
深入讲解如何使用 JavaScript 原生 String.prototype.matchAll() 方法提取字符串中所有正则表达式匹配项及捕获分组,对比 match 与 exec 的优劣,并提供完整操作步骤与常见避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
使用matchAll提取JavaScript中所有正则匹配项
作者:半夏
时间:2026-11-16
浏览:373
文章目录
在 JavaScript 中从一段文本里提取所有符合规则的内容及其捕获组时,
String.prototype.matchAll() 是最直接且健壮的原生解决方案。它不仅克服了 str.match(/.../g) 自动丢弃捕获分组的缺陷,还避免了使用 RegExp.prototype.exec() 编写 while 循环时所产生的全局状态污染与死循环隐患。本文将详细讲解 matchAll 的运行机制、数据结构、标准提取流程以及开发中必须注意的边界约束。
图示:String.prototype.matchAll 核心定位与技术特征速览
一、传统提取方案的痛点与 matchAll 的出现
在 ECMAScript 2020 (ES11) 引入 matchAll 之前,JavaScript 开发者如果需要对一段文本进行“全量匹配”并“提取括号中的捕获分组”,通常只有两种选择,但这两种方式各自存在明显的缺陷。
1. str.match(/.../g) 丢失捕获组
调用 str.match(regexp) 时,只要正则表达式带有全局标志 g,返回结果就仅仅是一个包含所有完整匹配文本的一维纯字符串数组。所有在正则表达式内部使用小括号声明的捕获组(Capture Groups),无论是有序捕获组还是命名捕获组,都会被浏览器静默丢弃。
const text = "用户A: id=101, 用户B: id=202";
const regex = /id=(\d+)/g;

const result = text.match(regex);
console.log(result);
// 示例输出: ['id=101', 'id=202']
// 痛点: 无法直接获取括号中具体匹配到的纯数字 "101" 和 "202"
2. RegExp.prototype.exec() 循环带来的副作用
为了拿到捕获组,传统做法只能通过 while 循环反复调用正则表达式对象的 exec() 方法。然而,exec() 在全局模式下是有状态的(Stateful),它会不断修改正则对象自身的 lastIndex 属性。这种机制带来了极大的维护风险:
- 容易引发死循环:如果开发者不小心传入了一个没有
g标志的正则表达式,lastIndex永远不会后移,循环条件将始终为真,瞬间导致线程卡死。 - 共享正则冲突:同一个正则实例如果被多个模块或不同循环并发使用,其内部的
lastIndex指针会被互相覆盖,造成莫名其妙的漏匹或解析错乱。
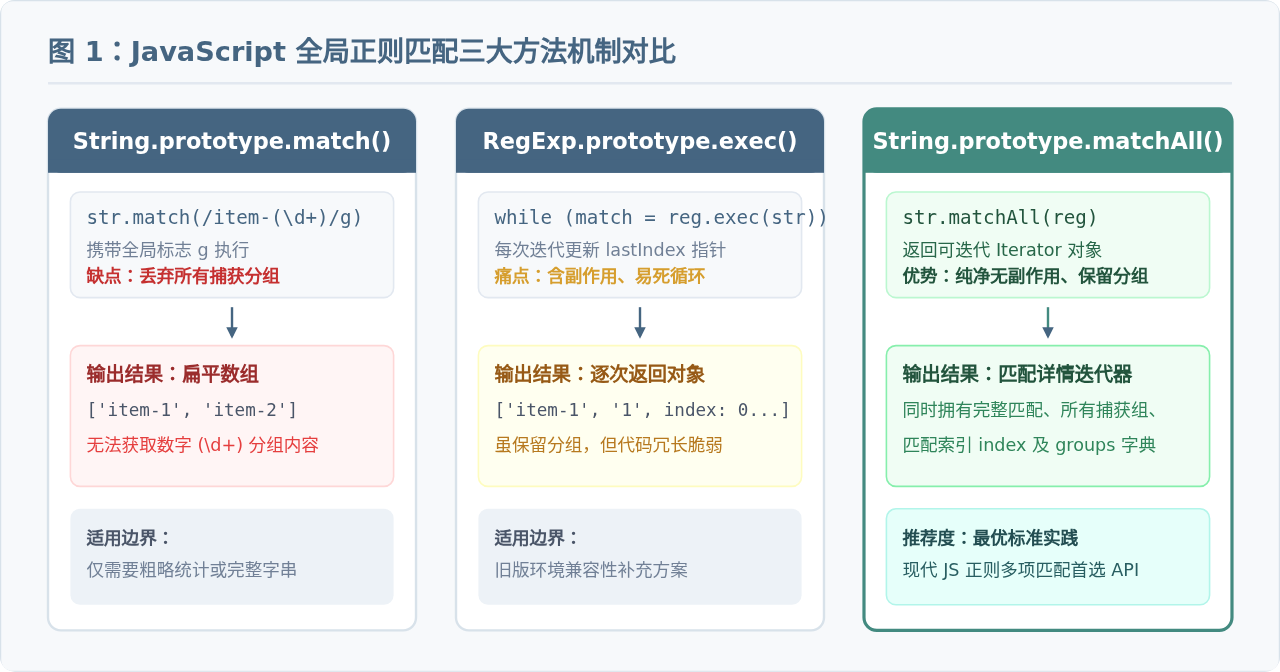
图 1:JavaScript 中 match()、exec() 与 matchAll() 机制行为对比
二、matchAll 的核心机制与返回数据结构
str.matchAll(regexp) 的核心思路非常清晰:它接受一个正则表达式,并返回一个符合 ES6 迭代协议的可迭代迭代器(RegExpStringIterator)。
该迭代器在被逐次消费时,生成的每一个匹配项对象都与调用单次 RegExp.prototype.exec() 得到的数组结构完全一致。它不但不会丢弃分组,还会完整保留匹配的起始索引和命名捕获对象。更关键的是,matchAll 在内部会复制正则的执行环境,完全不会污染外部传入的正则实例的 lastIndex。
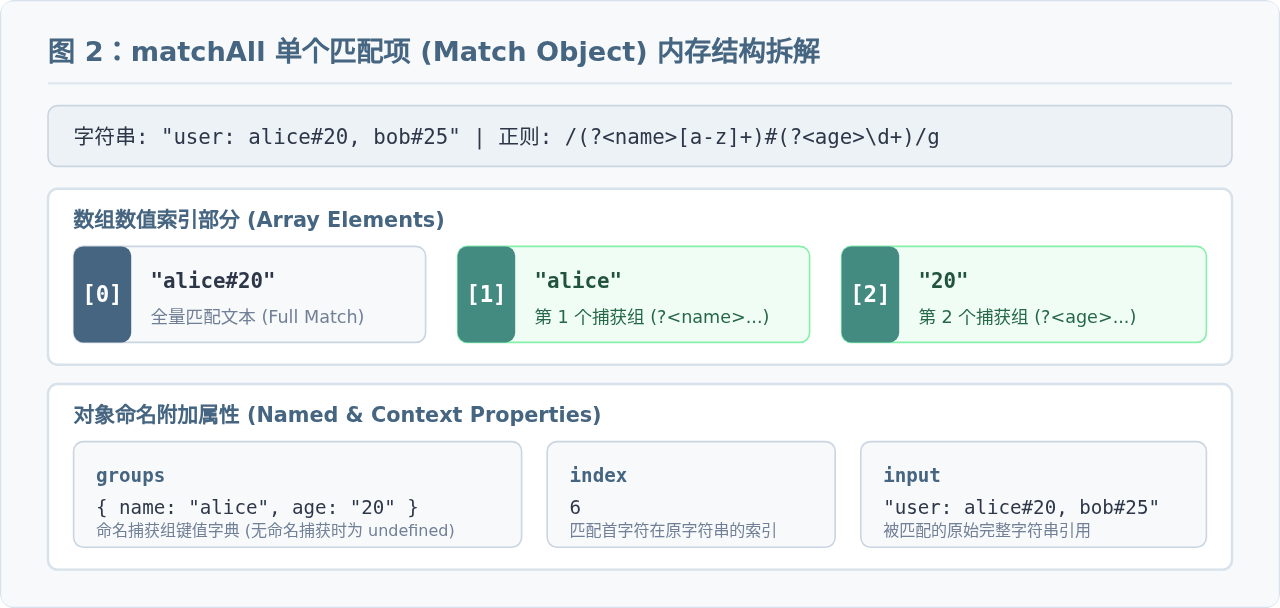
图 2:matchAll 单个匹配项 (Match Object) 属性与索引结构拆解
通过解构单个匹配项,我们可以获取到以下核心信息:
[0]:与整个正则表达式匹配的完整子串。[1], [2], ... [n]:对应第 1、第 2 及后续小括号()所捕获的子串内容。如果某个捕获组未匹配到,则为undefined。index:本次匹配内容在原文本中的起始字符下标(基于 0 开始)。input:被执行匹配的原始完整字符串。groups:包含所有命名捕获组(?<name>...)的键值对象。如果没有命名分组,该属性为undefined。
三、使用 matchAll 提取数据的完整实战步骤
在真实业务代码中使用 matchAll 提取数据,通常可以遵循以下四个明确步骤。
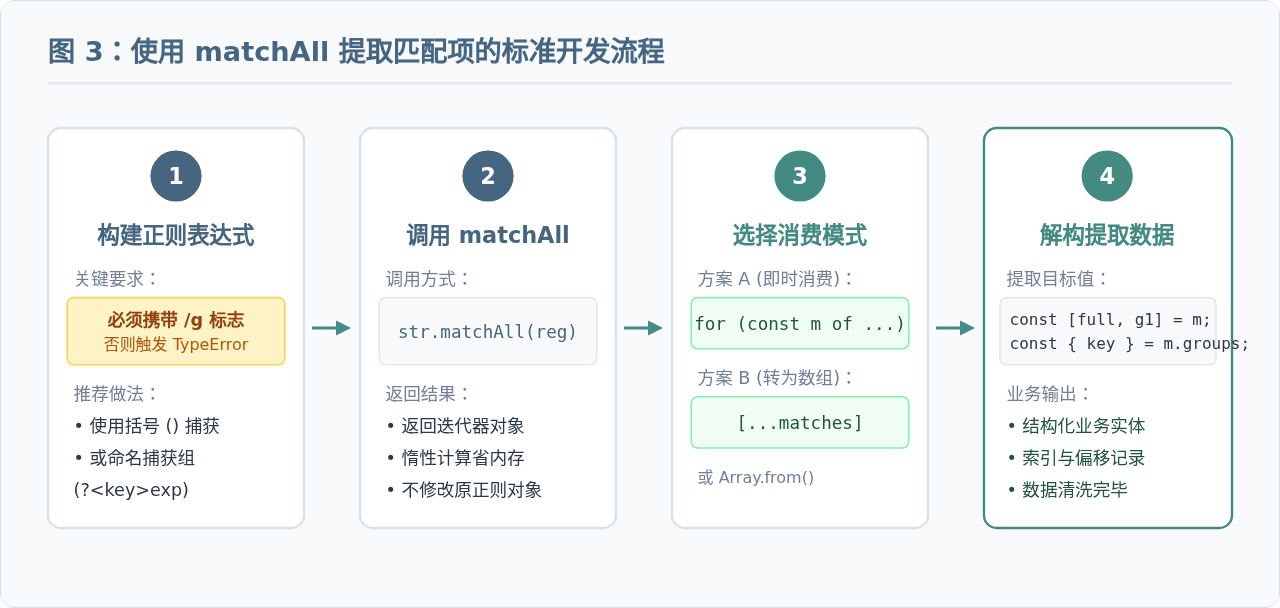
图 3:使用 matchAll 提取匹配项的标准开发流程
步骤 1:编写包含全局标志 g 的正则表达式
使用 matchAll 时,正则表达式必须显式携带全局修饰符 g。为了方便后续提取,建议使用具名捕获组 (?<name>pattern) 提高代码可读性。例如我们需要从一段日志中提取所有 HTTP 请求的请求方法、路径及状态码:
// 带有 /g 修饰符以及命名捕获组的正则表达式
const logPattern = /(?<method>GET|POST|PUT|DELETE)\s+(?<path>\/\S*)\s+(?<status>\d{3})/g;

const logData = `
[INFO] GET /api/v1/users 200 - 15ms
[WARN] POST /api/v1/login 401 - 22ms
[INFO] GET /api/v1/posts/88 200 - 9ms
`;
步骤 2:调用 matchAll 获取迭代器
直接在目标字符串上调用 matchAll 方法,将正则表达式作为参数传入:
const iterator = logData.matchAll(logPattern);
// 返回的是一个 RegExpStringIterator 对象,此时匹配计算是惰性(Lazy)执行的
步骤 3:选择合适的消费方式
由于 matchAll 返回的是可迭代对象,在实际开发中通常有两种处理策略:
方式 A:使用 for...of 即时遍历(推荐大数据量场景)
如果数据量较大或者希望在满足某种条件时提前中断(例如通过 break 停止),直接使用 for...of 循环是内存占用最低的消费方式:
for (const match of logData.matchAll(logPattern)) {
  // 直接解构命名捕获组
  const { method, path, status } = match.groups;
  console.log(`请求方法: ${method}, 路径: ${path}, 状态码: ${status}, 偏移量: ${match.index}`);
}

// 示例输出:
// 请求方法: GET, 路径: /api/v1/users, 状态码: 200, 偏移量: 8
// 请求方法: POST, 路径: /api/v1/login, 状态码: 401, 偏移量: 45
// 请求方法: GET, 路径: /api/v1/posts/88, 状态码: 200, 偏移量: 83
方式 B:通过展开运算符或 Array.from 转为普通数组
如果需要对匹配结果进行链式调用(如 .map()、.filter())或多次反复访问,建议先将其展开为真实数组:
// 使用扩展运算符展开
const matchesArray = [...logData.matchAll(logPattern)];

// 提取出所有状态码为 200 的请求路径
const successPaths = matchesArray
  .filter(m => m.groups.status === "200")
  .map(m => m.groups.path);

console.log(successPaths);
// 示例输出: ['/api/v1/users', '/api/v1/posts/88']
步骤 4:解构提取目标值并组装业务对象
通过解构赋值,我们可以非常优雅地把文本转成标准业务对象,代码没有任何冗余的字符串截取逻辑:
const records = [...logData.matchAll(logPattern)].map(m => ({
  fullMatch: m[0],
  method: m.groups.method,
  path: m.groups.path,
  status: Number(m.groups.status),
  position: m.index
}));

console.log(records);
// 得到清晰规整的结构化对象数组
四、关键注意事项与常见避坑指南
必须添加 /g 标志:
如果向
matchAll() 传入未声明 g 标志的正则表达式,JavaScript 引擎会立即抛出 TypeError: String.prototype.matchAll called with a non-global RegExp argument。这是官方规范设立的硬性保护机制,旨在防止开发者因误用单次匹配规则而陷入意外行为。
在动态组装正则表达式时,务必注意第二参数:
// 错误写法:缺少 'g',运行时直接抛出 TypeError 异常
const wrongReg = new RegExp("item-(\\d+)");
text.matchAll(wrongReg); // 抛出 TypeError!

// 正确写法:必须指明 'g'
const safeReg = new RegExp("item-(\\d+)", "g");
const matches = text.matchAll(safeReg); // 正常运行
迭代器单次消费特性
RegExpStringIterator 是一次性(Single-pass)迭代器。一旦被 for...of 遍历或被 [...iterator] 展开完毕后,该迭代器指针就已耗尽。再次对其进行遍历将无法得到任何结果。若需再次使用,必须重新调用 str.matchAll(regexp) 生成新的迭代器,或者在首次提取时直接保存为数组。
五、总结与 API 选型速查
为了帮助读者在日常开发中准确选择最合适的正则处理 API,我们对 JavaScript 中主流的正则匹配方法做如下归纳:
| API 方法 | 是否返回所有匹配 | 是否保留捕获组 | 副作用 (lastIndex) | 典型适用场景 |
|---|---|---|---|---|
RegExp.prototype.test() |
否 | 否 | 全局模式下有 | 仅校验字符串是否满足格式要求 |
str.match(非全局正则) |
否 (仅首个) | 是 | 无 | 只需提取文本中第一次出现的数据及分组 |
str.match(全局正则 /g) |
是 | 否 (被丢弃) | 无 | 只需提取所有完整子串,不关心分组 |
RegExp.prototype.exec() |
需手写 while | 是 | 有 (修改 lastIndex) | 不支持 ES2020 的极老旧运行环境 |
| String.prototype.matchAll() | 是 | 是 | 无 (纯净安全) | 需要同时提取所有匹配项及捕获分组的首选方案 |
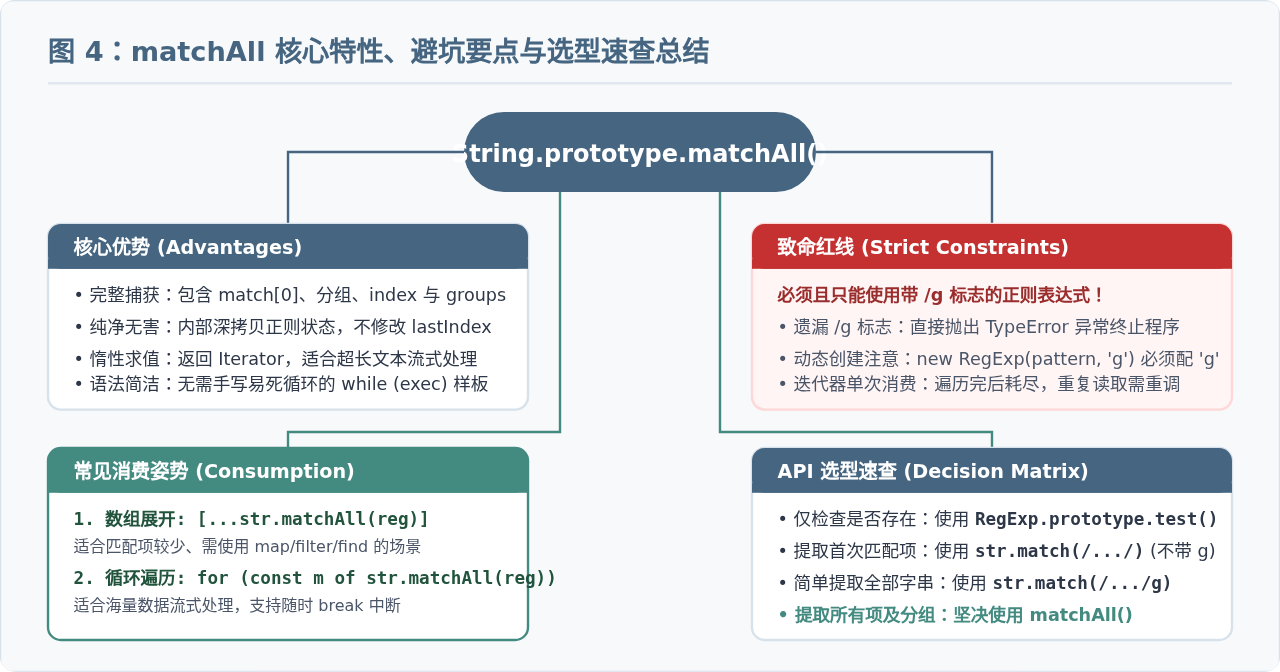
图 4:matchAll 关键特性、使用禁忌与选型速查总结
总结建议:
在现代 JavaScript 及 Node.js 开发中,只要遇到“提取文本中所有匹配项以及各自的分组数据”的需求,应当无条件优先使用
String.prototype.matchAll()。配合具名捕获组与解构赋值,能够用最清晰、最具表现力的代码完成复杂文本提取。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章