
深入解析JavaScript递归遍历树或图结构时报RangeError: Maximum call stack size exceeded的根本原因,提供基线条件检查、WeakSet防环守卫、显式栈迭代消除递归以及异步切片的完整排查步骤与可运行代码。

当前位置:首页 > JavaScript 函数与作用域 > 正文
JS递归遍历报Maximum call stack size exceeded怎么解决
作者:函数茶馆
时间:2026-11-16
浏览:340
文章目录
Runtime RangeError
JavaScript 内存与性能
数据结构与算法
在 JavaScript 中使用递归遍历对象、嵌套数组或树形数据时,抛出
RangeError: Maximum call stack size exceeded 的根本原因在于单线程执行栈(Call Stack)的栈帧数量突破了运行环境的硬性上限。核心排查与解决路径包括四个环节:首先补正缺失的基线终止条件(Base Case),其次引入 WeakSet 拦截循环引用成环,遇到深度极大(超过万级)的场景果断改用显式堆内存栈(Array + while)改写为迭代遍历,并在长任务场景配合时间切片调度。
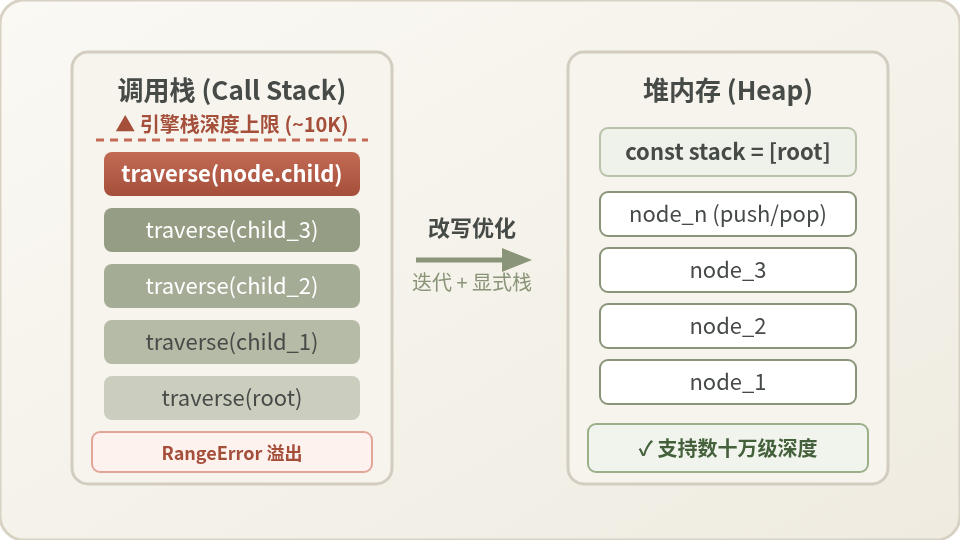
图 0:递归调用栈溢出(左)与显式堆栈迭代化重构(右)机制概览
一、问题本质:调用栈为何会溢出?
JavaScript 引擎(如 Chrome 和 Node.js 底层的 V8、Firefox 的 SpiderMonkey、Safari 的 JavaScriptCore)在执行同步代码时,依赖唯一的执行上下文栈(Execution Context Stack,即调用栈)来追踪函数的嵌套调用层级。
每次一个函数被调用,引擎就会为该函数分配并压入一个新的栈帧(Stack Frame),其中保存了函数的入参、局部变量、作用域链引用以及调用完成后的返回地址。只有当被调用函数执行完毕并执行 return(显式或隐式)时,对应的栈帧才会被弹出并销毁,栈内存得以释放。
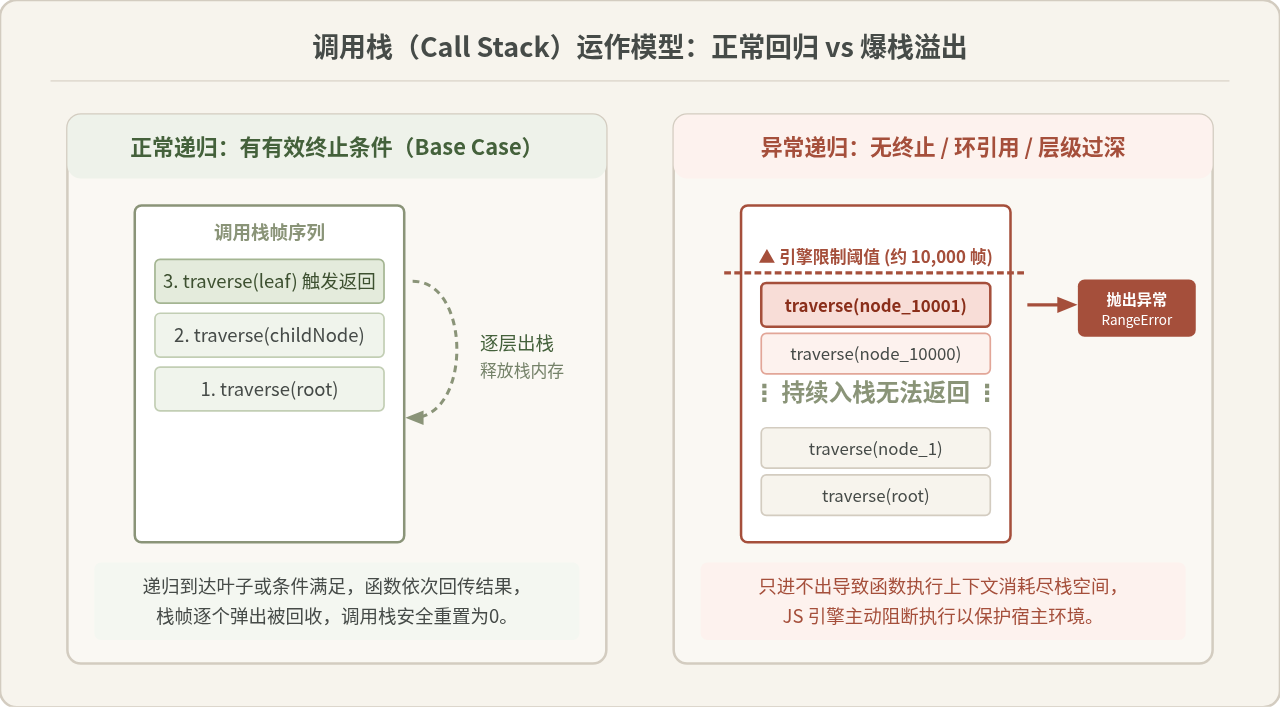
图 1:调用栈帧累积与栈溢出(RangeError)触发原理对比
宿主环境为了防止无休止的递归耗尽系统线程的物理栈内存(通常每条线程分配的栈空间仅约 1MB 左右),对调用栈的最大嵌套深度做出了硬性限制。在 V8 引擎中,这个阈值通常在 8,000 到 12,000 层之间(具体取决于单个函数栈帧中局部变量的体积)。一旦函数只进不出、持续嵌套压栈直到触碰这条警戒线,引擎便会立即抛出 RangeError: Maximum call stack size exceeded 并中断程序。
二、系统排查四步法:快速定位诱发根源
递归遍历抛出爆栈错误通常由四种诱因引起。面对具体报错时,建议按照由浅入深的逻辑顺序依次排查:
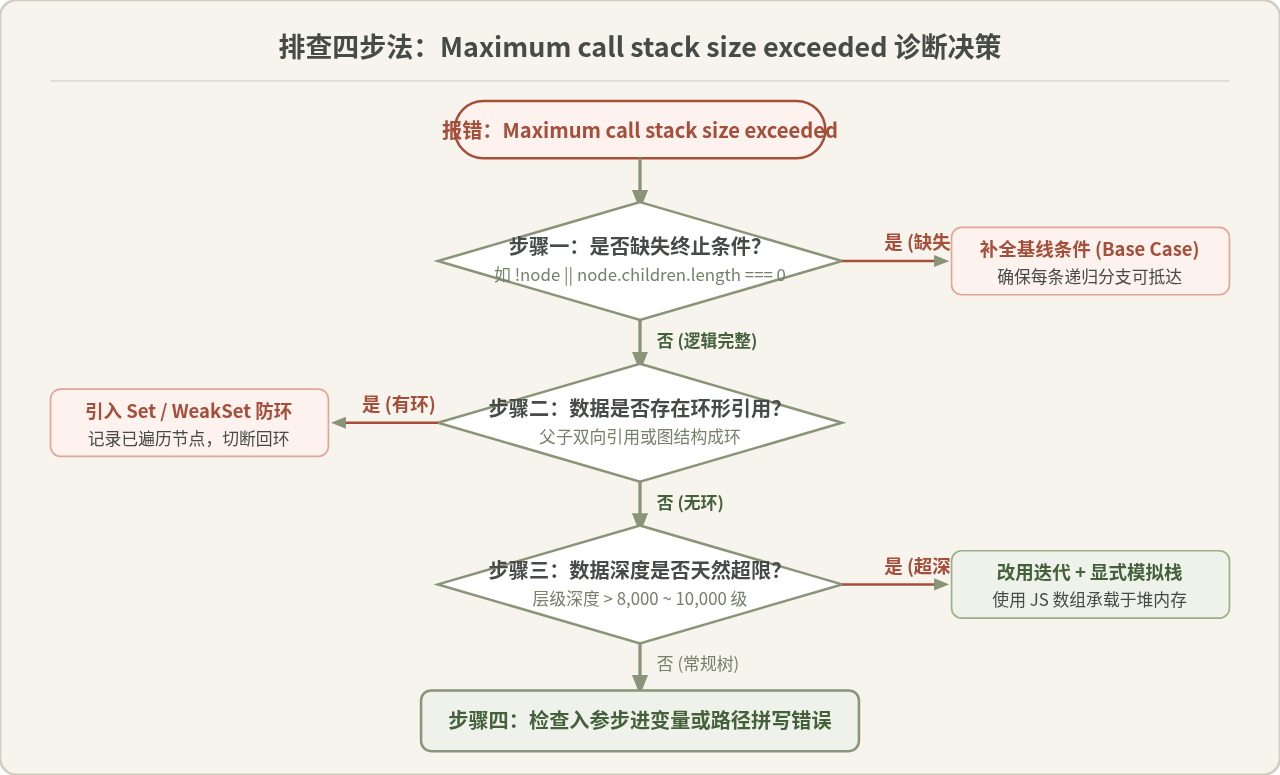
图 2:Maximum call stack size exceeded 故障定位与重构决策流程图
1
步骤一:排查基线条件(Base Case)与递进步长
检查递归函数内部是否包含明确的返回出口。确认每一条可能的分支执行路径最终都能触发 return,并且每次递归传递给子调用的参数都在向终止条件逼近,而不是传入了原封不动的参数或无效路径。
2
步骤二:排查数据结构中是否存在“循环引用”
树形数据或对象图结构中如果包含双向关联(例如父节点引用子节点,子节点又通过 parent 指针引用父节点;或者原生 DOM 树、包含相互依赖的配置图),会导致递归函数在两个或多个节点之间死循环往复调用,瞬间耗尽栈空间。
3
步骤三:评估业务数据的实际嵌套层级规模
如果逻辑完全正确且无环形引用,但处理的数据属于超长扁平链表、极度深层的文件树或数十万级的层级结构,天然深度超过了万层上限,此时递归方案已不再适用,必须消除函数调用栈依赖。
4
步骤四:排查变量拼写与闭包传参失误
检查是否存在因拼写错误导致递归调用了原节点本身(如把 traverse(child) 误写成了 traverse(node)),或递归入参未正确解构展开。
三、四大针对性解决方案与完整代码实现
方案一:补齐或修正递归基线条件(Base Case)
这是最常见也最容易修复的低级失误。递归函数必须在执行核心遍历逻辑前,优先处理空值边界或叶子节点终止判断。
// ❌ 错误示范:缺乏终止出口或参数未递进
function traverseListBuggy(node) {
  console.log(node.val);
  // 缺少对 node.next 是否存在的校验,若 next 逻辑异常将死循环
  traverseListBuggy(node.next);
}

// ✓ 修正示范:严格的基线条件守卫
function traverseListSafe(node) {
  // 1. 基线条件:节点为空立即返回出栈
  if (!node) {
    return;
  }

  console.log(node.val);

  // 2. 递进步进向终点收敛
  traverseListSafe(node.next);
}
方案二:使用 WeakSet 拦截循环引用(防环守卫)
在遍历复杂复杂对象、富文本 AST 树或包含 parentNode 引用的图结构时,必须引入缓存容器记录“已经访问过的节点”。若再次遇到同一个对象引用,说明出现了回环,应立即阻断不再深入。
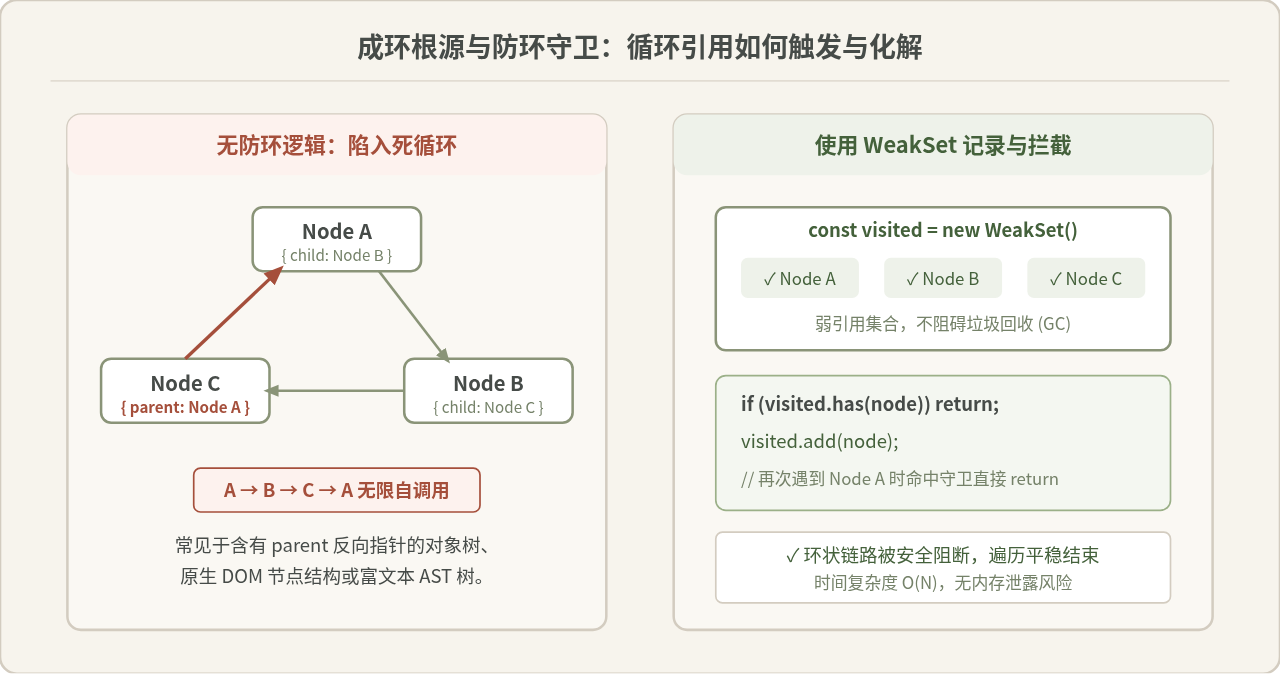
图 3:循环引用无限自调用成环与 WeakSet 访问拦截对比
推荐使用 WeakSet 而不是普通的 Array 或 Set。WeakSet 仅持有对象的弱引用,在遍历完成后不会阻碍垃圾回收(GC),能够有效避免长生命周期内存泄漏,并且查询时间复杂度为 O(1)。
/**
 * 带有循环引用检测的安全递归遍历
 * @param {object} root 根节点
 * @param {WeakSet} visited 已访问节点的弱引用集合
 */
function traverseGraphSafe(node, visited = new WeakSet()) {
  // 1. 基础空值与非对象类型校验
  if (!node || typeof node !== 'object') {
    return;
  }

  // 2. 防环守卫:已访问过则直接退出,切断无限循环
  if (visited.has(node)) {
    return;
  }

  // 3. 将当前节点登记到已访问集合中
  visited.add(node);

  // 处理业务逻辑
  console.log('Visiting:', node.id || node.name || node);

  // 4. 递归遍历子节点或对象属性
  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      traverseGraphSafe(child, visited);
    }
  } else {
    for (const key of Object.keys(node)) {
      if (typeof node[key] === 'object') {
        traverseGraphSafe(node[key], visited);
      }
    }
  }
}
方案三:改写为迭代模式(显式栈/队列,生产首选)
当业务数据的嵌套深度天然可能达到万级以上(例如大型文件系统扫描、组织架构树、反序列化巨型数据)时,彻底消除递归、改用显式栈(Stack)或队列(Queue)进行迭代循环,是工业界最通用、最可靠的根治策略。
💡 为什么迭代显式栈不会报 Maximum call stack size exceeded?
因为递归消耗的是线程调用栈内存(Stack Memory),其容量非常小且受引擎上限死锁限制(~10,000 层);而手动创建的
因为递归消耗的是线程调用栈内存(Stack Memory),其容量非常小且受引擎上限死锁限制(~10,000 层);而手动创建的
const stack = [] 数组分配在 V8 堆内存(Heap Memory)中。V8 堆内存默认限制在 1.4GB 到 4GB 之间,足以存储数百万乃至数千万个引用对象,完全不会触发调用栈溢出错误。
1. 深度优先搜索(DFS)显式栈迭代遍历
/**
 * 消除递归:使用显式辅助栈实现深度优先遍历 (DFS)
 * 完全规避调用栈溢出限制
 */
function traverseTreeIterativeDFS(root) {
  if (!root) return;

  // 在堆内存中开辟数组充当调用栈
  const stack = [root];
  const visited = new WeakSet();

  while (stack.length > 0) {
    const currentNode = stack.pop();

    if (!currentNode || typeof currentNode !== 'object') continue;
    if (visited.has(currentNode)) continue;
    visited.add(currentNode);

    // 消费当前节点
    console.log('DFS Node:', currentNode.id || currentNode.name);

    // 将子节点倒序入栈,确保从左至右的正常遍历顺序
    if (Array.isArray(currentNode.children)) {
      for (let i = currentNode.children.length - 1; i >= 0; i--) {
        stack.push(currentNode.children[i]);
      }
    }
  }
}
2. 广度优先搜索(BFS)层序队列遍历
/**
 * 消除递归:使用队列实现广度优先层序遍历 (BFS)
 */
function traverseTreeIterativeBFS(root) {
  if (!root) return;

  const queue = [root];
  let head = 0; // 避免频繁 shift() 导致 O(N) 数组重排

  while (head < queue.length) {
    const currentNode = queue[head++];

    // 消费当前节点
    console.log('BFS Node:', currentNode.id || currentNode.name);

    if (Array.isArray(currentNode.children)) {
      for (const child of currentNode.children) {
        queue.push(child);
      }
    }
  }
}
方案四:异步时间切片(Chunking)防止主线程冻结
对于节点数极大(如数十万个节点)的数据,即使改用迭代不会引起调用栈溢出,长时同步循环依然会霸占 JavaScript 的单线程执行器,导致浏览器 UI 掉帧、页面卡死(Unresponsive Script)或 Node.js 服务无法响应网络请求。
在这种场景下,可以结合异步时间切片(Time Slicing),每遍历一定批次(如 1000 个节点)主动 yield 一次宏任务,让出主线程给事件循环(Event Loop):
/**
 * 异步时间切片遍历:既防爆栈,又防主线程无响应 (卡死)
 */
async function traverseTreeAsyncSliced(root, batchSize = 1000) {
  if (!root) return;

  const stack = [root];
  let processedCount = 0;

  while (stack.length > 0) {
    const currentNode = stack.pop();

    // 执行业务操作
    doWork(currentNode);
    processedCount++;

    // 入栈子节点
    if (Array.isArray(currentNode.children)) {
      for (let i = currentNode.children.length - 1; i >= 0; i--) {
        stack.push(currentNode.children[i]);
      }
    }

    // 每处理 batchSize 个节点,主动让出事件循环,重置调用栈并让浏览器渲染
    if (processedCount % batchSize === 0) {
      await new Promise(resolve => setTimeout(resolve, 0));
    }
  }
}
四、认知辨析:关于“尾调用优化(TCO)”的误区
⚠️ 常见错误认知:“只要把递归函数改写为尾递归(Tail Call),JS 引擎就会复用当前栈帧,自然不会发生爆栈了。”
为什么这种说法在当下不能作为解决方案?
- 标准与实现的割裂:虽然 ECMAScript 2015 (ES6) 规范中确实定义了严格模式下的尾调用优化(Proper Tail Calls,简称 PTC),但在主流引擎中,只有 Safari 旗下的 WebKit 引擎对其提供了完整支持。
-
V8 / Node.js 官方放弃支持:占据桌面与服务端统治地位的 Chrome、Node.js 底层 V8 团队明确表示不在生产环境中启用 PTC。原因是尾递归消除会破坏
error.stack的调用栈回溯信息,使得异常排查极其困难;同时它会增加引擎内部架构复杂度并带来部分性能回退。 -
结论:在跨平台(Chrome、Node.js、Firefox、Edge)的日常开发中,绝不能指望通过改写为尾递归来解决
Maximum call stack size exceeded。在非 WebKit 环境下,尾递归与普通递归的调用栈深度限制完全一致。
五、总结与方案选型对照
为了帮助大家在实际遇到报错时迅速敲定方案,下表对各类修复策略的技术特性做出了横向对比:
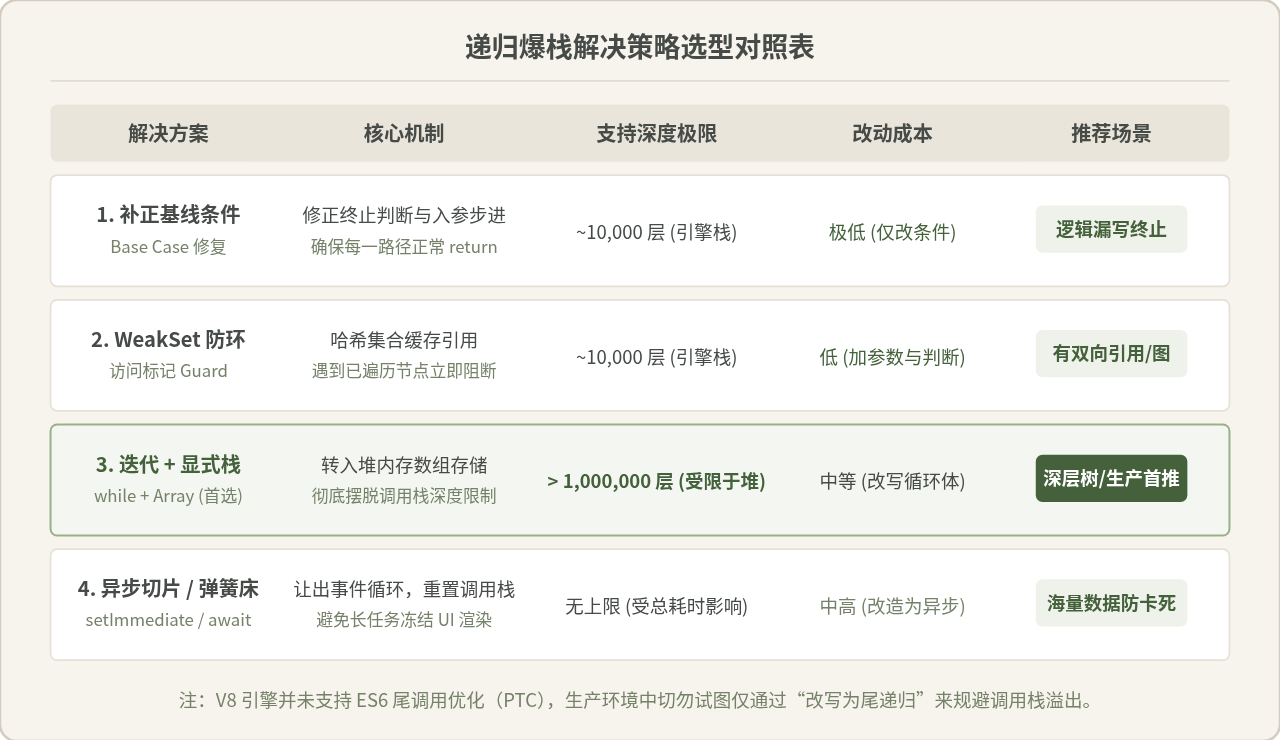
图 4:递归爆栈四类解决策略选型对照与关键指标总结
| 方案类型 | 适用典型场景 | 内存承受极限 | 代码重构成本 | 选型建议 |
|---|---|---|---|---|
| 补齐 Base Case | 漏写终止判断、步进参数传递错误 | ~10,000 层 | 极低(仅增补分支) | 基础必做项,首先自查 |
| WeakSet 守卫防环 | 对象双向关联、DOM 树引用、图结构成环 | ~10,000 层 | 低(增加入参集合) | 存在回环数据时的标配 |
| 显式栈迭代(DFS/BFS) | 数据层级庞大(>10K)、工业级核心遍历算法 | 百万级以上(受堆内存限制) | 中等(while 循环改写) | 生产环境推荐首选 |
| 异步时间切片 | 海量数据遍历导致页面卡顿、UI 掉帧冻结 | 无上限(按批执行) | 中等(改为 async/await) | 长任务防冻结专属配合方案 |
简而言之:排查错误时,一查终止出口,二查是否带环,三看数据深度。只要数据深度存在破万的潜能,务必将递归直接替换为基于 while 与堆内存数组的显式栈迭代,这是杜绝 Maximum call stack size exceeded 最稳妥的做法。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章