
深入对比JavaScript中字符串转数字的三种主流方式:Number()、parseInt()与一元加号。详细剖析底层ToNumber机制、逐字符解析逻辑、空值与特殊边界陷阱及业务选型建议。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串转数字:Number()、parseInt()与一元加号的区别
作者:开源拾贝
时间:2026-11-03
浏览:220
文章目录
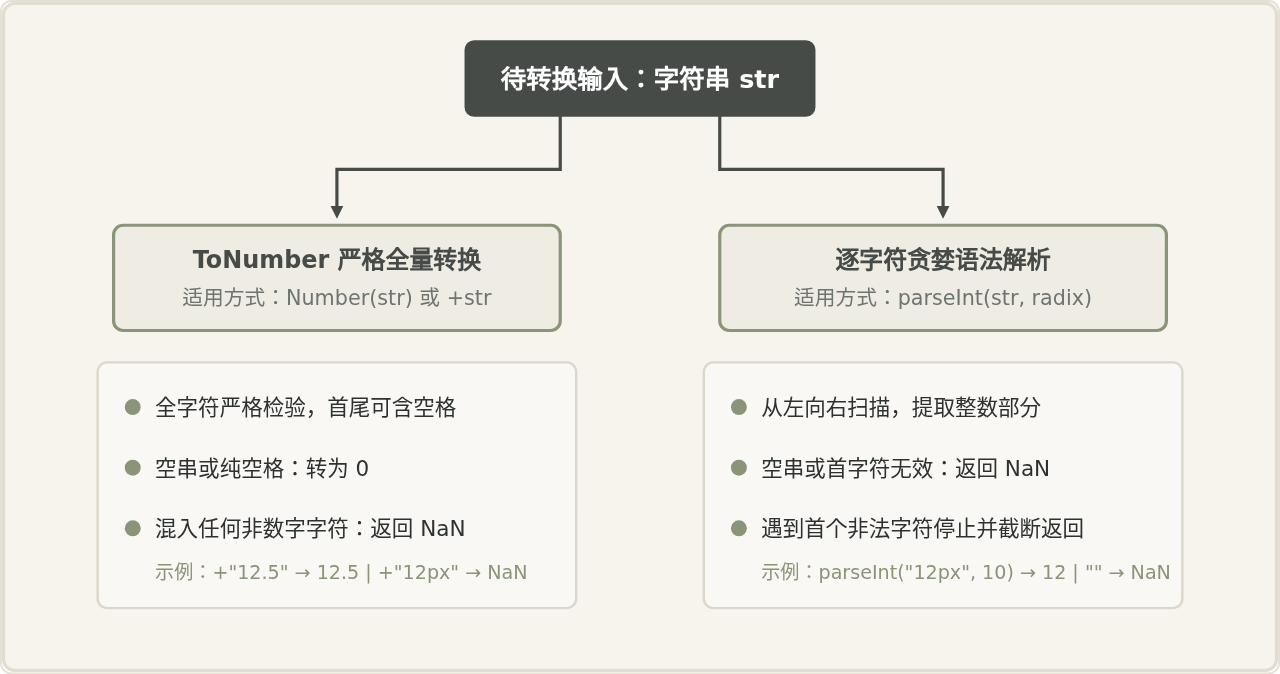
在 JavaScript 中,将字符串转换为数字主要有三种常用方式:Number() 显式转换、一元加号(+)操作符以及 parseInt() 函数。简要核心结论是:Number() 与一元加号底层机制一致,都基于 ECMAScript 规范的 ToNumber 抽象操作进行“全量严格解析”,遇到任何非数字字符立即判定为 NaN,但会将空字符串转为 0;而 parseInt() 则是“逐字符从左向右提取整数”,只要开头是有效数字就会截取到底并忽略后续杂质字符,但它会将空字符串转为 NaN,且必须时刻警惕进制(radix)与浮点科学计数法陷阱。
一、底层机制差异:ToNumber 全量转换与逐字符解析
在许多初学者的认知中,这三种方式仅仅是“写法不同”,甚至有人认为一元加号比 Number() 更加神奇或高效。事实上,它们在 ECMAScript 规范层面上被划分为截然不同的两类行为。
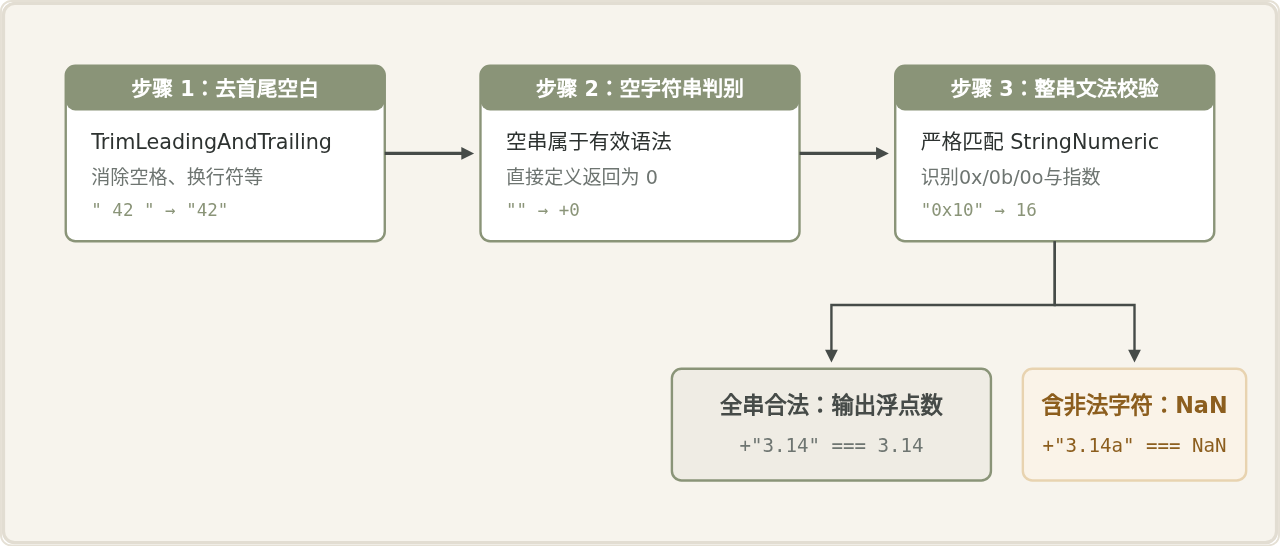
Number(value) 与一元加号 +value 调用的内部规范完全相同,即 ToNumber(argument)。当传入一个字符串时,引擎会将其视为一个完整的数字字面量进行语法检验。这意味着:
- 允许字符串开头和结尾包含任意数量的空白字符(如空格、Tab、换行符等)。
- 允许识别常见的数字表达形式,包括标准的浮点数、科学计数法(如
"1e3")、十六进制("0x1f")、二进制("0b101")和八进制("0o77")。 - 只要字符串内部混杂了任何无法构成合法数值的字符(例如
"120px"、"12.0.1"),整个转换过程就会彻底宣告失败,直接返回NaN。
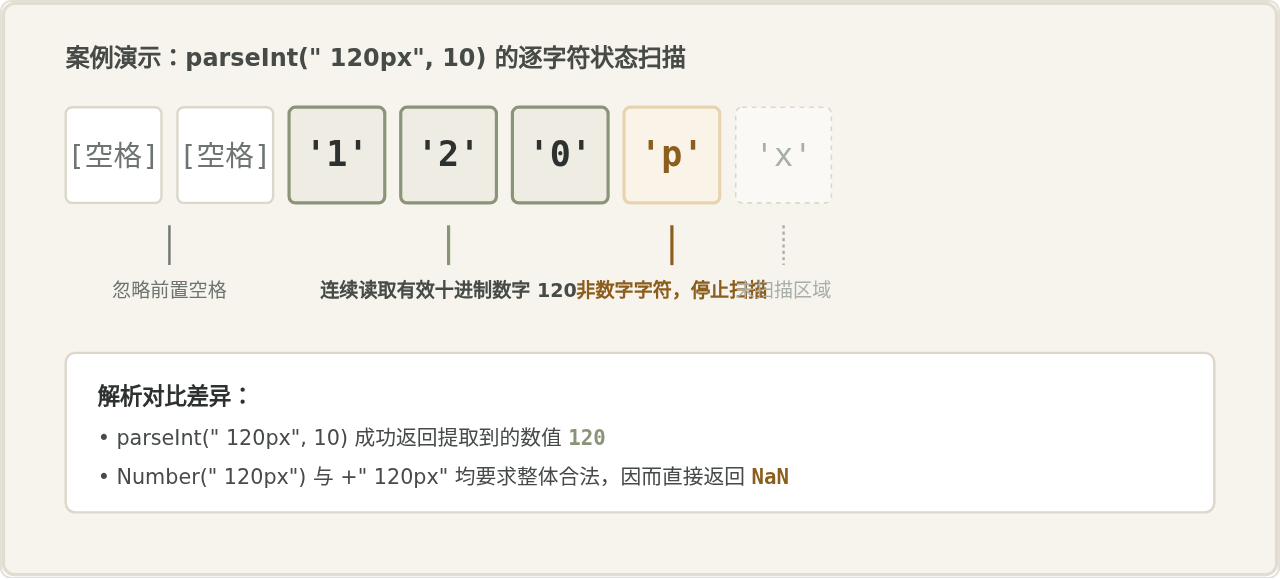
与此相反,parseInt(string, radix) 的设计定位是“文本解析器(Parser)”,它模拟的是一种从左往右的扫描过程:
- 同样会先忽略开头的空白字符。
- 找到第一个非空白字符后,检查该字符是否为正负号或指定基数下的有效数字字符。如果不是,解析立即终止,直接返回
NaN。 - 如果是有效数字,则继续向右逐个字符读取,直到遇到第一个无法作为当前基数有效数字的字符为止。此时,它会停止读取,并将前面已经提取到的所有数字字符转换为整数返回。
二、边界值辨析:空字符串、null 与 undefined
在实际项目开发中,最容易引发隐蔽 Bug 的并非 "123" 这类明确的数字串,而是空字符串、空白符以及非字符串的空值对象。理解以下对比是写出健壮代码的关键:
// 1. 空字符串与纯空白字符串
Number("");            // 0
+"";                   // 0
Number("   ");         // 0
+"   ";                // 0
parseInt("", 10);      // NaN
parseInt("   ", 10);   // NaN

// 2. null 与 undefined
Number(null);          // 0
+null;                 // 0
parseInt(null, 10);    // NaN (实际执行了 parseInt("null", 10))

Number(undefined);        // NaN
+undefined;               // NaN
parseInt(undefined, 10);  // NaN (实际执行了 parseInt("undefined", 10))
为什么 Number("") 会得到 0?
ECMAScript 规范在制定 ToNumber 规则时,沿袭了 C 语言等传统惯例,将空字符串定义为数值形式的起始点 +0。
⚠️ 业务风险提醒:在处理表单输入时,若用户没有在输入框中填写任何内容,获取到的
input.value 为 ""。此时若直接使用 +input.value 或 Number(input.value),变量将悄无声息地变成 0,而不是预期的“未填写”或 NaN。如果这是一个价格、年龄或折扣字段,将直接导致逻辑错误。
三、parseInt() 的两大陷阱:进制与科学计数法
1. 必须始终显式传递第二个参数 radix
parseInt 接收两个参数:parseInt(string, radix)。第二个参数 radix 表示解析使用的基数(2 到 36 之间)。如果省略该参数,虽然在 ES5 之后已经规范化默认处理,但它仍会在以下场景产生令人意外的行为:
- 如果字符串以
"0x"或"0X"开头,即使不传基数,也会被自动当做十六进制解析:parseInt("0x10") === 16。 - 在一些极老的引擎或特殊运行环境下,以
"0"开头的数字可能被误解析为八进制。虽然现代规范已将其定为十进制,但为了代码可读性与确定性,永远明确写出parseInt(str, 10)是行业共识的标准实践。
2. 隐式字符串转换与浮点数陷阱
parseInt 必须接收字符串。如果传入非字符串类型,JavaScript 会先对其执行 ToString()。这在处理微小浮点数时会引发著名陷阱:
// 为什么 parseInt(0.0000005, 10) 会等于 5?
console.log(parseInt(0.0000005, 10)); // 输出 5

// 原因解释:
// 0.0000005 转换为字符串后会变成科学计数法:"5e-7"
// parseInt("5e-7", 10) 从左向右读取,读到数字 5,随后遇到字符 'e'(在十进制下是非法字符)
// 解析器在 'e' 处终止,返回前面提取到的结果:5
同理,如果传入 parseInt(null, 10),实际上先转为了 parseInt("null", 10)。首字符是 'n',不是合法十进制数字,因此返回 NaN。
四、一元加号与 Number() 的微小差异与选型辨析
常见的一种流行说法是:“一元加号比 Number() 速度快得多,应当全盘替换”。这种说法在现代前端工程中需要客观审视:
- 执行性能:在现代 JavaScript 引擎(如 V8、SpiderMonkey)经过 JIT 优化后,
+str与Number(str)在绝大多数日常业务代码中的执行速度几乎没有感知上的差异。只有在千万级数组的高频计算循环中,一元加号可能省去函数调用上下文的微小开销,但在 99% 的场景下,这种性能差异不构成决定性因素。 - 代码可读性与团队规范:
Number(str)属于显式类型转换(Explicit Coercion),语义清晰明确,初级开发者容易理解;一元加号+str属于隐式转换(Implicit Coercion),写法简洁紧凑,但当与自增++或加法运算混合使用时(如a + +b),容易降低代码可读性甚至引发歧义。 - 浮点数保留:
Number()和一元加号能够保留浮点数(如+"12.34" === 12.34),而parseInt()只会截取整数(parseInt("12.34", 10) === 12)。若要保留小数并提取文本前缀,应使用parseFloat("12.34px")。
五、工程实践总结与防御性代码模式
在实际编写业务逻辑时,切勿盲目直接做类型转换后直接使用。针对常见输入场景,建议采用防御性封装模式:
1. 针对表单输入的防御性安全转换
function parseFormNumber(input) {
  // 1. 如果传入不是字符串,或去空白后为空,则明确返回 null
  if (typeof input !== "string" || input.trim() === "") {
    return null;
  }

  // 2. 使用 Number 进行全量严格检验
  const num = Number(input);

  // 3. 校验是否属于有效数字(排除 NaN 与非有限数字)
  return Number.isFinite(num) ? num : null;
}

// 测试验证
console.log(parseFormNumber("42"));     // 42
console.log(parseFormNumber(""));       // null (成功规避转为 0 的陷阱)
console.log(parseFormNumber("   "));    // null
console.log(parseFormNumber("12px"));   // null (严格拦截非纯数字)
2. 核心结论与选型速记
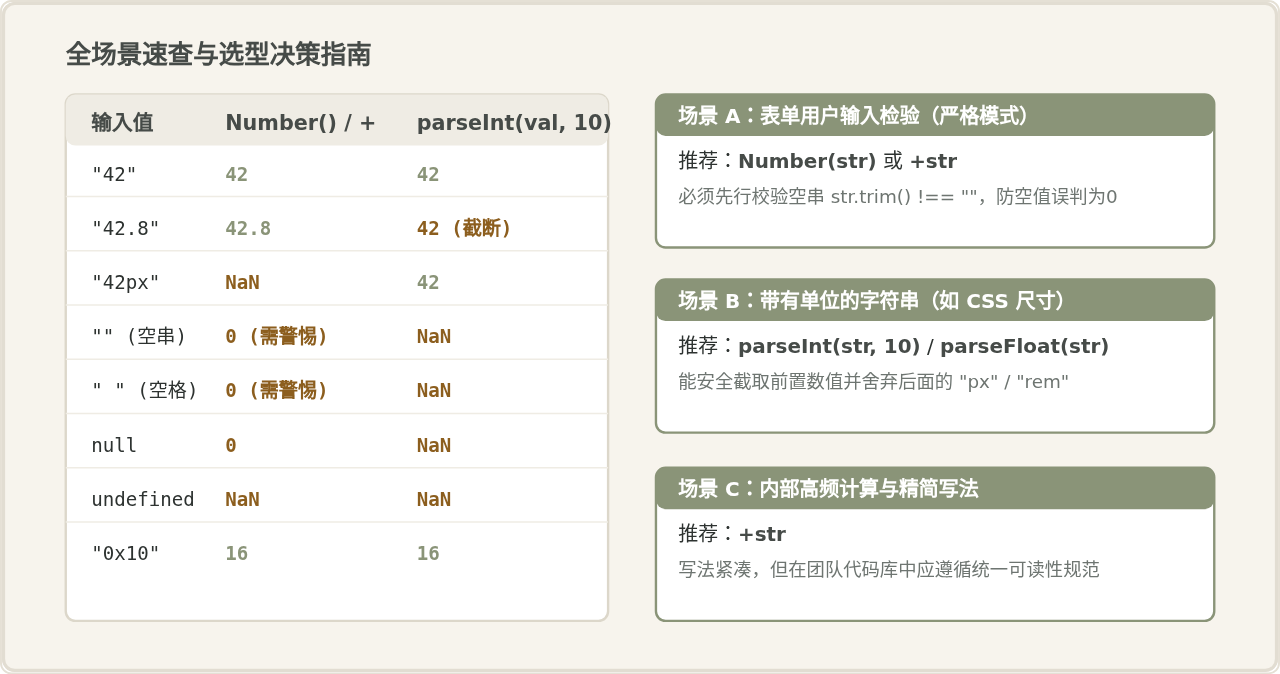
| 转换方式 | 底层操作 | 小数保留 | 空字符串处理 | 非纯数字字符串(如"10px") | 适用核心场景 |
|---|---|---|---|---|---|
| Number() | ToNumber |
是 | 0 |
NaN |
严格业务校验,显式可读性优先 |
| 一元加号 (+) | ToNumber |
是 | 0 |
NaN |
简单类型转换,紧凑语法优先 |
| parseInt(str, 10) | 逐字符解析 | 否(截断为整数) | NaN |
10(截取前缀数字) |
提取含单位数值,指定进制整数提取 |
掌握这三种转换方式的本质,关键在于区分“全量语法校验(ToNumber)”与“扫描截断提取(Parser)”。在表单校验等严谨场景下,优先选用 Number() 并配合防空处理;在处理 CSS 尺寸或包含单位的文本时,使用显式基数的 parseInt(str, 10) 或 parseFloat(str),即可彻底杜绝类型转换带来的潜在缺陷。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章