
深入解析开源数据语义层Cube.js的核心定义、系统架构、语义建模机制与Cube Store多维存储原理,结合端到端执行流程与实操示例,帮助技术团队掌握统一指标与查询加速的实现路径。

当前位置:首页 > Node.js 数据库开发 > 正文
Cube.js是什么:开源数据语义层与多维存储架构解析
作者:栖木
时间:2026-11-03
浏览:156
文章目录
开源数据基础设施技术解析
主题:数据语义层 (Universal Semantic Layer) / Headless BI
存储内核:Cube Store (分布式列存)
适用场景:指标中台、嵌入式分析、AI Agent 规范取数
设想一个在数据驱动型团队中反复上演的实际状况:在每周一的经营例会上,业务运营团队在自建后台查看的“月活跃付费客户数”是 12,450 人,商业智能分析师在 Metabase 看板中导出的数字是 11,800 人,而财务在对账报表系统里汇总的却只有 11,210 人。技术人员排查后发现,前端开发在编写定制接口时只过滤了未退款订单;分析师在 BI 工具的图形界面中额外排除了内部测试员工账号;而后端直接写 SQL 查询了未经去重清洗的旧宽表。与指标口径打架并存的另一个严重问题是性能:一旦业务看板面临几十上百人并发刷新,大量涉及上亿明细的大宽表 JOIN 和 GROUP BY 直接压向底层数仓,导致数仓 CPU 瞬时飙到 100%,不仅查询频频超时,而且按量计费的云数仓月度账单直线上升。
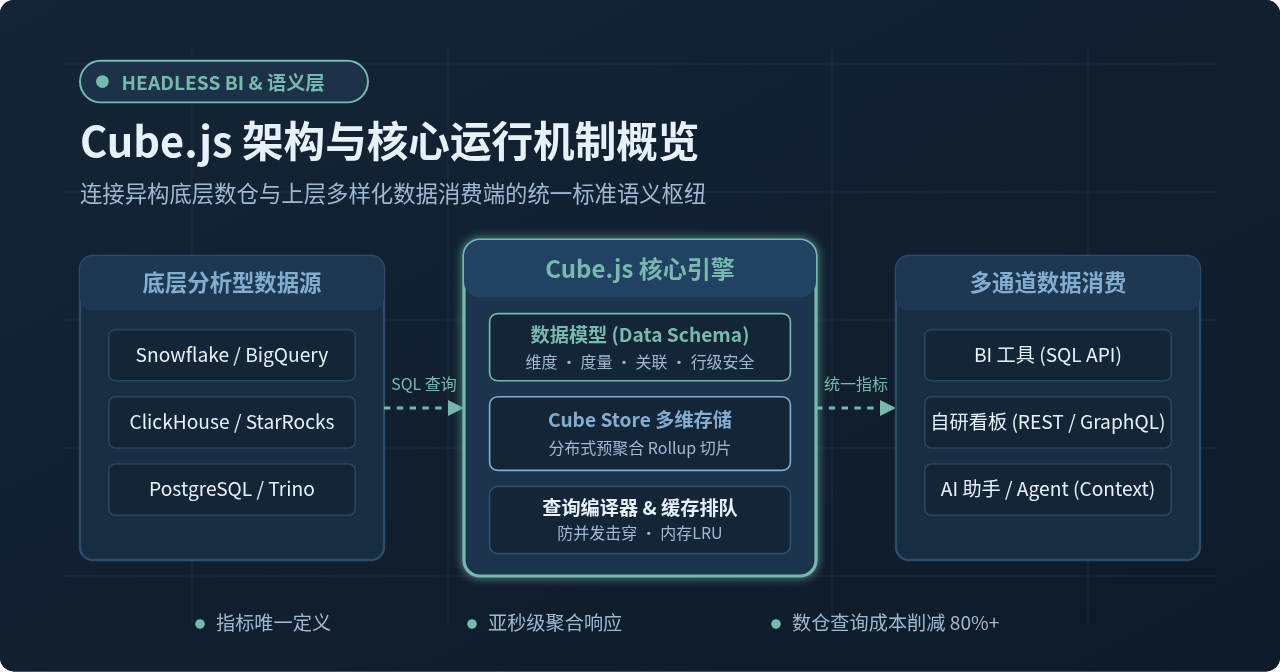
面对“指标定义割裂”与“数仓高并发查询性能低下且成本昂贵”这两大痛点,Cube.js(现官方正式品牌统一简化为 Cube)应运而生。从本质上说,Cube.js 是一个开源的通用数据语义层(Universal Semantic Layer)与 Headless BI 引擎。它驻留在底层数据仓库/数据库与上层分析应用之间,通过统一的代码化语义模型集中定义业务度量与维度,并通过内置的高性能多维列式存储引擎(Cube Store)与预聚合机制,将数仓耗时数秒甚至数分钟的重型查询加速至毫秒级返回。
一、Cube.js 在现代现代数据栈中的四层架构解析
传统的商业智能(BI)工具通常将“数据连接”、“数据建模”、“指标计算”和“可视化渲染”深度绑定在单个软件内部。这种紧密耦合模式导致外部系统或定制的前端业务看板难以复用其指标逻辑,形成了“一个工具一套口径”的信息孤岛。Cube.js 采用了 Headless BI(无头商业智能)架构,将前端可视化与后端语义建模彻底解耦,其技术体系自下而上划分为清晰的四个层次:
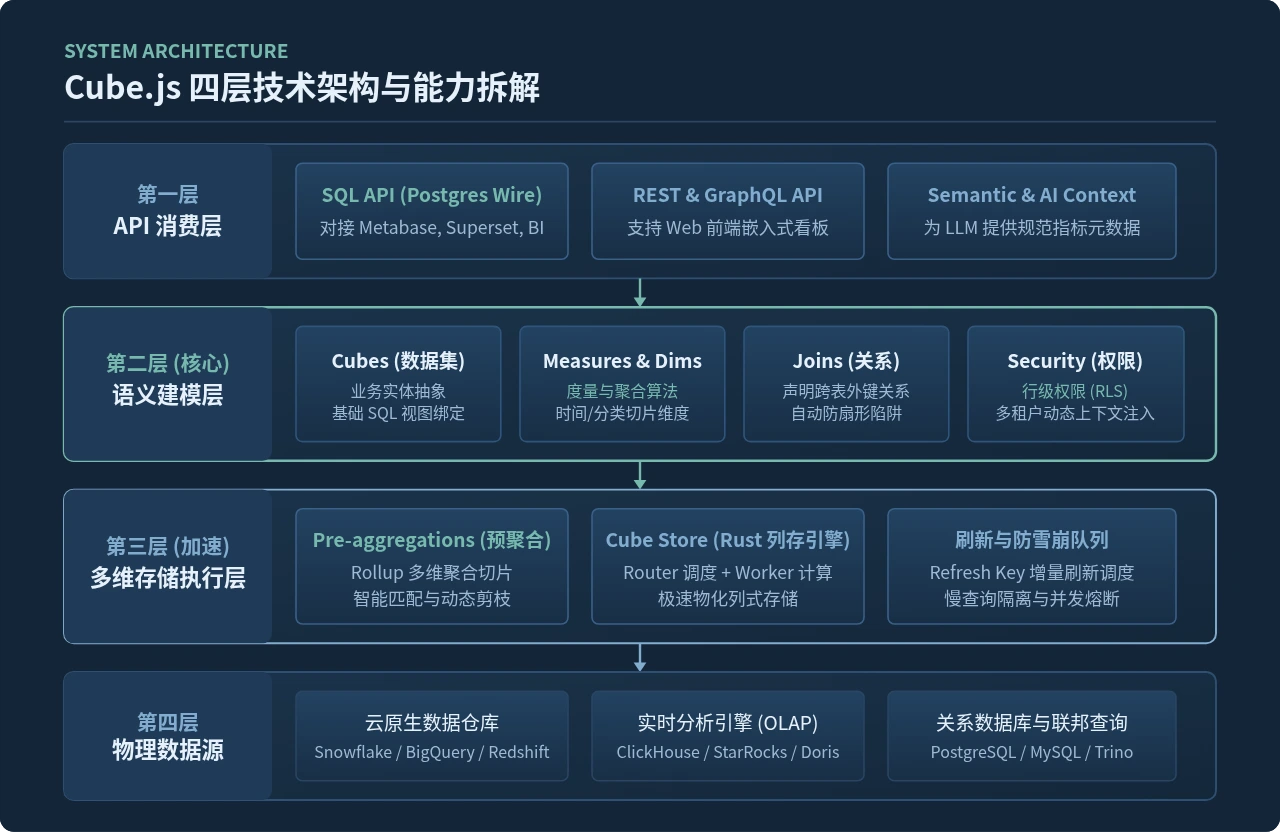
- 物理数据源层(Data Source Layer):负责对接企业现有的各类数据基础设施。Cube.js 支持数十种主流数据引擎,包括 Snowflake、Google BigQuery、Amazon Redshift 等云原生数仓,ClickHouse、StarRocks、Apache Doris 等实时 OLAP 引擎,以及 PostgreSQL、MySQL 等关系型数据库与 Trino/Presto 联邦查询引擎。Cube.js 本身不接管原始数据的持久化写入,而是作为智能计算查询代理。
- 语义建模层(Semantic Modeling Layer):系统的核心定义层。工程师使用基于声明式的 JavaScript、TypeScript 或 YAML 语言编写
Data Schema。在这里,开发者将物理数据表映射为业务认知实体(Cubes),明确声明维度(Dimensions,如按日期、省份、用户类型切片)与度量(Measures,如订单总额、去重用户数、转化率),并定义表之间的关联拓扑(Joins)与动态行级安全策略(Row-Level Security, RLS)。 - 多维存储与执行加速层(Storage & Execution Layer):Cube.js 最显著区别于普通 SQL 转换网关的关键所在。该层由专为预聚合研发的分布式列式存储引擎 Cube Store 以及智能查询调度器组成。通过定义
pre-aggregations(预聚合),系统将耗时昂贵的聚合切片预先物化至 Cube Store 中。当查询到达时,优先直接读取多维切片,避免重复穿透扫描底层数仓。同时,该层内置查询排队与防雪崩机制,确保高并发下的系统稳定性。 - 统一 API 消费层(API & Consumption Layer):Cube.js 对外暴露标准化多协议接口。包括兼容 PostgreSQL Wire 协议的 SQL API(上层工具如 Tableau、Power BI、Metabase、Apache Superset 可直接将其作为标准 Postgres 数据库连接),用于现代 Web/App 嵌入式分析的 REST API 与 GraphQL API,以及面向大语言模型(LLM)的 Semantic Context API,为 AI Agent 生成安全严谨的指标取数上下文。
二、语义建模机制:在代码中统一指标口径
在 Cube.js 中,数据模型即代码(Data Modeling as Code),这使得指标的增删改查能够纳入 Git 进行分支管理、代码审查(Code Review)和持续集成部署(CI/CD)。一个典型的数据模型由 Cubes(数据集)、Dimensions(维度)、Measures(度量)和 Joins(关联)构成。
1. 语义模型代码示例与结构剖析
以下为一个标准的电商订单分析语义模型文件(存储在项目 model/cubes/orders.js 中):
cube(`Orders`, {
  sql: `SELECT * FROM public.orders`,

  // 1. 维度:用于分组、过滤与切片
  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primaryKey: true
    },

    status: {
      sql: `status`,
      type: `string`,
      description: `订单状态:completed, pending, cancelled`
    },

    createdAt: {
      sql: `created_at`,
      type: `time`
    },

    // 衍生计算维度
    isHighValue: {
      sql: `CASE WHEN ${CUBE}.amount >= 1000 THEN '高价值' ELSE '普通' END`,
      type: `string`
    }
  },

  // 2. 度量:业务聚合指标定义(禁止上层客户端自行手写求和逻辑)
  measures: {
    count: {
      type: `count`,
      description: `订单总笔数`
    },

    totalAmount: {
      sql: `amount`,
      type: `sum`,
      format: `currency`
    },

    completedAmount: {
      sql: `amount`,
      type: `sum`,
      filters: [
        { sql: `${CUBE}.status = 'completed'` }
      ],
      description: `已完成订单总交易额`
    },

    // 复合计算度量:客单价
    averageOrderValue: {
      sql: `${completedAmount} / NULLIF(${count}, 0)`,
      type: `number`
    }
  },

  // 3. 关联关系:声明与其他 Cube 的连接方式
  joins: {
    Users: {
      relationship: `belongsTo`,
      sql: `${CUBE}.user_id = ${Users}.id`
    }
  }
});
💡 关键语法与设计规则说明
1. 宏变量 ${CUBE}:在定义字段与过滤条件时,始终使用 ${CUBE} 代表当前模型别名。Cube.js 在编译最终 SQL 时会自动分配唯一的表别名,有效防止自连接或多表关联时的列名冲突与歧义。
2. 过滤度量(Filtered Measures):如上例中的 completedAmount,业务过滤逻辑被固化在语义模型内部。无论调用方通过 SQL API 还是 REST API 查询,系统均会自动附加 status = 'completed',彻底根除“各处过滤不一致”的人为差错。
3. 复合计算度量:度量之间可以直接引用(如 averageOrderValue 引用 completedAmount 与 count),保证底层指标逻辑复用。
2. 细粒度行级安全控制(Row-Level Security, RLS)
面向多租户 SaaS 平台或企业内部分权时,不能让每个报表接口单独编写 WHERE tenant_id = xxx。Cube.js 允许在数据模型中结合上下文 COMPILE_CONTEXT 注入安全约束:
cube(`Orders`, {
  sql: `SELECT * FROM public.orders WHERE ${COMPILE_CONTEXT.securityContext.tenantId} = tenant_id`,
  // ... 其他度量与维度定义
});
当客户端携带包含 tenantId 的加密 JWT 发起查询时,Cube.js 编译引擎会自动将租户隔离条件植入到生成的每条查询 SQL 中。如果用户未传递合法租户令牌,查询将直接被语义网关拦截,从底层阻断越权访问可能。
三、多维存储内核:Cube Store 与预聚合机制深度剖析
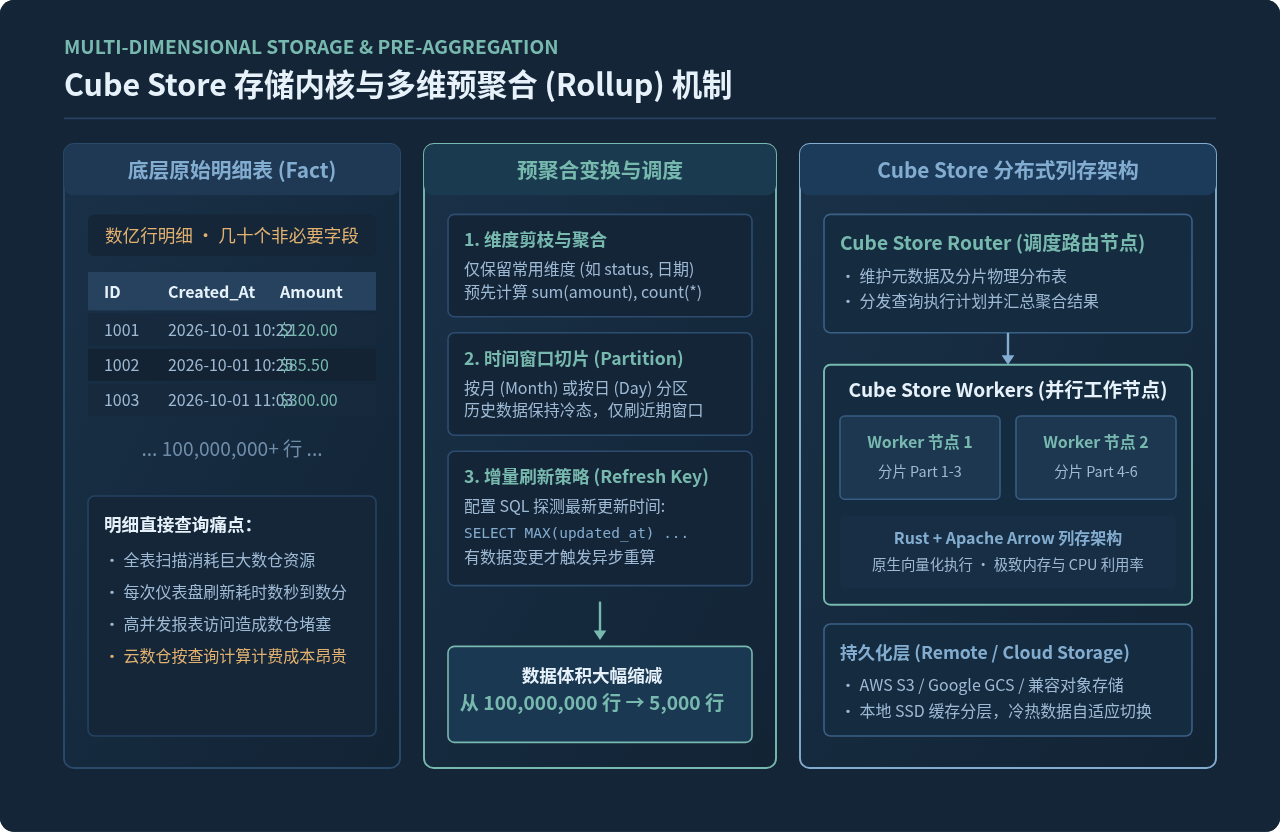
仅仅具备语义转换功能,依然不足以解决海量数据分析的性能瓶颈。如果数仓底层存储的是上亿条日志明细,上层仪表盘每次切片都要发起大规模全表扫描,数仓必然不堪重负。Cube.js 解决这一问题的核心架构是:Pre-aggregations(预聚合)+ Cube Store(专用多维列存引擎)。
1. 什么是预聚合(Pre-aggregations)
预聚合是用户在 Cube 模型中显式声明的一种物化视图规则。它指定系统按照特定维度组合(如:按天 + 按订单状态)对度量进行提前聚合计算,并将计算结果持久化存储。以下为预聚合配置示例:
cube(`Orders`, {
  // ... 基础定义略 ...

  preAggregations: {
    // 定义一个名为 dailyOrdersRollup 的多维预聚合切片
    dailyOrdersRollup: {
      type: `rollup`,
      measures: [Orders.count, Orders.totalAmount],
      dimensions: [Orders.status],
      timeDimension: Orders.createdAt,
      granularity: `day`,

      // 时间分区:按月切分,避免全量重刷
      partitionGranularity: `month`,

      // 增量刷新判定键
      refreshKey: {
        every: `10 minute`,
        sql: `SELECT MAX(updated_at) FROM public.orders`
      }
    }
  }
});当上层应用发起查询请求:“统计过去 30 天内每天不同状态的订单金额与总数” 时,Cube.js 的查询规划器(Query Planner)在语法树分析阶段会识别到该请求与 dailyOrdersRollup 完全匹配。系统将直接跳过数亿行原始明细表,转而扫描该预聚合切片(通常仅有几十到几千行数据),查询响应时间从数十秒骤降至 10~50 毫秒以内。
2. 为什么需要自研列存引擎 Cube Store?
在早期版本中,Cube.js 通常将预聚合表回写至底层数仓本身(如在 MySQL 或 Postgres 中建临时聚合表)。但团队在生产实践中遭遇了明显阻碍:
- 数仓写入并发能力有限:云数仓(如 Snowflake/BigQuery)更擅长跑大批量作业,不适合高频的小批次物化更新;
- 外部数据库资源争抢:预聚合构建占用了生产数仓宝贵的 CPU 额度,且跨库回写权限复杂;
- 网络开销与格式转换:行式存储在面对多维聚合时 I/O 效率较低。
为此,Cube 团队采用 Rust 语言完全从零研发了 Cube Store。Cube Store 是一个支持高并发、分布式的列式存储计算引擎,底层完全拥抱 Apache Arrow 内存模型与列式磁盘持久化格式,具备以下核心架构特性:
- Router / Worker 节点角色分离:Router 节点负责元数据管理、预聚合表物理分片路由、任务调度与最终聚合合并;Worker 节点负责各自分区的列存扫描、向量化本地聚合计算与后台分片压缩。
- 时间窗口水平分区(Partitioning):支持按日、按周或按月物理分区。例如,2026年10月的订单数据变更时,系统仅刷新当月分区,历史 2025 年及更早的冷分区保持原样,将数据刷新开销控制在极小范围。
- 冷热分层与云对象存储对接:Worker 节点在本地 SSD 缓存热点数据,同时支持将数据全量异步同步至 AWS S3、Google Cloud Storage 或 MinIO 等兼容对象存储中,实现计算与存储解耦和无状态水平扩展。
四、端到端运作流程:从客户端请求到响应的执行路径
理解 Cube.js 的运作本质,需要洞悉一条分析请求进入系统后的完整流转生命周期。以下图示清晰还原了内部六个执行阶段与决策分支:
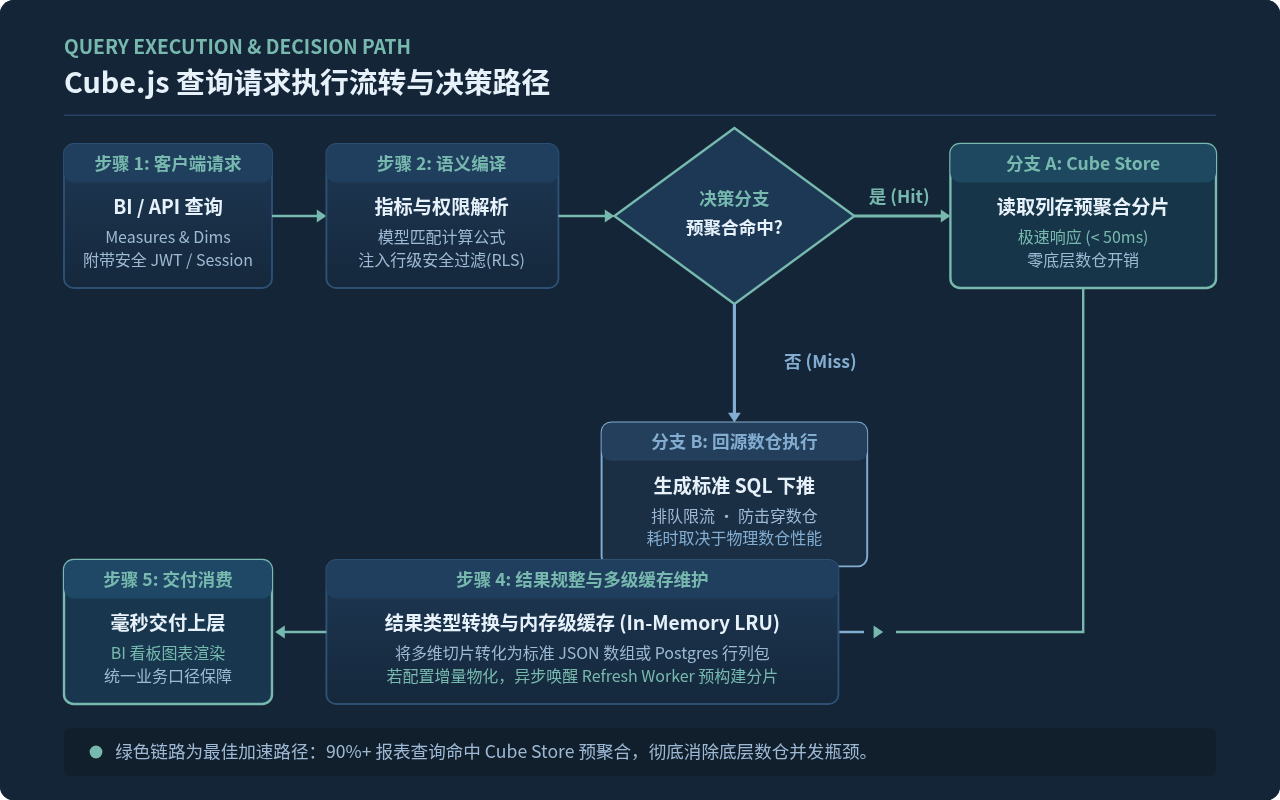
具体执行链路按如下顺序严密展开:
- 步骤 1:客户端发起统一指标请求
前端组件、自定义看板或 BI 工具通过 REST API 发送标准的 JSON 查询载荷(指定度量measures、维度dimensions、时间范围timeDimensions),或通过 SQL API 发送标准 ANSI SQL 查询语句。 - 步骤 2:语义编译与动态安全注入
Cube.js 编译器拦截请求,检索内存中的 Schema 元数据定义。编译器验证所请求的字段有效性,根据关联关系(Joins)自动计算最佳拓扑路径(防止经典的扇形陷阱 Fan-out Problem),并将 JWT 上下文中的租户过滤条件无缝编入查询语法树。 - 步骤 3:预聚合匹配与路由决策(关键决策节点)
系统执行预聚合匹配评估(Pre-aggregation Matcher):- 分支 A(命中预聚合 - 绝佳性能):若存在覆盖查询维度的 Rollup 切片,且切片处于就绪(Ready)状态,请求将被路由至 Cube Store 集群。Worker 节点利用多核并发执行向量化列存扫描,通常在 50ms 内即可完成数十万预聚合行的计算。
- 分支 B(未命中预聚合 - 回源降级):若查询包含未预聚合的生僻维度,或属于即席探索查询,系统生成针对底层特定数仓方言(Dialect)的高度优化原生 SQL,通过内置连接池推向下游物理数仓执行。此时请求进入限流防击穿队列,防止同类重复大查询压垮数仓。
- 步骤 4:多级缓存规整与异步物化触发
系统具备内存级 LRU 缓存。无论是 Cube Store 还是底层数仓返回的数据,均会在内存中维持短期结果集缓存。若该请求触发了刷新条件,后台调度器会异步向 Worker 发送任务,触发增量物化构建。 - 步骤 5:标准化响应交付
数据被格式化为符合规范的 JSON 结构或 PostgreSQL 二进制协议包,交付至上层前端或 BI 客户端进行图表渲染。
五、实操指南:从零搭建 Cube.js 服务与本地验证
为了让读者直观体验 Cube.js 的工程化落地流程,本节提供在本地开发环境中快速启动 Cube.js 并验证语义模型与预聚合的完整步骤。
1. 环境准备与项目初始化
环境要求:安装 Node.js 18.x 或更高版本、Docker(用于便捷运行 Cube Store 与测试数据库)。在终端执行以下命令创建脚手架:
# 全局安装 Cube CLI 工具
npm install -g cubejs-cli

# 创建基于 PostgreSQL 驱动的 Cube 项目
cubejs-cli create my-cube-project -d postgres

# 进入项目工作目录
cd my-cube-project
创建完成后,项目根目录会生成核心配置文件 cube.js、环境变量文件 .env 以及用于放置语义模型的 model/ 目录。
2. 环境变量配置
在项目根目录编辑 .env 文件,配置底层数据库连接与 Cube Store 参数:
# 底层业务数据源连接信息
CUBEJS_DB_TYPE=postgres
CUBEJS_DB_HOST=localhost
CUBEJS_DB_PORT=5432
CUBEJS_DB_NAME=analytics_db
CUBEJS_DB_USER=readonly_user
CUBEJS_DB_PASS=SecurePassword123

# Cube 基础配置
CUBEJS_DEV_MODE=true
CUBEJS_API_SECRET=your_super_secret_jwt_key_32chars

# 启用内置 Cube Store 作为多维预聚合引擎
CUBEJS_CUBESTORE_PORT=3030
CUBEJS_CUBESTORE_WORKER_PORT=3031
3. 编写语义模型与预聚合定义
在 model/cubes/ 目录下新建 ecommerce.js 文件,写入如下内容:
cube(`ECommerce`, {
  sql: `SELECT * FROM public.sales_orders`,

  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primaryKey: true
    },
    category: {
      sql: `category`,
      type: `string`
    },
    orderDate: {
      sql: `order_date`,
      type: `time`
    }
  },

  measures: {
    salesAmount: {
      sql: `price * quantity`,
      type: `sum`,
      format: `currency`
    },
    orderCount: {
      type: `count`
    }
  },

  preAggregations: {
    categoryDailySales: {
      type: `rollup`,
      measures: [salesAmount, orderCount],
      dimensions: [category],
      timeDimension: orderDate,
      granularity: `day`,
      refreshKey: {
        every: `1 hour`
      }
    }
  }
});
4. 启动服务与 Developer Playground 验证
在终端运行服务启动命令:
npm run dev终端将输出如下所示的服务就绪提示信息(示例输出):
[Cube.js] 🚀 Cube.js server is processing incoming queries at http://localhost:4000/
[Cube.js] 🔌 SQL API is listening on 127.0.0.1:15432
[Cube.js] 📦 Cube Store router is running on 127.0.0.1:3030
[Cube.js] 📊 Developer Playground available at http://localhost:4000/
🔍 在 Playground 中验证执行表现
打开浏览器访问 http://localhost:4000/ 进入自带的 Developer Playground。在界面中勾选 ECommerce.salesAmount 度量与 ECommerce.category 维度,点击“Run”。首回执行会提示构建并写入预聚合分片,再次点击运行,右侧执行时间将变为 5ms ~ 15ms,并在控制台明确显示 Pre-aggregation: ECommerce.categoryDailySales HIT,表明查询成功走通 Cube Store 列存链路。
5. 通过 SQL API 供第三方 BI 连接
以开源 BI 工具 Apache Superset 或 Metabase 为例,选择新增 PostgreSQL 数据库连接:
- Host:
localhost(或 Cube 部署服务器 IP) - Port:
15432(即CUBEJS_SQL_PORT默认端口) - Database Name: 任意填写或填写
cube - User / Password: 默认留空或填入在
cube.js中配置的用户认证凭据
连接成功后,BI 客户端将直接看到名为 ECommerce 的逻辑虚拟表,其中字段包含所定义的度量和维度,数据分析师拖拽报表时体验与普通数据库完全无异,但查询均受 Cube 统一语义与预聚合缓存保护。
六、架构选型生命周期与适用边界决策
任何优秀的中间件技术都有其最适用的土壤与明显的架构边界。引入 Cube.js 绝非银弹,技术决策者需要清醒评估自身的系统成熟度与业务痛点。
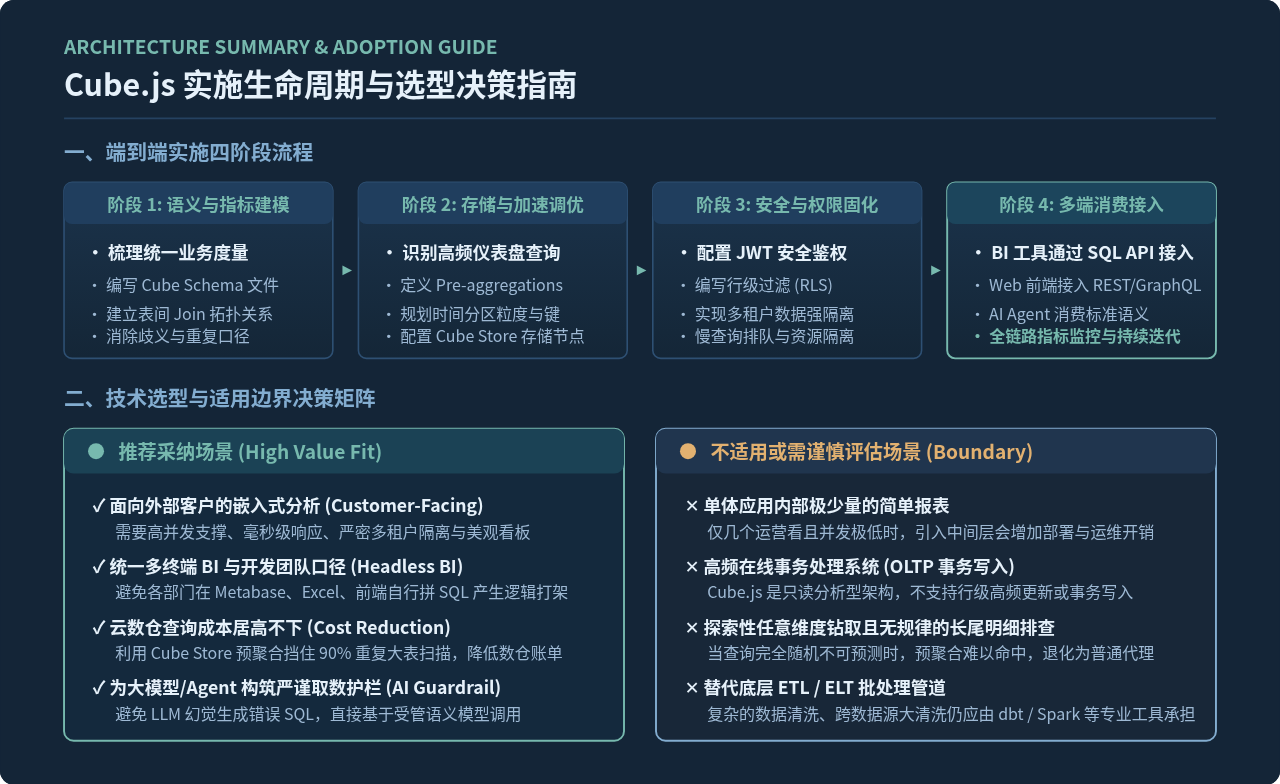
1. 技术选型决策对照表
| 评估维度 | 强烈推荐采用 Cube.js | 不推荐或需谨慎评估 |
|---|---|---|
| 业务类型 | 面向客户的嵌入式分析看板(SaaS Customer-facing Analytics)、多租户报表 | 仅供内部个别管理员偶尔查看的低并发、少指标的简易后台 |
| 指标管理现状 | 多端(BI、移动端、自研前端、对账系统)口径严重不一致,重复编写 SQL | 单一报表工具,且数据模型极为简单,不存在跨部门口径混乱 |
| 并发与性能要求 | 数百甚至数千并发访问,要求平均响应时间 < 200ms,追求极致体验 | 离线 T+1 跑批,对查询耗时(哪怕几分钟)完全不敏感 |
| 数仓成本痛点 | 云原生数仓(如 Snowflake)按扫描量计费,高频重复刷新看板账单暴增 | 本地自建高性能 ClickHouse 集群且机器资源冗余极大,负载很低 |
| 事务写入与更新 | 只读分析型负载(OLAP),数据通过数据管道批量同步 | 涉及行级强事务写入(OLTP)、账务转账高频写操作 |
⚠️ 架构边界与容易混淆的定位偏差
1. Cube.js 不是底层数据仓库的替代品:Cube.js 不负责持久存储海量原始历史明细,它依赖底层数仓作为真实数据源源头(Source of Truth)。
2. Cube.js 不是 ETL / ELT 批处理工具:跨多系统的大规模原始数据清洗、脏数据修正、复杂的去噪规则依然应在 dbt 或 Spark/Flink 等数据管道中先行完成。Cube.js 建模建立在干净、规范的数据集之上最佳。
3. 探索性无边界全量大扫描的局限:如果业务分析师需要频繁对上百个不可预测的任意组合维度做临时即席下钻,预聚合将很难命中,系统将退化为普通的 SQL 代理转发,此时应重点优化底层数仓性能而非指望预聚合。
七、高频疑难问题与调优排查手册
1. 为什么预聚合未能成功命中(Pre-aggregation Miss)?
在开发和生产排查中,经常遇到查询未能走预聚合而是穿透到底层数仓的现象。常见原因包括:
- 时间粒度不匹配:预聚合定义的是
granularity: 'day',而客户端请求传入了granularity: 'hour',由于小时粒度无法由天粒度聚合还原,匹配规则被动失效; - 维度溢出:查询请求中包含了未在预聚合
dimensions列表中声明的额外维度; - 度量不可累加性(Additive vs Non-additive):对
count_distinct(去重计数)类型的度量,如果 Rollup 维度与请求维度组合未能精确一致,系统出于结果准确性考虑会拒绝复用并回源查询,此时应评估使用HLL(HyperLogLog)近似算法或扩大 Rollup 覆盖范围。
2. 时区与时间窗口对齐偏差
时区问题是数据语义层最常见的隐形陷阱。如果底层数据库存储的是 UTC 时间,而业务看板要求按东八区(Asia/Shanghai)进行“按天”聚合,必须在环境变量中明确配置 CUBEJS_TIMEZONE=Asia/Shanghai。否则,在每天 00:00 至 08:00 之间,Cube Store 的天级别预聚合切片划分将与本地业务日期错位 8 小时,产生统计数据整体漂移。
3. Cube Store 磁盘容量与分区维护
对于千万级以上增长的业务数据集,务必开启预聚合的 partitionGranularity(如按月或按日)。如果定义无分区的巨大全量 Rollup,每当执行一次刷新,Cube Store 就需要全量重写整个列存文件,极易造成 I/O 堵塞与临时磁盘占满。设置分区后,只有当前活跃的时间窗口会产生轻量更新,冷历史数据得以持久安全封存。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章