
针对Cube.js在实际落地中最为高发的连接超时(Connection Timeout)与数据模型编译失败(Schema Validation Failure)两类典型故障,提供清晰的报错现象识别、分层根因排查步骤、代码修正示例与生产防护指南。

当前位置:首页 > Node.js 数据库开发 > 正文
Cube.js常见报错排查:连接超时与Schema校验失败
作者:栖木
时间:2026-11-02
浏览:352
文章目录
在构建指标语义层或 BI 数据看板时,开发人员往往在配置好底层数据库并定义好首批多维模型后启动服务,却频繁遭遇两类阻塞性报错:一类是在发起查询或构建预聚合时终端输出 ResourceRequest timed out、ETIMEDOUT 或查询耗时超过阈值被强制截断;另一类是在服务冷启动或保存模型文件时控制台直接抛出 Cube 'Orders' doesn't have a primary key、ReferenceError 或 YAML 缩进解析失败。这两类问题分别对应了 Cube.js 服务体系的两大核心瓶颈:底层物理网络及驱动连接池管理,以及语义建模编译器对元数据语法与拓扑约束的校验。本文将结合具体的错误日志特征,按照自底向上的顺序,逐步拆解这两类常见故障的具体成因、复现场景、排查路径及对应的生产配置调优方案。
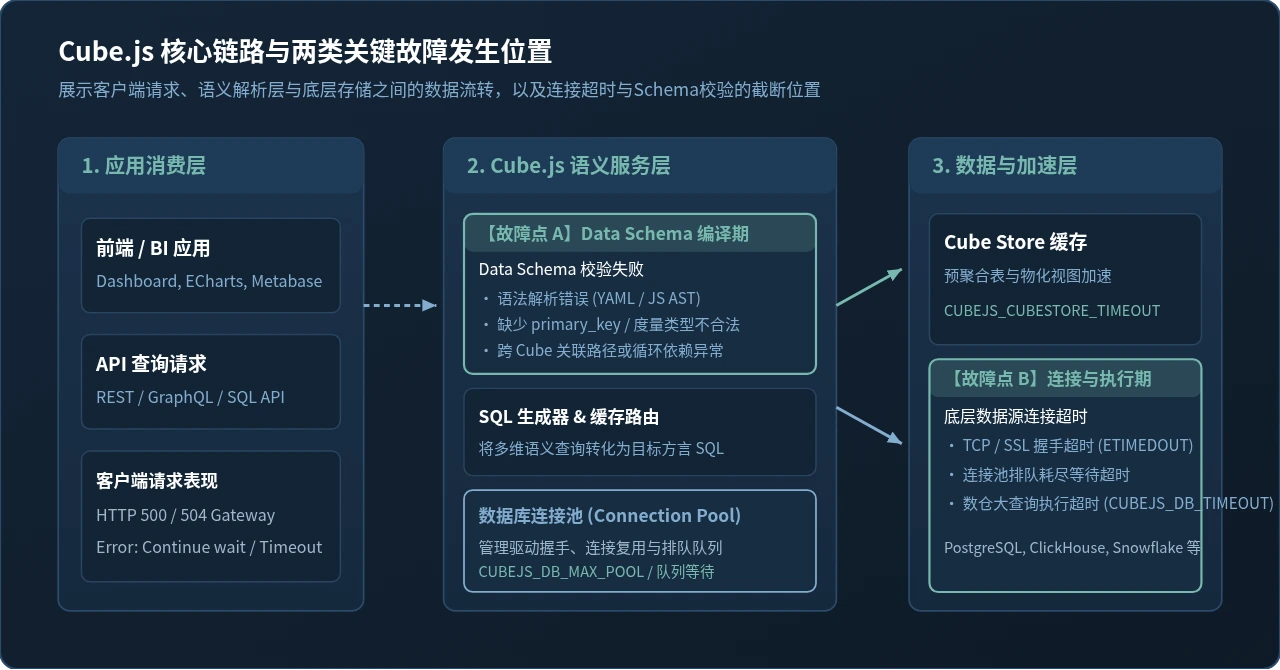
一、连接超时(Connection Timeout)报错排查与解决
假设在一个微服务或容器化部署场景中,Cube.js 实例作为独立的语义 API 服务运行在应用内网,下游挂载 PostgreSQL 或 ClickHouse 数据仓库。当客户端发起查询,或者系统触发后台预聚合刷新时,接口长时间处于 Pending 状态,最后返回 HTTP 500 或 504 错误。在排查连接超时前,首先需要通过日志的报错耗时与错误码区分故障所处的具体阶段。
1.1 典型报错形态与日志判断
在 Cube.js 服务端日志中,连接超时主要呈现为以下三种特征表现,排查思路各有侧重:
- 瞬间失败(0~2 秒内抛出):日志出现
connect ETIMEDOUT 10.x.x.x:5432或ECONNREFUSED。这说明 Cube.js 尚未完成 TCP 三次握手,请求在网络接入层或防火墙即被丢弃。 - 等待指定周期后抛出连接池获取失败:日志输出
TimeoutError: ResourceRequest timed out,通常默认在 30000ms(30 秒)后触发。这表示所有数据库连接均被长期占满或处于假死状态,新进入的查询在连接池队列中排队超时。 - 查询执行中途被中断:日志输出
Error: Query timeout of 30000ms exceeded,底层数仓同步记录canceling statement due to statement timeout。这表明 TCP 连接与鉴权成功,但目标 SQL 执行计划过于复杂或触发了锁等待。
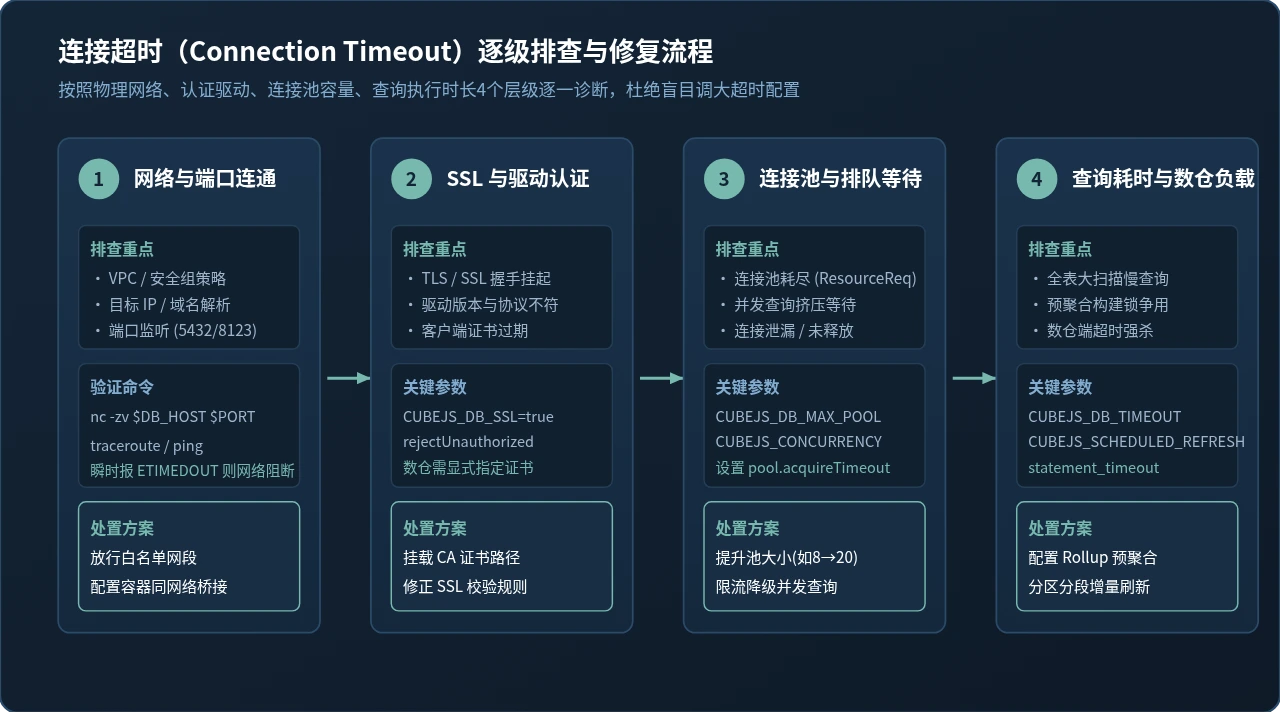
1.2 分步排查与环境修复操作
定位连接超时应严格按照网络可达性、SSL/TLS 握手、连接池饱和度、SQL 性能的顺序展开,避免未经验证直接盲目调大超时阈值:
第一步:验证容器/主机间网络与端口通畅性
如果在 Docker 或 Kubernetes 集群中部署,需确保 Cube.js 所在的 Pod/容器与目标数据库在同一网络平面或 VPC 路由可达。在 Cube.js 运行实例中直接执行探测命令:
SHELL 连通性测试命令
# 进入容器环境后测试数据库端口连通性
nc -zv postgres-cluster.internal 5432

# 测试如果底层使用 ClickHouse HTTP 接口
curl -Iv http://clickhouse-server.internal:8123/ping
若探测返回超时或丢包,需优先在云厂商控制台检查安全组入方向规则,将 Cube.js 节点 IP 网段加入目标数据库的白名单。
第二步:核对 SSL 与加密握手配置
许多现代云原生数仓(如 AWS RDS、Snowflake、Supabase)默认强制开启 SSL/TLS 加密。如果 Cube.js 未显式配置 SSL,某些驱动会无限等待服务端握手响应直至挂起。在项目根目录的 .env 文件中,需根据数据库要求配置证书及验证行为:
.env 数据库连接基础配置
# 数据源驱动类型与网络端点
CUBEJS_DB_TYPE=postgres
CUBEJS_DB_HOST=postgres-cluster.internal
CUBEJS_DB_PORT=5432
CUBEJS_DB_NAME=analytics_prod
CUBEJS_DB_USER=cube_service_user
CUBEJS_DB_PASS=YourSecurePassword123

# SSL 配置:如果使用自签名证书或云平台内网证书,合理指定 rejectUnauthorized
CUBEJS_DB_SSL=true
CUBEJS_DB_SSL_REJECT_UNAUTHORIZED=false
第三步:调整连接池容量(Connection Pool)避免排队饿死
Cube.js 内部采用通用连接池管理数据库会话。默认连接池并发上限较小(通常为 8 个)。当 Dashboard 上的多个组件同时向 Cube.js 请求数十个指标时,并发查询瞬间超出容量上限,排在队尾的查询就会在获取连接时超时抛出 ResourceRequest timed out。
可在 .env 中针对性扩大最大连接池上限,并合理设置连接等待时长:
.env 连接池与执行超时参数调优
# 最大底层数据库连接池容量(建议根据数仓承载力设置为 16~30)
CUBEJS_DB_MAX_POOL=20

# 数据库单次查询超时时间(单位:毫秒,默认 30000ms,按需调整至 60000ms)
CUBEJS_DB_TIMEOUT=60000

# 等待可用连接的超时阈值(避免客户端无限挂起)
CUBEJS_DB_POLL_TIMEOUT=120000

# 启用 Cube Store 缓存加速层时的通信超时
CUBEJS_CUBESTORE_TIMEOUT=60000
第四步:排查慢查询与数仓锁竞争
如果调大 CUBEJS_DB_MAX_POOL 后仍偶发超时,说明是由于某些未经预聚合的大宽表关联查询耗费了数十秒,一直霸占着连接池中的会话通道。以 PostgreSQL 为例,可在数据库管理端执行查询定位长时间运行的查询进程:
SQL 慢查询排查语句 (示例)
SELECT pid, now() - pg_stat_activity.query_start AS duration, query, state
FROM pg_stat_activity
WHERE state != 'idle' AND query LIKE '%cube%'
ORDER BY duration DESC;
如果发现大量全表扫描语句,应通过后文介绍的预聚合(Pre-aggregations)机制将高频多维计算提前物化到 Cube Store 中,从根本上释放底层数据库连接池的压力。
二、Schema 校验失败(Schema Validation Failure)报错排查与解决
Cube.js 与传统直接编写 SQL 的 ORM 框架不同,其核心依赖于 Data Schema(数据模型)的编译解析。模型文件定义在 schema/ 目录下,可使用 JavaScript(.js)或 YAML(.yml)格式书写。在服务启动或代码热重载时,Cube.js 编译器会静态扫描所有模型并构建语义拓扑图。一旦存在语法违规、必填项缺失、字段引用错误或循环依赖,便会直接中断编译并阻断服务。
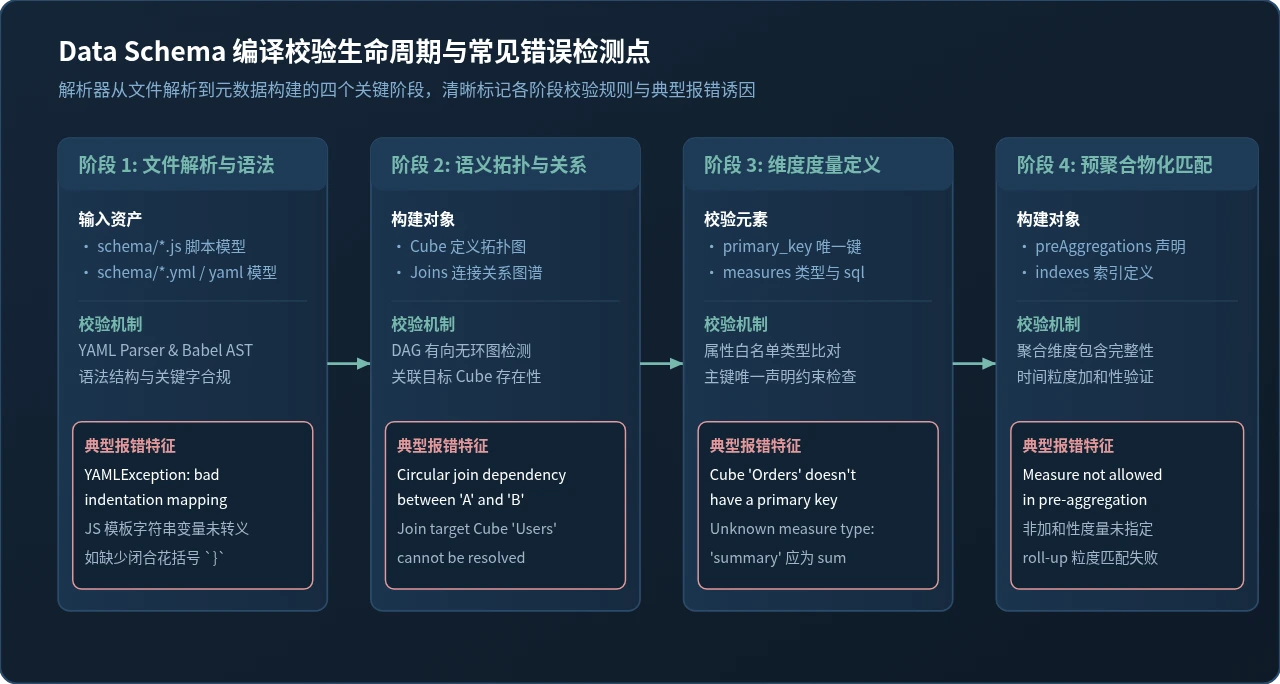
2.1 常见校验错误原因与代码对比
以下是开发者在编写模型时最为高发的三类 Schema 校验失败报错,每一类均有严格的格式规范:
报错 1:缺少 Primary Key 导致主键校验失败
典型日志:Error: Cube 'Orders' doesn't have a primary key. Please add a dimension with 'primary_key: true'.
产生原因:Cube.js 在跨 Cube 联表计算指标时,必须依赖主键去重以防止度量出现扇出(Fan-out)重复累加。如果一个 Cube 未声明任何主键维度,编译器会抛出校验异常。
错误示范:未声明主键维度
cube(`Orders`, {
  sql: `SELECT * FROM public.orders`,

  dimensions: {
    id: {
      sql: `id`,
      type: `number`  // 缺少 primary_key: true 声明
    },
    status: {
      sql: `status`,
      type: `string`
    }
  }
});
正确示范:显式声明主键与复合主键
cube(`Orders`, {
  sql: `SELECT * FROM public.orders`,

  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primary_key: true  // 修复:显式指定主键约束
    },
    status: {
      sql: `status`,
      type: `string`
    }
  }
});注意事项:如果底层数据表本身没有单一自增主键(如按天汇总的联合日志表),可以在 SQL 层通过拼接字段构建合成主键,例如 sql: `CONCAT(date, '_', user_id)`,并标记 primary_key: true。
报错 2:度量类型不合法或缺少必需属性
典型日志:Unknown measure type: summary 或 Measure of type 'count' shouldn't have sql attribute, use 'countDistinct' instead。
产生原因:Cube.js 度量类型仅支持受限的内置枚举(如 count, countDistinct, sum, avg, min, max, number)。常见的混淆点是:类型为 count 时不需要也不能指定 sql(会自动生成 COUNT(*));如果需要对特定列计数或排重,必须使用 countDistinct 或 countDistinctApprox 并指定目标列。
规范示例:标准化定义 Measures
measures: {
  // 正确:普通统计行数,无需定义 sql 字段
  count: {
    type: `count`
  },

  // 正确:去重统计唯一访客,必须指定 sql
  distinctUsers: {
    sql: `user_id`,
    type: `countDistinct`
  },

  // 正确:金额汇总,指定数值字段
  totalAmount: {
    sql: `amount`,
    type: `sum`
  }
}
报错 3:跨 Cube 关联(Joins)字段引用语法错误与循环依赖
典型日志:ReferenceError: Target cube 'Users' is not defined 或 Circular join dependency detected: Orders -> Users -> Orders。
产生原因:Cube.js 的 joins 属于单向关系图。定义关联关系时,必须使用模板占位符 ${CUBE} 代表当前模型,使用 ${TargetCube.dimension} 引用目标模型的维度。如果两个 Cube 互相在自己的配置中声明 join 对方,就会形成拓扑环路导致循环依赖报错。
YAML 规范示例:正确的单向 Join 与引用路径
cubes:
  - name: orders
    sql: SELECT * FROM public.orders

    joins:
      - name: users
        sql: "{ CUBE }.user_id = { users.id }"
        relationship: many_to_one  # 声明关系基数

    dimensions:
      - name: id
        sql: id
        type: number
        primary_key: true

      - name: user_id
        sql: user_id
        type: number
2.2 本地静态校验实操:利用 CLI 在发布前发现错误
许多团队只有在将服务部署到测试环境后,才通过容器退出日志发现 Schema 校验失败。实际上,Cube.js 官方提供了内置的静态模型校验工具。在修改模型后,可以在本地命令行或 CI 流水线中执行验证:
SHELL 模型校验命令
# 校验 schema 目录下所有 YAML / JS 文件的语法与依赖拓扑
npx cubejs-cli check

# 示例验证通过输出:
# ✓ Schema compiled successfully. 4 cubes and 2 views validated. 0 errors found.
如果存在错误,CLI 会精确打印出错的文件路径、行号及具体缺失的属性字段,大幅提升排错效率。
三、综合排查清单与长效防范机制
为了在复杂多维分析项目中防患于未然,避免因连接超时与 Schema 校验错误影响生产可用性,建议在工程架构中落地以下三项预防机制:
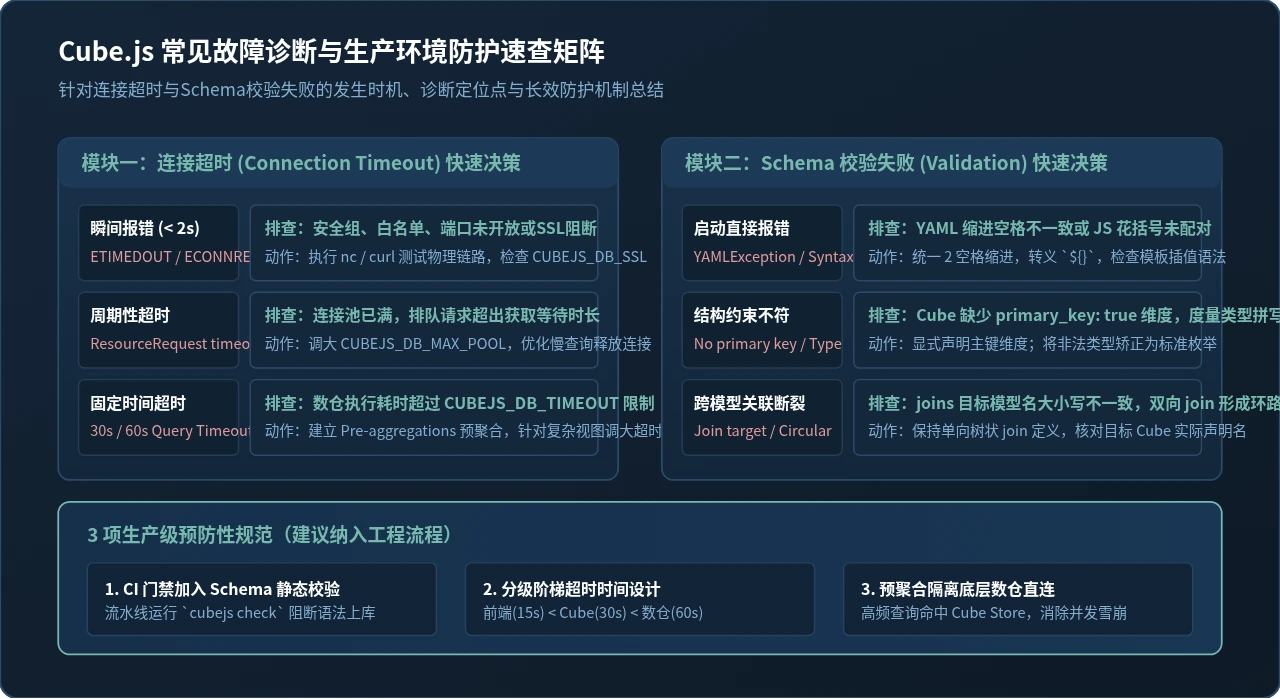
3.1 分级阶梯超时时间设计
超时时间的设置必须遵循逐层放宽的阶梯原则,杜绝上游超时时间长于下游导致资源泄漏:
| 系统分层 | 典型推荐阈值 | 配置所在位置 | 超时策略说明 |
|---|---|---|---|
| 前端 / BI 调用端 | 15 秒 ~ 20 秒 | Axios / Fetch 客户端 | 超时即向用户提示重试,切断前端无效等待 |
| Cube.js API 与连接池 | 30 秒 ~ 45 秒 | CUBEJS_DB_TIMEOUT |
Cube.js 语义层主动中断长时间未返回的慢任务 |
| 底层数仓 / 数据库 | 60 秒 ~ 120 秒 | statement_timeout |
数据库层最后保底,强杀耗尽系统资源的恶劣 SQL |
3.2 合理配置 Pre-aggregations 降低连接池争用
连接超时的根本原因往往是分析型聚合 SQL 过重。通过在 Schema 中定义预聚合(Pre-aggregations),Cube.js 会在后台将聚合计算结果写入 Cube Store(基于 DuckDB / RocksDB 的专用缓存引擎)。后续前端无论发起多么复杂的分组计算,均直接命中预聚合表,底层数据库连接仅在定时增量抽取时占用数秒,彻底解耦并发查询对数据仓库连接的消耗:
预聚合定义示例 (schema/Orders.js)
cube(`Orders`, {
  sql: `SELECT * FROM public.orders`,

  pre_aggregations: {
    // 定义每日订单汇总预聚合
    dailyOrdersRollup: {
      measures: [Orders.count, Orders.totalAmount],
      dimensions: [Orders.status],
      time_dimension: Orders.createdAt,
      granularity: `day`,
      partition_granularity: `month`,  // 按月分区物化,加速增量更新
      refresh_key: {
        every: `1 hour`  // 每小时增量刷新
      }
    }
  },

  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primary_key: true
    },
    createdAt: {
      sql: `created_at`,
      type: `time`
    },
    status: {
      sql: `status`,
      type: `string`
    }
  },

  measures: {
    count: {
      type: `count`
    },
    totalAmount: {
      sql: `amount`,
      type: `sum`
    }
  }
});
3.3 验证问题已根治的判断标准
完成上述排查与优化后,可通过以下三项可观测指标确认服务已恢复稳态:
- Schema 启动编译零报错:服务启动日志中输出
Cube.js server (0.35.x) is listening on 4000,无任何YAMLException、primary key或ReferenceError警告。 - Playground 查询秒级响应:在本地运行
npx cubejs-cli dev打开管理后台(http://localhost:4000),选择对应 Cube 的维度与度量发起 Execute,查询在 500ms 内完成,右下角状态显示Match pre-aggregation或执行耗时在安全区间。 - 连接池状态平稳:高并发打压下,底层数据仓库活动连接数稳定在
CUBEJS_DB_MAX_POOL设定的阈值范围内,不再出现因连接池排队饿死而引起的ResourceRequest timed out日志。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章