
深入解析 Cube.js 预聚合 (Pre-aggregations) 的配置方法与查询加速底层机制,涵盖 Rollup、分区增量刷新、非可加度量避坑指南与生产调优实战。

当前位置:首页 > Node.js 数据库开发 > 正文
Cube.js预聚合(Pre-aggregations)配置与查询性能优化
作者:霁月
时间:2026-11-03
浏览:134
文章目录
Cube.js 性能工程
数据架构
阅读时长约 15 分钟
发布状态: 生产落地实践指南
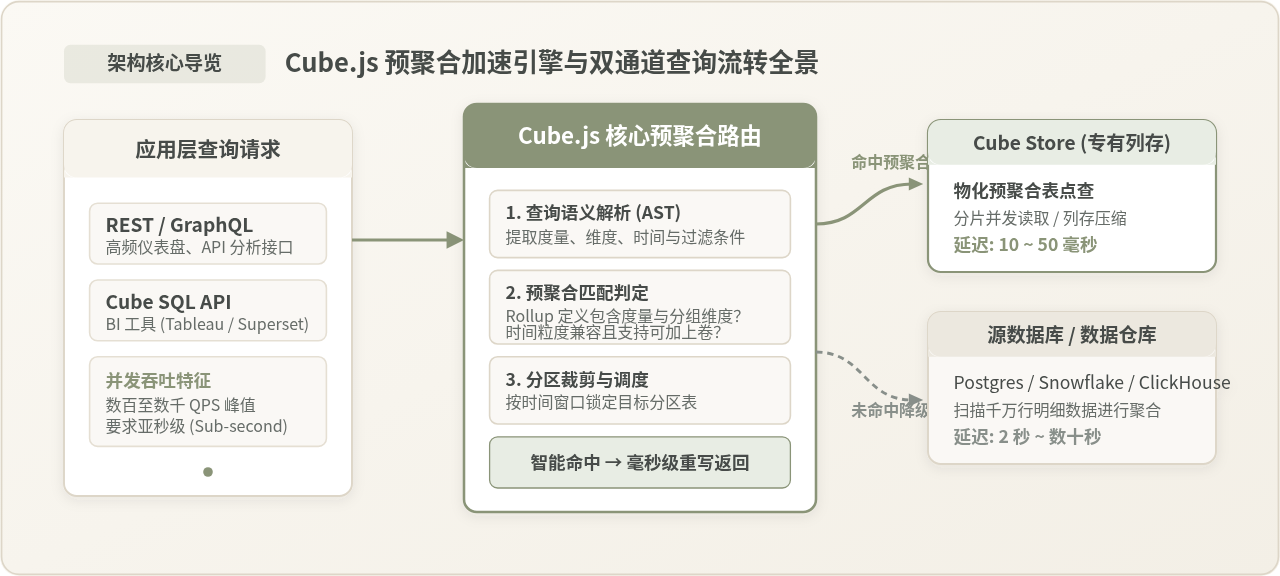
Cube.js 的预聚合(Pre-aggregations)是解决分析型应用在高并发与海量数据场景下查询缓慢的核心利器。其本质是将原本运行时耗时巨大的 SQL 聚合计算,转化为在后台预先构建并物化到高性能列式存储(Cube Store 或底层数据库表)中的中间汇总结果。当业务端发起多维查询时,Cube.js 路由器会自动将针对源表数千万乃至数亿行的扫描,重写为针对预聚合表的轻量索引检索,将查询延迟由数秒或数分钟降至 10~50 毫秒。本文系统拆解预聚合的内部运行机制、标准配置链路、增量分区策略与常见认知误区,帮助工程团队在保障实时性与存储成本平衡的前提下,构建高吞吐的语义层分析系统。
一、预聚合的核心运作机制与分层架构
在传统 BI 与嵌入式分析系统中,直接向云数据仓库(如 Snowflake、BigQuery、ClickHouse、PostgreSQL 等)发起复杂的多维聚合查询存在显著短板:随着行数增长与并发请求叠加,仓库的 CPU 和 I/O 会迅速逼近瓶颈,导致前端页面卡顿甚至超时。
Cube.js 引入的预聚合层位于应用查询入口与物理数据源之间。当 Cube.js 接收到客户端的 JSON 规范查询或 SQL API 查询时,它不会立即向底层数据库下发原生 SQL,而是通过内置的编译器与优化器完成语法树解析(AST),并交由预聚合匹配器(Pre-aggregation Matcher)进行评估。
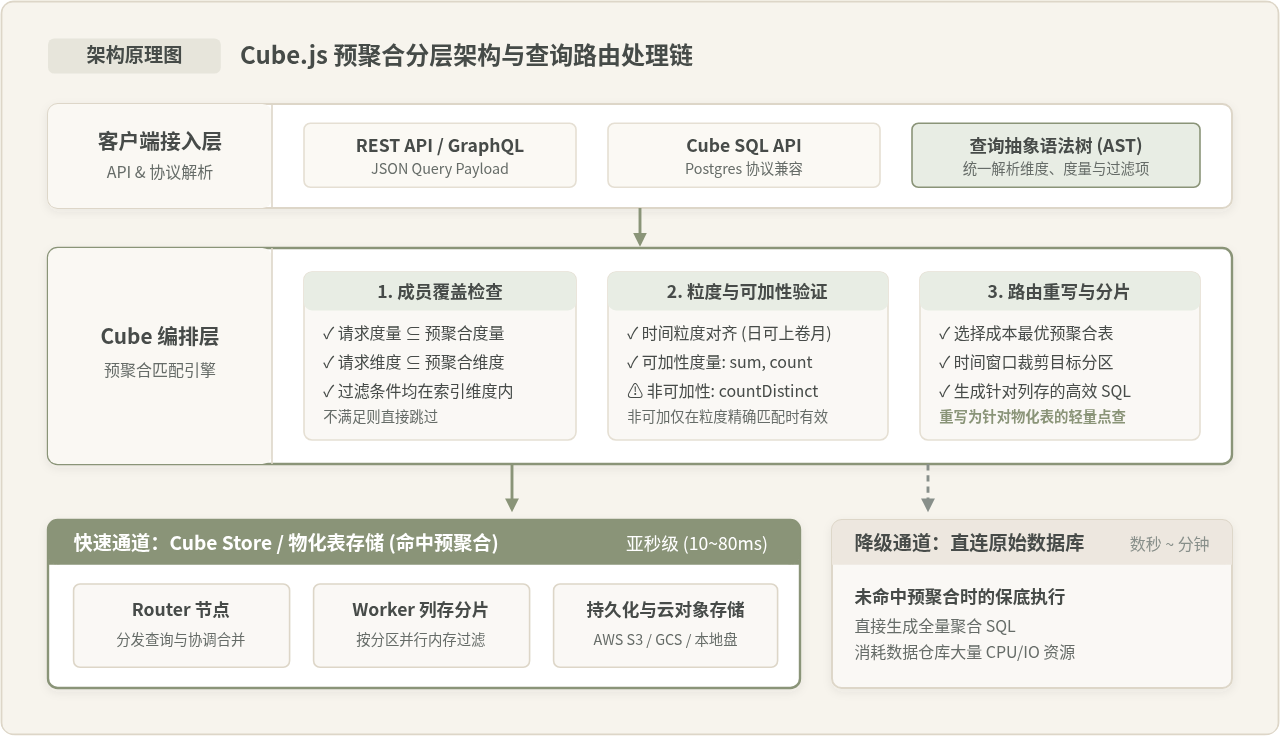
从架构层面看,整个查询与数据流动包含以下核心模块:
- 语义分析与匹配判定:Cube.js 检查查询所需的度量(Measures)、分组维度(Dimensions)、过滤条件(Filters)以及时间粒度(Granularity),并在已配置的预聚合集合中寻找能够完全覆盖该查询的候选表。
- 双通道执行路由:如果找到匹配的预聚合表,Cube.js 将查询重写为针对该物化表的精简 SQL,直接下发给 Cube Store 执行;如果没有任何预聚合满足条件,则触发降级机制,将原生聚合 SQL 发送给底层数据仓库。
- Cube Store 专用列式缓存:Cube Store 是 Cube 官方打造的分布式 Rust 引擎,基于 Apache Arrow 与 DataFusion 构建,采用列式压缩存储格式。它支持将物化表分片加载到内存与本地 NVMe 盘中,同时支持异步持久化到云对象存储(AWS S3、GCS 等),实现亚秒级的低延迟点查。
二、核心配置实战:从简单 Rollup 到多维跨模型聚合
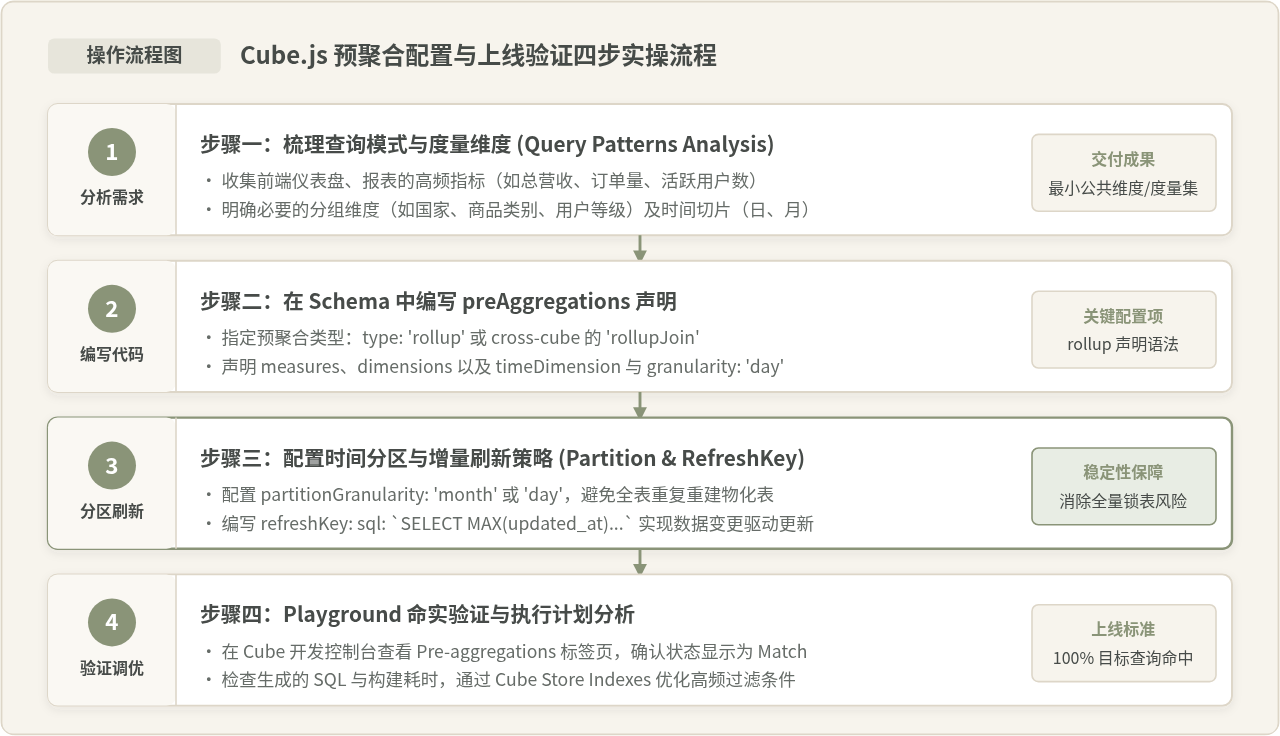
在 Cube.js Schema 中,预聚合定义在各数据模型(Cube)的 preAggregations 代码块内。最基础也是最广泛使用的预聚合类型是 rollup。
1. 单一 Cube 的典型 Rollup 配置
以下为一个标准的电商订单分析 Cube 示例,演示如何配置包含时间维度、分类维度与核心度量的预聚合模型:
cube(`Orders`, {
  sql: `SELECT * FROM public.orders`,

  measures: {
    count: {
      type: `count`
    },

    totalAmount: {
      sql: `amount`,
      type: `sum`
    },

    avgAmount: {
      sql: `amount`,
      type: `avg`
    }
  },

  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primaryKey: true
    },

    status: {
      sql: `status`,
      type: `string`
    },

    createdAt: {
      sql: `created_at`,
      type: `time`
    }
  },

  preAggregations: {
    // 订单状态与日级总览预聚合
    ordersDailyRollup: {
      type: `rollup`,
      measures: [count, totalAmount],
      dimensions: [status],
      timeDimension: createdAt,
      granularity: `day`,
      partitionGranularity: `month`,
      refreshKey: {
        every: `1 hour`
      },
      indexes: {
        statusIdx: {
          columns: [status]
        }
      }
    }
  }
});
2. 跨模型关联聚合:rollupJoin
在复杂的业务分析中,报表往往需要跨表统计(例如按商品的分类名称统计订单销售额)。若每次查询都实时 JOIN 大表,耗时极高。Cube.js 提供了 rollupJoin,允许跨已建立关联的 Cube 组合预聚合:
cube(`OrderAnalysis`, {
  preAggregations: {
    // 跨 Orders 和 Products 的联合预聚合
    categorySalesRollup: {
      type: `rollupJoin`,
      measures: [Orders.totalAmount, Orders.count],
      dimensions: [Products.categoryName],
      timeDimension: Orders.createdAt,
      granularity: `day`
    }
  }
});
配置要点:rollupJoin 要求涉及的底层 Cube 必须存在明确的 joins 关系,且底层各个 Cube 自身通常已定义好各自的 rollup,Cube 会在构建阶段协调各节点完成增量物化与连接。
三、大规模时序数据优化:分区管理与增量刷新
当数据量达到千万级或亿级时,全量重建预聚合表是不切实际的:每次刷新都要扫描全表,既会导致数据源 CPU 飙升,也会导致长时间锁表或 Cube Store 构建队列阻塞。解决这个问题的核心武器是分区(Partitions)与探针刷新机制(RefreshKey)。
1. 合理设置 partitionGranularity
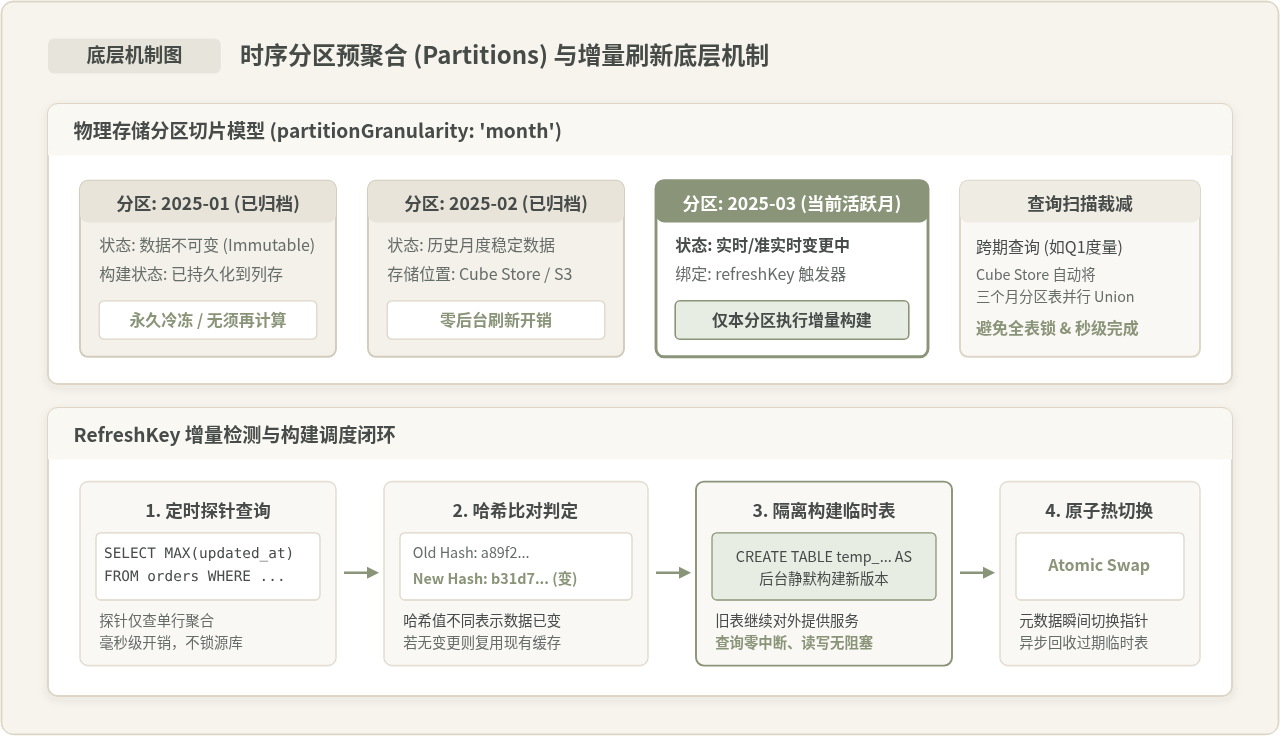
通过声明 partitionGranularity: 'month' 或 partitionGranularity: 'day',Cube.js 会按照时间维度将预聚合表物理拆分为多个独立的小分片表(如 orders_daily_rollup_2025_01, orders_daily_rollup_2025_02):
- 历史已结算分区冷冻:对于过去月份(如 1 月、2 月),业务数据已不再变更,Cube.js 构建一次后便将其状态冻结,后续刷新调度会完全跳过这些冷数据分区。
- 活跃分区增量构建:后台刷新任务仅专注于当前月份(或当前天)的分区,大幅降低源库负载与构建时间。
- 透明多表合并:前端查询跨季度(如查看近 6 个月趋势)时,Cube Store 会在底层并发读取对应的 6 个分区表并在内存中快速合并聚合,上层应用无感知。
2. 编写高效的 SQL RefreshKey
默认的基于固定时间的刷新(如 every: '1 hour')属于盲目轮询。如果数据没有更新,重复构建会浪费算力;如果数据提前写入,固定时间又会导致延迟。最佳实践是使用 SQL 探针:
refreshKey: {
  sql: `SELECT MAX(updated_at) FROM public.orders WHERE created_at >= ? AND created_at < ?`,
  every: `5 minutes`
}
在配置了分区的预聚合中,SQL 中的 ? 占位符会自动替换为当前分区的起止时间戳。Cube.js 定时以极小的开销执行这条探针 SQL,提取哈希摘要值;仅当哈希发生变动时,才真正触发后台临时表的构建,并在完成后通过原子热替换生效。
3. 构建窗口修剪:buildRangeStart 与 buildRangeEnd
对于拥有 10 年历史数据的系统,很多时候前端报表仅展示近 1~2 年的数据。通过配置 buildRangeStart: { sql: `SELECT NOW() - INTERVAL '730 day'` },可以显式阻止 Cube.js 去物化过于陈旧的历史分区,从而节省可观的磁盘存储与初始化构建时间。
四、常见认知误区与规避策略
在实际项目落地中,许多开发者容易对预聚合产生一些直觉性错误理解。以下梳理三种最具代表性的误区并分析其成立边界:
误区一:“预聚合配置得越多越好,能把所有报表组合都覆盖”
看似合理的理由:每个查询如果都有专属的预聚合,所有 API 请求都能直接命中物化表,达到极速响应。
事实与修正:预聚合本质是用存储空间与构建算力换取查询时间。如果为一个包含 10 个维度的宽表配置过多排列组合的 Rollup,会带来以下严重后果:
- 构建风暴(Build Storm):数十个预聚合表在数据更新时并发争抢源数据库连接与 Cube Store CPU,可能导致源库瘫痪。
- 存储爆炸:每个物化分片都会占用磁盘与内存。多维组合的笛卡尔积可能导致预聚合表总容量甚至超过原始表数倍。
- 优化原则:遵循“最小覆盖集”准则。优先配置 1~2 个包含核心分组维度的日级 Rollup。由于加法度量支持上卷,高维度的 Rollup 可以被低维度的子查询直接复用。
误区二:“只要配了预聚合,所有带有过滤条件的查询都会自动变快”
看似合理的理由:预聚合表已经把几千万行压缩到了几万行,带任意过滤条件查询都应该很快。
事实与修正:Cube.js 的预聚合命中规则极为严格:查询所引用的所有维度(包括过滤条件 filter 涉及的维度),必须全部存在于预聚合的 dimensions 列表中。如果查询写了 filters: [ { member: 'Orders.city', operator: 'equals', values: ['北京'] } ],而预聚合仅定义了 dimensions: [status],即使度量完全匹配,Cube.js 也会判定未命中(Cache Miss),直接降级为原始全表扫描!
优化方法:将高频过滤字段纳入 dimensions,并在预聚合定义中显式增加 indexes,例如 indexes: { cityIdx: { columns: [city] } },让 Cube Store 利用列存稀疏索引快速过滤定位。
误区三:“非可加度量(如 Count Distinct)可以像 Sum 一样随意按日跨月上卷”
看似合理的理由:既然日维度的独立访客数(UV)已经算出来了,求整月 UV 时把每天的 UV 累加起来就行。
事实与修正:数学上 countDistinct 是典型的非可加性度量(Non-additive Measure)。同一用户在 3 月 1 日和 3 月 2 日均访问过,跨天直接求和会导致严重的重复计算。因此,当查询按“月”请求精确 countDistinct 时,Cube.js 严禁将“日级预聚合”上卷合并,会导致匹配失效降级。
解决方案:
- 如果必须精确去重,必须针对“月”粒度单独定义专用 Rollup;
- 在海量流量分析中,推荐使用 HyperLogLog 近似算法:Cube.js 原生支持
count_distinct_approx。HLL 的状态摘要支持分布式二进制合并,日级 HLL 预聚合可以毫秒级合并得到准确率在 98.5% 以上的月级/年级去重指标。
五、预聚合命中排查与性能调优决策全景
当业务发现某个分析接口未达到毫秒级预期时,需要系统化梳理排查链路与调优决策。
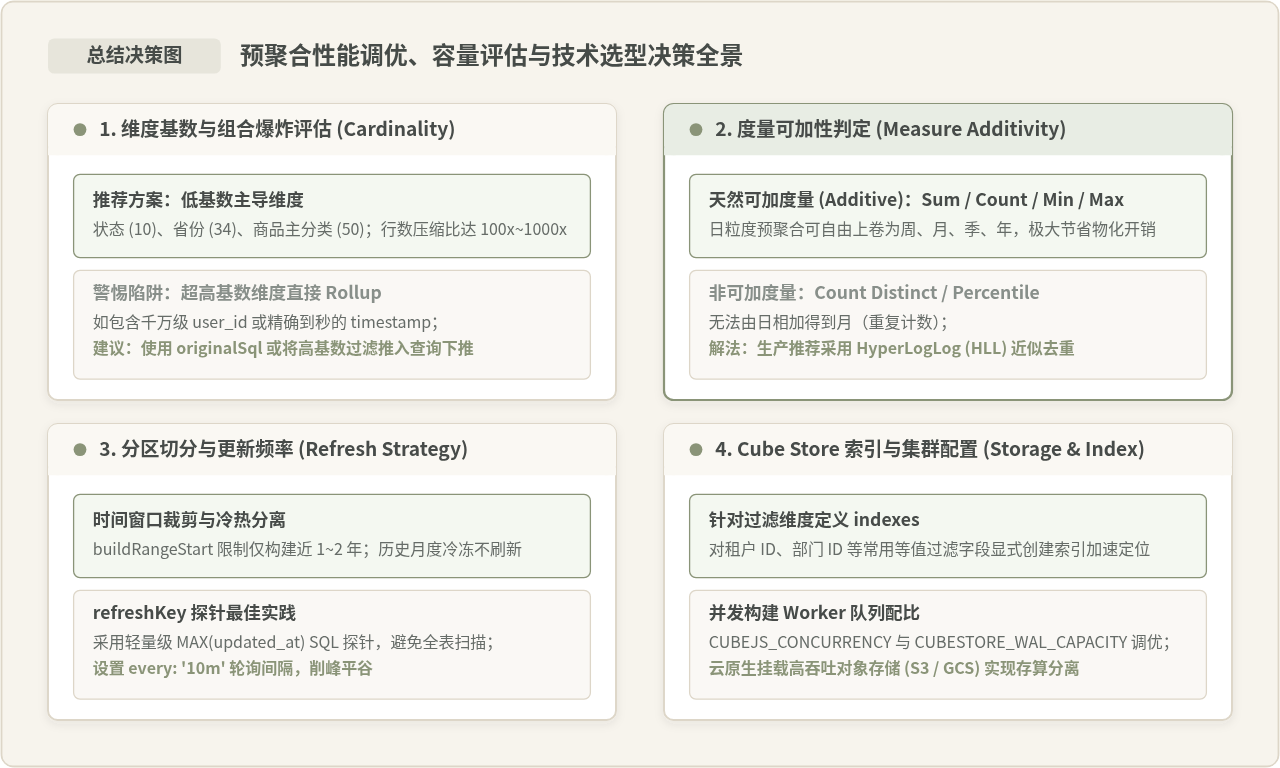
1. 如何验证预聚合是否真正生效
在日常开发与测试中,切勿仅凭页面响应时间主观猜测,应采用以下标准排查方法:
- 使用 Cube.js Playground:打开本地或测试环境的
http://localhost:4000,在查询页面点击右下角Query Inspector,切换至Pre-aggregations标签页。如果命中,会显示绿色“Match found: Orders.ordersDailyRollup”;若未命中,会详尽展示匹配失败的具体原因(如缺少维度、度量不兼容等)。 - REST API 响应头与元数据排查:在发起查询请求时附带
trace: true参数,Cube.js 会在返回的 JSON 中输出usedPreAggregations字段,列出本次查询命中的所有分区表名及实际构建执行耗时。
2. Cube Store 核心运行参数调优
在生产环境中,合理配置 Cube Store 的环境变量对高并发吞吐至关重要:
| 环境变量 | 默认值 / 推荐值 | 优化作用与调优场景 |
|---|---|---|
CUBEJS_CONCURRENCY |
默认 2 / 推荐 4~8 | 控制向底层数据库同时拉取预聚合构建任务的并发连接数,防止打垮只读从库。 |
CUBESTORE_WAL_CAPACITY |
默认 1048576 (1MB) / 推荐 16MB | Cube Store 预写日志容量,增大可提升高频分片写入与批量落盘吞吐。 |
CUBEJS_SCHEDULED_REFRESH_TIMER |
默认 true / 30s | 预聚合刷新检查轮询间隔。时效性要求高的系统可调低至 10s。 |
CUBESTORE_REMOTE_DIR |
s3://bucket/path | 配置远程对象存储持久化,实现 Cube Store 集群存算分离与 Worker 无状态水平扩容。 |
六、生产环境落地核对清单
在将包含预聚合配置的模型发布至生产环境前,建议按照以下清单逐一核验:
- 覆盖度量与过滤字段:确认关键报表所需的所有聚合度量及常用
filters字段已完整声明在预聚合定义中。 - 启用时间分区:涉及千万级以上时序数据的预聚合,已配置
partitionGranularity: 'month'或'day',严禁全量无分区单表。 - 配置增量探针 RefreshKey:使用针对业务修改时间戳的
MAX(updated_at)探针 SQL 代替无脑的定时高频轮询。 - 合理限制构建区间:配置
buildRangeStart,避免历史陈旧无效数据占用构建时间与存储。 - 索引关键维度:对租户标识、组织 ID、分类状态等高频筛选维度配置
indexes,提升点查效率。 - 非可加度量单独把控:对
countDistinct度量明确其上卷需求,高并发场景优先采用count_distinct_approx(HLL)。 - 验证构建时长与锁表影响:在低峰期试运行初始构建,确认源数据仓库未产生排他锁或长时间高负载。
- Playground 真实抽样检验:在 Inspector 中验证 100% 预期查询均显示绿色
Match Found,且执行耗时稳定在 100ms 以内。
通过建立严谨的预聚合设计体系,数据开发人员可以在保护源数据仓库平稳运行的同时,为应用层提供毫秒级、高并发的多维交互式分析体验,真正兼顾工程成本与用户体验。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章