
深入解析在JavaScript中处理十万至千万级大规模数据随机排序时的性能瓶颈,从算法复杂度、V8内存布局、类型化数组到Web Worker零拷贝转移,提供完整落地的性能优化策略。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript大规模数据随机排序的性能优化策略
作者:极速慢跑
时间:2026-11-22
浏览:201
文章目录
在 JavaScript 中对数万到数千万量级的数据进行随机排序(洗牌)时,常规的 sort(() => Math.random() - 0.5) 会因算法缺陷与高阶复杂度引发严重卡顿与概率偏差。实现高性能随机排序的核心路径分为三层:算法层采用时间复杂度严格为 $O(n)$ 且无偏的现代 Fisher-Yates 洗牌算法;内存层利用类型化数组(TypedArray)消除对象指针冗余与垃圾回收(GC)暂停;架构层通过 Web Worker 配合可转移对象(Transferable Objects)实现后台零拷贝计算,保障主线程渲染流畅。
一、算法选型:破除误区与 Fisher-Yates 实现
在很多初学者甚至常规工程代码中,常见以下随机排序写法:
// 存在严重性能与统计学缺陷的反例
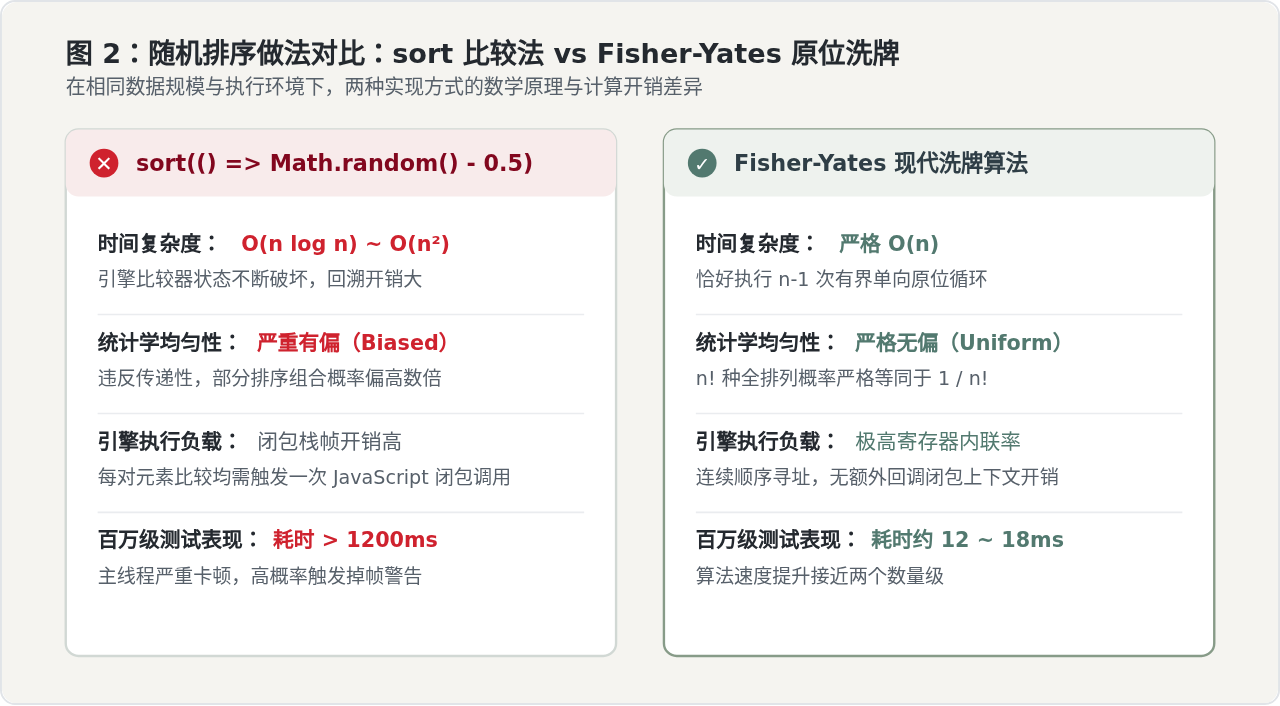
const badShuffle = (arr) => arr.sort(() => Math.random() - 0.5);这种写法在大规模数据下存在致命缺陷。首先是复杂度退化:V8 等现代引擎的 sort 底层采用 TimSort 混合排序算法,期望比较函数满足严格弱序(即传递性:若 $A > B$ 且 $B > C$ 则必有 $A > C$)。然而 Math.random() - 0.5 返回非确定性正负值,完全打破了传递性公理,导致内部状态不断重置与回溯,比较次数达到 $O(n \log n)$ 甚至最坏 $O(n^2)$。其次是概率偏倚(Bias):各元素出现在各个位置的概率极不均匀,无法生成真正的离散均匀分布。
解决此问题的标准工业级方案是 Fisher-Yates 算法(Knuth Shuffle)。现代版本从数组尾部逆向遍历,每次生成一个处于当前有效未洗牌范围内的随机索引,并将两项进行原位(In-place)交换。每个排列组合生成的概率严格为 $1/n!$,遍历单次即可完成,时间复杂度恒定为 $O(n)$,空间复杂度为 $O(1)$。
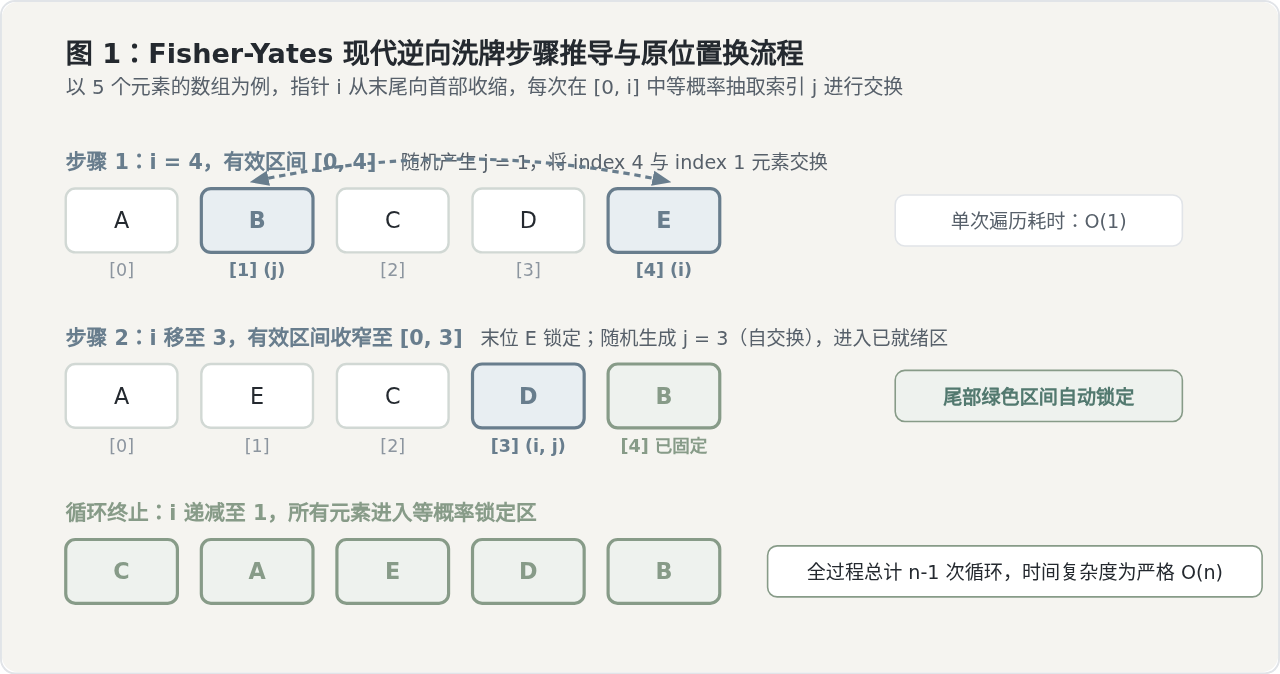
标准 JavaScript 实现如下:
/**
 * 经典 Fisher-Yates (Durstenfeld) 数组原位随机洗牌
 * @param {Array} arr 输入待排序数组
 * @returns {Array} 洗牌后的原数组引用
 */
function shuffleInPlace(arr) {
  let i = arr.length;
  while (--i > 0) {
    // 生成 [0, i] 范围内的随机整数
    const j = Math.floor(Math.random() * (i + 1));
    // 原位数值交换,避免解构赋值 [arr[i], arr[j]] = [arr[j], arr[i]] 产生的额外微数组开销
    const temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
  }
  return arr;
}
注意微优化细节:在现代 JavaScript 引擎中,尽管 ES6 解构
[arr[i], arr[j]] = [arr[j], arr[i]] 语法简洁,但在循环十万次以上时,解构会在短时间内分配大量临时微数组迭代器,导致隐式内存抖动。使用临时变量 temp 进行赋值置换能使 V8 JIT 编译器生成最优的机器寄存器交换指令。
二、内存与底层优化:类型化数组与索引映射
当数组规模从 10 万增长至 1000 万时,单凭 $O(n)$ 算法依然可能遇到瓶颈。这通常不再是 CPU 算力不足,而是内存布局与垃圾回收(GC)机制造成的停顿。
1. 普通 JavaScript 数组的内存困境
在 V8 引擎中,标准 JavaScript 数组(JSArray)是一个高度抽象的包装对象。即便元素全是纯数字,其底层结构在不同优化阶段(PACKED_SMI_ELEMENTS 到 PACKED_ELEMENTS)转换时也会消耗可观内存。若数组中存储的是复杂对象或字符串引用,每个数组槽位本质上是一个 64 位的指针。在千万级元素下,仅指针列表就会占用约 80MB 内存,加上被引用对象的堆开销,总体内存可达数百兆甚至吉字节。在重排过程中频繁的指针重写会触发 V8 堆内存的写屏障(Write Barrier),使得垃圾回收器(Scavenger / Major GC)频繁介入,造成肉眼可见的卡顿。
2. 采用类型化数组(TypedArray)消除 GC 开销
类型化数组(如 Int32Array、Uint32Array、Float64Array)直接基于连续的二进制缓冲区块(ArrayBuffer)分配内存。它的核心优势体现在三点:
- 连续紧凑内存:一个千万级
Uint32Array严格占用固定 40MB 物理内存,比同等容量的通用数组减少 70% 以上的内存开销。 - 极高 CPU 缓存命中率(Cache Locality):连续内存保证了数据在 L1/L2/L3 缓存中的高速装载,大幅减少内存寻址等待周期。
- 零垃圾回收暂停:洗牌过程全部在既有缓冲区内就地改写,不产生任何临时小对象,执行期间 GC 压力为零。
/**
 * 针对数值型连续数据的 TypedArray 高性能洗牌
 * @param {Uint32Array|Int32Array|Float64Array} typedArr
 */
function shuffleTypedArray(typedArr) {
  let i = typedArr.length;
  while (--i > 0) {
    const j = Math.floor(Math.random() * (i + 1));
    const temp = typedArr[i];
    typedArr[i] = typedArr[j];
    typedArr[j] = temp;
  }
  return typedArr;
}
3. 针对复杂对象数组的“索引映射洗牌法”
如果待洗牌的数据本身是包含多个字段的复杂对象(例如 [{ id: 1, name: 'A' }, ...]),直接重排原对象数组会导致大量对象引用的移动与缓存未命中。实用的优化策略是:不直接移动对象,只对索引进行洗牌。
/**
 * 针对复杂对象数组的索引映射洗牌法
 * @param {Array<Object>} items 原始大对象数组
 * @returns {Uint32Array} 洗牌后的索引映射表
 */
function shuffleIndices(length) {
  // 分配与数据量等长的 32 位无符号整型紧凑数组
  const indices = new Uint32Array(length);
  for (let i = 0; i < length; i++) {
    indices[i] = i;
  }
  // 仅对数值索引执行高效原位洗牌
  shuffleTypedArray(indices);
  return indices;
}

// 使用方式:按需根据洗牌后的索引顺序读取
const bigData = getTenMillionRecords();
const shuffledIndex = shuffleIndices(bigData.length);

// 读取第 0 项随机数据:bigData[shuffledIndex[0]]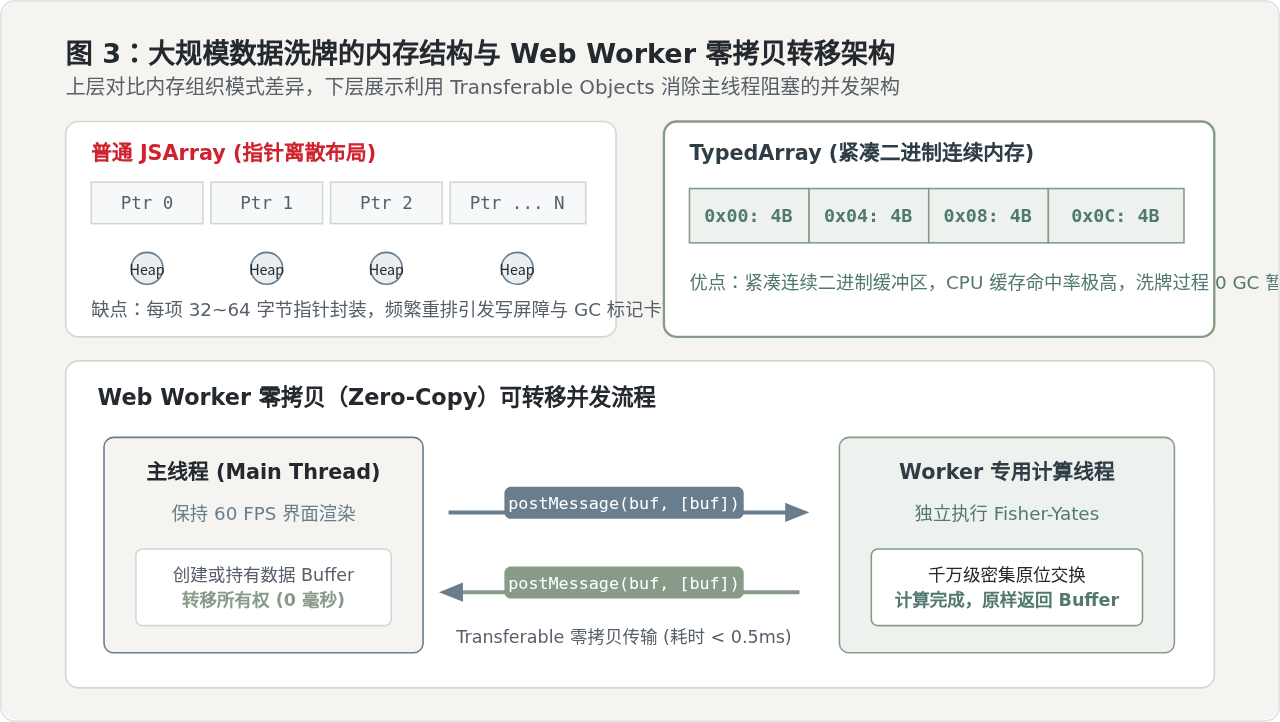
三、架构级并发优化:Web Worker 与 Transferable Objects
即使使用了最优化的 Fisher-Yates 配合 TypedArray,在处理 500 万至 1000 万级别的数据时,纯 CPU 运算仍需 50ms ~ 150ms。因为浏览器中 JavaScript 的主线程同时负责样式计算、布局、绘制与用户交互输入,超过 16.6ms(60Hz 刷新率)的长任务都会直接导致页面掉帧、输入卡顿或动画停滞。
1. 为什么常规 postMessage 会失效?
通常情况下,通过 worker.postMessage(data) 向后台线程传递数据时,浏览器会采用结构化克隆算法(Structured Clone Algorithm)。如果要传递一个包含 500 万项的数组,浏览器会在内存中完整复制一份该数组。这不仅会瞬间导致内存占用翻倍,而且序列化与反序列化本身的耗时甚至远超过洗牌算法本身的执行时间。
2. 零拷贝解决方案:Transferable Objects
HTML5 规范支持将 ArrayBuffer 作为“可转移对象”(Transferable Objects)。在调用 postMessage 时,只要将其列入第二个转移参数数组中,浏览器就会直接将底层内存块的所有权(Ownership)从主线程上下文转移给 Worker 线程,而无需发生任何内存复制。转移耗时几乎为 0 毫秒(通常 < 0.2ms)。当 Worker 完成洗牌后,再以同样方式将所有权移回主线程即可。
完整工程化实现如下:
// ================= worker.js (计算子线程) =================
self.onmessage = function (e) {
  const { buffer, type } = e.data;
  // 基于接收到的底层二进制内存包装为类型化数组视图
  const arrayView = new Uint32Array(buffer);

  // 执行 Fisher-Yates 核心洗牌算法
  let i = arrayView.length;
  while (--i > 0) {
    const j = Math.floor(Math.random() * (i + 1));
    const temp = arrayView[i];
    arrayView[i] = arrayView[j];
    arrayView[j] = temp;
  }

  // 计算完成,将 ArrayBuffer 所有权无损转回主线程,零内存复制
  self.postMessage({ buffer: arrayView.buffer }, [arrayView.buffer]);
};

// ================= main.js (主线程调用方) =================
function asyncShuffleLargeBuffer(typedArray) {
  return new Promise((resolve, reject) => {
    const worker = new Worker('worker.js');

    worker.onmessage = function (e) {
      // 此时所有权转回,重新构造视图
      const resultView = new Uint32Array(e.data.buffer);
      worker.terminate(); // 计算完成销毁实例
      resolve(resultView);
    };

    worker.onerror = function (err) {
      worker.terminate();
      reject(err);
    };

    // 关键优化:传入 typedArray.buffer 并将其填入 Transferable 列表
    const rawBuffer = typedArray.buffer;
    worker.postMessage({ buffer: rawBuffer }, [rawBuffer]);

    // 注意:一旦转移,主线程上的 typedArray.byteLength 变为 0,无法再访问该 buffer
  });
}
四、按需随机化策略:局部洗牌(Partial Shuffle)
在大量实际业务场景中(例如从数百万用户的候选池中随机抽取前 100 名中奖者、或者推荐系统中从 10 万候选集中随机拉取一页 20 条数据展示),我们完全不需要将全量数据彻底随机重排。
在 Fisher-Yates 算法中,每一次迭代都会严格固定当前位置的随机结果。因此,如果我们只需要随机选取 $k$ 个元素($k \ll n$),只需要让外层循环执行 $k$ 次即可提前终止,这被称为部分洗牌(Partial Fisher-Yates):
/**
 * 局部随机抽取优化:仅随机化前 k 个元素
 * @param {Array|TypedArray} arr 待抽样数据
 * @param {number} k 需要抽取的随机样本数量 (k <= arr.length)
 * @returns {Array|TypedArray} 包含前 k 个随机样本的数组
 */
function partialShuffle(arr, k) {
  const len = arr.length;
  const count = Math.min(k, len);

  // 只需将索引 0 到 count - 1 的元素与 [i, len - 1] 范围内的随机项交换
  for (let i = 0; i < count; i++) {
    const j = i + Math.floor(Math.random() * (len - i));
    const temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
  }

  // 此时 arr[0 ... count-1] 即为严格等概率抽取的 k 个独立随机项
  return arr.subarray ? arr.subarray(0, count) : arr.slice(0, count);
}
这一优化将时间复杂度从 $O(n)$ 直接削减至 $O(k)$。例如在 1000 万数据中抽取 100 个随机样本,原本需要 1000 万次迭代,优化后仅需 100 次迭代,执行时间直接由数十毫秒降至 0.01 毫秒以下。
五、优化策略决策模型与技术选型指南
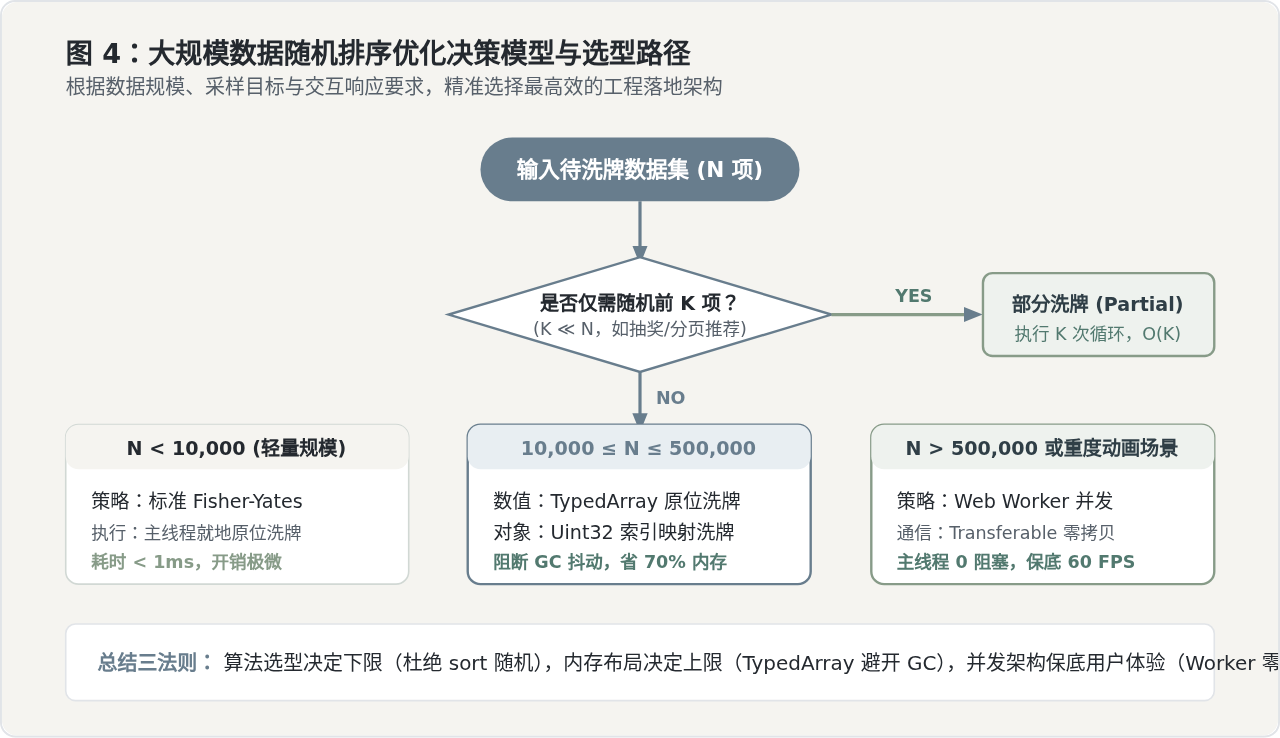
针对不同数据规模与业务场景,应采取梯次渐进的优化方案。下表梳理了在统一测试基准下的综合指标对比:
| 方案类型 | 时间复杂度 | 空间复杂度 | 百万级耗时 | 主线程阻塞 | 最适用场景 |
|---|---|---|---|---|---|
arr.sort(Math.random) |
$O(n \log n)$ | $O(\log n)$ 栈开销 | ~1300 ms | 严重卡死 | 不推荐使用任何场景 |
| 主线程 Fisher-Yates (普通数组) | $O(n)$ | $O(1)$ | ~80 ms | 轻微卡顿 | < 10,000 规模的基础场景 |
| 主线程 Fisher-Yates (TypedArray) | $O(n)$ | $O(1)$ (内存减70%) | ~15 ms | 极短阻塞 | 10,000 ~ 500,000 数值运算 |
| Web Worker + Transferable | $O(n)$ | $O(1)$ (零拷贝) | ~16 ms (异步) | 0 毫秒(完全不卡) | > 500,000 或对 UI 帧率极其敏感 |
| 局部洗牌 (Partial Shuffle) | $O(k)$ | $O(1)$ | < 0.1 ms | 0 毫秒 | 仅需随机前 k 项或分页抽取 |
六、总结与落地建议
面对大规模数据的随机排序需求,单一的编码技巧难以完全解决性能瓶颈,必须从算法、数据结构和运行时架构三个层面联合施策:
- 杜绝比较器伪随机:切勿使用
arr.sort(() => Math.random() - 0.5),它不仅具有偏差,而且时间复杂度高。在任何生产场景中,都应将 Fisher-Yates 洗牌算法作为标准实现。 - 优先采用连续二进制存储:当数据量上升至十万级别时,尽量转换为
Int32Array或Uint32Array进行原位洗牌;处理非数值对象集合时,通过只洗牌索引映射表,可以彻底避免大对象的频繁内存重排。 - 大容量离线计算移至 Worker:处理超过 50 万量级数据或对交互流畅度要求严苛的界面时,必须结合 Web Worker 与可转移对象(Transferable Objects),在 0 毫秒数据交接的前提下保障浏览器主渲染循环的平稳流畅。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章