
深入剖析JavaScript变量命名中因字形相似、Unicode同形字及不可见字符引发的视觉混淆隐患,解析JS引擎底层符号映射机制,提供语义化重构方案与涵盖字体、IDE、ESLint及Git Hook的四步工程化防御指南。

当前位置:首页 > JavaScript 代码规范与重构 > 正文
避免视觉混淆:JS变量命名中易错字符辨析与建议
作者:函数茶馆
时间:2026-11-22
浏览:309
文章目录
JavaScript 代码规范
工程化质量
代码辨析与防御指南
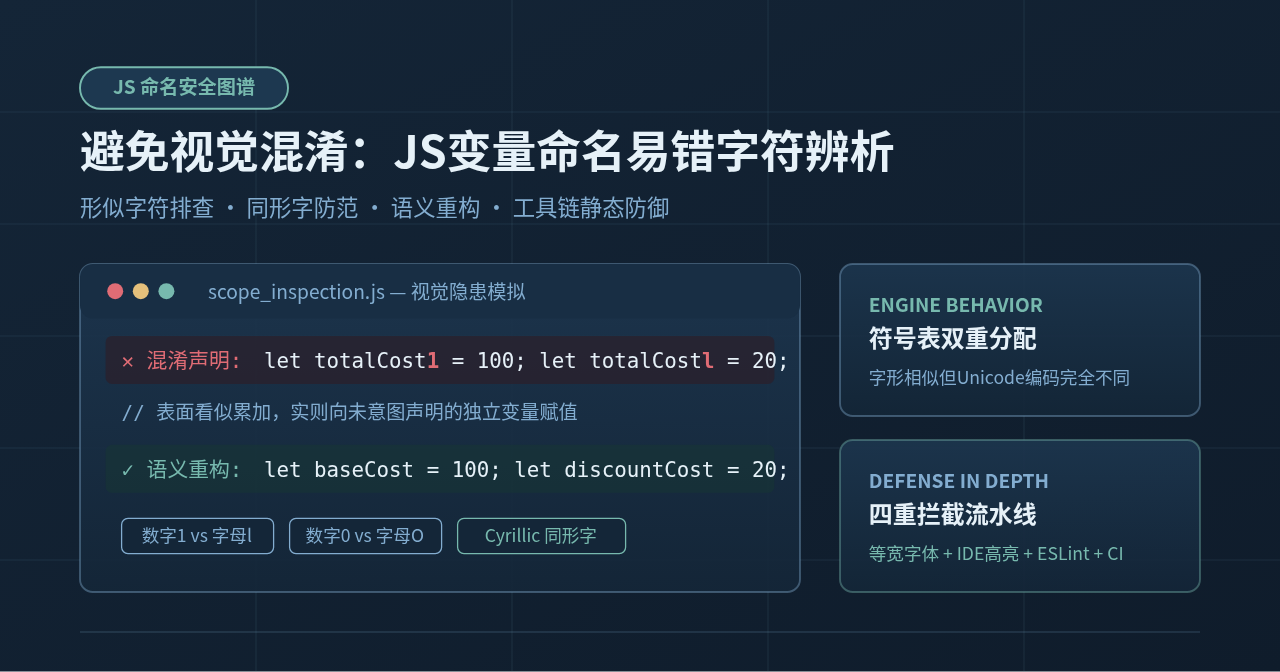
假设在排查一段线上结算模块时,循环累计的总金额总是偏差一笔运费,但控制台既没有任何语法错误,也没有抛出未捕获异常。经过数小时逐行核对才发现,业务初始声明的是
解决这一隐患的核心在于:明确高频易错字符的形态与编码差异,认清 JavaScript 引擎符号表解析机制,建立以语义具象化为核心的重构规则,并结合具备字形区分特性的等宽字体、编辑器高亮、ESLint 规则与 Git Hook 提交门禁,将视觉混淆消灭在进入生产环境之前。
totalCost1(以数字 1 结尾),而在后续的分支累加中误写成了 totalCostl(以小写字母 l 结尾)。在 JavaScript 运行环境中,由于这是两个合法的独立标识符,引擎不会将其判定为冲突,而是直接将数值累加到另一个未被消费的变量中,导致计算结果悄然失真。
解决这一隐患的核心在于:明确高频易错字符的形态与编码差异,认清 JavaScript 引擎符号表解析机制,建立以语义具象化为核心的重构规则,并结合具备字形区分特性的等宽字体、编辑器高亮、ESLint 规则与 Git Hook 提交门禁,将视觉混淆消灭在进入生产环境之前。
一、经典视觉混淆字符图谱与形态辨析
在日常开发与代码维护中,字符混淆主要源自两类场景:一是由于非优质编程字体或人眼辨识度限制导致的“形近字混淆”;二是复制网页资料、富文本聊天工具代码片段时无意识混入的“跨语系同形字与不可见符号”。以下是 JavaScript 开发中最容易踩中的四组典型字符。
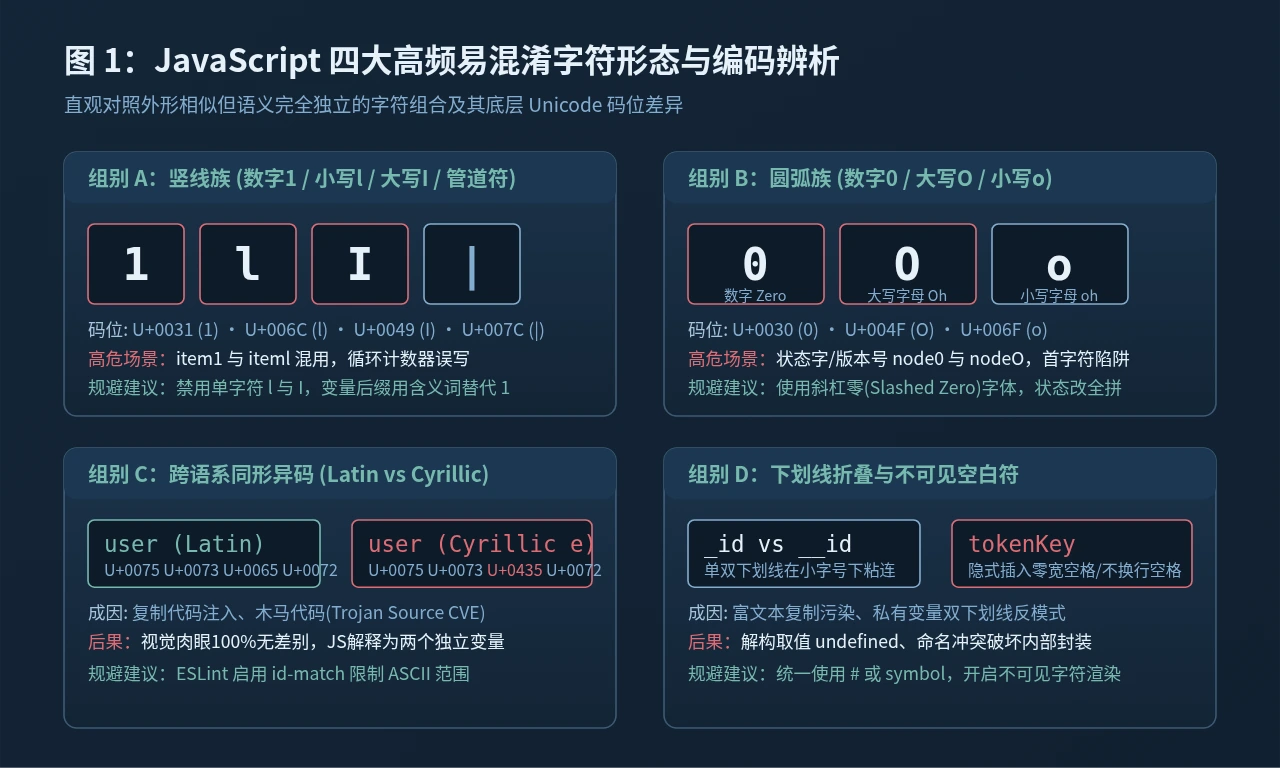
1. 竖线族字符:数字 1、小写字母 l、大写字母 I 与管道符 |
在很多无衬线字体(如 Arial、Helvetica 或操作系统默认无衬线字体)中,数字 1、小写字母 l(El)、大写字母 I(Eye)以及竖线 |(Pipe)的高度、宽度与笔画几乎没有视觉区隔。
- 数字 1 (U+0031):常作为自增编号后缀,如
arg1、res1。 - 小写字母 l (U+006C):常出现在表示长度(
len/l)或列表项(line/list)的缩写中。 - 大写字母 I (U+0049):常在下划线命名法或缩写词中出现,如
MAX_I或ItemI。
当开发者随手定义 const val1 = calculate(); const vall = val1 * 2; 时,后序阅读者极难察觉 vall 的最后一个字符其实是字母 l。一旦发生拼写打字偏差,编译器和语法检查器完全无法推测开发者的真实意图。
2. 圆弧族字符:数字 0、大写字母 O 与小写字母 o
数字 0 (U+0030) 与大写英文字母 O (U+004F) 是另一对重灾区。在非等宽字体或未经过切角处理的字体中,两者的宽度差极为细微。常见高危场景包括状态枚举、版本序号或节点索引:
// 危险写法:肉眼极易误判状态常量
const STATE_O = 0; // 字母 O,本意可能为状态 0
const STATE_0 = 1; // 数字 0,本意可能为第 0 个枚举
let nodeO = getRootNode(); // 尾部是 Oh 还是 Zero?
若在判断逻辑中使用 if (status === STATE_0),实际业务期待的是状态为 0 时的逻辑,却因使用了易混淆的枚举后缀导致永远命中错误分支。
3. 跨语系同形异码:拉丁字符与西里尔字符 (Unicode Homoglyphs)
现代 ECMAScript 规范允许标识符采用 Unicode 字符集(遵循 Unicode Standard Annex #31 规范)。这为国际化命名提供了便利,但同时也开启了同形字安全隐患(Homoglyph Attack / Trojan Source):
| 字符外观 | 拉丁字符 (Standard ASCII) | 西里尔字符 (Cyrillic Homoglyph) | Unicode 码位对照 |
|---|---|---|---|
| a / а | Latin Small Letter A | Cyrillic Small Letter A | U+0061 vs U+0430 |
| e / е | Latin Small Letter E | Cyrillic Small Letter Ie | U+0065 vs U+0435 |
| o / о | Latin Small Letter O | Cyrillic Small Letter O | U+006F vs U+043E |
| p / р | Latin Small Letter P | Cyrillic Small Letter Er | U+0070 vs U+0440 |
| c / с | Latin Small Letter C | Cyrillic Small Letter Es | U+0063 vs U+0441 |
当开发者从外部论坛、即时通信软件或经过恶意修改的开源库中复制代码片段时,西里尔字符 а 会与英文字母 a 混合在一起。例如变量名 user 中若第三个字符是西里尔字母 е,人眼看完全一致,但在底层它与全英文的 user 是两个互不相干的独立变量。
4. 连续下划线与不可见空白符
除了常规字母与数字外,标识符内部的特殊符号同样容易引发视觉混同:
- 单下划线与双下划线:例如
_config与__config。在小字号或低分辨率屏幕上,连续两个下划线往往渲染成一条稍微加长的横线,肉眼难以区分数量。 - 零宽空格与不换行空格:例如
(Zero-Width Space)与tokenKey),外观显示为tokenKey,但使用正常的tokenKey进行取值时只会得到undefined。
二、JS 引擎眼中的“同名陷阱”:词法解析与运行时故障推导
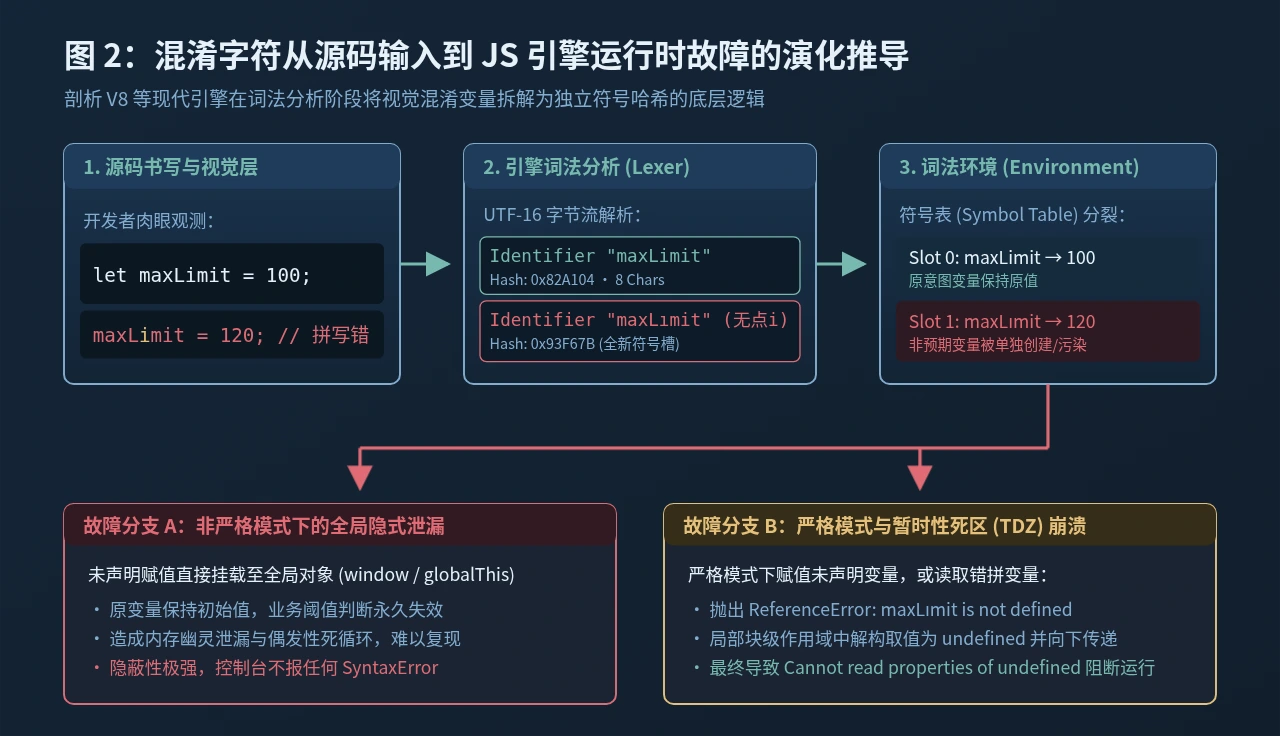
人类在阅读代码时依赖视觉轮廓与语境推测,而 JavaScript 引擎(如 V8、SpiderMonkey、JavaScriptCore)则在词法分析阶段严格依据字符的 UTF-16 编码单元执行逐字节扫描。
1. 词法分析器 (Lexer) 的符号表槽位分配
在词法分析阶段,引擎将源代码字符流拆分为 Token。当遇到标识符时,引擎会依据其精确的 Unicode 码位计算哈希值,并在当前执行上下文的环境记录(Environment Record)中开辟一个符号槽位(Symbol Slot)。
对于人类看似相同的 totalCost1 与 totalCostl,其最后一个字符的十六进制编码分别为 0x0031 与 0x006C。引擎由此生成两个不同的字符串哈希,并在作用域中分配两个互不相干的绑定对象。
2. 运行时行为的两种破坏性分支
符号表一旦产生分裂,后续代码运行将陷入两类隐蔽故障:
分支 A:非严格模式下的静默泄漏与逻辑吞没
若在未经严格模式保护的代码中,误将计算结果赋值给拼写错误的变量(如
若在未经严格模式保护的代码中,误将计算结果赋值给拼写错误的变量(如
totalCostl = base + tax;),由于 totalCostl 之前未用 let/const/var 声明,引擎会自动在全局对象上创建该属性。原本需要累加的目标变量 totalCost1 保持初始状态不变,导致业务数据永久计算错误,且控制台毫无报警信息。
分支 B:严格模式与暂时性死区 (TDZ) 崩溃
在启用
在启用
"use strict" 或 ES6 模块的环境中,向未声明的混淆变量赋值会立即抛出 ReferenceError;而如果混淆发生在局部对象的属性解构中,例如 const { usеr } = response.data;(其中使用了西里尔字母),则解构出来的 usеr 变量值静默为 undefined,直到下一行调用 usеr.name 时才会爆发 TypeError: Cannot read properties of undefined,排查路径十分曲折。
三、消除视觉混淆的变量重构与命名规范
依靠人眼的注意力去分辨毫厘之间的字符差异是极其脆弱的。要彻底消除视觉混淆,必须从编码源头建立明确的命名禁则与语义化替代规则。
1. 杜绝尾部无意义的单数字或单字母后缀
无意义的单字符后缀(如 data1 / data2、tempA / tempB、res1 / resl)是滋生视觉混淆的主要温床。重构方法是强制使用具象化的业务状态或数据形态进行区分:
// ✕ 易错写法:依靠微弱后缀区分,极易看错
const item1 = fetchSourceItem();
const iteml = convertToTarget(item1); // 尾部是小写字母 l

// ✓ 建议重构:依据业务语义具象命名
const sourceItem = fetchSourceItem();
const transformedItem = convertToTarget(sourceItem);
2. 建立单字母变量的严格使用白名单
单字母变量虽然输入快捷,但在宽作用域中使用时极易被误读。应当在团队中落实如下硬性准则:
- 绝对禁用单字母:严禁使用
l(小写L)、I(大写i)、O(大写o)作为任何作用域下的变量名或函数参数。 - 限定短作用域单字母:允许
i、j、k仅在少于 10 行的显式for循环中担任数值递增索引;允许e或err仅在catch(e)或事件回调中表示异常与事件对象。 - 跨函数及模块导出:禁止任何单字母变量外泄,所有导出接口必须具有明确完整的英文单词命名。
3. 状态与标志采用显式枚举替代数值
涉及多状态判断时,不要使用带有数字或字母后缀的标志位,应统一采用冻结对象(Frozen Object)或 TypeScript 枚举类型:
// ✕ 易错写法:数字与字母混用,难以审查
let runMode0 = false;
let runModeO = true;

// ✓ 建议重构:定义明确的常量字典
const ExecutionMode = Object.freeze({
  DRY_RUN: 'DRY_RUN',
  PRODUCTION: 'PRODUCTION',
});
let currentMode = ExecutionMode.PRODUCTION;
4. 废弃双下划线私有化反模式
早期的 JavaScript 库常用双下划线(如 __init__、__state)表示私有成员,这极易引发笔误与下划线粘连。在现代 JavaScript(ES2022+)中,应全面改用原生的 ECMAScript 私有字段语法(#state)或使用 Symbol() 保持封装,从根本上摆脱下划线计数陷阱。
四、四步工程化防御流水线:从字体到 CI 门禁的落地实施
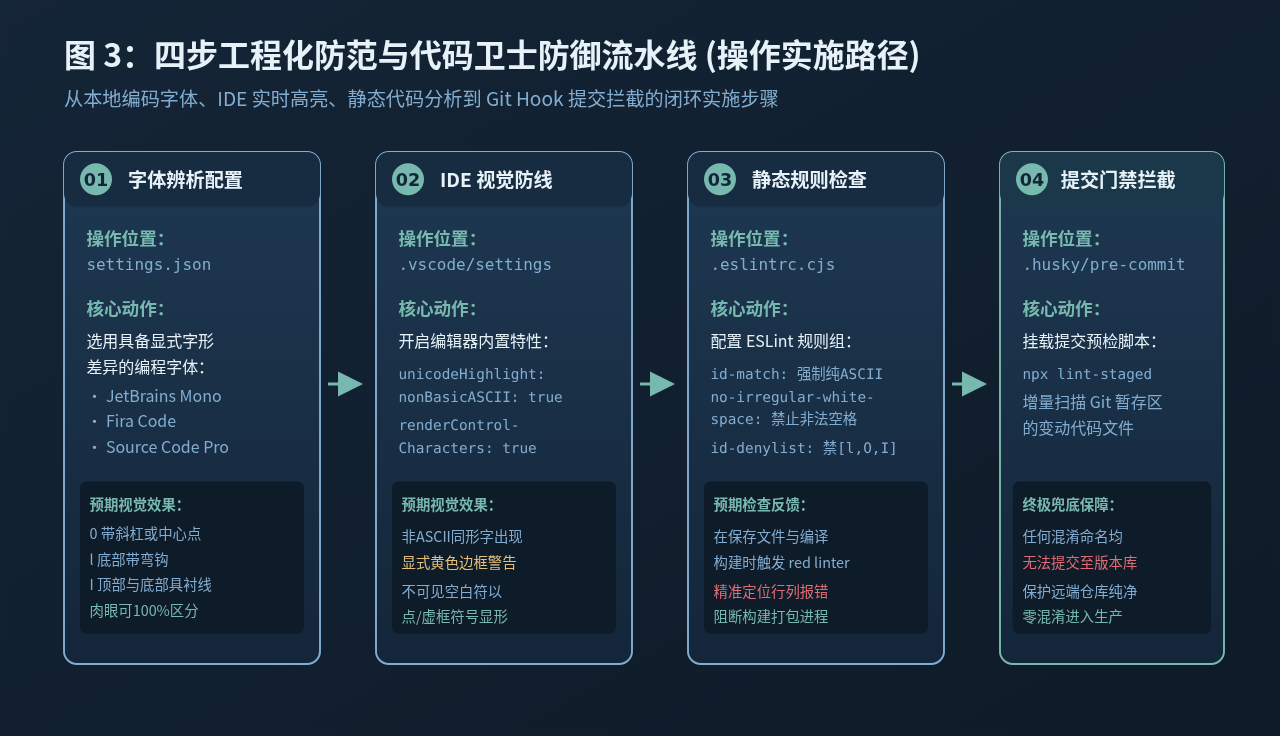
仅靠规范文档无法彻底避免人为疏忽。现代前端与 Node.js 工程应搭建包含“字体显示、编辑器实时提示、静态语法检查、Git 提交门禁”的四级防护网。
步骤 1:配置具备高辨识度字形的编程等宽字体
日常编码环境应选用专门优化过字符辨识度的等宽字体。优秀编程字体的典型特征是:数字 0 中间带斜杠或点(Slashed / Dotted Zero)、小写字母 l 底部有向右的弯钩(Curved tail)、大写字母 I 上下具有明确的水平衬线(Serifed I)。
在 VS Code 的全局或工作区 settings.json 中进行如下配置:
{
  "editor.fontFamily": "'JetBrains Mono', 'Fira Code', 'Source Code Pro', Consolas, monospace",
  "editor.fontLigatures": true,
  "editor.fontSize": 14
}
步骤 2:开启 IDE 原生 Unicode 预警与控制字符渲染
VS Code 1.63 及后续版本内置了强大的 Unicode 同形字和不可见字符检测能力。通过在项目工作区 .vscode/settings.json 中开启对应选项,可在代码键入时直接标红异常字符:
{
  // 高亮非基础 ASCII 字符(捕获西里尔同形字等)
  "editor.unicodeHighlight.nonBasicASCII": true,
  // 高亮与常用 ASCII 字符外观相似的 Unicode 字符
  "editor.unicodeHighlight.ambiguousCharacters": true,
  // 高亮零宽字符与不可见空白符
  "editor.unicodeHighlight.invisibleCharacters": true,
  // 显式渲染制表符、空格与不可见控制字符
  "editor.renderControlCharacters": true
}
配置生效后,一旦代码中混入了西里尔字母 а 或零宽空格 ,编辑器将直接显示醒目的黄色警告边框,鼠标悬停时会提示其具体 Unicode 码位。
步骤 3:在 ESLint 中配置严苛的标识符字符集与黑名单规则
为防止不规范变量被带入构建流程,需在项目的 .eslintrc.cjs 或 eslint.config.js 中配置静态规则,强制所有变量名必须为纯 ASCII 字符,并拉黑高危单字符:
module.exports = {
  rules: {
    // 1. 强制标识符只能包含纯 ASCII 字符(杜绝跨语系同形字)
    'id-match': ['error', '^[$_a-zA-Z][$_a-zA-Z0-9]*$', {
      properties: true,
      onlyDeclarations: false,
      errorMessage: '变量名 "{{name}}" 包含非法或非 ASCII 字符,存在视觉混淆隐患',
    }],

    // 2. 禁止将形近单字符作为变量名
    'id-denylist': ['error', 'l', 'I', 'O', 'o', 'oo'],

    // 3. 禁止不规则的空白字符(包括零宽空格与非断行空格)
    'no-irregular-whitespace': ['error', {
      skipStrings: false,
      skipComments: false,
      skipRegExps: false,
      skipTemplates: false,
    }],
  },
};
步骤 4:通过 Husky 与 lint-staged 建立 Git 提交阻断门禁
最后一步是将静态检查接入版本控制工作流,确保未通过检测的代码无法提交到远端仓库。在工程根目录执行以下配置:
# 1. 安装 git hooks 与暂存区扫描工具
npm install --save-dev husky lint-staged

# 2. 初始化 husky
npx husky init

# 3. 在 package.json 中声明针对 JS 文件的增量检查
// package.json
{
  "lint-staged": {
    "*.{js,ts,jsx,tsx}": [
      "eslint --fix",
      "eslint --max-warnings=0"
    ]
  }
}
将 .husky/pre-commit 内容修改为 npx lint-staged。至此,任何含有西里尔同形字、非法单字符 l 或零宽空白的代码在执行 git commit 时都会被即刻拒绝并给出清晰的行列报错。
五、变量防混淆命名规范与落地自检矩阵
为了便于团队成员在方案设计、代码编写以及 Code Review 时快速对照,下表梳理了变量防混淆自检矩阵:
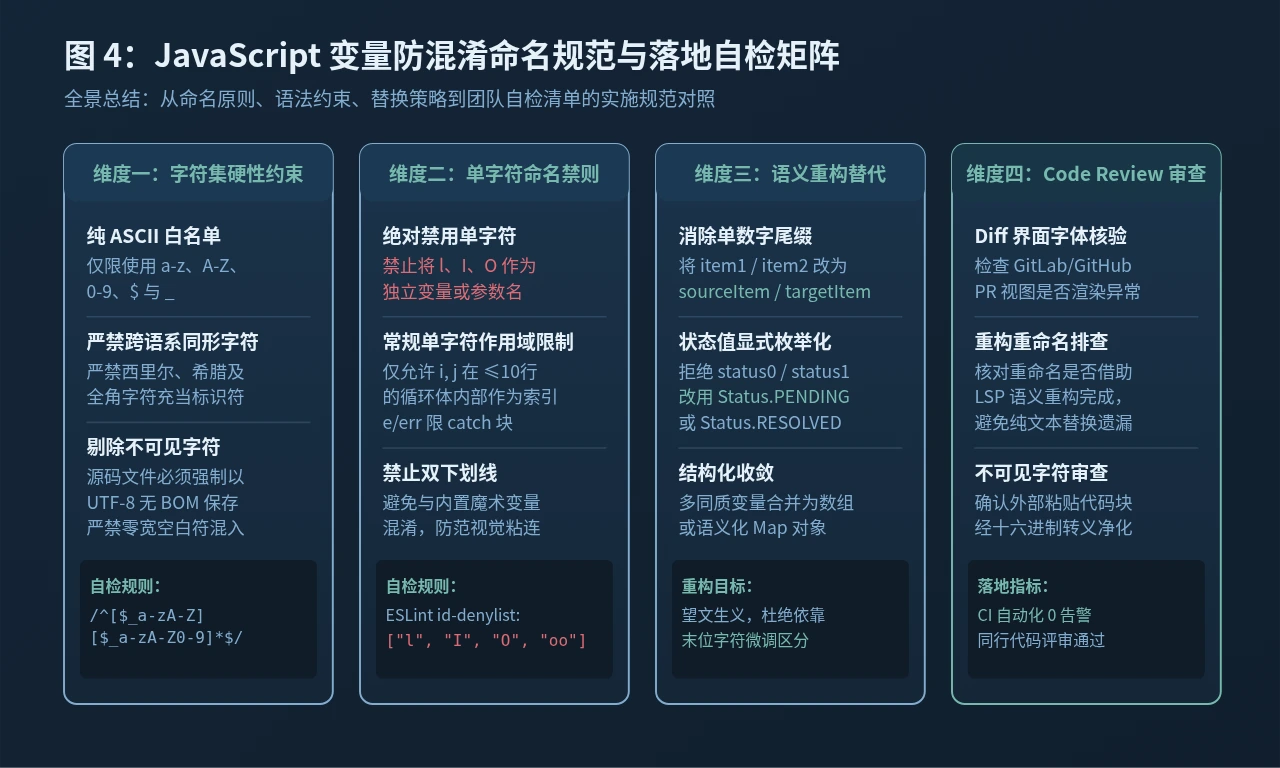
| 检查维度 | 禁止模式 (Anti-Pattern) | 推荐模式 (Recommended) | 工程化把关手段 |
|---|---|---|---|
| 字符集范围 | 包含西里尔字母 usеr、希腊字母或非 ASCII 符号 |
严格使用英文字母、数字及规范下划线 [$_a-zA-Z0-9] |
ESLint id-match 规则拦截 |
| 单字符选用 | 使用 l、I、O 声明变量或作为箭头函数形参 |
使用明确语义词如 lineItem、offset、index |
ESLint id-denylist 规则拦截 |
| 区分度递增 | 使用无意义单数字后缀 node1 / nodel、arg1 / arg2 |
使用业务角色命名 sourceNode / targetNode |
Code Review 语义审查 |
| 特殊修饰符 | 滥用双下划线 __data 模拟私有化,容易发生视觉粘连 |
采用现代原生私有属性 #data 或 Symbol |
ESLint no-underscore-dangle |
| 不可见字符 | 复制混入 (零宽空格)或 (不换行空格) |
源码文件纯净 ASCII / 标准半角空格,UTF-8 无 BOM 保存 | VS Code 高亮 + no-irregular-whitespace |
六、常见易错问题解答 (FAQ)
Q1:既然同形字符会带来如此大的混淆,为什么 ECMAScript 规范不直接禁止非 ASCII 标识符?
ECMAScript 是一门面向全球开发者的国际化语言,允许各国开发者使用母语(如中文标识符
const 用户列表 = []、日文或阿拉伯文)编写代码。规范的核心目标是提供通用能力,而字符集的收敛与语法收紧属于工程实践范畴。因此,国际化开放性由语言标准保障,而团队代码库的 ASCII 纯净度则应由团队的 Linter 工具链负责约束。
Q2:在对接第三方三方库或老旧后端 API 时,接口返回的 JSON 属性本身就带有容易混淆的字段(如
res1 或下划线前缀),前端该如何处理?
建议在网络请求层(API Adapter / Response Transform)完成边界隔离。在接收到后端数据后,立即通过解构重命名转换为规范的语义化对象:
让视觉隐患阻隔在网络防线外部,确保项目核心业务逻辑代码内部始终流转符合规范的具象变量。
const { res1: sourceResult, resl: remoteChecksum } = response.data;
让视觉隐患阻隔在网络防线外部,确保项目核心业务逻辑代码内部始终流转符合规范的具象变量。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章