

深入讲解浏览器前端使用原生 Fetch API 加载 JSON 文件的核心方法,涵盖 async/await 标准调用、双重 Promise 与底层流解析机制、本地静态服务运行环境要求、常见报错与防御封装实践。
浏览器前端怎么用Fetch API加载JSON文件
作者:函数茶馆
时间:2026-11-22
浏览:470
文章目录
在现代浏览器前端开发中,使用原生 Fetch API 加载 JSON 文件的核心方式是调用 fetch(url) 发起网络请求,并在收到响应后调用 response.json() 将原始数据流反序列化为 JavaScript 对象。全文围绕这一核心操作展开,具体说明标准调用方式、底层的双重 Promise 机制、本地测试时不可忽视的 Web 静态服务环境限制,以及如何排查网络异常与语法错误,帮助你在实际开发中写出健壮可靠的数据加载逻辑。
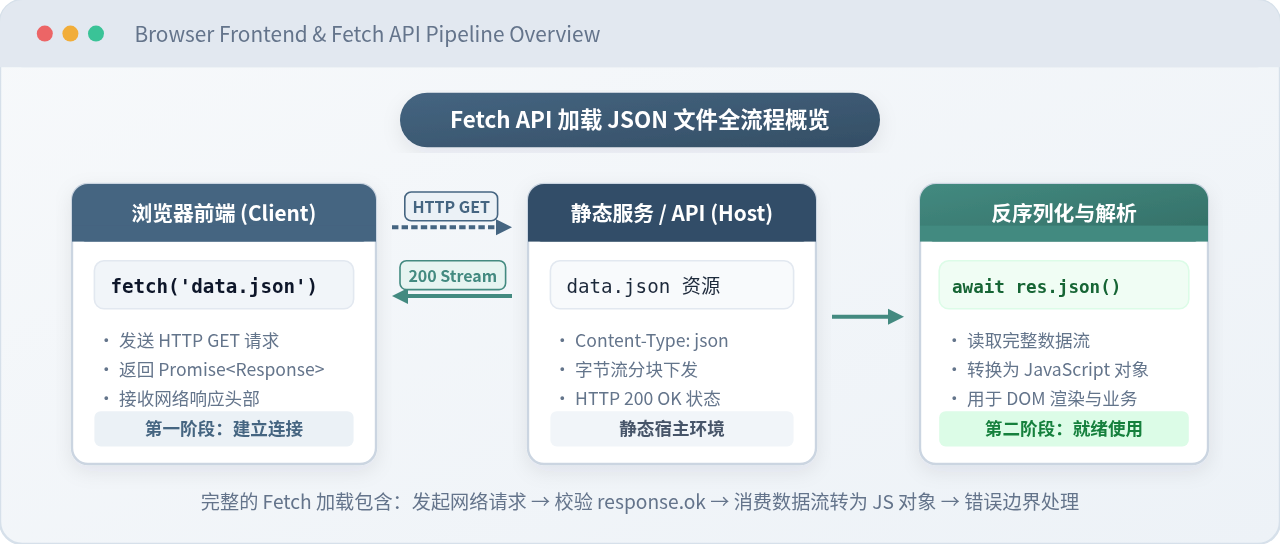
一、基础用法:标准语法与双重 Promise
Fetch API 是现代浏览器原生内置的 HTTP 请求接口,基于 Promise 设计。加载一个 JSON 文件的最简流程包含两个异步阶段:先获取 HTTP 响应对象,再把响应体解析成 JavaScript 对象。
1. 现代标准的 async / await 写法(推荐)
在支持异步函数的环境中,使用 async/await 能够使代码逻辑像同步代码一样直观可读:
// 推荐的标准异步加载函数
async function loadUserData() {
  try {
    // 1. 发起网络请求,等待服务端返回响应头
    const response = await fetch('./data/users.json');

    // 2. 必须检查 HTTP 状态码是否属于 200~299 成功区间
    if (!response.ok) {
      throw new Error(`HTTP 错误,状态码: ${response.status}`);
    }

    // 3. 读取响应流并反序列化为 JavaScript 对象
    const data = await response.json();

    // 4. 正常使用数据
    console.log('JSON 数据加载成功:', data);
    return data;
  } catch (error) {
    // 5. 捕获网络异常、HTTP 状态异常或 JSON 格式错误
    console.error('加载 JSON 文件失败:', error.message);
  }
}

// 执行调用
loadUserData();
2. 经典 Promise 链式写法(.then / .catch)
如果不方便定义 async 包装函数,可以直接使用 Promise 原型链上的 .then() 与 .catch():
fetch('./data/users.json')
  .then(response => {
    if (!response.ok) {
      throw new Error(`网络响应错误,状态码: ${response.status}`);
    }
    return response.json(); // 返回另一个 Promise
  })
  .then(data => {
    console.log('获取到的 JSON 数据:', data);
  })
  .catch(error => {
    console.error('请求过程中出现异常:', error);
  });
语法注意点:无论采用哪种写法,都必须依次处理两个 Promise:第一个由
fetch() 产生,第二个由 response.json() 产生。初学者经常遗漏第二个 await 或遗漏 return response.json(),导致最终得到的变量是一个 Promise {<pending>} 而非解析后的对象。
二、标准操作流程与完整代码实现
为了让数据请求在生产环境下稳定运行,不能仅仅写两行代码,而需要按照标准流程实现“路径定位 → 发起请求 → 状态校验 → 流解析 → 业务消费 → 异常兜底”。
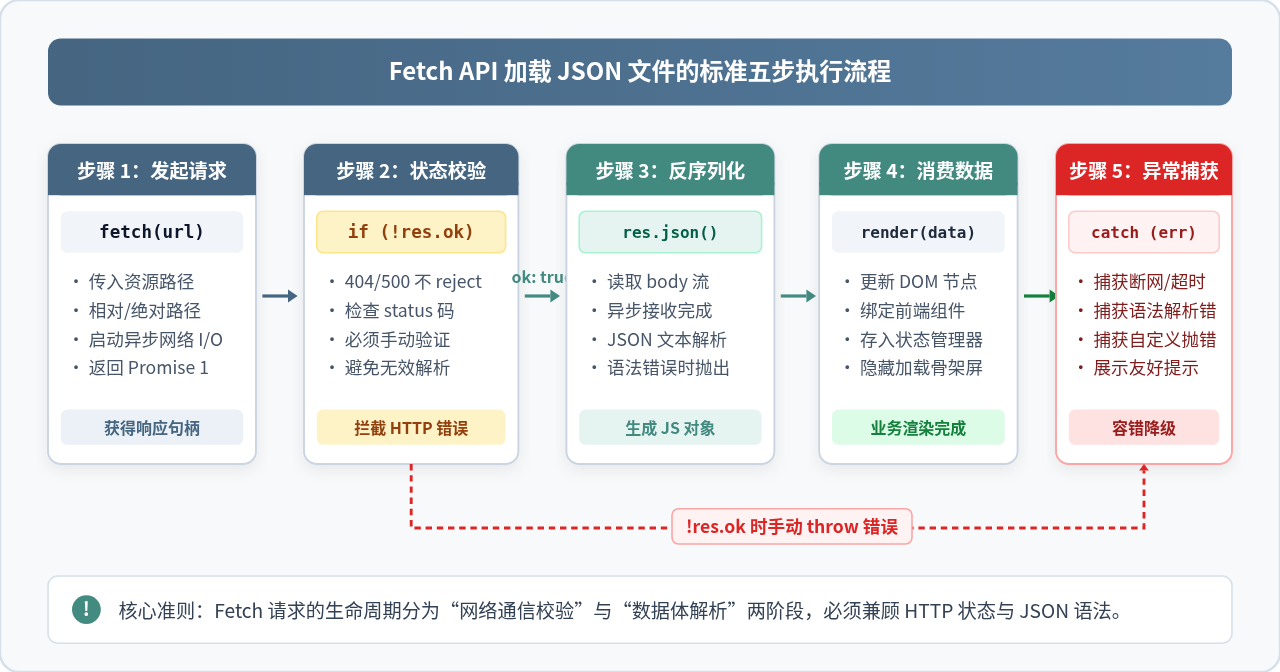
详细执行步骤说明
-
步骤 1:确认 JSON 资源路径
在前端项目中,JSON 文件通常存放在公共静态资源目录(例如工程的/public/data.json或与 HTML 同级的相对目录./config.json)。确保传入fetch(url)的相对路径基于当前访问页面的 URL,或者使用带斜杠的绝对根路径/data/config.json。 -
步骤 2:发起请求并校验
response.ok
这是 Fetch API 最容易被忽略的关键特性:即使服务器返回 404(资源不存在)或 500(服务器内部错误),fetch()的 Promise 也不会触发 reject。只要浏览器成功收到了服务器的 HTTP 响应报文,Promise 就会被 resolve。因此,必须手动检查response.ok(当 HTTP 状态码位于 200 到 299 之间时为true),如果为false则主动抛出错误。 -
步骤 3:调用
response.json()反序列化
调用此方法会触发浏览器底层的数据流读取器,将网络收到的所有数据块拼装并调用 JSON 引擎解析。如果数据内容不是合法的 JSON 语法(例如误返回了 HTML 错误页),这里会抛出SyntaxError。 -
步骤 4:消费数据并更新视图
获取到真正的原生 JS 对象或数组后,执行后续的前端渲染逻辑,如遍历渲染列表、绑定状态数据、关闭加载骨架屏等。 -
步骤 5:使用
catch处理全局异常
统一捕获断网、DNS 解析失败、协议被拦截、HTTP 状态码异常以及 JSON 语法错误,展示友好的错误提示或执行降级重试。
三、核心原理解析:为什么需要两次 await?
许多刚刚接触 Fetch API 的开发者常有疑问:为什么像老旧的 XMLHttpRequest 或第三方库如 axios 可以一次性返回响应体,而原生的 Fetch 必须先 await fetch() 再 await response.json()?
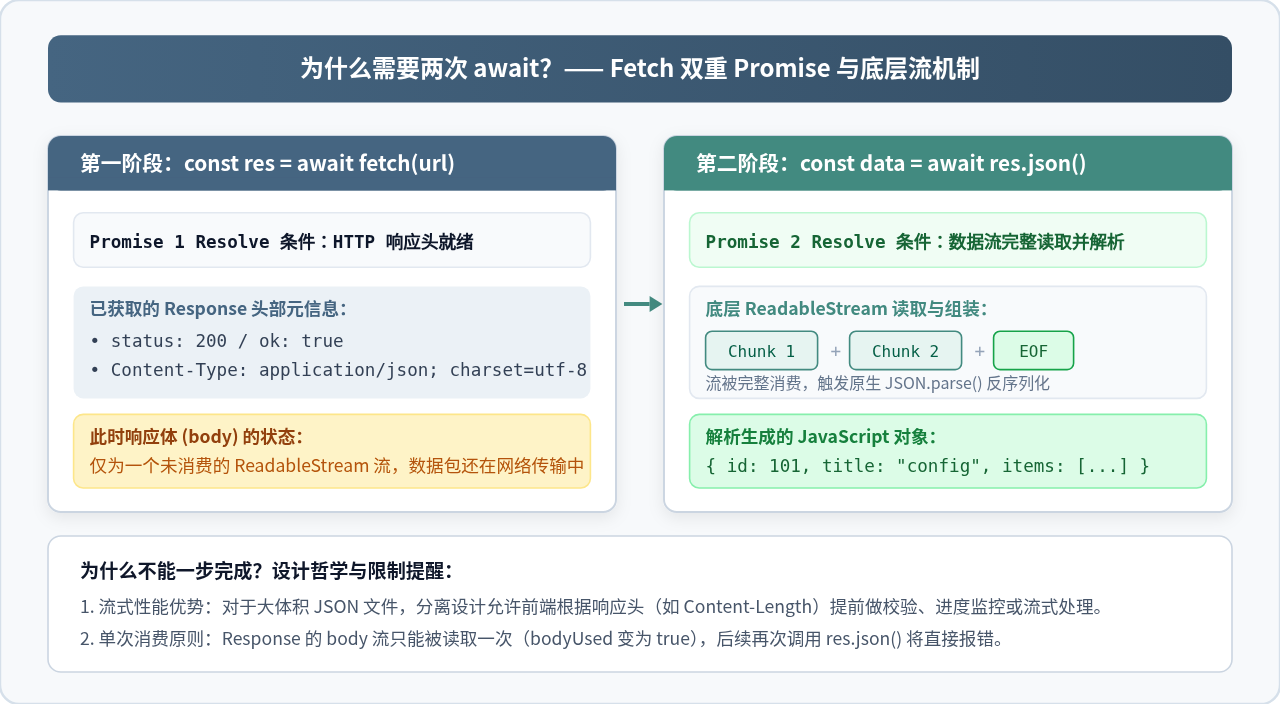
这源于现代 Web 标准对网络流式传输(Streaming)的架构考量:
-
阶段一(响应头就绪):当浏览器与服务器建立 TCP/TLS 连接并刚刚接收到 HTTP 响应头(包含状态码、
Content-Type、Content-Length、Cookies 等)时,fetch()返回的第一个 Promise 就已经 resolve。此时,服务器可能才刚刚开始往网络套接字写入体积庞大的正文内容,或者正在以分块传输编码(Chunked Transfer Encoding)持续下发数据。此时生成的Response对象中,响应体属性response.body是一个标准的ReadableStream(可读流)。 -
阶段二(数据流读取与反序列化):调用
response.json()会在底层启动流读取器(Stream Reader),逐块接收网络字节,直到读取到数据结束符(EOF)。随后,浏览器对完整缓冲的文本执行反序列化,生成 JavaScript 内存对象。第二个 Promise 在整个流读取与解析完毕后才会 resolve。
单次消费限制(Body Used):
Response 内部的数据流是一次性的。一旦调用了 response.json()、response.text() 或 response.blob(),流就会被锁定并排空(此时 response.bodyUsed 会变为 true)。如果你对同一个响应对象连续两次调用 await response.json(),浏览器将直接抛出 TypeError: Already read 异常。如果确实需要多处消费同一响应,应在读取前先调用 response.clone()。
四、本地开发的关键前提:为什么直接双击 HTML 会失败?
初学者最常遇到的挫折是:在本地电脑上新建了 index.html 和 data.json,然后直接在文件管理器中双击 index.html 用浏览器打开(此时地址栏为 file:///Users/.../index.html 或 file:///C:/...),控制台立刻报错:
TypeError: Failed to fetch
// 或者提示:
Cross origin requests are only supported for protocol schemes: http, data, chrome, https...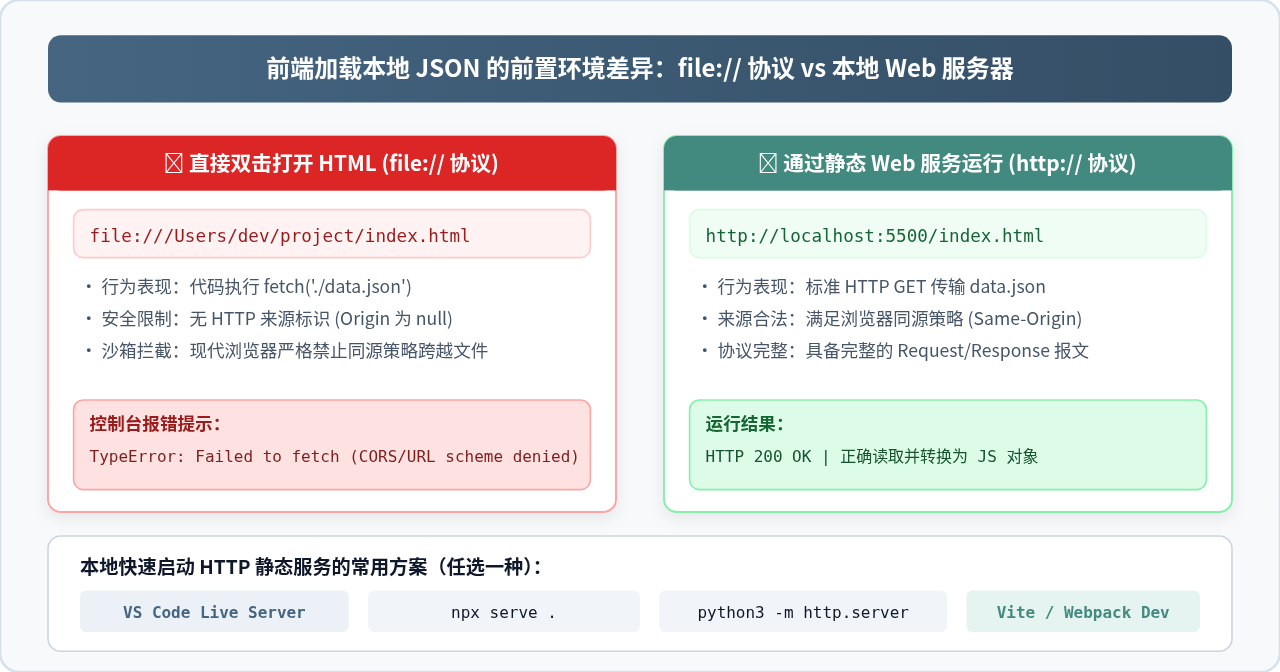
产生这一问题的根源是浏览器的同源策略(Same-Origin Policy)与本地沙箱安全模型:
-
在
file://协议下运行的页面,其请求源(Origin)被浏览器视作不透明的null。为防止恶意 HTML 网页借由脚本偷偷读取用户本地硬盘上的其他敏感文件(如系统配置、私钥或浏览记录),现代浏览器严格限制了file://协议下的异步资源加载行为。 - Fetch API 的规范设计初衷是针对 HTTP/HTTPS 网络事务,依赖标准的 HTTP 请求头、响应头以及同源机制。在本地文件系统中,根本不存在真正的 HTTP 状态码与响应头概念。
本地启动静态 Web 服务的四种实用方式
| 工具/方式 | 适用环境 | 执行命令或操作 | 本地访问地址 |
|---|---|---|---|
| VS Code Live Server 插件 | 安装了 VS Code 编辑器 | 在 HTML 文件上右键选择 "Open with Live Server" | http://127.0.0.1:5500 |
| Node.js 静态服务 (serve) | 已安装 Node.js 环境 | 在工程目录下运行 npx serve . |
http://localhost:3000 |
| Python 内置模块 | 已安装 Python 3 环境 | 在工程目录下运行 python3 -m http.server 8000 |
http://localhost:8000 |
| 现代前端脚手架 | Vite / Vue CLI / Create React App | 运行 npm run dev,将 JSON 放在 public/ 下 |
http://localhost:5173 |
五、常见报错原因与排查决策树
在实际项目调试过程中,使用 Fetch API 加载 JSON 文件常见的报错集中在以下三种,只要按照决策树逐步比对,就能迅速定位并解决。
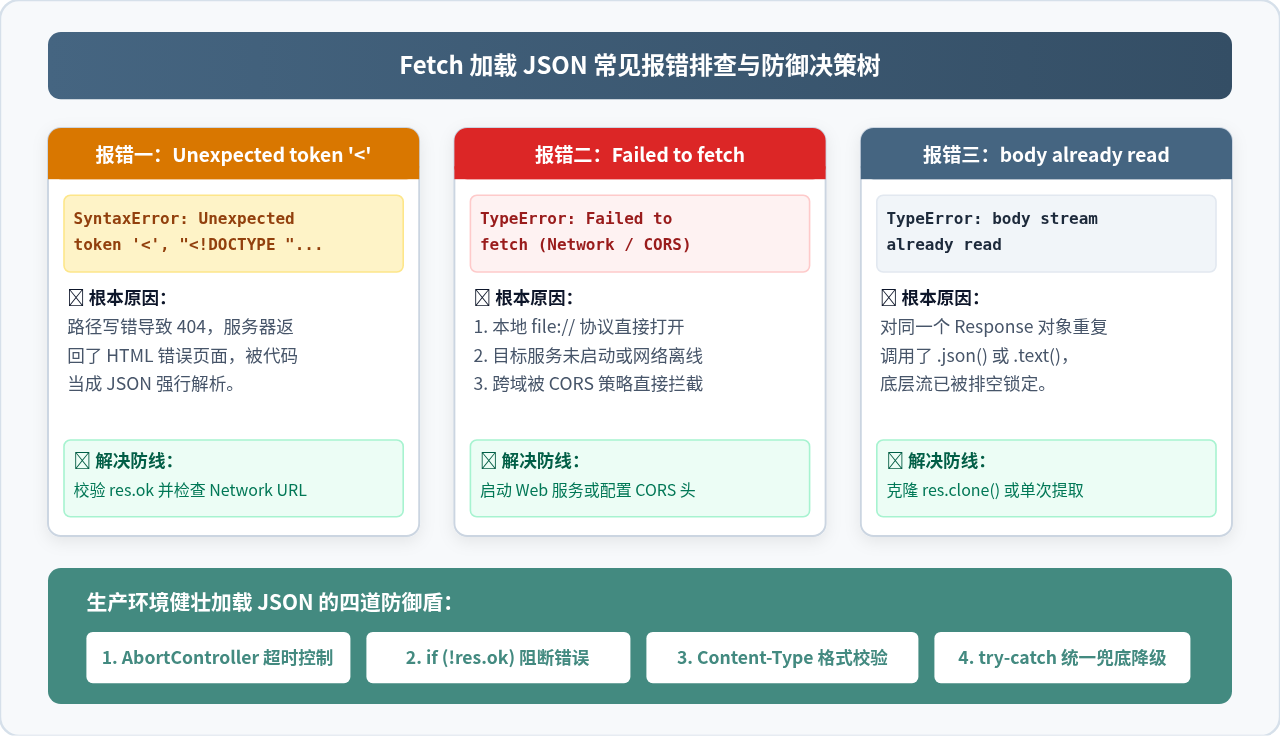
1. SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON
报错表象:JSON 解析失败,指出在第 1 行第 1 列遇到了字符 <。
产生机理:这绝大多数是因为你的请求路径写错了(例如拼错文件名或相对路径层级不对),Web 服务器找不到该文件而返回了一个 404 错误页面。许多静态服务器或单页应用(SPA)框架在路由未命中时,会默认返回 index.html 或标准的 404 HTML 模板。HTML 文件的第一行正是 <!DOCTYPE html>。如果代码没有先校验 response.ok 就直接执行 response.json(),解析引擎把 HTML 文本送进 JSON 解释器,遇到首字符 < 就会抛出上述异常。
排查步骤:
- 打开浏览器开发者工具(F12),切换到 Network(网络) 标签页;
- 刷新页面,在网络列表中找到对应的请求条目,查看其 Status(状态码) 是否为 404 或 500;
- 点击该条目查看 Response(响应体) 选项卡,确认返回的内容是否为 HTML 网页;
- 校对前端请求的文件相对路径,确保在服务器上该路径确实对应静态 JSON 文件。
2. TypeError: Failed to fetch
报错表象:Promise 直接 reject,控制台打印 TypeError: Failed to fetch。
产生机理:该错误说明网络层在建立通信阶段就彻底失败了,根本没有拿到任何 HTTP 响应报文。主要原因包括:本地直接使用 file:// 协议打开;本地 Web 服务未开启或端口号填错;目标域名无法解析或处于断网状态;跨域请求时被浏览器的 CORS(跨源资源共享)策略拦截。
排查步骤:检查地址栏协议是否为 http:// 或 https://;若加载跨域远程 JSON 文件,确认服务端是否在响应头中附加了 Access-Control-Allow-Origin: *。
3. TypeError: body stream already read
报错表象:提示响应体流已经被读取过。
产生机理:在拦截器、调试日志或业务代码中对同一个 response 先后调用了 await response.text() 和 await response.json()。如前所述,原生流是一次性消费的。
排查步骤:删除重复调用的代码,或者在首次读取前使用 const resCopy = response.clone(); 备份一份。
六、生产级健壮封装模式
在实际工程开发中,推荐将原生的 fetch 请求封装为一个独立的工具函数,统一加入超时取消控制(AbortController)、HTTP 状态码判断与 MIME 类型预检,以保障系统运行的高可靠性:
/**
 * 健壮的 JSON 资源加载器
 * @param {string} url 资源地址
 * @param {object} options 配置选项(包含超时时间、请求头等)
 * @returns {Promise<any>} 解析后的 JavaScript 数据
 */
async function fetchJson(url, options = {}) {
  const { timeout = 8000, ...fetchOptions } = options;

  // 1. 设置超时控制器,避免网络挂起无限等待
  const controller = new AbortController();
  const timeoutId = setTimeout(() => controller.abort(), timeout);

  try {
    const response = await fetch(url, {
      ...fetchOptions,
      signal: controller.signal,
      headers: {
        'Accept': 'application/json',
        ...(fetchOptions.headers || {})
      }
    });

    // 2. 严格检查 HTTP 状态码
    if (!response.ok) {
      throw new Error(`HTTP 异常: ${response.status} ${response.statusText}`);
    }

    // 3. 校验响应头的 MIME 类型是否包含 json
    const contentType = response.headers.get('content-type') || '';
    if (!contentType.includes('application/json')) {
      console.warn(`警告: 响应类型为 ${contentType},预期为 application/json`);
    }

    // 4. 解析并返回数据
    return await response.json();
  } catch (error) {
    if (error.name === 'AbortError') {
      throw new Error(`加载 JSON 超时(超过 ${timeout}ms): ${url}`);
    }
    // 重新包装错误,便于上层业务识别
    throw new Error(`加载 JSON 失败 [${url}]: ${error.message}`);
  } finally {
    // 清除定时器
    clearTimeout(timeoutId);
  }
}

// 业务使用示例:
async function initApp() {
  try {
    const appConfig = await fetchJson('./config/app-settings.json', { timeout: 5000 });
    console.log('应用配置初始化完成:', appConfig);
  } catch (err) {
    console.error('初始化失败,使用默认降级配置:', err.message);
  }
}

initApp();
七、要点总结与速查清单
掌握浏览器前端加载 JSON 文件的核心脉络,可以在开发与排查中少走弯路:
- 双重等待:调用
fetch(url)和response.json()都需要使用await或.then()。 - 必须判空:404 / 500 不会自动 reject,代码中务必包含
if (!response.ok)手动阻断。 - 拒绝双击:本地测试务必使用 HTTP 静态服务器(如 Live Server、Vite 或 serve),切勿直接通过
file:///协议双击运行。 - 单次读取:响应流消费后即销毁,不要对同一
Response重复调用解析方法。 - 防范 Unexpected token '<':遇到此错误第一时间检查 Network 面板,确认是否由于路径错误导致服务器返回了 HTML 404 错误页。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章