
讲解JavaScript中数组筛选后如何结合Set与filter实现高效去重,包含基本类型链式写法、单次遍历优化、对象数组按字段去重及执行顺序判断依据。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组筛选后怎么高效去重?结合Set与filter的链式操作
作者:木棉
时间:2026-11-22
浏览:396
文章目录
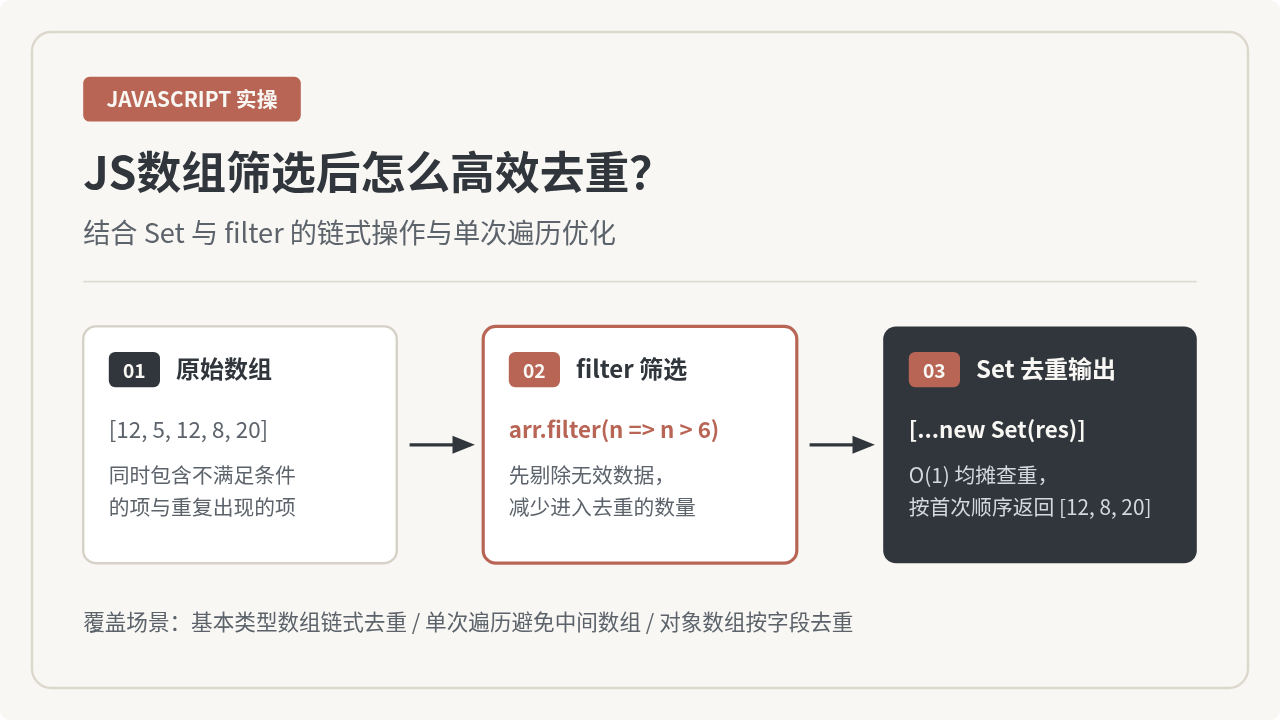
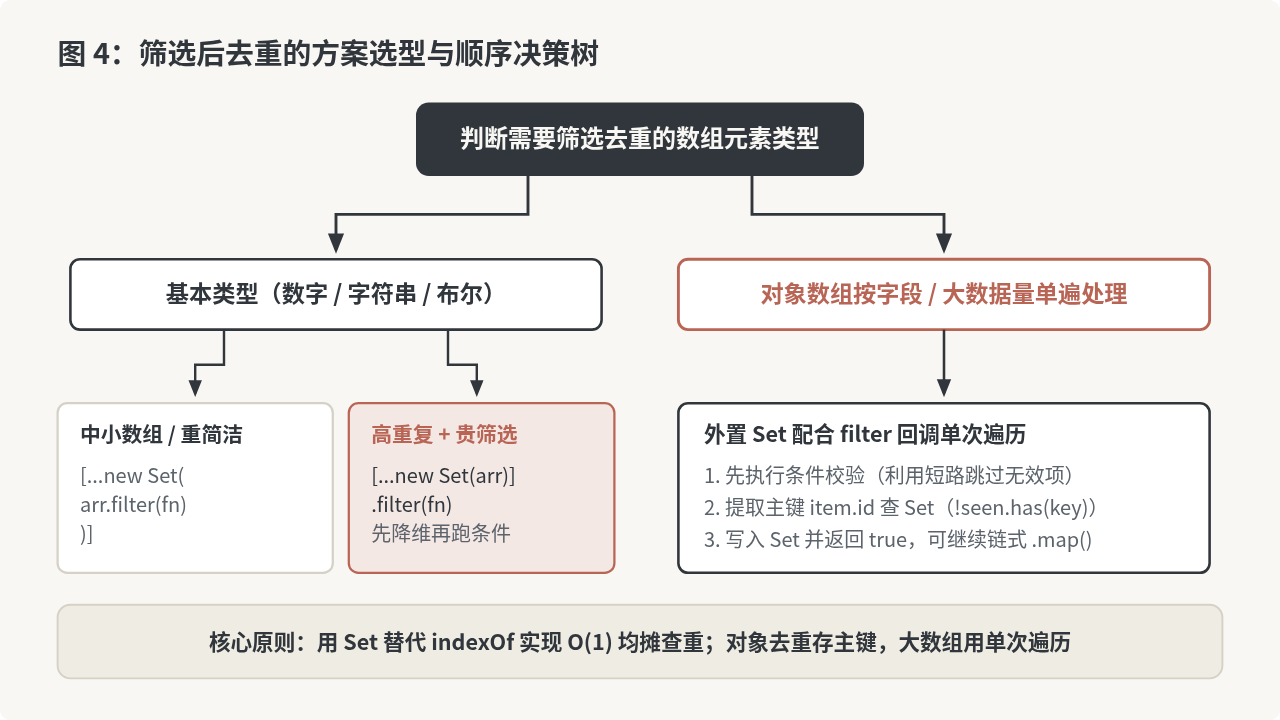
在 JavaScript 中,对数组筛选后高效去重最直接的做法分两种:如果数组元素是数字、字符串等基本类型,直接将 filter() 的返回值传给 new Set() 再用展开运算符转回数组,即 [...new Set(arr.filter(fn))];如果数组较大、想避免多生成一个中间数组,或者元素是对象需要按某个字段去重,则在外层创建一个 Set 实例,在 filter() 回调中一次遍历同时完成条件判断与去重检查。下面按不同数据结构与性能需求展开具体写法、原理解释与边界情况。
基本类型数组的链式筛选去重
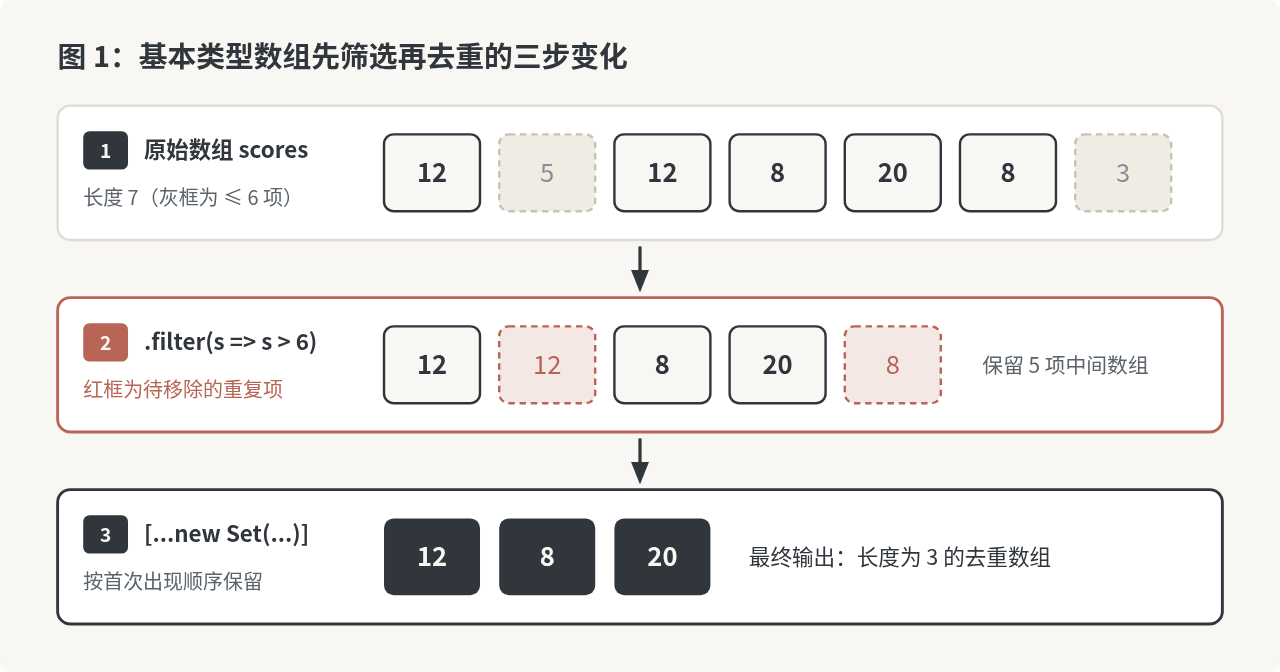
当数组里存放的是数字、字符串、布尔值等基本类型时,将 filter() 和 new Set() 直接组合是最清晰且够快的方案。Set 底层基于哈希机制实现近似常数时间(均摊 O(1))的查找,并且严格保留元素首次插入时的顺序。
以下代码可在现代浏览器开发者工具控制台或 Node.js(支持 ES6 及以上语法,如 Node.js 12+)中直接运行。假设需要从一组原始数值中筛选出大于 6 的记录并去除重复项:
const scores = [12, 5, 12, 8, 20, 8, 3];

// 链式组合:filter 筛选结果直接交给 Set 去重,再通过展开运算符转回数组
const uniqueHighScores = [...new Set(scores.filter((score) => score > 6))];

console.log(uniqueHighScores);示例输出[12, 8, 20]
如果在老旧打包配置下不喜欢展开运算符,也可以把 [...new Set(...)] 替换为 Array.from(new Set(scores.filter((score) => score > 6))),两者的结果与顺序完全一致。
如果对一个只有筛选结果的数组再接续 .map() 或 .sort(),只需把结果继续链式调用即可,例如在去重后按升序排列:
const sortedHighScores = [...new Set(scores.filter((score) => score > 6))].sort((a, b) => a - b);

console.log(sortedHighScores);示例输出[8, 12, 20]
相比早期常见的 filter((item, index, arr) => arr.indexOf(item) === index) 写法,Set 方案的优势随数据量增大而迅速拉开:indexOf 每次都要从头扫描数组,整体时间复杂度是 O(n²);当筛选后还剩几万条数据时,indexOf 会产生明显卡顿,而 new Set() 构建集合的整体复杂度为 O(n)。
用外置 Set 配合 filter 实现单次遍历
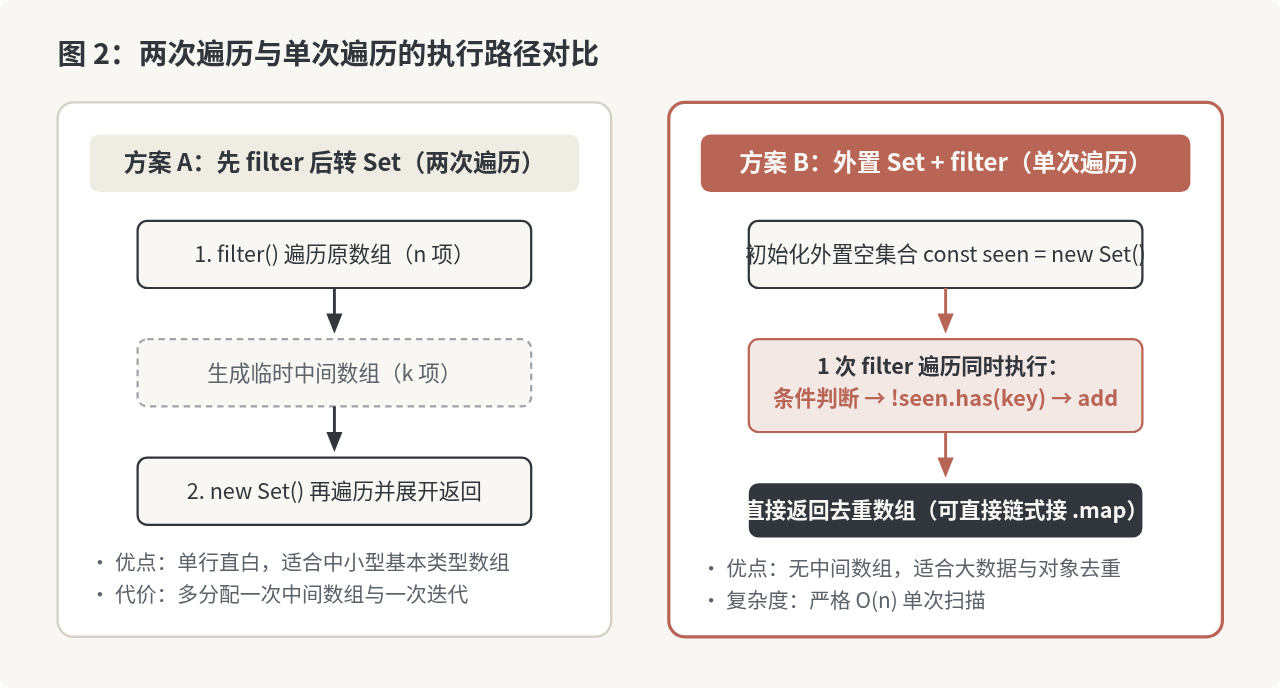
上面的 [...new Set(arr.filter(fn))] 虽然写法很短,但它实际执行了两次数据遍历:filter() 先遍历一次原数组并生成一个临时中间数组,new Set() 再遍历一次中间数组建立哈希集合,最后展开运算符还需把集合转为数组。数据量在几千条以内时这种开销微乎其微;但当数组达到数万甚至十万级,或者你在筛选后还要紧接着链式调用 .map() 时,把 Set 提到外部配合 filter() 做单次遍历会更省内存。
具体做法是在 filter() 之前创建一个名为 seen 的 Set,在回调函数内部完成“条件筛选”和“查重写入”两件事:
const scores = [12, 5, 12, 8, 20, 8, 3];
const seen = new Set();

const uniqueHighScores = scores.filter((score) => {
  if (score <= 6 || seen.has(score)) {
    return false;
  }
  seen.add(score);
  return true;
});

console.log(uniqueHighScores);示例输出[12, 8, 20]
这段代码只遍历了一次 scores,也没有产生多余的中间数组。此外,由于返回值本身就是一个标准数组,后面可以直接继续接 .map()、.slice() 等数组方法,链路不会中断。
在部分技术文章里,你还会看到更紧凑的单行表达式写法:
const seen = new Set();
const uniqueHighScores = scores.filter((s) => s > 6 && !seen.has(s) && seen.add(s));
它之所以能成立,是因为 Set.prototype.add() 方法在写入元素后会返回当前的 Set 实例对象,而在 JavaScript 中任何对象在布尔上下文里都被视为真值(truthy),所以 filter() 会保留该元素。不过这种写法依赖隐式真值转换,团队协作中容易让初次阅读者产生疑问;如果不是追求极致简短,前一种显式写明 return false 与 return true 的多行回调更易于维护。
常见误区提醒:务必把
const seen = new Set() 放在 filter() 外部。如果不小心写进了 filter() 的回调函数体内部,每次迭代都会新建一个空集合,结果将完全无法去重。如果习惯纯粹的链式风格不想暴露外部变量,可以把 seen 封装成返回过滤函数的高阶工厂函数,例如 scores.filter(createUniqueFilter((s) => s > 6))。
对象数组筛选后按字段去重的做法
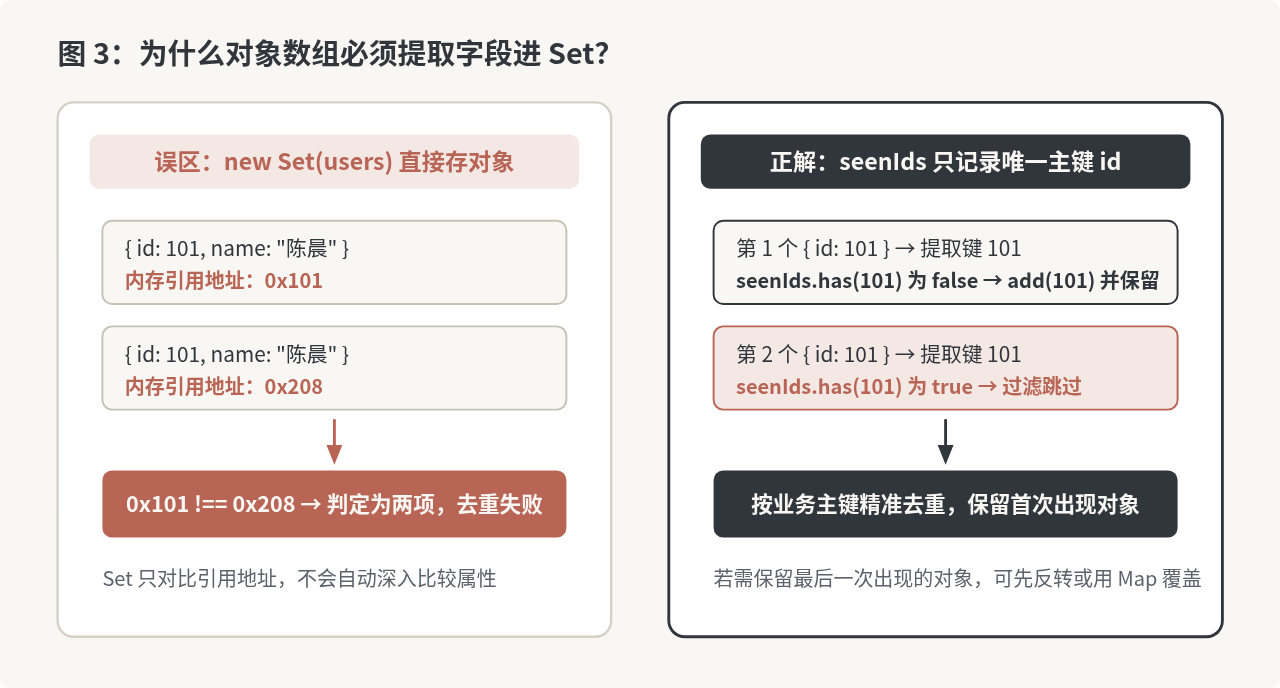
在实际业务里,更常遇到的是接口返回的对象数组——例如筛选出状态为启用的用户,再按 id 去重。此时直接写 [...new Set(users.filter(...))] 几乎总是失效的。
原因在于 Set 判断两个对象是否相等时,比较的是它们在内存中的引用地址,而不是对象内部的属性值。只要数组里的两个对象是通过两次 JSON 解析或不同接口请求生成的,即使它们的所有字段完全一模一样,Set 依然会把它们视为两个不同的元素。
解决思路恰好就是上一节介绍的“外置 Set + filter()”模式:不要把整个对象放进 Set,而是只把用于唯一标识的字段(如 user.id)存入 Set 中作为查重索引,同时在链式调用中直接保留原对象,或继续接 .map() 提取所需字段:
const users = [
  { id: 101, name: "陈晨", active: true },
  { id: 102, name: "林宇", active: false },
  { id: 101, name: "陈晨", active: true },
  { id: 103, name: "周敏", active: true },
  { id: 103, name: "周敏", active: true }
];

const seenIds = new Set();

const activeUniqueNames = users
  .filter((user) => {
    if (!user.active || seenIds.has(user.id)) {
      return false;
    }
    seenIds.add(user.id);
    return true;
  })
  .map((user) => ({ id: user.id, name: user.name }));

console.log(activeUniqueNames);示例输出[{ id: 101, name: '陈晨' }, { id: 103, name: '周敏' }]
如果去重依据不是单个字段,而是多个字段的组合(例如同时要求 department 和 role 相同才算重复),可以在查重时拼出一个稳定的字符串键:
const seenKeys = new Set();

const filtered = records.filter((item) => {
  if (!item.valid) {
    return false;
  }
  const key = `${item.department}::${item.role}`;
  if (seenKeys.has(key)) {
    return false;
  }
  seenKeys.add(key);
  return true;
});
多字段拼接提醒:拼接复合键时应选择业务字段中不会出现的分隔符(例如上面使用的
::),或者在字段本身可能包含任意字符时改用嵌套 Map 或对数组 JSON.stringify([item.department, item.role]) 生成键,避免像 "ab" + "c" 与 "a" + "bc" 拼接成相同字符串而产生误判。
先筛选还是先去重?执行顺序与边界注意
把筛选和去重组合在一起时,经常会遇到一个疑问:到底是先 filter() 再去重,还是先把原数组去重再 filter()?这没有绝对的唯一答案,但有清晰的判断依据:
- 大多数情况应该“先筛选,再去重”:例如状态过滤、非空判断或数值比较(
n > 6、item.active)的计算开销极低。先把不符合条件的元素剔除,可以显著减小写入Set的哈希表体积,避免把根本不需要的脏数据也存入集合。 - “重复率极高且筛选条件计算昂贵”时考虑“先去重,再筛选”:如果原始数组有十万条记录,实际不重复的关键词只有两百个,而筛选条件里包含复杂的正则匹配或较重的计算逻辑,先用
[...new Set(arr)]把十万条压缩成两百条再去跑filter(),能省下大量重复计算。 - 单次遍历写法的顺序:在
filter()内部同时判重时,通常把开销更小的判断放在||或&&前面(例如if (!user.active || seenIds.has(user.id)))。如果user.active为false,JavaScript 的短路求值会直接跳过后面的seenIds.has()查询。
此外,结合 Set 使用时还需留意三个语言边界细节:
NaN与+0 / -0的判等规则:Set内部使用类似“SameValueZero”的算法判等。它认为NaN等于NaN(多个NaN会被正确去重为只留一个,不像indexOf会找不到NaN),同时也认为+0与-0相等(保留最先出现的那一个)。- 字符串与数字不相等:
Set严格区分类型,1和"1"会被视为两个不同值。如果数据源类型不统一,应先在map()中规范化类型或再转字符串比较。 - 保留“第一条”还是“最后一条”:无论是
[...new Set(arr)]还是在filter()里查重,默认都是保留相同元素中第一次出现的那一项。如果遇到对象数组去重且希望由后面的新数据覆盖前面的旧数据,Set配合filter()就不太顺手,这时更建议改用Map(利用map.set(item.id, item)自动覆盖同键旧值的特性)来一次完成。
不同场景的写法选型对照
下表整理了几种常见组合方案的适用条件与特点,方便根据实际代码场景直接选用:
| 场景与数据结构 | 推荐写法 | 遍历次数 | 适用边界说明 |
|---|---|---|---|
| 基本类型数组,代码求简短 | [...new Set(arr.filter(fn))] |
2 次 | 语义最直观,适合中小型数组;过滤条件简单时优先先筛选再去重 |
| 基本类型数组,重复极多且筛选耗时 | [...new Set(arr)].filter(fn) |
2 次 | 先压扁重复项再执行昂贵校验(如复杂正则),减少回调执行次数 |
大数据量或需紧接 .map() |
外置 Set + arr.filter(...) |
1 次 | 省去中间数组分配,保持单次 O(n) 扫描且不打断后续数组链式调用 |
| 对象数组按字段去重(留首条) | 外置 seen 存 item.id + filter() |
1 次 | 支持单字段或拼接复合键;保留首次出现的元素 |
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章