
深入讲解JavaScript中字符串反转时Emoji和特殊Unicode字符产生乱码的原因,剖析UTF-16码元、码点与字素簇的区别,并提供基于Intl.Segmenter的标准解决方案与兼容性建议。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript怎么处理含Emoji或特殊Unicode字符的反转乱码问题
作者:木棉
时间:2026-11-21
浏览:562
文章目录
在 JavaScript 中,直接使用
str.split('').reverse().join('') 反转包含 Emoji、复合修饰符或特殊符号的字符串时,会经常出现字符乱码、位置倒置或问号乱码()。要彻底解决这一问题,现代 JavaScript 的标准解法是使用 Intl.Segmenter 按照“字素簇(Grapheme Cluster)”粒度进行分词反转。本文将从底层编码原因剖析入手,系统讲解这一问题的根源与标准实现方案。
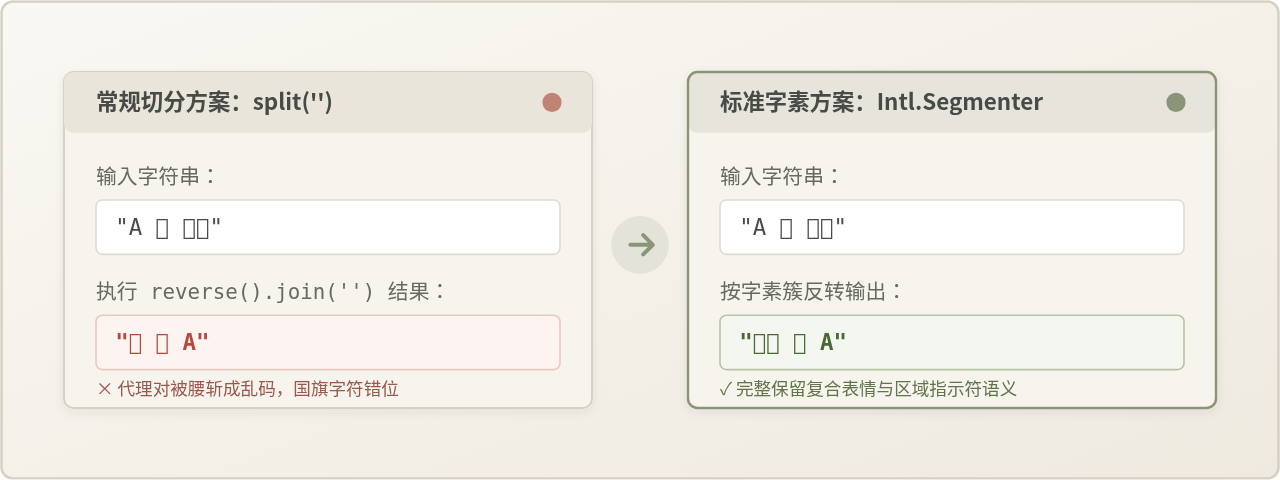
图 0:常规反转方案与字素级反转方案的处理结果对比
一、常见反转写法的乱码现象与深层原因
在前端或 Node.js 开发中,反转字符串最常见的写法是先调用 split('') 将字符串切分成字符数组,再调用 reverse() 倒序,最后通过 join('') 拼接。对于纯 ASCII 字符(如英文与数字)或常规的汉字,这种写法能够正常工作。但一旦遇到 Emoji 表情、国旗图标或带重音符的特殊语言字符,就会产生不可逆的乱码。
造成这一现象的根本原因在于:JavaScript 字符串在内部是基于 UTF-16 码元(Code Unit,16位无符号整数)存储的。不同字符在 Unicode 标准与内存中的表示维度截然不同:
- UTF-16 码元(Code Unit):每个单元占 16 位(2 字节)。基本多语言平面(BMP,码点范围在
U+0000到U+FFFF)内的字符只占用 1 个码元。 - Unicode 码点(Code Point):Unicode 标准中分配给每个符号的唯一编号。超出 BMP 范围(如绝大部分常用 Emoji,码点在
U+10000以上)的字符,在 UTF-16 中必须使用一对 16 位码元表示,这一对码元被称为代理对(Surrogate Pair),由一个高位代理(High Surrogate,0xD800–0xDBFF)和一个低位代理(Low Surrogate,0xDC00–0xDFFF)组成。 - 用户感知字符 / 字素簇(Grapheme Cluster):用户视觉上看到的单个字符,可能由多个独立的 Unicode 码点组合而成。例如,肤色表情(基础手势 + 肤色码点)、零宽连字序列(ZWJ Sequence,如家庭组合表情)、国旗(由两个区域指示符码点拼成)以及组合音标(字母 + 结合变音符)。
当执行 str.split('') 时,JavaScript 引擎并非按“人类眼中的字符”进行切分,而是机械地按照 16 位 UTF-16 码元 进行拆分。以标准笑脸 Emoji 😀(码点 U+1F600)为例,其 UTF-16 编码由 \uD83D 和 \uDE00 两个码元组成。当执行 reverse() 后,原本的高位码元与低位码元被调换成了 \uDE00\uD83D,这破坏了合法的代理对结构,引擎无法解析孤立的代理码元,最终便渲染为无意义的问号替换字符 。
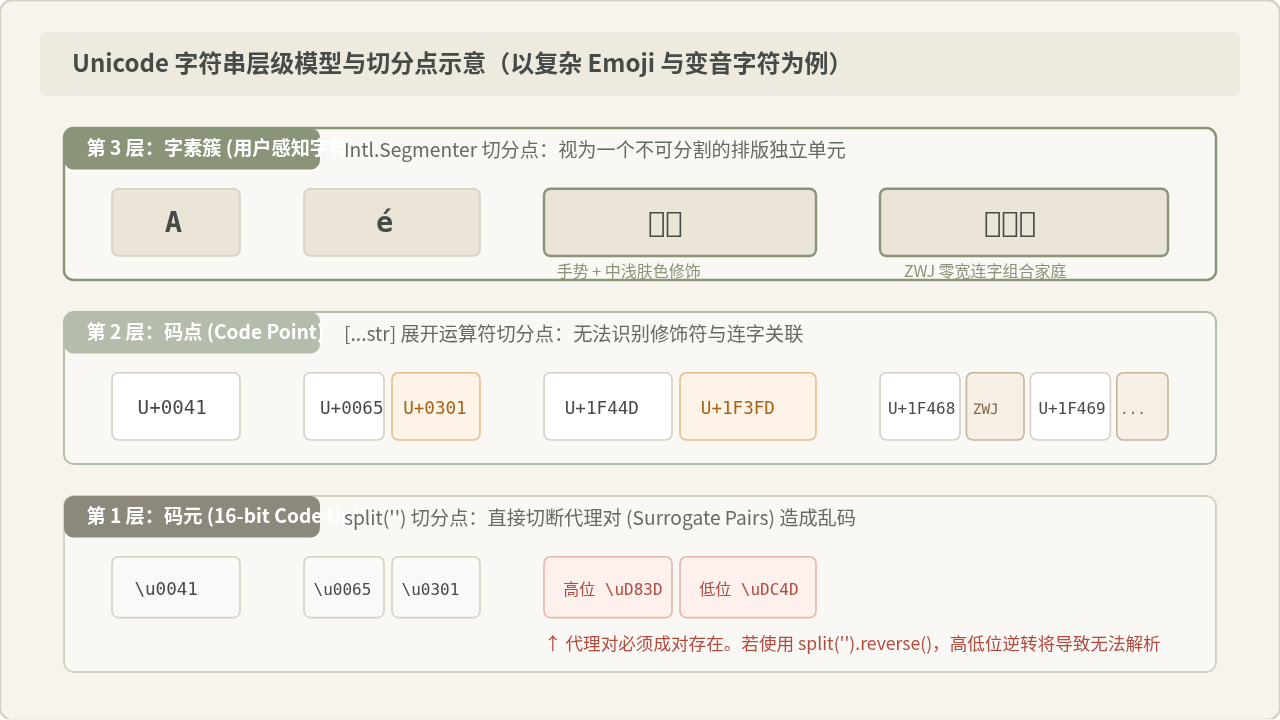
图 1:Unicode 字符串的码元、码点与字素簇层级结构差异
二、方案辨析:为什么展开运算符 [...str] 并不彻底?
许多开发者在遇到 split('') 破坏代理对的问题后,会尝试改用 ES6 的展开运算符 [...str] 或 Array.from(str),写成:
// 看似合理的改进写法
function reverseByCodePoint(str) {
  return [...str].reverse().join('');
}

console.log(reverseByCodePoint("A😀B")); // 输出 "B😀A",单码点 Emoji 正常
这种写法在处理简单的独立 Emoji(如 😀、🎉、🔥)时确实有效。因为 ES6 为字符串实现的迭代器接口(Symbol.iterator)是以 Unicode 码点(Code Point) 为单位进行迭代的,它能够正确识别并保留完整的 UTF-16 代理对,避免将其腰斩成单个码元。
但是,该方案在面对更复杂的 Unicode 复合字符时仍然会失效。原因在于,它只解决到了“码点层”,并未触及“字素簇层”:
- 带肤色修饰符的 Emoji:例如
👍🏽实际上是由手势码点U+1F44D与肤色修饰符码点U+1F3FD组合而成。[...str]会将其拆为两个独立的码点数组元素,反转后变为[肤色, 手势],修饰符失去附着对象,页面上呈现为一个独立色块和一个原色手势🏽👍。 - 国旗符号(Regional Indicator Symbols):国旗 Emoji 由两个区域指示符码点组合而成,例如中国国旗
🇨🇳是由U+1F1E8(区域符号 C)和U+1F1F3(区域符号 N)组成。若简单按码点反转,顺序变为 N + C,即🇳🇨,变成了新喀里多尼亚的旗帜,语义被完全篡改。 - 零宽连字符(ZWJ)组合:例如家庭表情
👨👩👧👦由男人、女人、女孩、男孩四个 Emoji 及 3 个零宽连字符(\u200D)连续串联而成。按码点反转后不仅顺序颠倒,连字符前后错位,渲染引擎无法识别连字规则,直接解体为一串零散的人物小图标。 - 复合重音字母(Combining Diacritical Marks):例如
e\u0301(渲染为é)。按码点反转后,浮动音标\u0301跑到了e的前面,导致变音符无法正确叠加在字母上方。
三、标准解决方案:使用 Intl.Segmenter 按字素簇反转
为了从根本上解决由人类视觉感知字符与计算机底层存储结构不匹配导致的文本切分问题,ECMAScript 正式推出了国际化文本分词标准 API:Intl.Segmenter。
通过配置 granularity: 'grapheme'(字素粒度),Intl.Segmenter 能够严格遵循 Unicode 文本分段标准(UAX #29),自动识别所有的代理对、肤色修饰符、ZWJ 序列、区域指示符和组合附加符,将其完整归并为一个不可分割的字素簇。
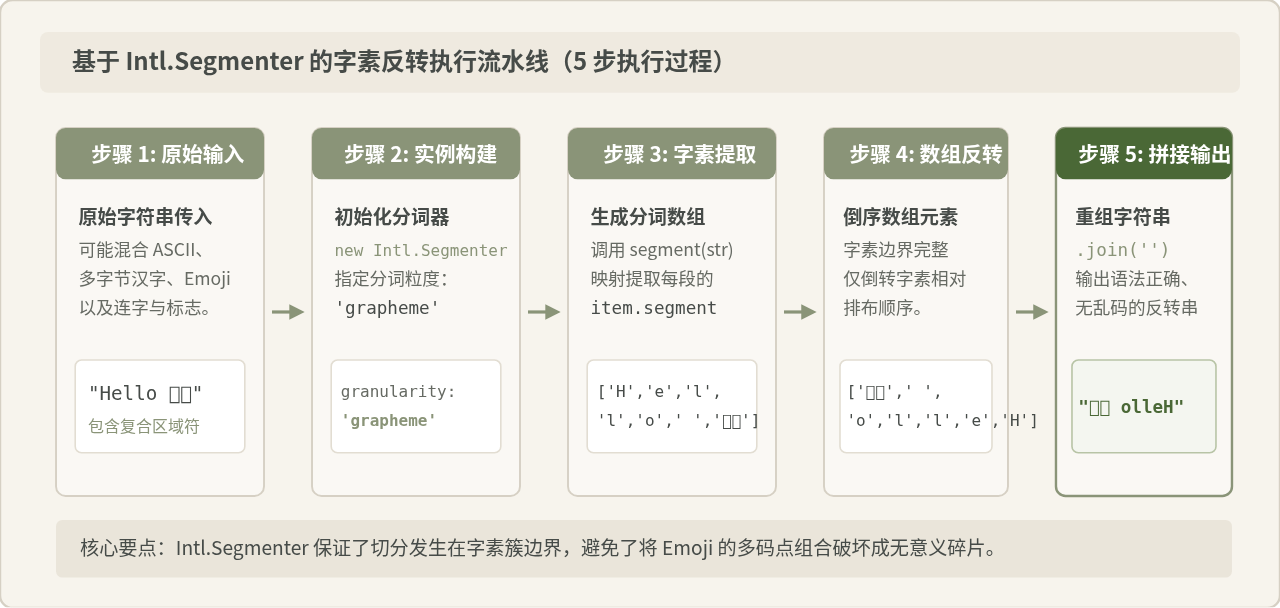
图 2:基于 Intl.Segmenter 的字素反转执行流水线
完整标准实现代码
以下是使用 Intl.Segmenter 实现的安全字符串反转函数:
/**
* 按照用户感知的字素簇(Grapheme Cluster)安全反转字符串
* @param {string} str - 需要反转的原始字符串
* @returns {string} - 反转后的字符串
*/
function reverseGraphemes(str) {
// 1. 创建字素分词器实例,granularity 设置为 'grapheme'
const segmenter = new Intl.Segmenter(undefined, { granularity: 'grapheme' });
// 2. 将分词迭代器转换为字素文本数组
const segments = Array.from(segmenter.segment(str), s => s.segment);
// 3. 反转数组并拼接返回
return segments.reverse().join('');
}
// 验证测试:
console.log(reverseGraphemes("Hello World!"));
// 示例输出: "!dlroW olleH"
console.log(reverseGraphemes("A 👍🏽 🇨🇳 👨👩👧👦 B"));
// 示例输出: "B 👨👩👧👦 🇨🇳 👍🏽 A"
// 结果分析: 所有的肤色修饰、国旗符号以及家庭组合 Emoji 均保持结构完整,毫无乱码
代码执行机制解析:
segmenter.segment(str) 返回一个具有可迭代能力的 Segments 对象。通过 Array.from(segments, s => s.segment),我们将每一个被正确划界的完整字素提取为纯字符串数组元素。由于数组中的每一个单元在排印上都具备原子性,直接调用 Array.prototype.reverse() 只会调换不同字素之间的相对前后顺序,不会触动字素内部的编码组合。
四、多方案能力对比与验证
为了直观展现各方案的边界差异,我们可以对比不同字符在传统方式、展开运算符与 Intl.Segmenter 下的实际处理效果:
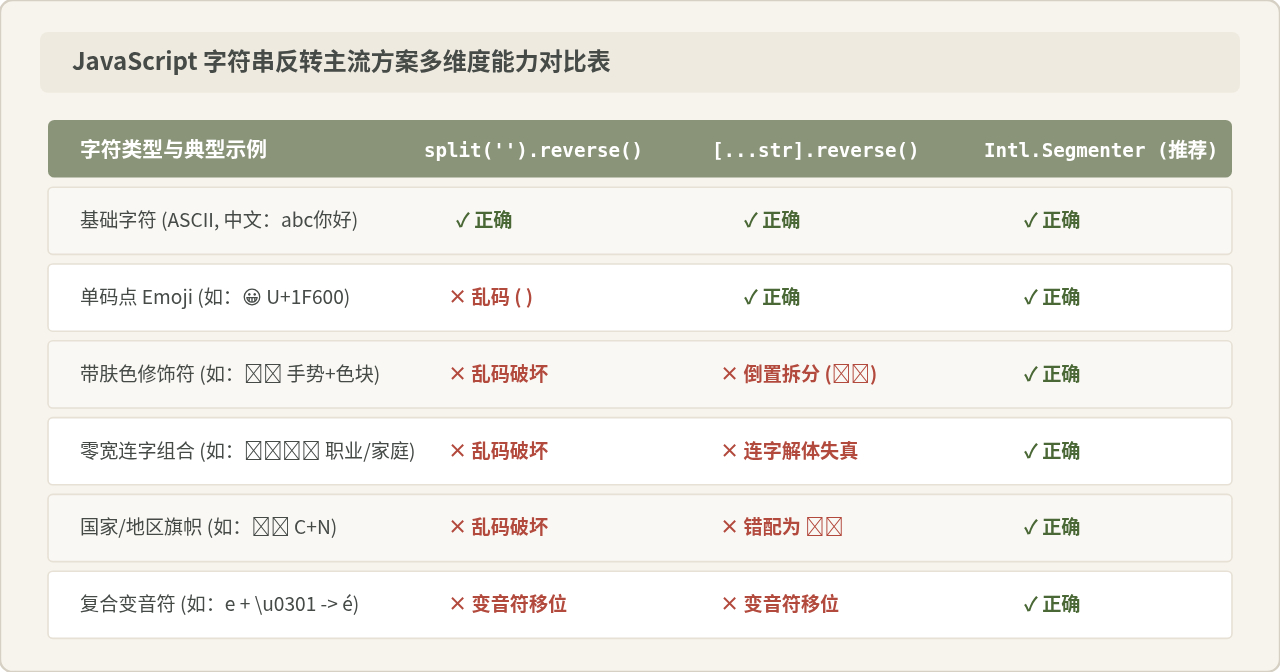
图 3:各方案在不同 Unicode 字符类型下的能力矩阵对比
| 输入字符串示例 | split('').reverse().join('') |
[...str].reverse().join('') |
reverseGraphemes(str) |
|---|---|---|---|
"abc 123" |
"321 cba" (正常) |
"321 cba" (正常) |
"321 cba" (正常) |
"😀" (U+1F600) |
" " (代理对破损乱码) |
"😀" (正常) |
"😀" (正常) |
"👍🏽" (U+1F44D + U+1F3FD) |
" " (双重破坏) |
"🏽👍" (肤色与手势颠倒分离) |
"👍🏽" (正常完整) |
"🇨🇳" (U+1F1E8 + U+1F1F3) |
" " (乱码) |
"🇳🇨" (国旗颠倒,变为新喀里多尼亚) |
"🇨🇳" (正常完整) |
"👨👩👧👦" (ZWJ 序列) |
产生连续 |
"👦👧👩👨" (连字混乱解体) |
"👨👩👧👦" (正常完整) |
五、兼容性处理与备选方案
在工程落地时,需要明确不同运行环境对 Intl.Segmenter 的支持情况:
- 现代浏览器支持良好:Chrome 87+、Edge 87+、Safari 14.1+ 以及 Firefox 125+ 均已全面原生支持。
- Node.js 运行环境:Node.js 从 v16.0.0 开始已默认集成该 API。
如果在项目维护中需要兼容老旧浏览器(如旧版 Firefox 长期支持版或低版本 WebView),直接调用可能会报 TypeError: Intl.Segmenter is not a constructor。此时可根据项目约束选择如下替代或兜底手段:
备选方案 1:引入社区成熟的字素分割库(推荐)
在无法确保宿主环境版本时,推荐引入专门遵循 Unicode 标准规范的轻量分词库,例如 grapheme-splitter:
// 需先在项目中安装: npm install grapheme-splitter
import GraphemeSplitter from 'grapheme-splitter';

function reverseWithPolyfill(str) {
  if (typeof Intl !== 'undefined' && Intl.Segmenter) {
    const segmenter = new Intl.Segmenter(undefined, { granularity: 'grapheme' });
    return Array.from(segmenter.segment(str), s => s.segment).reverse().join('');
  }

  // 降级使用字素分割库
  const splitter = new GraphemeSplitter();
  return splitter.splitGraphemes(str).reverse().join('');
}
备选方案 2:基于现代正则的 Unicode 属性转义(需审慎评估)
若仅仅需要处理部分带组合符的字符且运行在支持 ES2018 的环境中,可以通过正则匹配字素簇。但需要注意,纯原生正则表达式难以完全覆盖复杂的 ZWJ 序列与全套区域指示符,对于生产环境的严谨国际化需求,依然建议使用 Intl.Segmenter 或专业分词库。
六、总结与工程决策指南
处理含 Emoji 或特殊 Unicode 字符的反转问题时,核心关键是区分“编码存储单位”与“排版渲染单位”。解决步骤可归纳如下:
- 坚决弃用
str.split('').reverse().join('')这一遗留写法,它无法应对任何超出基本多语言平面的现代符号。 - 对于简单字符流或受限内部字符集,了解
[...str]的局限性,不要假定它能正确处理所有 Emoji。 - 在现代项目(现代 Web 页面、Electron、Node.js 16+ 后端)中,将
Intl.Segmenter({ granularity: 'grapheme' })作为标准的反转实现。 - 在老旧系统或需要广泛兼容性的 SDK 中,引入轻量级字素分割工具进行降级保护。
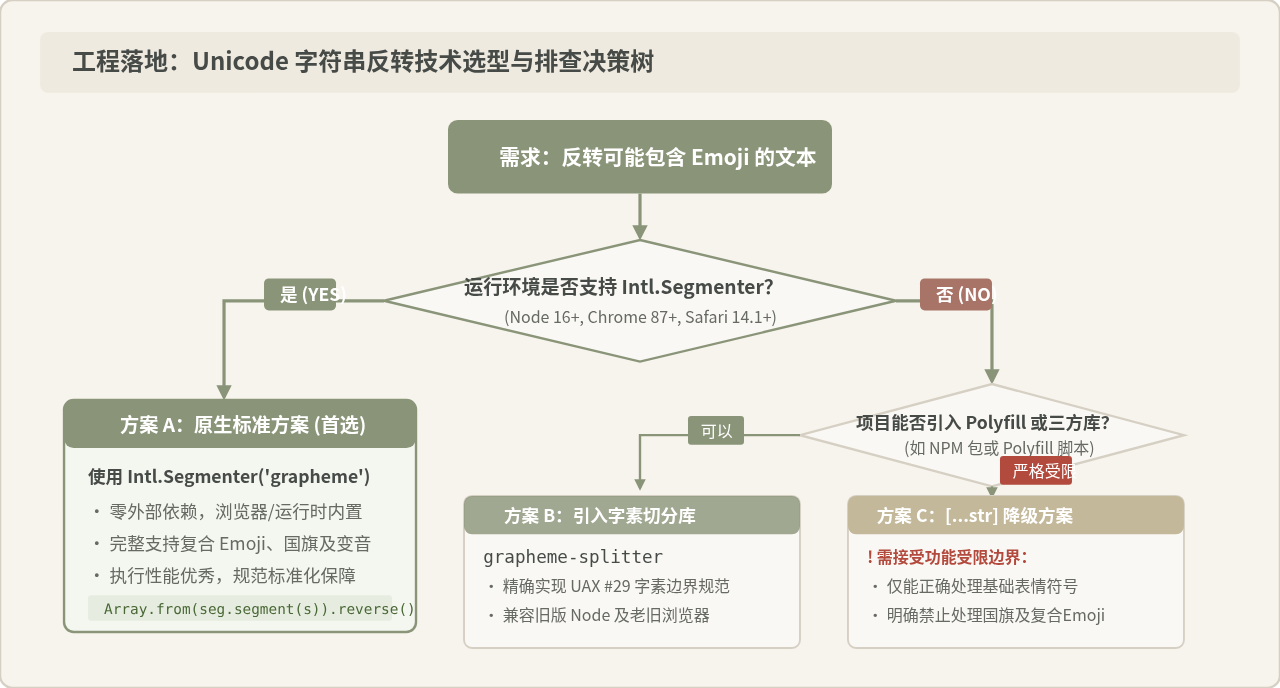
图 4:Unicode 字符串反转技术选型与排查决策树
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章