
在JavaScript中进行关键词过滤时,用户输入常伴随不同的大小写组合。本文详解如何利用正则表达式的i修饰符、特殊字符转义、批量词库合并以及Unicode大小写折叠,实现高效安全的大小写不敏感匹配与脱敏替换。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript过滤关键词时怎么处理大小写不敏感匹配
作者:闭包旅人
时间:2026-11-21
浏览:495
文章目录
分类:前端开发 / JavaScript 实战
阅读时长:约 8 分钟
关键词:正则表达式 / 字符串替换 / 过滤脱敏
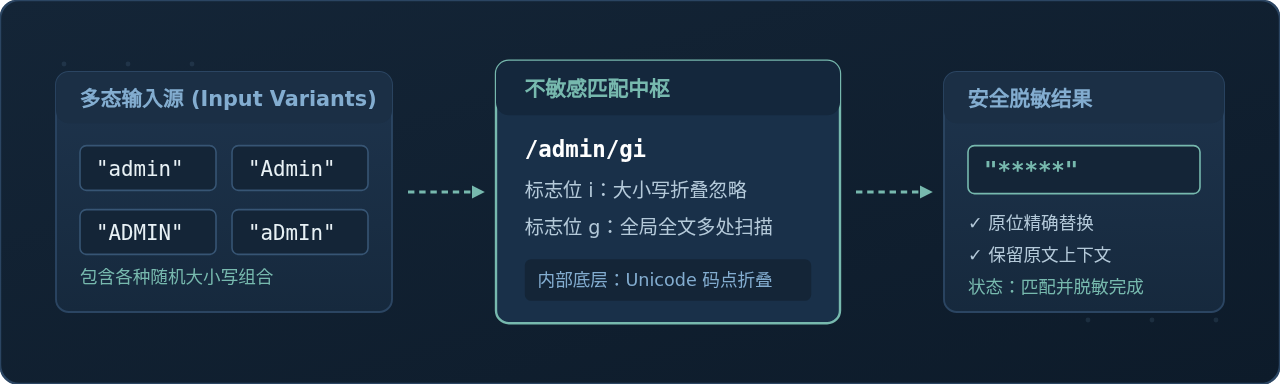
核心解决路径:在 JavaScript 中处理大小写不敏感的关键词过滤,核心做法是通过
new RegExp(escapedKeyword, 'gi') 动态构建带有 i(ignoreCase)修饰符的正则表达式,并对关键词中的特殊元字符进行先期转义;如需批量过滤多词,应使用 | 管道符将词库拼接为单条正则,在保留原始文本上下文大小写排版的同时,单次遍历完成脱敏替换。
一、问题情境:为什么简单匹配无法满足需求
假设我们正在开发一个论坛的互动评论区,系统要求拦截或脱敏敏感词(例如 admin)。在实际测试中经常发现:如果用户输入纯小写的 admin,基础的字符串替换能够生效;但如果用户输入 Admin、ADMIN 甚至交错混写的 aDmIn,简单的字符串全等比较或者不带标志位的 text.replaceAll('admin', '***') 就会彻底失效。
这是因为 JavaScript 原生字符串方法(如 indexOf、includes、replaceAll 的字符串参数形式)在默认情况下都是严格区分字符码点的。要让程序识别出拼写相同但大小写不同的所有变体,开发者主要有两种处理思路:一种是将文本和关键词统一转换为小写进行比对,另一种是利用正则表达式引擎内置的大小写折叠机制。在实际开发中,根据是“只读判断存在性”还是“做原位脱敏替换”,两者的具体实现截然不同。
二、核心方案:使用正则表达式的 i 标志位
处理大小写不敏感过滤最标准、最通用的方式是借助正则表达式的 i(ignoreCase)修饰符。当正则开启了 i 标志时,正则引擎在进行状态机转移时会自动做大小写折叠(Case Folding),从而把大写字母、小写字母等同对待。
1. 静态与动态正则的构造方式
若关键词在代码编写时就已经固定,可以直接使用正则字面量:
// 静态字面量方式:使用 i 忽略大小写,g 表示全局匹配
const rawText = "Hello Admin, please contact the ADMIN team.";
const filteredText = rawText.replace(/admin/gi, "***");
console.log(filteredText);
// 输出示例:Hello ***, please contact the *** team.
然而在绝大多数实际业务场景中,关键词列表往往是动态获取的(例如从后端接口拉取的敏感词库或用户动态输入的搜索词)。此时必须使用 new RegExp() 构造函数动态生成正则表达式:
function filterSingleWord(text, keyword) {
  // 传入 'gi' 标志:全局匹配 + 忽略大小写
  const regex = new RegExp(keyword, 'gi');
  return text.replace(regex, '***');
}
2. 关键防御:动态关键词必须进行元字符转义
使用 new RegExp() 最容易被忽视但后果极其严重的一个缺陷是:动态输入的关键词可能包含正则表达式元字符。例如用户搜索或需要过滤的词是 c++、vip?、v.i.p 或 [test],如果直接传入 new RegExp("c++", "gi"),由于 + 是量词,正则引擎会直接抛出语法错误 SyntaxError: Invalid regular expression 导致整个页面脚本崩溃;而如果是 v.i.p,点号会被误当成“匹配任意字符”,导致非预期的误杀。
因此,动态构造正则前,必须使用转义函数把特殊元字符降级为普通字面量:
/**
 * 安全转义正则表达式中的所有特殊元字符
 * 包括:. * + ? ^ $ { } ( ) | [ ]  */
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 安全过滤函数
function safeFilterKeyword(text, keyword, mask = '***') {
  if (!keyword || !text) return text;
  const safePattern = escapeRegExp(keyword);
  const regex = new RegExp(safePattern, 'gi');
  return text.replace(regex, mask);
}

// 验证特殊字符
const comment = "Learning C++ and c++ at VIP? and vip?";
console.log(safeFilterKeyword(comment, "c++"));
// 示例输出: "Learning *** and *** at VIP? and vip?"
3. 进阶替换:保留原词长度的动态遮罩
很多产品设计要求敏感词被遮罩为与原文相同长度的字符(例如 Admin 替换为 *****,c++ 替换为 ***),以便读者感知词语占位而不破坏整体排版。借助 String.prototype.replace 的回调函数参数,我们可以直接获取每次命中的实际原始文本:
function maskKeywordWithLength(text, keyword) {
  const regex = new RegExp(escapeRegExp(keyword), 'gi');
  return text.replace(regex, (matched) => {
    // matched 即为当前实际命中的文本片段(如 'Admin' 或 'ADMIN')
    return '*'.repeat(matched.length);
  });
}

const sample = "The ADMIN verified that admin is ready.";
console.log(maskKeywordWithLength(sample, "admin"));
// 示例输出: "The ***** verified that ***** is ready."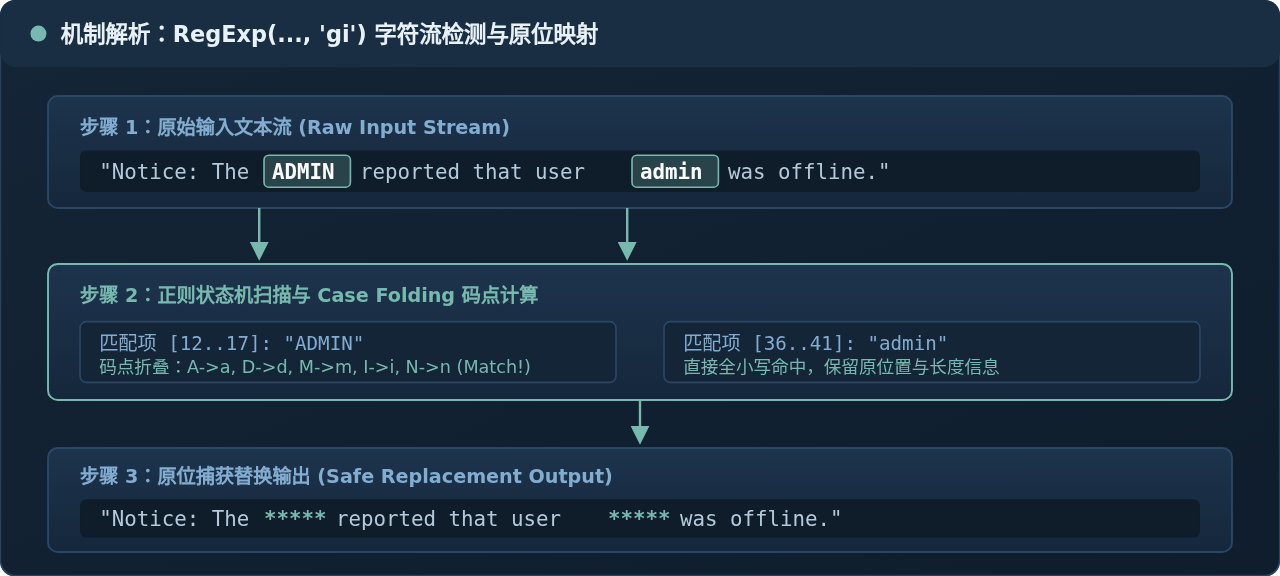
三、进阶实践:批量多关键词的高性能过滤流水线
实际生产项目中很少只过滤单一关键词,系统通常需要对包含了成百上千个敏感词的词库进行全文本过滤。许多初学者会写出如下的多次循环循环替换:
// 错误示例:低效的多重循环替换(反模式)
function badBatchFilter(text, wordList) {
  let result = text;
  for (const word of wordList) {
    const regex = new RegExp(escapeRegExp(word), 'gi');
    result = result.replace(regex, '***'); // 每一轮都全量重新扫描并创建新字符串
  }
  return result;
}
这种写法的算法复杂度是 O(M × N)(M 为词库长度,N 为文章长度),若词库有 2000 个词,对一篇文章就要完整扫描 2000 次,产生大量的中间字符串垃圾,严重拖慢渲染性能。
1. 正则管道合并与单趟扫描
解决批量过滤性能问题的核心策略是:利用正则表达式的分组管道符 | 将所有转义后的词汇合并为一条复合正则表达式。这样 JavaScript 的底层正则引擎(如 V8 的 Irregexp)会将其编译为统一的确定性有限状态自动机(DFA/NFA),只需要单次遍历待检文本,即可同时识别并过滤词库中的任意关键词。
/**
 * 高性能多关键词批量脱敏过滤
 * @param {string} text - 原始文本
 * @param {string[]} keywords - 敏感词库数组
 * @param {string|Function} [replacer='***'] - 替换内容或动态回调
 * @returns {string} 过滤后的文本
 */
function batchFilterKeywords(text, keywords, replacer = '***') {
  if (!text || !Array.isArray(keywords) || keywords.length === 0) {
    return text;
  }

  // 1. 过滤空值并安全转义
  const escapedTokens = keywords
    .filter(word => typeof word === 'string' && word.trim().length > 0)
    .map(escapeRegExp);

  if (escapedTokens.length === 0) return text;

  // 2. 按词长降序排列(避免短词先匹配截断长词,如 "admin" 优先于 "ad")
  escapedTokens.sort((a, b) => b.length - a.length);

  // 3. 使用非捕获组与管道符拼接,编译为单条正则
  const combinedPattern = `(?:${escapedTokens.join('|')})`;
  const combinedRegex = new RegExp(combinedPattern, 'gi');

  // 4. 单次遍历完成所有替换
  if (typeof replacer === 'function') {
    return text.replace(combinedRegex, replacer);
  }
  return text.replace(combinedRegex, replacer);
}

// 测试多词库批量过滤
const sensitiveWords = ['admin', 'c++', 'secret key', 'vip'];
const inputContent = "Hello ADMIN, please keep the Secret Key and c++ token safe for VIP users.";

// 示例 1:固定掩码
console.log(batchFilterKeywords(inputContent, sensitiveWords, '***'));
// 示例输出: "Hello ***, please keep the *** and *** token safe for *** users."

// 示例 2:动态等长掩码
const dynamicMasked = batchFilterKeywords(inputContent, sensitiveWords, (m) => '*'.repeat(m.length));
console.log(dynamicMasked);
// 示例输出: "Hello *****, please keep the ********** and *** token safe for *** users."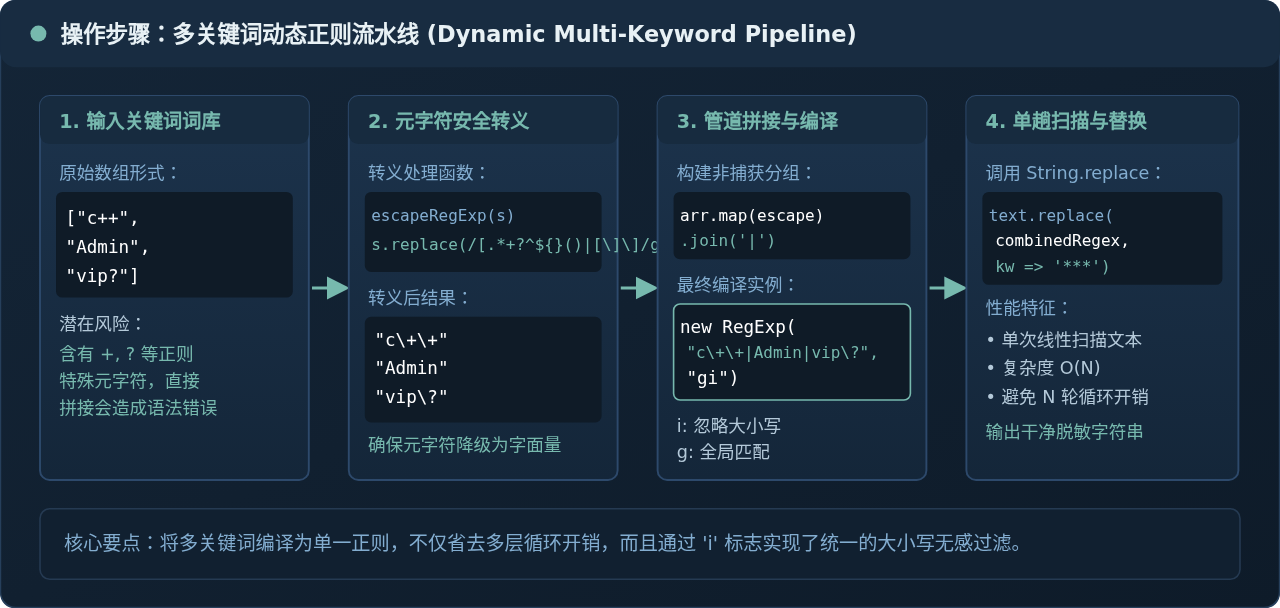
四、方案对比:toLowerCase() 方案的适用边界与局限
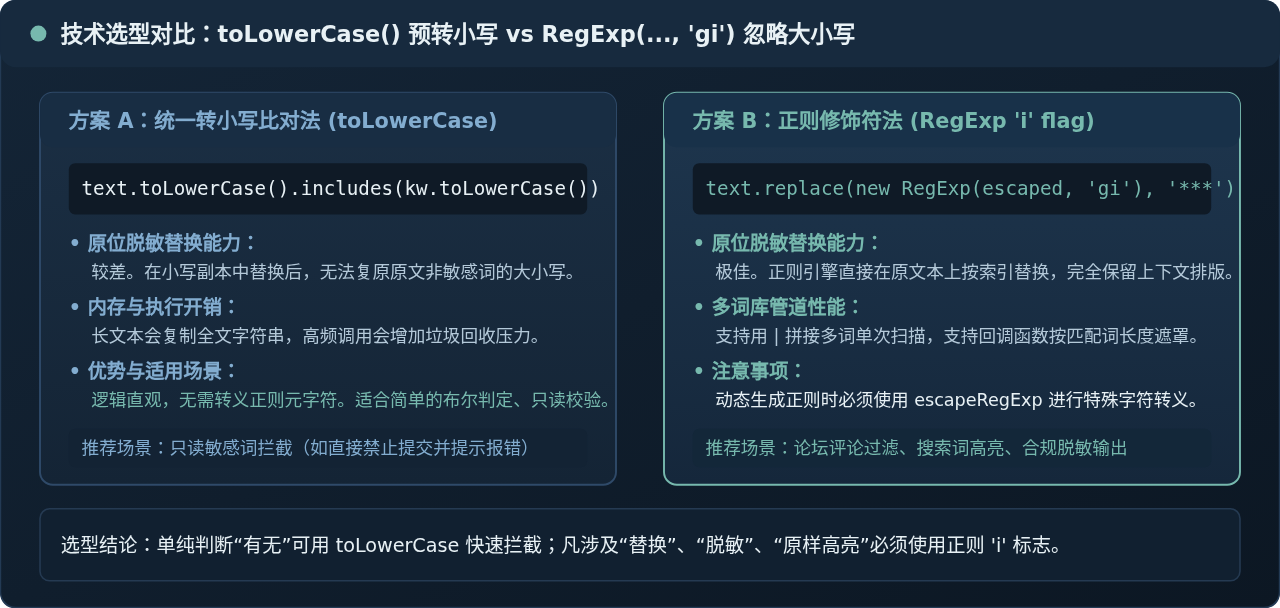
除了正则表达式,很多开发者第一反应是使用 toLowerCase()。我们需要客观认识它的优缺点:
1. toLowerCase() 的适用场景:只读的存在性检测
如果业务需求极其单纯——仅仅需要在用户提交时,判断内容中是否存在某个关键词,若存在则直接弹窗拦截并禁止提交,此时并不涉及修改字符串内容,使用 toLowerCase() 是非常轻量且直截了当的:
// 仅作布尔检测:判断是否包含关键词(大小写不敏感)
function hasKeyword(content, keyword) {
  if (!content || !keyword) return false;
  return content.toLowerCase().includes(keyword.toLowerCase());
}

console.log(hasKeyword("Welcome SuperAdmin!", "admin")); // true
此方法的明显优点是:不需要编写任何正则表达式,完全规避了 c++、[test] 等特殊符号引发的元字符转义隐患,执行速度极快。
2. 为什么在“脱敏替换”时不建议使用 toLowerCase()
如果需求是“将文本中的敏感词替换为星号,同时把其余合法内容展示给其他用户”,toLowerCase() 就存在根本性的致命缺陷:
- 原文字符大小写丢失:如果先把整篇文章
text = text.toLowerCase(),再把敏感词替换掉,整篇文章原本正常的大写首字母(如专有名词、句子开头、英文缩写)将全被强制转为小写,彻底破坏原文排版。 - 偏移量映射极其复杂:若试图在小写文本中用
indexOf找出起始索引,再去切割原始字符串做拼接,一旦出现多次匹配或替换长度不一致的情况,开发者必须手动维护大量的字符偏移量计算,代码冗长且极易出现索引错位 Bug。
五、生产级考量:Unicode 规范化与混淆防范
在严肃的内容安全审核和过滤系统中,仅仅考虑纯 ASCII 英文字母的大小写折叠往往还不够。恶意用户经常使用形态相似的特殊字符来绕过大小写检测:
1. 全角字母与 Unicode 兼容变体绕过
例如用户输入全角英文字母 Admin(Fullwidth Latin Capital/Small Letters),在普通的 ASCII 码下与标准 Admin 是完全不同的 Unicode 码点。如果直接进行正则比对,/admin/gi 将无法命中。
针对此类绕过,应在进入正则过滤前,使用 JavaScript 原生的 String.prototype.normalize() 进行兼容性分解与重组:
// 使用 NFKC 规范化将全角字母统一转换为标准半角字符
function normalizeInput(text) {
  if (!text) return '';
  return text.normalize('NFKC');
}

const bypassText = "请联系 Admin 处理"; // 全角字符
const normalized = normalizeInput(bypassText);
console.log(normalized); // "请联系 Admin 处理" (已转换为标准半角)

// 随后使用 /admin/gi 即可顺利识别并替换
console.log(safeFilterKeyword(normalized, "admin"));
// 输出: "请联系 *** 处理"
2. 正则的 u (Unicode) 标志位
在处理多语言或特殊字符集时,建议为动态正则表达式同时添加 u 标志位(如 'giu')。u 标志不仅确保正则引擎将 4 字节的 Emoji 和代理对(Surrogate Pairs)视作单一码点,还会启用 Unicode 标准定义的完整大小写折叠算法,避免由于高低位代理分离引发的罕见匹配异常。
3. 词库编译缓存优化
在 Node.js 服务端或高频调用的前端组件中,每次执行过滤都重新执行 words.map(escapeRegExp).join('|') 并 new RegExp() 存在不必要的重复计算。建议将编译好的正则实例缓存起来:
// 正则实例缓存工厂
class KeywordFilterEngine {
  constructor(keywordList) {
    this.regex = this.compile(keywordList);
  }

  compile(list) {
    const safeTokens = list
      .filter(w => typeof w === 'string' && w.trim().length > 0)
      .map(escapeRegExp)
      .sort((a, b) => b.length - a.length);

    return new RegExp(`(?:${safeTokens.join('|')})`, 'giu');
  }

  filter(text, mask = '***') {
    if (!text) return '';
    // 先做 Unicode 规范化,再执行单趟正则替换
    const cleanText = text.normalize('NFKC');
    return cleanText.replace(this.regex, typeof mask === 'function' ? mask : mask);
  }
}

// 预先初始化引擎(仅编译一次)
const engine = new KeywordFilterEngine(['admin', 'root', 'c++']);

// 后续任意调用均为极致的 O(N) 匹配
console.log(engine.filter("User Admin login with ROOT access."));
// 输出: "User *** login with *** access."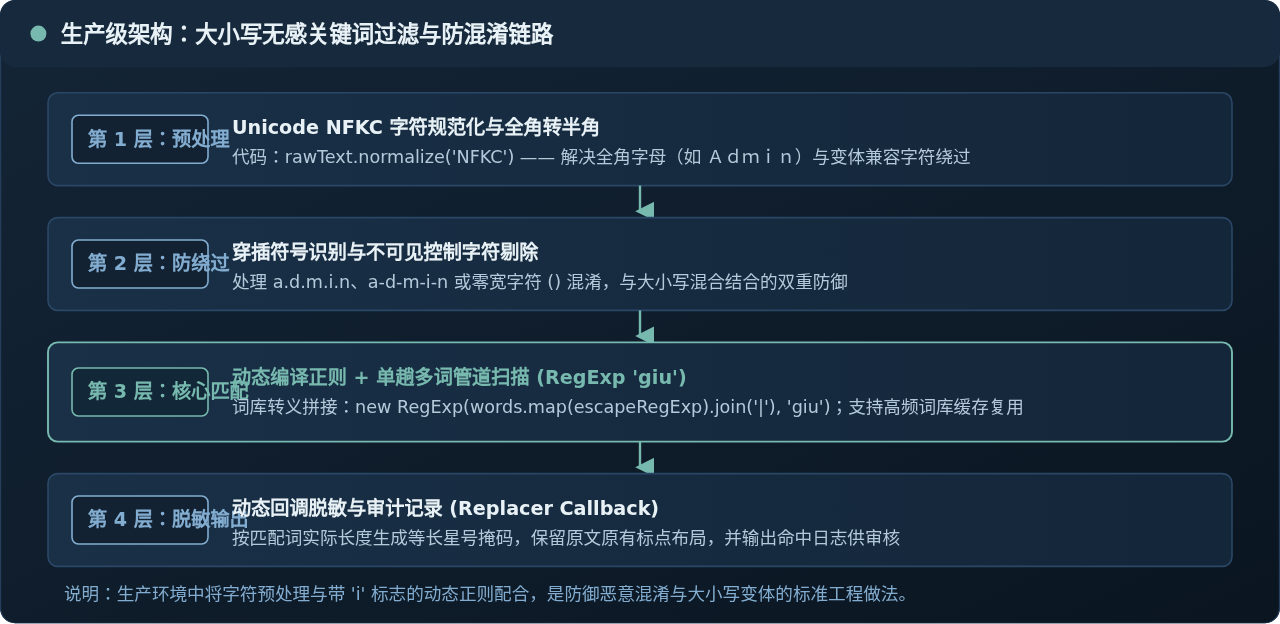
六、方案选型与开发检查清单
为了帮助开发者在实际开发中快速做出最合理的架构抉择,以下整理了核心场景的选型矩阵与上线前的关键排查项:
| 业务场景 | 推荐方案 | 关键考量因素 |
|---|---|---|
| 表单提交前只读检查(存在即阻断) | content.toLowerCase().includes(kw.toLowerCase()) |
逻辑极简,无正则元字符语法报错风险,执行速度快。 |
| 单关键词动态脱敏/替换 | text.replace(new RegExp(escapeRegExp(kw), 'gi'), '***') |
必须对关键词进行转义,确保原文本上下文大小写不受破坏。 |
| 大词库批量内容审核与脱敏 | 预编译管道正则 new RegExp(escapedWords.join('|'), 'giu') |
单趟扫描避免性能衰减,降序排序解决词缀冲突,结合缓存提升吞吐。 |
| 防恶意变体攻击的高防场景 | NFKC 规范化 + 剔除穿插符号 + 管道正则 'giu' |
多层防御体系,有效拦截全角变体、零宽字符与大小写混合绕过。 |
上线前开发自查清单:
- 所有动态传入
new RegExp的关键词是否均经过了escapeRegExp处理? - 是否按要求启用了
i(忽略大小写)和g(全局扫描)修饰符? - 批量关键词拼接前是否执行了降序排序,防止短词“抢先匹配”破坏长词?
- 是否考虑了用户使用全角字母绕过的可能,并在前置处理中加入了
normalize('NFKC')? - 高频调用场景是否复用了已编译的 RegExp 实例,避免重复构建造成垃圾回收压力?
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章