
详细讲解如何使用 JavaScript 原生的 filter 和 find 方法替代传统的 for 循环与 if 条件判断,深入剖析执行原理、短路机制、代码重构步骤及工程避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
怎么用filter和find替代JS传统循环中的条件判断
作者:闭包旅人
时间:2026-11-21
浏览:426
文章目录
一、传统循环条件判断的问题与重构思路
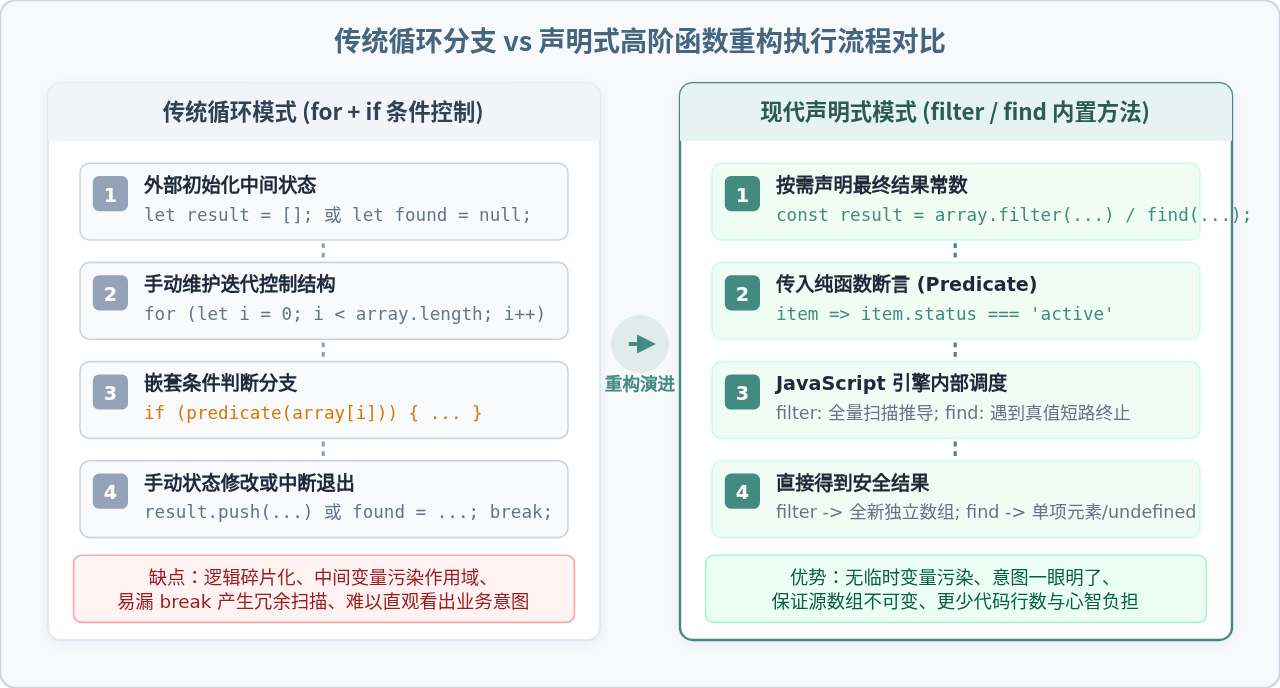
在日常前端与 Node.js 业务开发中,遍历数组并基于条件提取数据是非常高频的操作。过去开发者普遍依赖命令式的 for、while 或 for...of 结构:
// 场景 A:筛选出所有已启用的用户(传统模式)
const rawUsers = [
  { id: 1, name: '张三', active: true },
  { id: 2, name: '李四', active: false },
  { id: 3, name: '王五', active: true }
];

let activeUsers = []; // 必须在外部维护可变空数组
for (let i = 0; i < rawUsers.length; i++) {
  if (rawUsers[i].active === true) {
    activeUsers.push(rawUsers[i]); // 手动推入结果
  }
}

// 场景 B:根据 ID 查找指定商品并立即终止循环(传统模式)
let matchedProduct = null; // 必须在外部声明可能为 null 的变量
for (let i = 0; i < products.length; i++) {
  if (products[i].id === targetId) {
    matchedProduct = products[i];
    break; // 容易漏写 break 导致多余遍历
  }
}
这种写法虽然直观,但在工程维护中存在三个主要痛点:
- 逻辑样板繁重且易碎: 开发者必须同时关心循环计数器
i的边界、自增步长、数组长度判断,一旦边界条件写错就会引发死循环或下标越界。 - 状态暴露与意外修改:
activeUsers或matchedProduct必须用let提前暴露在外部作用域中,很容易在后续流程中被意外重写。 - 语义模糊: 读者无法一眼看出循环的最终目的。必须完整读完循环体内部的
if、push、break或continue之后,才能倒推出这是在做“多项过滤”还是“单项检索”。
重构的核心思路是把“怎么做(How)”委托给 JavaScript 引擎内置迭代器,把“要什么(What)”通过断言函数(Predicate)传递给引擎。
二、用 filter 收集所有符合条件的项
当原循环的业务目标是“从列表中筛选出满足某条件的所有子集”时,使用 Array.prototype.filter() 替代。
1. 语法规范与基础重构
filter() 接收一个谓词回调函数,为数组中的每个元素执行一次该回调。如果回调返回真值(truthy),该元素会被包含在返回的新数组中;如果返回假值(falsy),则被跳过。
// 重构后:单行声明,语义清晰
const activeUsers = rawUsers.filter(user => user.active);

// 示例输出:
// [ { id: 1, name: '张三', active: true }, { id: 3, name: '王五', active: true } ]
2. 复合条件判断场景
在实际业务中,if 分支常常包含多重逻辑判断。在 filter 回调中可以直接书写复合布尔表达式,也可以将复杂判断拆解为具名断言函数:
const orders = [
  { orderId: 'A1', amount: 260, status: 'PAID', inStock: true },
  { orderId: 'A2', amount: 80,  status: 'PAID', inStock: true },
  { orderId: 'A3', amount: 450, status: 'PENDING', inStock: false },
  { orderId: 'A4', amount: 150, status: 'PAID', inStock: false }
];

// 业务规则:筛选金额大于 100 且已支付、有现货的高价值有效订单
const isHighValueReadyOrder = order =>
  order.amount > 100 &&
  order.status === 'PAID' &&
  order.inStock;

const priorityOrders = orders.filter(isHighValueReadyOrder);
不可变性与安全性保证
filter() 绝不会修改原数组,它始终创建一个新数组。当没有任何元素命中条件时,filter() 会返回一个空数组 []。这意味着调用方无需进行 if (result !== null) 防御,可以直接安全地接续调用 .map() 或获取 .length。
三、用 find 获取首个命中目标并实现原生短路
当原循环的业务目标是“定位某一个具体对象(如通过唯一 ID、工号查找),命中后即可停止遍历”时,使用 Array.prototype.find() 替代。
1. 语法规范与短路机制
在传统 for 循环中,找到目标元素后必须显式写 break 语句,否则程序会傻傻地继续执行剩余成千上万次无效循环。
find() 内置了惰性求值与短路机制(Short-circuiting):它从索引 0 开始依次执行回调函数,一旦回调返回真值,find() 立即返回当前元素的值,并永久终止遍历。后续元素的回调函数完全不会被触发。
const employees = [
  { id: 101, name: '赵工', role: 'developer' },
  { id: 102, name: '钱工', role: 'designer' },
  { id: 103, name: '孙工', role: 'tester' },
  { id: 104, name: '周工', role: 'manager' }
];

// 重构后:一行代码,命中后自动短路,无需 break
const designer = employees.find(emp => emp.role === 'designer');
console.log(designer); // { id: 102, name: '钱工', role: 'designer' }
2. 边界情况:未命中返回 undefined 与安全读取
如果数组中没有符合条件的元素,find() 会返回 undefined。在读取目标属性时,推荐配合 ES2020 可选链操作符(?.)和空值合并操作符(??):
// 查找不存在的架构师职位
const architect = employees.find(emp => emp.role === 'architect');

// 安全读取属性并设置回退默认值
const architectName = architect?.name ?? '暂无负责人';
console.log(architectName); // "暂无负责人"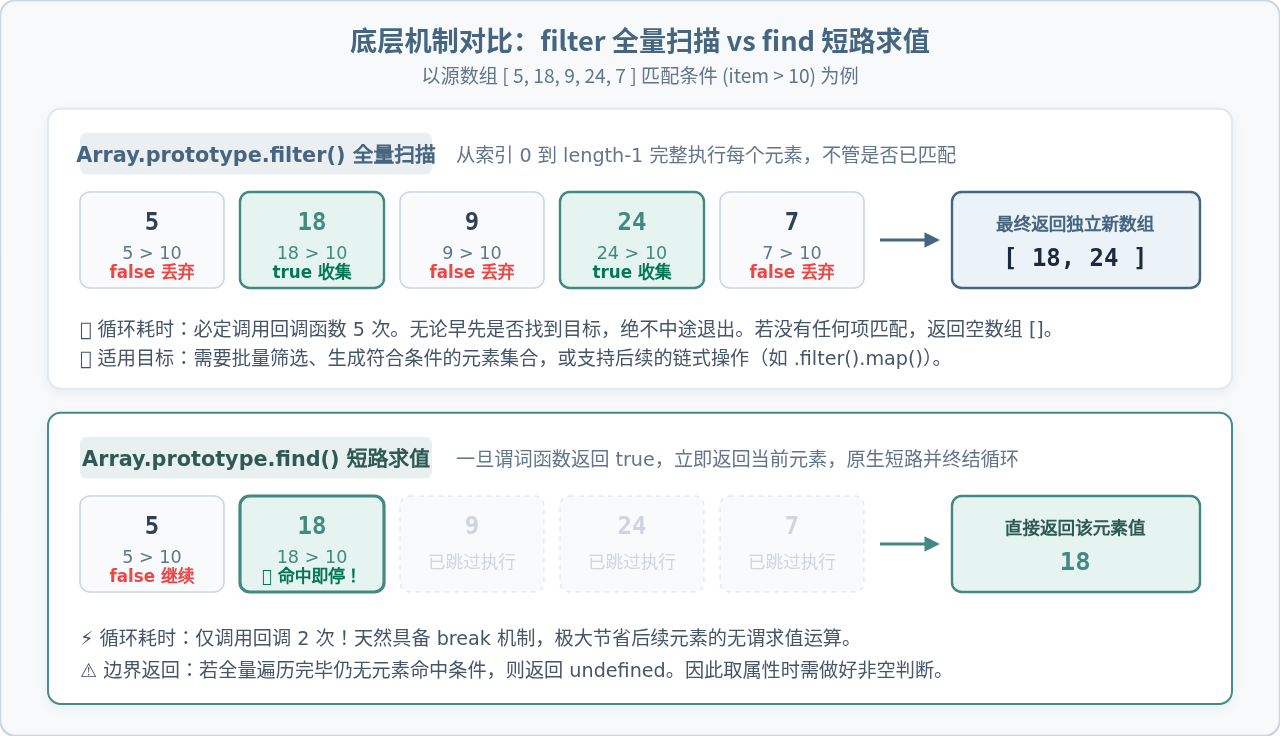
四、选型决策:什么时候用 filter,什么时候用 find?
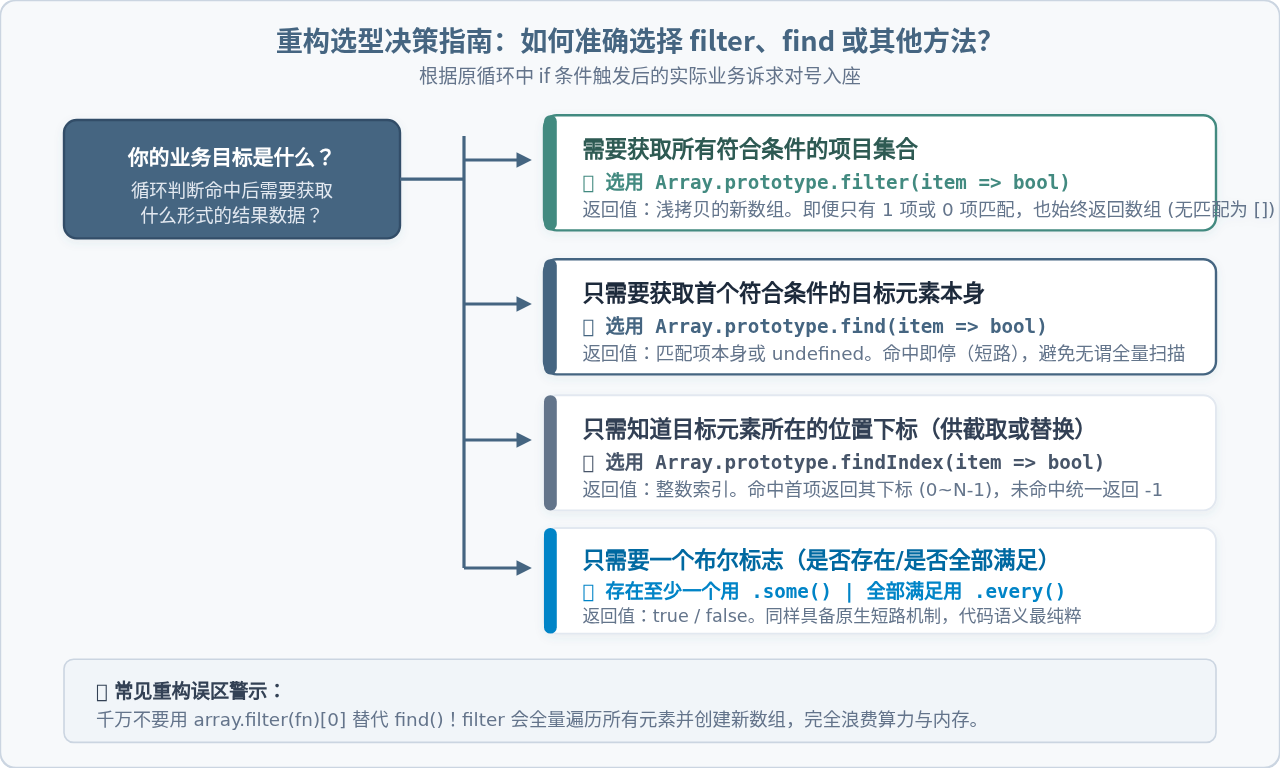
虽然两者都是基于条件函数执行检查,但在返回类型、遍历深度及内存分配上存在本质差异。在重构循环条件判断时,应遵循清晰的选型原则:
| 比较维度 | Array.prototype.filter() | Array.prototype.find() |
|---|---|---|
| 业务定位 | 筛选出所有符合条件的项目集合 | 获取第一个匹配的特定项目 |
| 返回值类型 | 全新的数组对象(Array) |
匹配项本身(Element)或 undefined |
| 未匹配结果 | 空数组 [] |
undefined |
| 循环控制 | 全量遍历每个元素(无法提前终止) | 遇首个真值立即短路退出 |
| 内存开销 | 分配新数组并填充引用 | 零额外容器分配,仅传递单一引用 |
相关近亲方法的补充边界
findIndex(): 如果循环条件命中后,你的目的不是要元素,而是要执行array.splice(index, 1)删除或替换该元素,那么应该使用findIndex()(未找到返回-1)。some(): 如果你在传统循环中设置了一个布尔标志位hasError = true; break;,只需知道“是否存在”,完全不需要获取元素本身,应选用some()。every(): 对应传统循环中验证“是否每一个都满足”。一旦遇到不满足的项即短路返回false。
五、工程实践与避坑指南
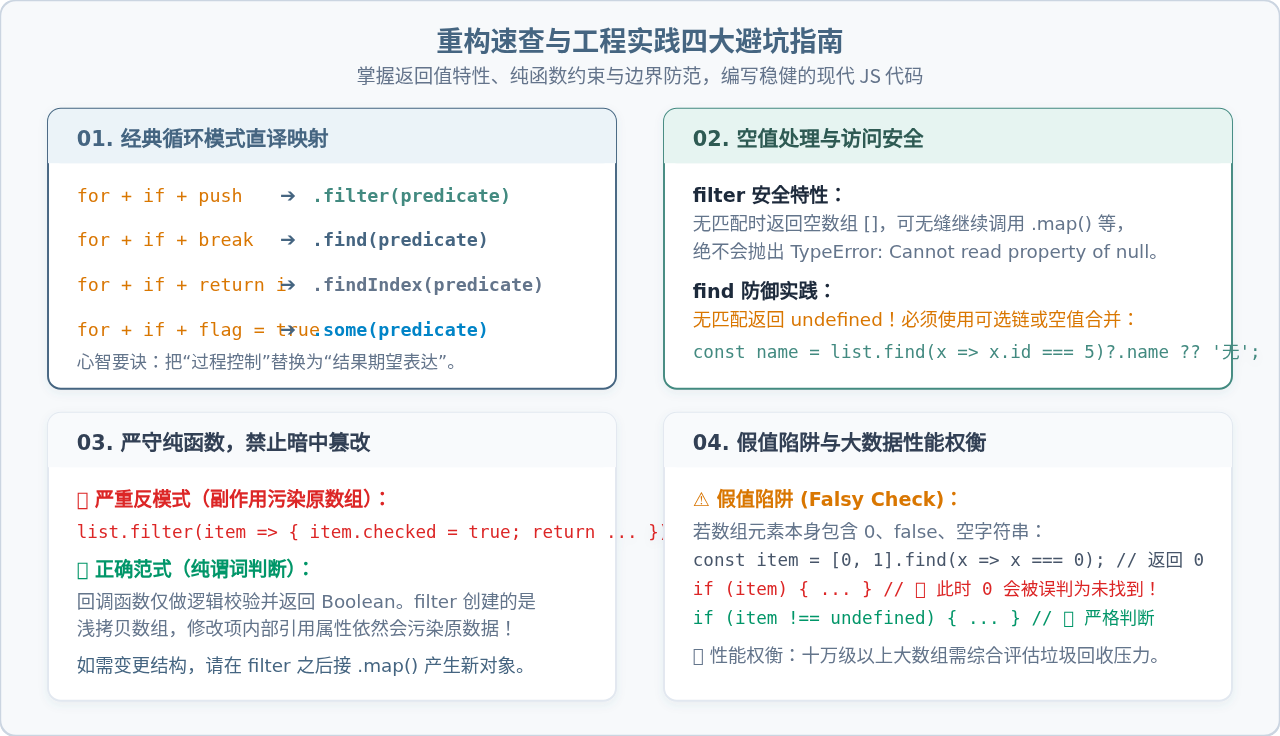
将传统循环改写为高阶函数时,有几处极易引发生产环境 Bug 的细节需要特别注意:
1. 严禁反模式:用 filter()[0] 模拟 find()
部分初学者习惯写 const item = list.filter(x => x.id === 5)[0];。这是一种典型的性能反模式!filter 会对 10 万条数据全部执行一遍回调并分配一个单元素数组,而 find 只要在第 2 条命中就会立刻终止执行。两者在性能上可能相差数十倍至数万倍。
2. 严守纯函数准则,杜绝暗中篡改对象
filter 和 find 的回调函数应该仅仅返回判断结果(true/false),绝对不能在回调内部修改元素属性或操作原数组:
// ❌ 严重反模式:借遍历之名产生副作用,污染原对象
const result = users.filter(user => {
  user.checked = true; // 破坏了数据不可变性,极易导致竞态问题
  return user.age >= 18;
});

// ✅ 正确范式:分离职责,筛选后再进行映射
const adultUsers = users
  .filter(user => user.age >= 18)
  .map(user => ({ ...user, checked: true }));
3. 假值元素的真值误判(Falsy Check)
当被查找的数组是原始基本类型(如数字、布尔值或字符串),且包含 0、false 或 "" 时,不能简单地用 if (found) 判断是否找到了元素:
const scores = [0, 12, 45, 78];
const zeroScore = scores.find(s => s === 0); // 返回 0

// ❌ 错误判断:0 在 JavaScript 中转换为 false,会误判为没找到
if (zeroScore) {
  console.log('找到了零分记录');
}

// ✅ 正确判断:显式与 undefined 进行严格不相等比较
if (zeroScore !== undefined) {
  console.log('成功命中:', zeroScore);
}
4. 简写箭头函数时的忘写 return 陷阱
如果箭头函数使用了花括号 {},必须显式书写 return,否则默认返回 undefined(假值),导致 filter 永远返回空数组、find 永远返回 undefined:
// ❌ 容易漏掉 return
const bad = list.filter(x => { x.status === 'active' }); // 永远得到 []

// ✅ 单行表达式隐式返回
const good1 = list.filter(x => x.status === 'active');

// ✅ 或多行时显式 return
const good2 = list.filter(x => {
  return x.status === 'active';
});
六、重构前后代码实战对照
最后,我们通过一段典型的业务代码重构前后对比,直观感受代码从命令式转向声明式后的简洁与健壮:
重构前(传统 for 循环 + if 条件判断):
// 需求:在购物车中找出首个未付款且已失效的商品,并收集所有折扣高于 20% 的可用商品
let firstInvalidItem = null;
let highDiscountItems = [];

for (let i = 0; i < cart.length; i++) {
  const item = cart[i];
  // 判断 1:找首个失效项
  if (!firstInvalidItem && !item.paid && item.expired) {
    firstInvalidItem = item;
  }
  // 判断 2:收集折扣商品
  if (item.discount > 0.2 && !item.expired) {
    highDiscountItems.push(item);
  }
}
重构后(职责分离的 find 与 filter):
// 声明式重构:意图一目了然,逻辑各自独立,无副作用
const firstInvalidItem = cart.find(item => !item.paid && item.expired);

const highDiscountItems = cart.filter(item => item.discount > 0.2 && !item.expired);
重构后的代码不仅消除了计数器与 push 样板代码,还消除了混合在同一个循环体里的多个异构逻辑,大幅提升了单元测试的编写便利性与长期可维护性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章