
深入解析 JavaScript 中 Array.prototype.sort() 对纯数字数组排序出现异常的根本原因,详细说明比较函数 compareFunction 的执行原理、升序降序正确写法,以及原地修改、减法溢出、NaN 等常见陷阱与防御方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
为什么JS sort()对数字排序会出错?正确写法与陷阱解析
作者:闭包旅人
时间:2026-11-21
浏览:582
文章目录
JavaScript 数组与算法机制
在 JavaScript 中直接对纯数字数组调用
[10, 25, 5, 1].sort(),得到的结果并不是直觉上的 [1, 5, 10, 25],而是 [1, 10, 25, 5]。这种现象并非引擎执行错误,而是源于 ECMAScript 规范的定义:缺省状态下的 sort() 会无差别地将所有元素转换为字符串,并按照 UTF-16 代码单元(Code Unit)的字符字典序逐位比较。要按真实的数字大小完成升序排列,必须显式传入比较函数 arr.sort((a, b) => a - b)。本文将从规范底层运作过程、比较函数决策机制、以及原地修改与异常极值等高频陷阱展开完整解析。
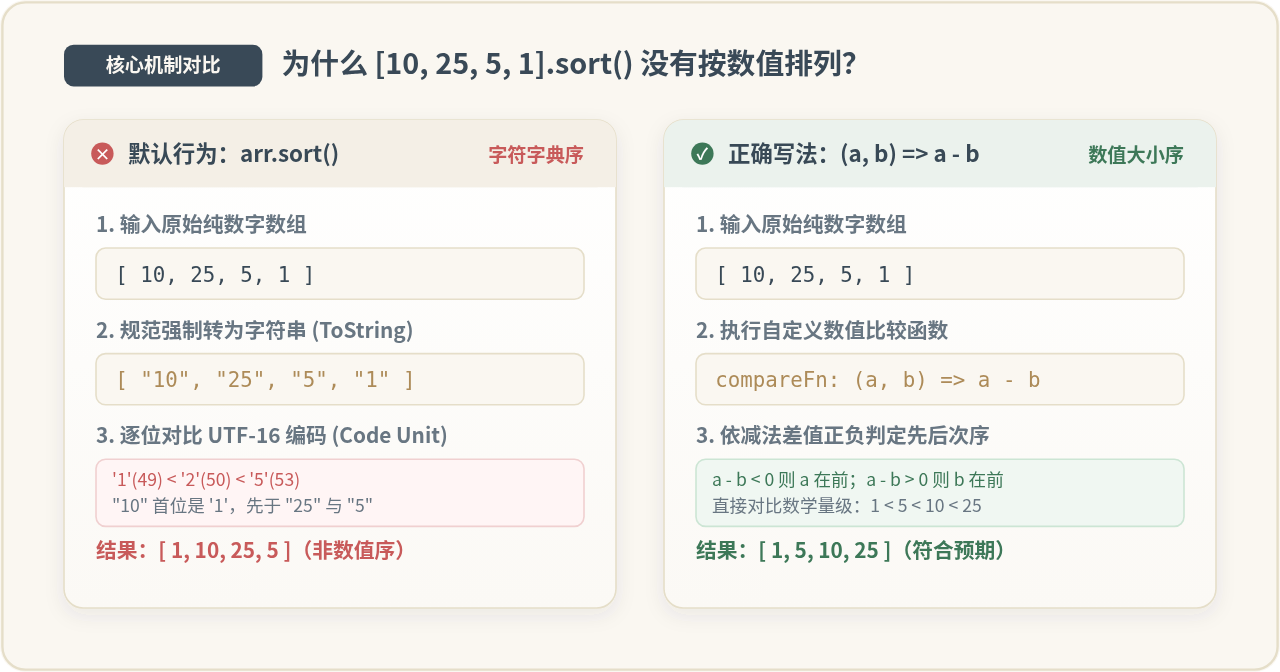
图 1:默认 sort() 字典序与传入自定义比较函数 (a, b) => a - b 数值序的效果对比
一、现象与根因:为什么 10 会排在 5 的前面?
很多初学者在第一次处理数字数组排序时,都会写出类似下面的代码:
// 示例:初学者常见的直接调用
const scores = [100, 25, 5, 40, 1];
scores.sort();

console.log(scores);
// 期望结果:[1, 5, 25, 40, 100]
// 实际输出:[1, 100, 25, 40, 5]在这个结果中,100 居然排在 25 前面,而 5 甚至被甩到了最后。要理解这一结果,需要查阅 ECMAScript 规范中对 Array.prototype.sort 的定义步骤:
- 步骤一:检查比较函数。如果调用
sort()时未传入comparefn(或传入undefined),引擎将启动默认比对算法SortCompare(x, y)。 - 步骤二:强制字符串转换。引擎在比对元素
x与y时,首先调用内部的ToString(x)与ToString(y)操作,将数字100转为字符串"100",25转为"25",5转为"5"。 - 步骤三:逐位核对 UTF-16 字符码。从字符串的第 0 位索引开始,比对各个字符的 Unicode UTF-16 代码单元值(即
charCodeAt(0)):- 字符
'1'的代码单元值为49(0x0031) - 字符
'2'的代码单元值为50(0x0032) - 字符
'4'的代码单元值为52(0x0034) - 字符
'5'的代码单元值为53(0x0035)
- 字符
因为字符 '1' 的编码 49 小于 '2' 的编码 50,所以在字典序中,字符串 "100" 会被判定为小于 "25"。比对过程在确定首字符大小后就已结束,多位数的总体数学大小完全不会参与评判。这就是数字在默认排序下表现反常的根源。
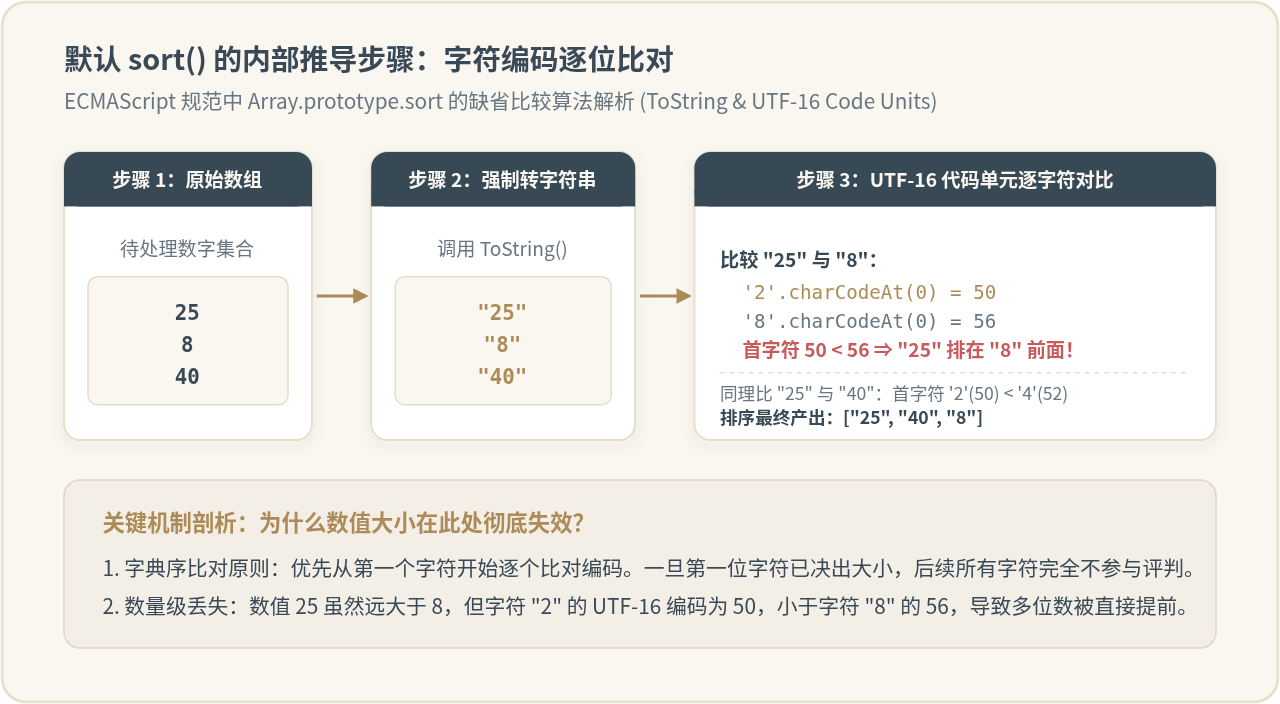
图 2:默认 sort() 算法将数字转为字符串并按 UTF-16 代码单元逐位推导的执行流程
二、正确写法:掌握比较函数(compareFunction)的工作机制
为了让数字按照数学量级排序,必须为 sort() 提供自定义的比较函数 compareFunction(a, b)。该函数接收两个待比较的元素,并依据其返回值的正负符号决定元素在排序后的相对顺序:
| 函数返回值范围 | 规范行为决策 | 排列结果 |
|---|---|---|
< 0(负数) |
判定 a 小于 b |
a 排在 b 前面(保持 [a, b]) |
=== 0(零) |
判定 a 与 b 权值相等 |
保持原有相对顺序(ECMAScript 2019+ 保证稳定排序) |
> 0(正数) |
判定 a 大于 b |
b 排在 a 前面(交换为 [b, a]) |
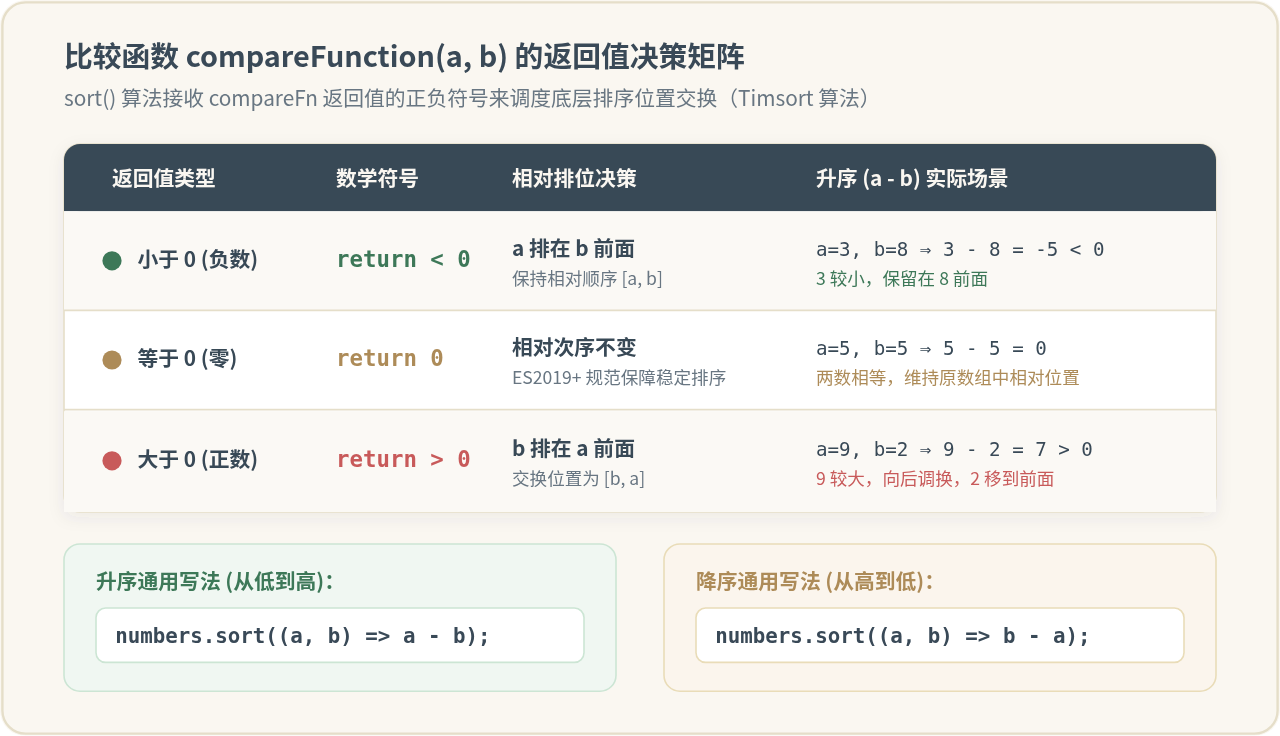
图 3:比较函数返回值正负判定与排序位置调度矩阵
1. 纯数字升序与降序
基于数字做差的特性:若 a < b 则 a - b < 0;若 a > b 则 a - b > 0。因此可以通过简单的减法表达式完成排序:
const numbers = [100, 25, 5, 40, 1];

// 1. 数值升序(从低到高:从小到大)
numbers.sort((a, b) => a - b);
console.log(numbers);
// 输出:[1, 5, 25, 40, 100]

// 2. 数值降序(从高到低:从大到小)
numbers.sort((a, b) => b - a);
console.log(numbers);
// 输出:[100, 40, 25, 5, 1]
2. 对象数组按数值字段排序
在前端业务场景中,数组通常是由包含各类数值属性的对象组成的。此时只需在比较函数中访问对应的数值键即可:
const products = [
  { id: 101, name: "键盘", price: 299 },
  { id: 102, name: "鼠标", price: 99 },
  { id: 103, name: "显示器", price: 1499 }
];

// 按商品价格从低到高排序
products.sort((a, b) => a.price - b.price);

console.log(products.map(p => `${p.name}: ¥${p.price}`));
// 输出:["鼠标: ¥99", "键盘: ¥299", "显示器: ¥1499"]
三、不可忽视的四大高频陷阱与规避方案
掌握了 (a, b) => a - b 之后,在实际工程项目中仍然可能会踩入隐蔽的暗坑。以下总结了开发中四类典型陷阱及其解决方案。
陷阱一:原地修改(In-Place Mutation)破坏原数据
JavaScript 中的 Array.prototype.sort 并不是纯函数。它会直接修改原数组内存中的排列,同时返回原数组的引用:
const originalList = [30, 10, 20];
const sortedList = originalList.sort((a, b) => a - b);

console.log(originalList); // [10, 20, 30] - 原数组已被污染修改!
console.log(sortedList === originalList); // true - 指向同一个堆内存对象
工程隐患:在 React、Vue、Redux 等现代响应式前端框架中,直接原地修改组件的 Props 或 State 会导致浅层比对(Shallow Compare)失效,无法触发组件重新渲染,甚至在其他引用该数组的模块中引发难以排查的数据脏写。
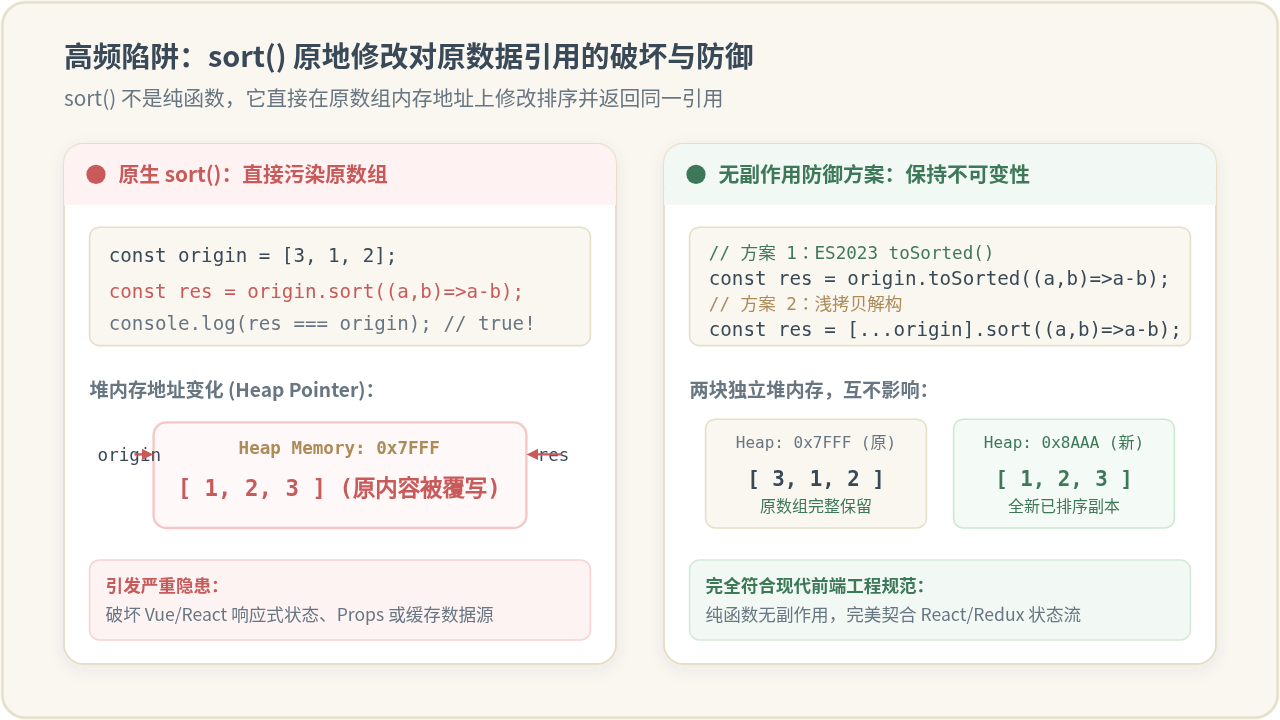
图 4:原生 sort() 原地修改对堆内存引用的破坏与无副作用纯函数方案对比
防御方案:
- 现代方案(ECMAScript 2023 / Node 20+):使用原生的不可变排序方法
arr.toSorted(),它会返回一个经过排序的全新数组实例,而不动原数组。// 现代浏览器及 Node.js 20+ const cleanList = [30, 10, 20]; const result = cleanList.toSorted((a, b) => a - b); console.log(cleanList); // [30, 10, 20] 原数据完好无损 console.log(result); // [10, 20, 30] 全新副本 - 向后兼容方案:在调用
sort()前先通过解构赋值[...arr]或arr.slice()生成浅拷贝。// 兼容所有环境的纯函数写法 const safeResult = [...originalList].sort((a, b) => a - b);
陷阱二:减法简写的边界崩塌 —— 缺失值与 NaN 陷阱
虽然 (a, b) => a - b 简洁直观,但在非严格类型数据中,如果数组包含 NaN、非法字符串或 null,减法操作可能返回 NaN:
const dirtyData = [10, NaN, 2, 5];
dirtyData.sort((a, b) => a - b);

console.log(dirtyData);
// 排序结果不可预测!可能为 [10, NaN, 2, 5] 或 [NaN, 10, 2, 5]
依据 IEEE 754 浮点数标准,任何数值与 NaN 进行算术运算均返回 NaN。当比较函数返回 NaN 时,底层排序算法(V8 引擎使用的 Timsort)无法建立有效的全序关系(Strict Weak Ordering),导致二分插入或归并步骤错乱,数组排序失效。
防御方案:在存在未知脏数据时,先通过过滤器清洗数据,或在比较函数内部显式处理非数情况:
// 健壮比较函数:将 NaN/非数统一移动到数组末端
function safeNumericSort(a, b) {
  const isANaN = Number.isNaN(a);
  const isBNaN = Number.isNaN(b);

  if (isANaN && isBNaN) return 0;
  if (isANaN) return 1; // a 为非数,后移
  if (isBNaN) return -1; // b 为非数,a 前移

  return a < b ? -1 : (a > b ? 1 : 0);
}
陷阱三:稀疏数组与 undefined 处理规则
在 JavaScript 中,undefined 和稀疏数组中的空位(Hole)有其特有的排序规则:它们永远会被放置在排序后数组的最末端,且不会被传递给自定义的 compareFunction:
const sparse = [10, undefined, 5, , 2];
sparse.sort((a, b) => {
  console.log(`比对: ${a} 与 ${b}`);
  return a - b;
});

console.log(sparse);
// 输出:[2, 5, 10, undefined, 空位]
// 注意:undefined 和空位完全没有触发 console.log
了解这一特性有助于在处理分页数据或空行数据时,预判末尾元素的出现,避免误以为比较函数拦截了所有项。
陷阱四:混合 BigInt 导致的 TypeError
当数组中混杂了常规 Number 与 BigInt 时,使用减法 a - b 会直接抛出运行时异常:TypeError: Cannot mix BigInt and other types。针对这种特殊场景,不可采用减法运算,而应使用显式的大于/小于三元运算符进行比对:
const mixed = [20n, 5, 100n, 1];

// 错误写法:mixed.sort((a, b) => a - b); // 抛出 TypeError

// 正确写法:使用逻辑运算符直接比对(JS 允许跨 Number 与 BigInt 进行比较)
mixed.sort((a, b) => (a < b ? -1 : a > b ? 1 : 0));
console.log(mixed); // [1, 5, 20n, 100n]
四、全场景最佳实践速查
在不同场景下,推荐选择的数字排序模式总结如下:
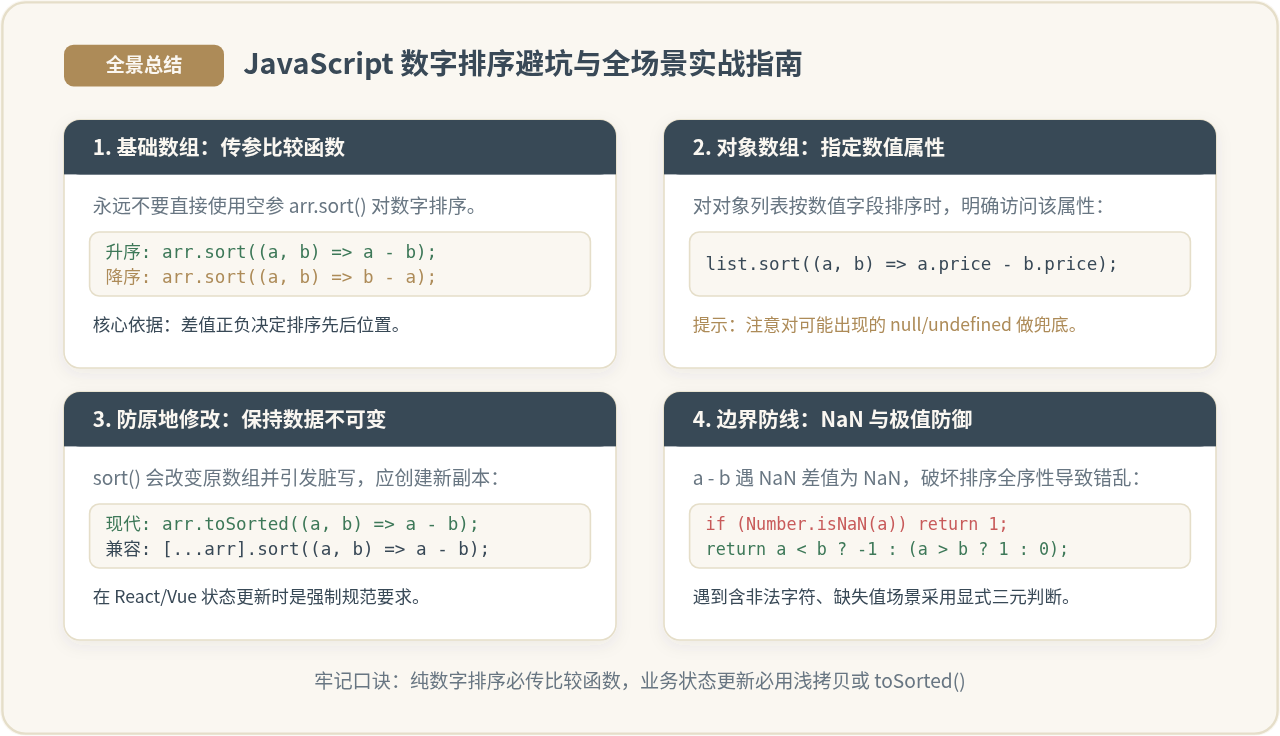
图 5:JavaScript 数字排序避坑与全场景最佳实践全景指南
核心记忆口诀:
- 数字排序莫空参:纯数字无论如何都不要调用无参
sort(),缺省的字符串字典序是导致“10 小于 2”的元凶。 - 升序 a 减 b,降序 b 减 a:记住减法正负号与位置变动的对应关系。
- 业务优先 toSorted:在涉足组件状态、Pinia/Vuex、Redux 的场景中,务必使用
toSorted()或浅拷贝[...arr].sort()保证原数组不变。 - 脏数据防 NaN:外部输入源可能含空值或非法数字时,优先做清洗或显式三元条件判断。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章