

深入解析在前端 JavaScript 环境中如何使用 FileReader 将本地文件完整读取为 ArrayBuffer 二进制数据,涵盖核心概念流转、事件生命周期、Promise 封装、Uint8Array 与 DataView 视图解析实战及大文件切片优化。
JS读取文件为二进制数据:FileReader与ArrayBuffer实战
作者:像素漫游
时间:2026-11-22
浏览:647
文章目录
在浏览器中处理本地文件上传、图片真实格式嗅探、音频采样分析、密码学 Hash 计算或 WebGL 资源载入时,将文件作为纯文本(UTF-8)或 Base64 编码读取往往无法满足性能与精确字节控制的需求。本文将直接演示如何通过
FileReader.readAsArrayBuffer() 将用户选择的文件转化为原始二进制内存缓冲区(ArrayBuffer),并结合 Uint8Array 与 DataView 对底层字节进行精确的读取与结构化解析。
一、核心概念:从 File 到 ArrayBuffer 的底层脉络
在 JavaScript 中,“文件”与“可以操作的内存”属于两个完全不同的层级。初学者常常混淆 File、FileReader 和 ArrayBuffer 之间的职责分工。要准确读写二进制数据,首先需要理清它们在浏览器运行时中的位置。
1. File 与 Blob(只读资源句柄):当用户通过 <input type="file">、拖拽或者剪贴板选中一个文件时,页面获得的是一个 File 对象(继承自 Blob)。这个对象仅仅是底层操作系统文件的一个引用指针,包含文件名、大小和声明的 MIME 类型,但它本身并不直接把文件数据全部加载进 JavaScript 引擎内存。这样设计的目的是避免因用户选中几个 GB 的文件而瞬间导致浏览器标签页崩溃。
2. FileReader(异步读取管道):由于文件读取涉及物理磁盘或系统 IO 操作,主线程绝不能同步等待。FileReader 就是浏览器提供的异步搬运工,专门负责把 File 或 Blob 指向的物理磁盘数据按指定格式读入 JavaScript 运行环境。
3. ArrayBuffer(固定长度的原始内存缓冲区):调用 FileReader.readAsArrayBuffer(file) 成功后,得到的结果是一个 ArrayBuffer 对象。它是在内存中开辟的一段固定长度、连续的通用原始二进制数据块。但核心要点在于:ArrayBuffer 本身没有任何格式语义,也不提供直接读取或写入单个数字的方法。如果你尝试使用 buffer[0] 读取它,只会得到 undefined。
4. TypedArray 与 DataView(透视镜与操作视图):为了读写 ArrayBuffer 中的字节,必须在它之上套一层“视图”(View)。JavaScript 提供了两种视图机制:
- TypedArray(类型化数组):如
Uint8Array、Int16Array、Float32Array。它们将整段内存切分为同等大小的单元,允许像普通数组一样用[index]访问,执行速度极快,适合大批量连续字节处理(如图像像素遍历、校验和计算)。 - DataView:专为处理异构复杂二进制协议设计。它允许在任意字节偏移位置读取不同类型的数据(如偏移 0 读一个 16 位整数,偏移 2 读一个 32 位浮点数),并允许明确指定大端序(Big-Endian)或小端序(Little-Endian)。
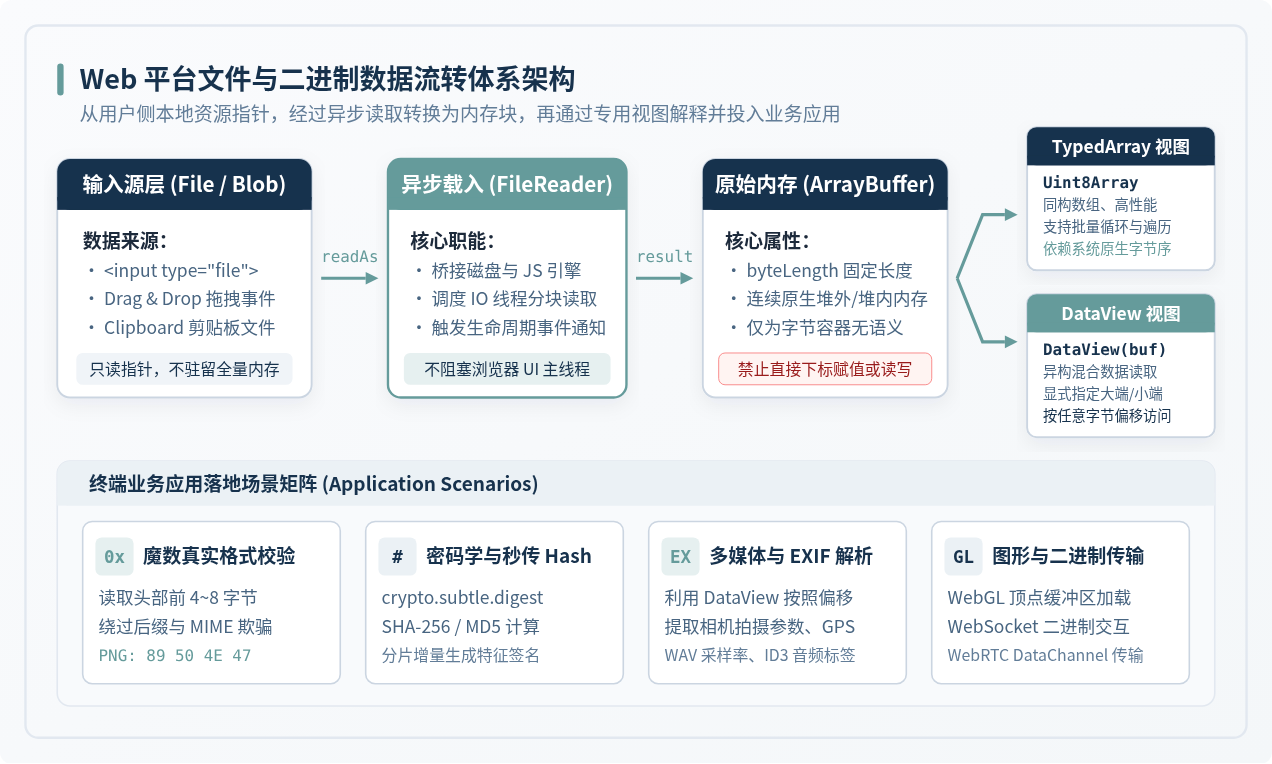
图 1:Web 平台本地文件到二进制底层数据的架构与流转体系
二、基础实战:使用 FileReader 读取文件的完整流程
理解了核心概念后,我们从最经典的 FileReader 事件流开始。在实际业务中,我们首先需要在页面中放置一个文件选择框,监听其 change 事件获取 File 实例,然后创建 FileReader 进行读取。
1. 完整标准代码示例
// 1. 获取 DOM 中的 input 元素
const fileInput = document.querySelector('#fileInput');

fileInput.addEventListener('change', (event) => {
  const file = event.target.files[0];
  if (!file) {
    console.warn('用户未选择任何文件');
    return;
  }

  console.log(`[准备读取] 文件名: ${file.name}, 大小: ${file.size} 字节`);

  // 2. 实例化 FileReader
  const reader = new FileReader();

  // 3. 注册事件监听:必须在调用读取方法前挂载
  reader.onloadstart = (e) => {
    console.log('[状态] 开始读取 (onloadstart)');
  };

  reader.onprogress = (e) => {
    if (e.lengthComputable) {
      const percent = ((e.loaded / e.total) * 100).toFixed(2);
      console.log(`[进度] 已读取 ${e.loaded} / ${e.total} 字节 (${percent}%)`);
    }
  };

  reader.onload = (e) => {
    // 读取成功完成:此时 result 属性中承载 ArrayBuffer
    const arrayBuffer = reader.result;
    console.log('[成功] 读取完成,获得 ArrayBuffer:', arrayBuffer);
    console.log(`[检查] 内存字节长度 (byteLength): ${arrayBuffer.byteLength}`);

    // 4. 将 ArrayBuffer 交付给类型化视图进行检查
    const uint8View = new Uint8Array(arrayBuffer);
    console.log('前 4 个字节的十进制值:', uint8View.slice(0, 4));
  };

  reader.onerror = (e) => {
    console.error('[异常] 文件读取发生错误:', reader.error);
  };

  reader.onloadend = (e) => {
    console.log('[结束] 读取周期结束 (onloadend)');
  };

  // 5. 触发二进制异步读取
  reader.readAsArrayBuffer(file);
});
2. 运行过程与状态机细节
FileReader 内部拥有一个标准的状态机属性 readyState:
EMPTY (0):刚创建实例,尚未调用任何读取方法;LOADING (1):数据正在从磁盘载入内存中,此时会周期性触发onprogress;DONE (2):整个读取操作已经完成(无论成功还是失败)。成功时reader.result挂载数据,失败时reader.error包含具体的DOMException。
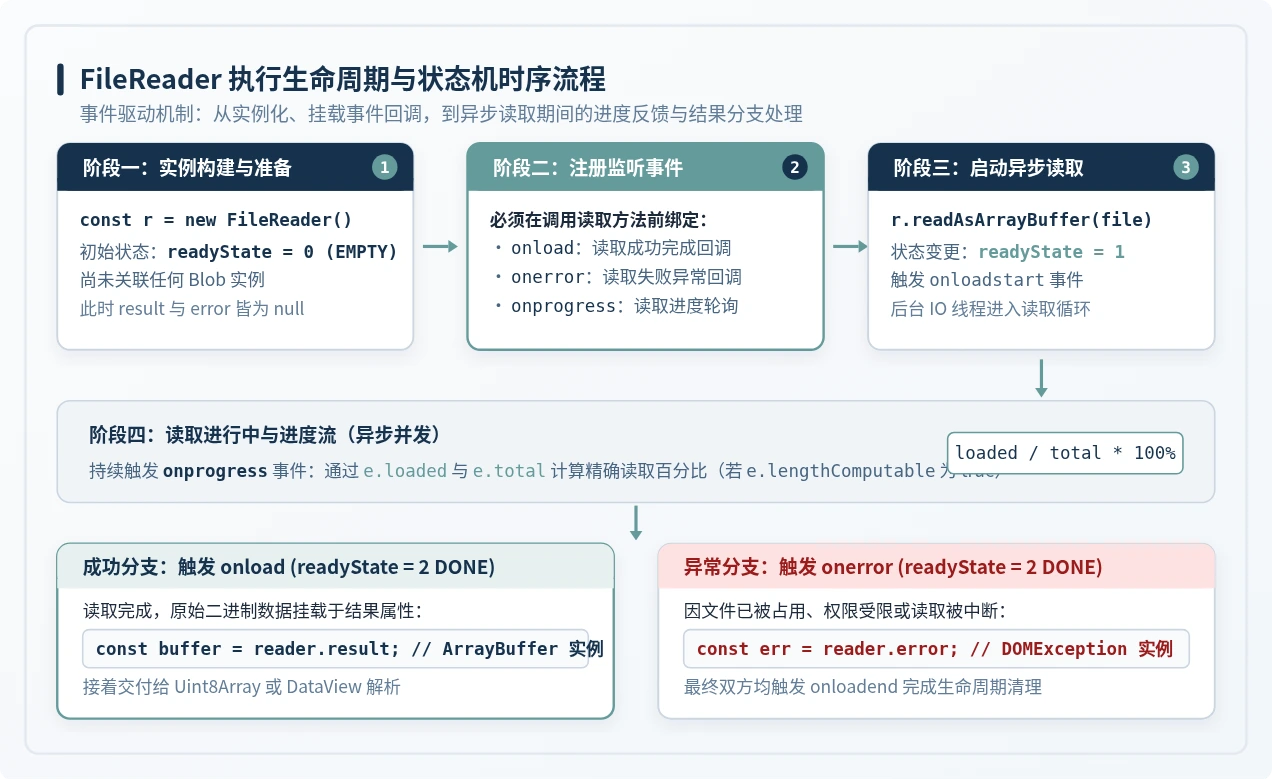
图 2:FileReader 异步执行生命周期与事件流转时序
⚠️ 踩坑提示:事件绑定的时机
务必在调用 reader.readAsArrayBuffer(file) 之前注册好 onload 和 onerror 事件。如果在调用启动方法之后才绑定,面对小体积文件时,浏览器底层可能在微任务/事件队列中极速完成读取,从而导致回调函数错过触发时机。
三、现代异步改造:将 FileReader 封装为 Promise 与 async/await
在现代前端工程(Vue、React 或纯 TypeScript 模块)中,嵌套的回调函数会导致代码难以组织,也无法直接与 async/await 流程控制配合。最标准、健壮的做法是将 FileReader 包装为一个返回 Promise<ArrayBuffer> 的独立函数。
/**
 * 将 File / Blob 异步读取为 ArrayBuffer
 * @param {Blob} blob - 目标文件或 Blob 切片
 * @param {(loaded: number, total: number) => void} [onProgress] - 可选的进度回调
 * @returns {Promise}
 */
function readFileAsArrayBuffer(blob, onProgress) {
  return new Promise((resolve, reject) => {
    if (!(blob instanceof Blob)) {
      reject(new TypeError('参数必须是 File 或 Blob 实例'));
      return;
    }

    const reader = new FileReader();

    reader.onload = () => {
      resolve(reader.result);
    };

    reader.onerror = () => {
      reject(reader.error || new Error('文件读取失败'));
    };

    if (typeof onProgress === 'function') {
      reader.onprogress = (e) => {
        if (e.lengthComputable) {
          onProgress(e.loaded, e.total);
        }
      };
    }

    reader.readAsArrayBuffer(blob);
  });
}

// 业务中的实际使用方式:搭配 async/await
async function handleFileProcess(file) {
  try {
    console.log('正在解析文件...');
    const buffer = await readFileAsArrayBuffer(file, (loaded, total) => {
      const percent = Math.round((loaded / total) * 100);
      console.log(`加载进度: ${percent}%`);
    });

    console.log('成功获取 ArrayBuffer,总字节数:', buffer.byteLength);
    // 后续业务处理...
  } catch (err) {
    console.error('读取中断或异常:', err.message);
  }
}
四、深入二进制解析:使用 Uint8Array 与 DataView 操作字节
将文件读为 ArrayBuffer 只是第一步,真正的业务价值在于解释这些原始字节。下面通过两个高频的生产场景,展示 Uint8Array 与 DataView 的实际用法。
场景 1:文件魔数(Magic Number)嗅探真实文件类型
在 Web 安全与文件上传场景中,仅仅依赖 file.name 的扩展名(如 .png)或者 file.type 是非常脆弱的,因为黑客只需修改文件后缀名或在请求中伪造 MIME 字段即可绕过检查。
真正的文件类型由文件头部的特定字节标识,也就是魔数(Magic Bytes)。例如:
- PNG:头部前 8 字节恒定为
[0x89, 0x50, 0x4E, 0x47, 0x0D, 0x0A, 0x1A, 0x0A]; - JPEG / JPG:头部前 3 字节恒定为
[0xFF, 0xD8, 0xFF]; - PDF:头部前 4 字节为
[0x25, 0x50, 0x44, 0x46](即 ASCII 字符%PDF); - GIF:头部前 4 字节为
[0x47, 0x49, 0x46, 0x38](即 ASCII 字符GIF8)。
/**
 * 校验文件真实类型
 * @param {ArrayBuffer} buffer
 * @returns {string} 真实检测出的类型或 'unknown'
 */
function detectMimeTypeFromBuffer(buffer) {
  // 创建 Uint8Array 逐字节视图
  const bytes = new Uint8Array(buffer);

  // 辅助函数:将字节转换为大写十六进制字符串
  const getHexHeader = (length) => {
    return Array.from(bytes.slice(0, length))
      .map(b => b.toString(16).padStart(2, '0').toUpperCase())
      .join(' ');
  };

  console.log('文件头部前 8 字节 (十六进制):', getHexHeader(8));

  // 1. 检查 PNG: 89 50 4E 47 0D 0A 1A 0A
  if (bytes[0] === 0x89 && bytes[1] === 0x50 && bytes[2] === 0x4E && bytes[3] === 0x47 &&
      bytes[4] === 0x0D && bytes[5] === 0x0A && bytes[6] === 0x1A && bytes[7] === 0x0A) {
    return 'image/png';
  }

  // 2. 检查 JPEG: FF D8 FF
  if (bytes[0] === 0xFF && bytes[1] === 0xD8 && bytes[2] === 0xFF) {
    return 'image/jpeg';
  }

  // 3. 检查 PDF: 25 50 44 46 (%PDF)
  if (bytes[0] === 0x25 && bytes[1] === 0x50 && bytes[2] === 0x44 && bytes[3] === 0x46) {
    return 'application/pdf';
  }

  // 4. 检查 GIF: 47 49 46 38 (GIF8)
  if (bytes[0] === 0x47 && bytes[1] === 0x49 && bytes[2] === 0x46 && bytes[3] === 0x38) {
    return 'image/gif';
  }

  return 'unknown';
}
场景 2:数据结构解析与字节序(Endianness)处理
当读取单字节数据(如 8 位无符号整数)时,不存在字节顺序的问题。但如果要读取 16 位整型(2 字节)、32 位整型(4 字节)或浮点数时,不同的体系结构在内存中存储高低字节的顺序会有所不同:
- 大端序(Big-Endian):高位字节存放在低地址(在内存最前),符合网络传输协议规范(RFC 标准网络字节序)以及很多图像格式(如 PNG 块长度);
- 小端序(Little-Endian):低位字节存放在低地址,大多数现代桌面 x86/x64 与 ARM 芯片原生采用小端序。
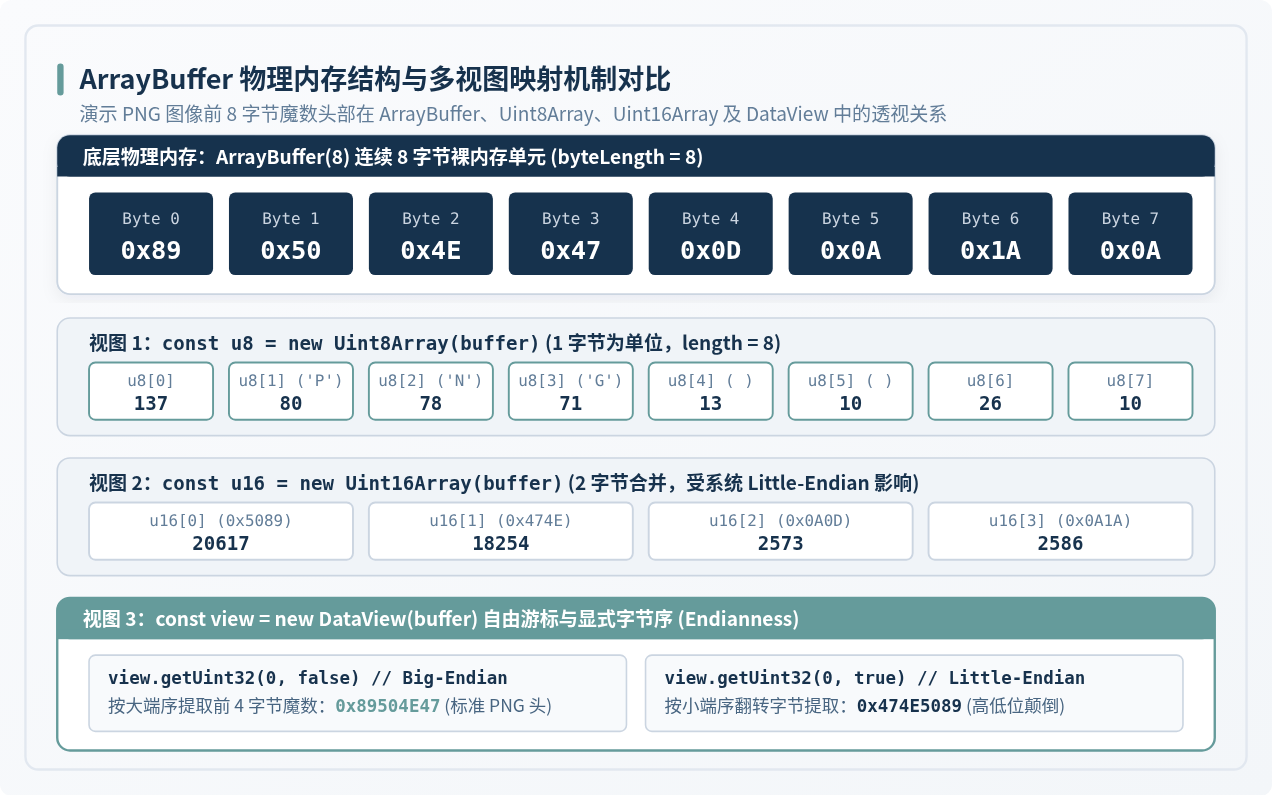
图 3:ArrayBuffer 底层内存与不同视图(Uint8Array、Uint16Array、DataView)的映射对比
TypedArray(例如 new Uint16Array(buffer))永远采用运行环境当前的系统原生字节序,这可能在不同终端之间导致数据不一致。而 DataView 提供了精确的显式控制参数 littleEndian:
// 假设已有包含二进制头部数据的 ArrayBuffer
const view = new DataView(buffer);

// 1. 读取单字节 (无需考虑字节序)
const headerFlag = view.getUint8(0);

// 2. 以大端序读取偏移 4 处的 32 位无符号整数 (如 PNG Chunk 的数据体长度)
const chunkLengthBigEndian = view.getUint32(4, false); // 第二个参数 false 代表大端序

// 3. 以小端序读取偏移 8 处的 16 位整数 (如 WAV 音频文件的声道数量)
const channelsLittleEndian = view.getUint16(8, true);  // 第二个参数 true 代表小端序

console.log(`解析结果: 标识=${headerFlag}, 块长度=${chunkLengthBigEndian}, 声道=${channelsLittleEndian}`);
五、大文件与性能优化:分片读取与现代替代方案
在实际工程中,如果用户上传了一个 2GB 的高清视频或者大型归档压缩包,直接使用 reader.readAsArrayBuffer(file) 会尝试在 JavaScript 堆中一口气分配 2GB 的连续内存。这极易触发浏览器的内存上限,导致页面崩溃卡死。
1. 结合 Blob.slice() 实现分片按需读取
File 对象本身继承了 Blob.prototype.slice(start, end) 方法。利用它,我们可以在不加载全量文件的前提下,直接切出我们需要的一小段进行读取:
// 仅读取大文件的前 64 字节,用于魔数嗅探或格式分析,耗时 < 2ms,内存接近 0 占用
async function inspectFileHeaderOnly(largeFile) {
  // 1. 逻辑切片:瞬间完成,不触发底层磁盘 IO
  const headerBlob = largeFile.slice(0, 64);

  // 2. 仅把这 64 字节读入 ArrayBuffer
  const buffer = await readFileAsArrayBuffer(headerBlob);

  const u8 = new Uint8Array(buffer);
  console.log('大文件头部字节样本:', u8);
  return detectMimeTypeFromBuffer(buffer);
}

// 分块流式遍历读取大文件 (例如增量计算哈希校验和)
async function processLargeFileInChunks(file, chunkSize = 2 * 1024 * 1024) {
  let offset = 0;
  let chunkIndex = 0;

  while (offset < file.size) {
    const chunkBlob = file.slice(offset, offset + chunkSize);
    const chunkBuffer = await readFileAsArrayBuffer(chunkBlob);

    // 在此处理当前 2MB 分片的数据,处理完毕后垃圾回收器可立刻释放内存
    console.log(`正在处理第 ${chunkIndex} 个分片 (大小: ${chunkBuffer.byteLength} 字节)`);

    offset += chunkSize;
    chunkIndex++;
  }
  console.log('所有分片串行处理完成');
}
2. 现代化替代方案:File.prototype.arrayBuffer()
在现代主流浏览器中,Blob / File 原生提供了 arrayBuffer() 实例方法。它直接返回一个 Promise<ArrayBuffer>,省去了手动创建 FileReader 的所有样板代码:
// 现代浏览器原生语法:一行代码直接获取 ArrayBuffer
async function modernRead(file) {
  // 直接调用 file.arrayBuffer()
  const buffer = await file.arrayBuffer();
  console.log('极简原生读取完成,字节数:', buffer.byteLength);
  return buffer;
}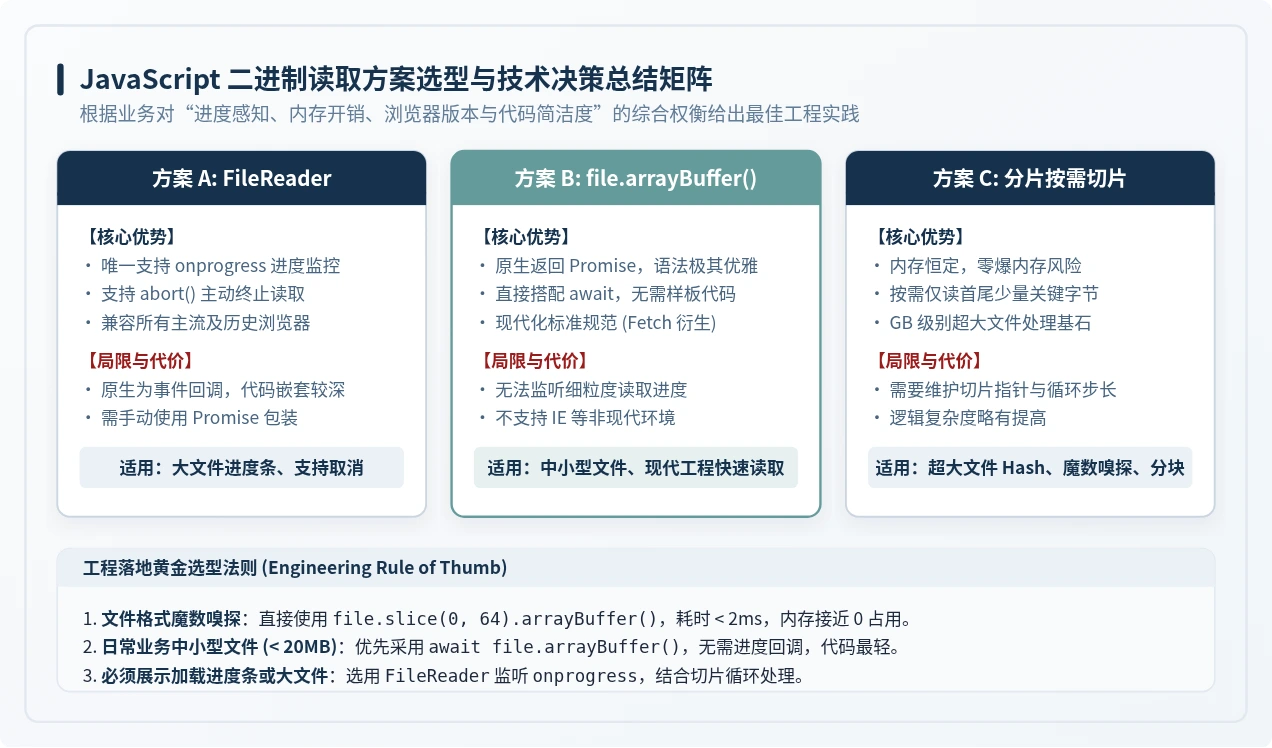
图 4:FileReader、原生 arrayBuffer() 与切片读取的技术选型决策矩阵
六、高频注意事项与避坑指南
在实际编写涉及二进制与内存操作的代码时,有三个最容易引发静默错误或性能瓶颈的地方值得特别注意:
1. 内存共享与联动效应:当你在同一个 ArrayBuffer 上创建了多个视图(如一个 Uint8Array 和一个 DataView)时,它们指向的是完全相同的物理内存空间。通过 uint8Array[0] = 255 修改某个字节后,通过 dataView.getUint8(0) 读取会立刻看到改变。只有使用 buffer.slice() 时才会产生独立的深拷贝内存。
2. Transferable Objects 与 Detached Buffer(分离的缓冲区):如果你通过 window.postMessage 或 worker.postMessage(buffer, [buffer]) 将 ArrayBuffer 作为可转移对象(Transferable)移交给 Web Worker 时,底层内存的所有权会被彻底转移。此时在主线程中,原 buffer.byteLength 会瞬间变为 0(变为 Detached 状态),再次对其做任何视图操作都会抛出运行时异常。
3. 将 ArrayBuffer 还原为可预览的 Blob 或 URL:如果需要把修改后的二进制数据(比如加密后的图片或重新拼装的文件)重新转换为浏览器可展示的图片或下载链接,只需将其传入 Blob 构造函数:
// 将处理后的 ArrayBuffer 还原为 Blob
const outputBlob = new Blob([buffer], { type: 'image/png' });

// 生成临时预览 URL
const previewUrl = URL.createObjectURL(outputBlob);
console.log('可供 <img src> 使用的 URL:', previewUrl);

// 记得在图片展示完毕或组件卸载时释放内存
// URL.revokeObjectURL(previewUrl);
掌握了 FileReader 的事件流程、ArrayBuffer 的内存模型,以及结合 Uint8Array 与 DataView 的多维度视图透视方法,你便拥有了在浏览器端直接处理任意复杂底层二进制文件的能力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章