

深入解析如何在 JavaScript 中使用原生 URLSearchParams 接口获取页面查询参数。包含单值读取、同名多值数组提取、Hash 路由兼容、特殊编码处理及常见排查自查清单。
JS使用URLSearchParams获取页面查询参数
作者:交互手记
时间:2026-11-21
浏览:176
文章目录
Web API
JavaScript 核心
适用环境:现代浏览器 / Node.js 10+
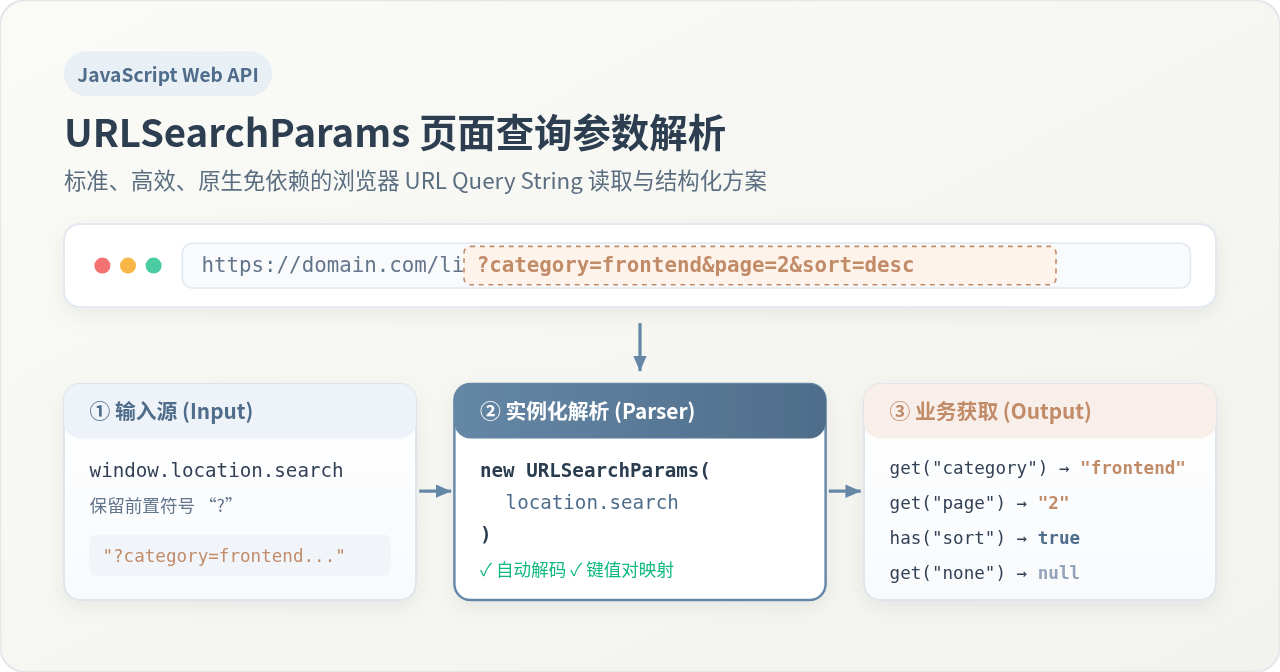
在现代 JavaScript 前端开发中,获取当前页面 URL 中的查询参数(Query String)最标准、直接的方式是调用原生 URLSearchParams 构造函数。通过传入 window.location.search,即可将浏览器地址栏形如 ?id=1024&type=article 的查询串解析为结构化对象,免去了传统字符串截取或正则表达式匹配的繁琐过程,并自带完备的字符解码与多值处理能力。
一、核心操作步骤与基础用法
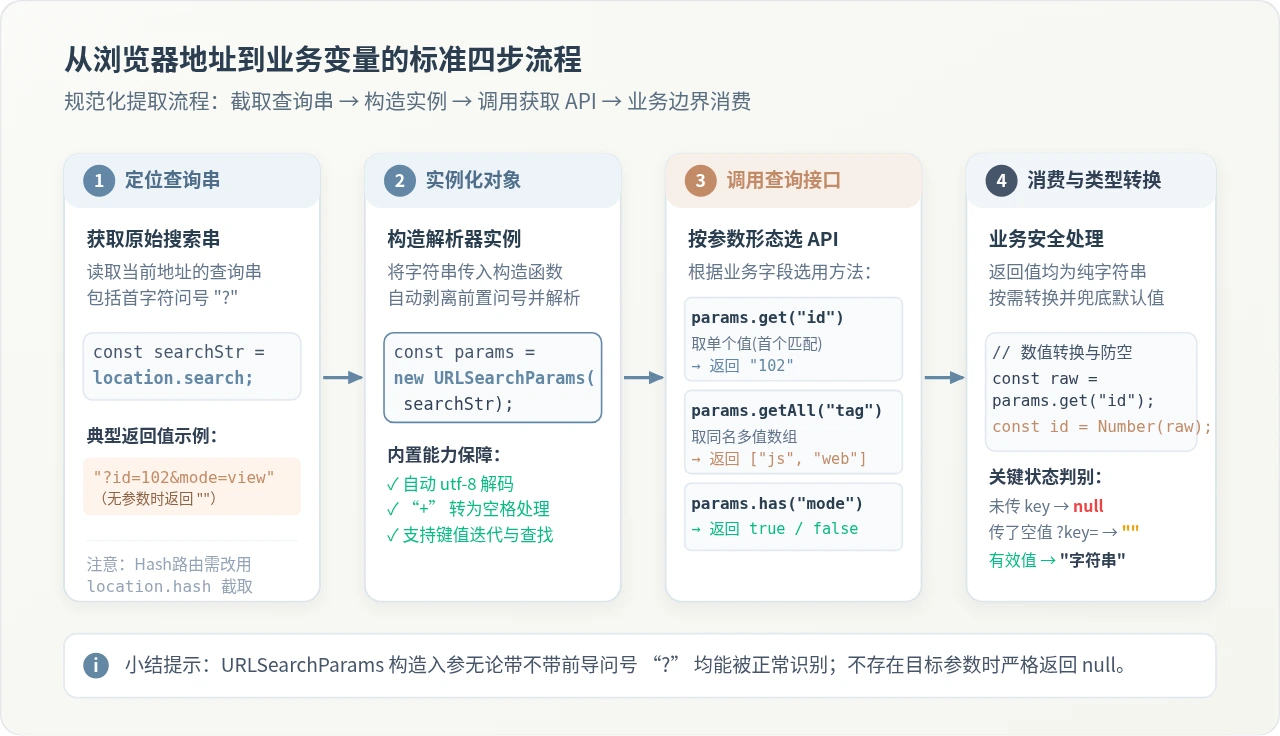
获取页面当前 URL 参数的整个流程可以收敛为简明的两步:首先读取当前窗口的查询字符串,随后交由 URLSearchParams 完成实例化并读取目标字段。
浏览器提供的 window.location.search 会返回包含前置问号 ? 的完整查询字符串(例如 ?keyword=javascript&page=1)。URLSearchParams 具有良好的容错设计,在传入带有前置 ? 的字符串时能够自动忽略该问号,无需开发者手动调用 substring(1) 或 slice(1)。
// 步骤一:获取当前页面的查询参数串
const searchString = window.location.search;

// 步骤二:实例化 URLSearchParams 解析器
const searchParams = new URLSearchParams(searchString);

// 步骤三:通过 get 方法读取具体的业务参数
const keyword = searchParams.get('keyword');
const page = searchParams.get('page');

console.log('搜索关键字:', keyword);
console.log('当前页码:', page);
示例输出(假设当前 URL 为 https://example.com/search?keyword=javascript&page=1)
搜索关键字: javascript当前页码: 1
如果只需要读取单个参数,也可以直接把调用写在一行内:new URLSearchParams(window.location.search).get('keyword')。在实际业务中,由于读取后往往需要进一步校验或转换类型,建议先将实例赋给局部变量。
二、常用查询方法与数据形态适配
在实际业务场景中,查询参数并不总是简单的“单键单值”。可能存在键名不存在、键名存在但值为空、或者多个参数同名(如复选框数组传参)的情况。针对不同的数据形态,URLSearchParams 提供了成套的方法。
1. 读取单值:get(name)
get(name) 是最常用的读取方法。它接收一个参数名,返回该参数对应的值(字符串格式)。
- 正常命中:返回对应的字符串值,如
"1"。 - 参数不存在:若 URL 中根本没有该键名,方法返回
null。 - 参数存在但值为空:例如 URL 为
?keyword=,此时该键名确实声明了,方法返回空字符串"",而不是null。 - 同名参数重复出现:如果 URL 中包含
?tag=html&tag=css,调用get('tag')只会返回第一个匹配项(即"html")。
2. 检查参数是否存在:has(name)
在执行过滤或条件分支前,若仅需确定 URL 是否携带了某个标志参数(无论是否有值),可以使用 has(name) 方法。该方法返回布尔值 true 或 false。
const params = new URLSearchParams(window.location.search);

if (params.has('debug')) {
  console.log('调试模式已启用');
}
3. 处理同名多值参数:getAll(name)
Web 应用在提交多选列表、筛选标签或批量 ID 时,常见做法是在 Query 中复用同一参数名,例如:?category=frontend&tag=javascript&tag=react&tag=node。
如果此时依然调用 get('tag'),将只能得到第一个标签 "javascript",其余标签会被直接丢弃。针对此类参数,应使用 getAll(name) 方法:
// 当前 URL: https://example.com/articles?tag=javascript&tag=react&tag=node
const params = new URLSearchParams(window.location.search);

const tags = params.getAll('tag');
console.log('已选标签列表:', tags);

// 若查询一个不存在的参数名
const nonExistent = params.getAll('author');
console.log('不存在的参数:', nonExistent);
示例输出
已选标签列表: ["javascript", "react", "node"]不存在的参数: []
注意返回值差异
当查询的参数不存在时,get() 返回 null,而 getAll() 返回一个空数组 []。在编写防御性代码时请特别留意该区别。
4. 遍历所有参数与转换为普通对象
URLSearchParams 实现了可迭代协议(Iterable),支持通过 for...of 直接遍历,或使用 forEach 遍历键值。若需要将全部参数序列化为普通 JavaScript 对象供外部使用,可直接配合 Object.fromEntries():
const params = new URLSearchParams(window.location.search);

// 方式 A:使用 for...of 遍历所有键值对
for (const [key, value] of params.entries()) {
  console.log(`${key} = ${value}`);
}

// 方式 B:一次性转换为标准 Key-Value Plain Object
const paramsObject = Object.fromEntries(params.entries());
console.log('参数对象:', paramsObject);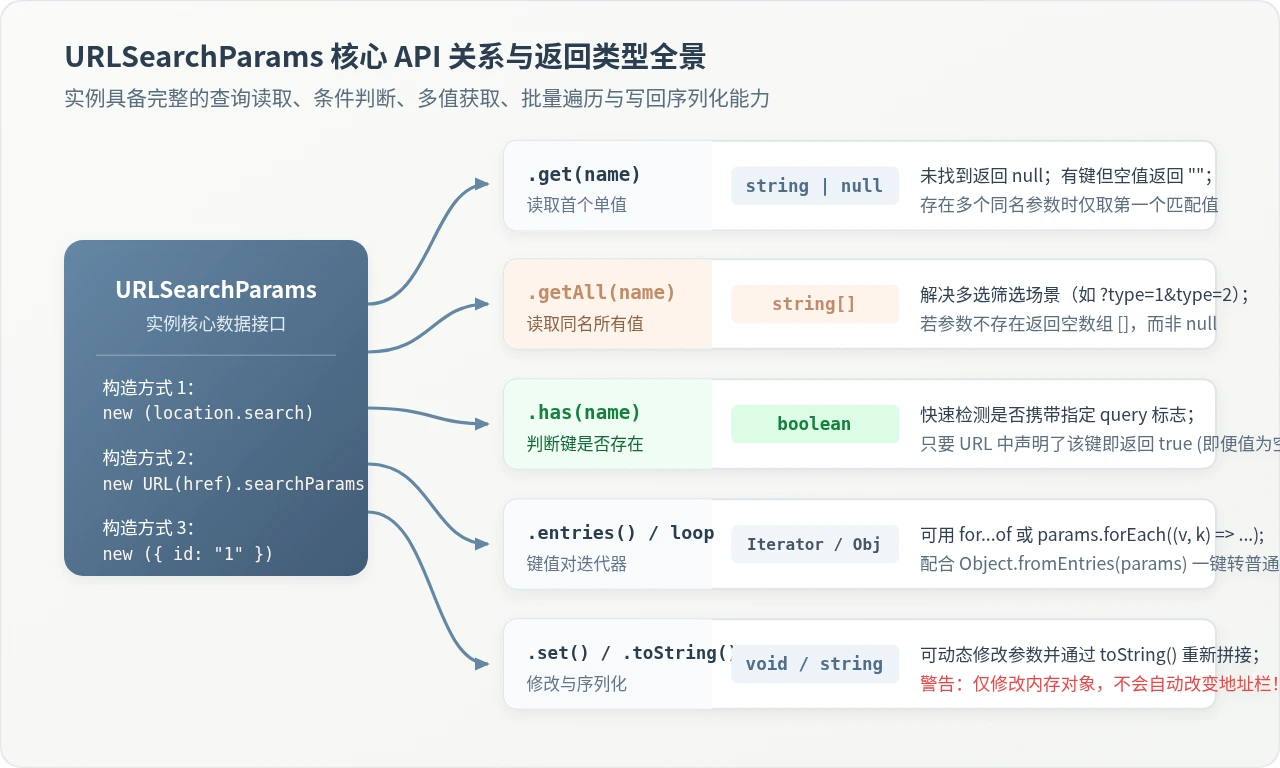
三、常见边界场景与特殊路由处理
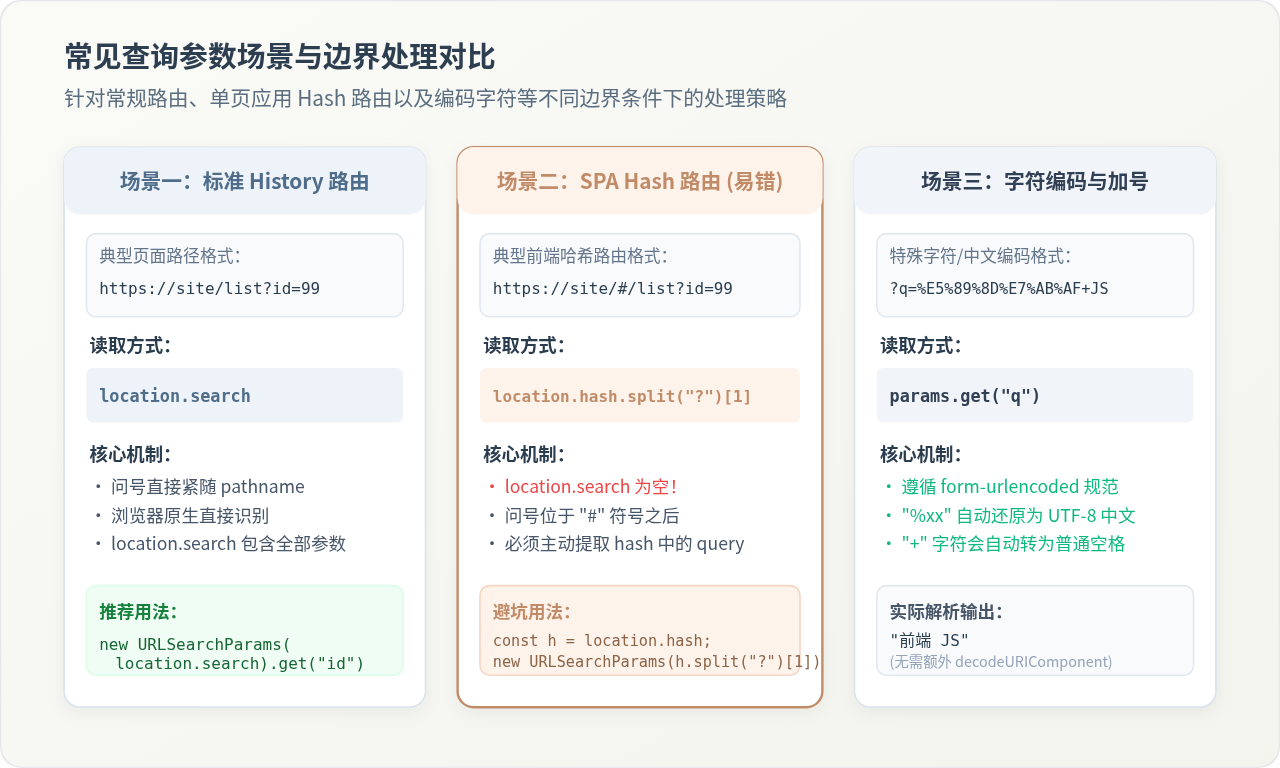
在实际工程开发中,页面的 URL 结构往往不仅包含传统的查询串,还可能结合单页应用(SPA)前端路由以及各类 URL 特殊转义字符。直接盲目读取 window.location.search 可能会出现“参数明明在地址栏但就是读不到”的现象。
1. SPA 单页应用的 Hash 路由陷阱
使用 Hash 路由(如早期的 Vue Router 或某些后台管理系统)时,URL 形如:
https://example.com/#/dashboard?userId=9527&tab=security
在浏览器的原生解析规则中,井号 # 之后的所有内容统一归属于 window.location.hash。此时,问号出现在 # 的后方,导致浏览器判断 window.location.search 为空字符串。
如果直接执行 new URLSearchParams(window.location.search),得到的将是一个空的参数集合。对于 Hash 路由,需要先从 location.hash 中截取出问号之后的内容:
// 适配 Hash 路由的查询串截取方案
function getHashSearchParams() {
  const hash = window.location.hash;
  const questionMarkIndex = hash.indexOf('?');
  if (questionMarkIndex === -1) {
    return new URLSearchParams();
  }
  const queryString = hash.slice(questionMarkIndex);
  return new URLSearchParams(queryString);
}

// 使用方式
const hashParams = getHashSearchParams();
console.log('用户ID:', hashParams.get('userId')); // "9527"
2. 原生 URL 对象自带的 url.searchParams
若已知一个完整的 URL 字符串(例如从接口返回、或来自链接属性 a.href),不需要先自己手动分割 ?,现代浏览器提供的 URL 构造函数自身就挂载了现成的 searchParams 属性:
const targetUrl = new URL('https://example.com/goods?sku=A88&count=3');
// 直接读取 searchParams
const sku = targetUrl.searchParams.get('sku');
console.log('商品SKU:', sku); // "A88"
3. 字符编码与“+”号的特殊规则
URLSearchParams 遵循 application/x-www-form-urlencoded 编码格式。这一标准有两个重要特征:
- 自动 UTF-8 解码:对于中文或特殊字符(如
?name=%E5%BC%A0%E4%B8%89),get('name')会自动将其解码为"张三",开发者无需再手动套一层decodeURIComponent()。 - 加号
+会被自动转换为空格:在表单查询串规范中,+常被用作空格替代符。因此,若地址栏出现?query=vue+react,使用params.get('query')得到的是"vue react"。如果参数原本就需要表达真实的加号符号+,在源头生成 URL 时必须通过%2B进行编码。
四、结果验证与排查指南
在实际操作中,若出现获取到的参数为 null 或与预期不符,可按照以下排查顺序逐级核对:
| 现象 | 根本原因 | 解决办法 |
|---|---|---|
地址栏有参数,但 get() 恒为 null |
单页应用使用了 Hash 路由(# 在 ? 前面),导致 location.search 为空字符串。 |
使用 location.hash.split('?')[1] 提取查询部分后再实例化。 |
| 参数名拼写看似一致,但无法获取 | 参数名称严格区分大小写(例如 ?userId=1 与 get('userid'))。 |
核对参数大小写,或遍历 keys 进行小写匹配。 |
| 同名多参数只拿到了第一个 | 使用了 get() 而非 getAll()。 |
改用 params.getAll('key') 获取完整的字符串数组。 |
| 需要的是数字类型,但参与计算时发生了字符串拼接 | URLSearchParams 提取的所有结果均是原始 string。 |
使用 Number(val) 或 parseInt(val, 10) 进行显式类型转换。 |
修改了 params.set() 但地址栏没有刷新 |
URLSearchParams 仅修改了内存中解析出的实例。 |
需调用 history.pushState() 或 window.location.search = params.toString()。 |
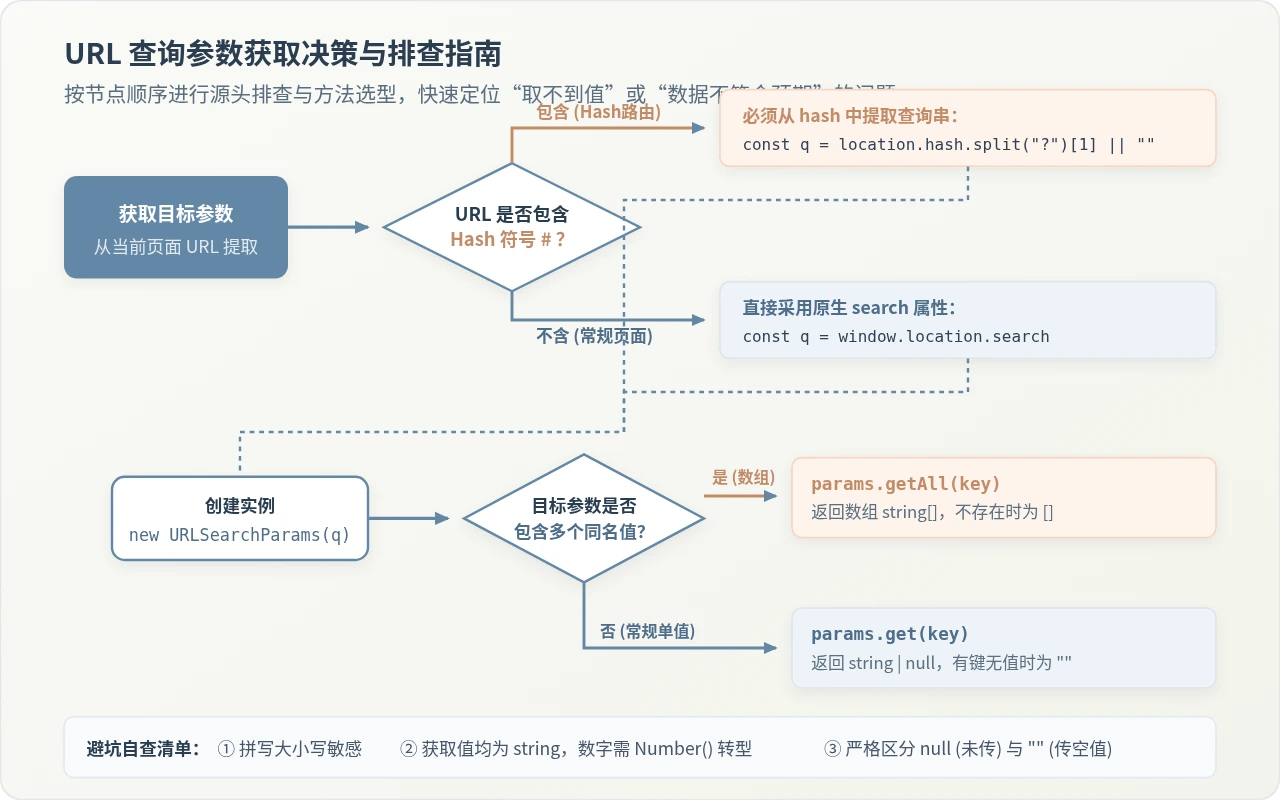
五、通用工程化工具函数实现
综合上述关于常规路由、Hash 路由与异常情况的处理逻辑,在实际工程项目中,可以封装一个通用的页面查询参数提取工具函数:
/**
 * 通用安全获取页面 URL 查询参数函数
 * 兼容标准路由 (search) 与单页 Hash 路由 (#/path?query)
 *
 * @param {string} paramName - 需要获取的参数键名
 * @param {string} [customUrl] - 可选的自定义完整 URL,默认取当前页面 location.href
 * @returns {string | null} 对应的参数值,不存在时返回 null
 */
function getUrlQuery(paramName, customUrl) {
  if (!paramName || typeof paramName !== 'string') {
    return null;
  }

  const rawHref = customUrl || window.location.href;
  const urlObj = new URL(rawHref, window.location.origin);

  // 优先从原生 searchParams 中检索
  let val = urlObj.searchParams.get(paramName);
  if (val !== null) {
    return val;
  }

  // 若未检索到,回退检查 Hash 中是否存在独立 query
  const hashStr = urlObj.hash;
  const hashQIndex = hashStr.indexOf('?');
  if (hashQIndex !== -1) {
    const hashParams = new URLSearchParams(hashStr.slice(hashQIndex));
    return hashParams.get(paramName);
  }

  return null;
}

// 示例运行与验证
console.log('常规测试:', getUrlQuery('token', 'https://a.com/?token=xyz'));
console.log('Hash测试:', getUrlQuery('view', 'https://a.com/#/detail?view=grid'));
console.log('缺失测试:', getUrlQuery('none', 'https://a.com/?token=xyz'));
示例输出
常规测试: xyzHash测试: grid
缺失测试: null
通过该工具函数,能够在各类复杂的页面环境和前端路由架构下稳定获取目标查询参数,同时保持代码简洁、高可维护性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章