

深入分析 JavaScript 代码混淆的实现原理、防护边界与核心局限性。结合 AST 语法树变换、逆向实操推导与全链路安全架构,解答 JS 混淆能否真正保护前端代码安全的疑问。
JS混淆真的能保护前端代码安全吗?局限性分析
作者:缓存笔记
时间:2026-11-19
浏览:479
文章目录
前端架构与安全
技术纵深分析
阅读时长:约 10 分钟
核心结论先行:JS 混淆无法从根本上保护前端代码的安全。混淆的本质是提高代码被人工阅读和逆向分析的“时间成本与技术门槛”,但它既不能提供真正的保密性,也无法提供防篡改能力。前端代码运行在用户完全控制的浏览器环境中,任何试图在客户端隐藏商业机密、私有密钥或寄希望于纯前端校验逻辑的做法,在有针对性的逆向面前都将失效。
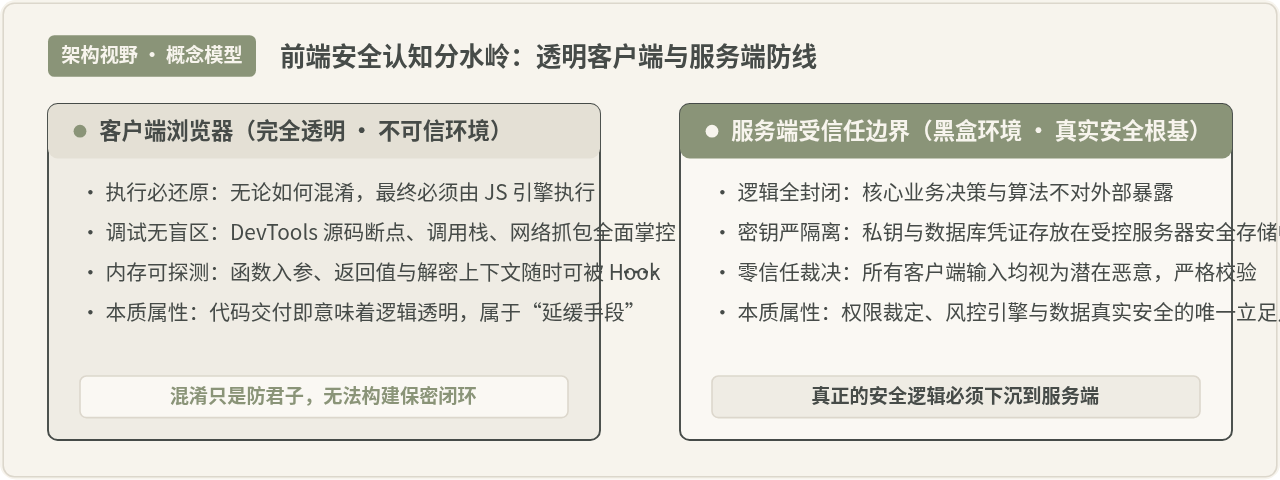
一、为什么混淆常被误认为“绝对安全”?辨析与修正
在前端开发团队中,常常能听到类似“只要把打包脚本配置上复杂的混淆插件(如 javascript-obfuscator),代码就安全了”的观点。这种看法看似合理,原因在于混淆后的代码在文本层面上确实面目全非:语义变量名被替换为类似 _0x3f1a 的无意义十六进制符号,原本整洁的字符串被抽取成经 Base64 或位运算移位的大数组,原本顺序执行的逻辑被打包塞进了由 switch-case 驱动的复杂状态机中。
普通人甚至未经专门训练的开发者打开控制台,面对数十万行没有换行符、变量名高度趋同的代码,往往会产生“这等同于加密,根本读不懂,所以很安全”的错觉。然而,这一认知混淆了“加密(Encryption)”与“混淆(Obfuscation)”的本质区别:
- 密码学加密:在没有私钥的情况下,密文在数学上无法被逆向还原。密文本身无法直接在计算芯片上执行,必须先经解密模块还原为明文指令。
- 代码混淆:它不依赖外部密钥,混淆后的代码依然是完全合法的 JavaScript 代码,必须由浏览器的 JavaScript 引擎(如 V8)直接解析并执行。
换言之,无论代码在静态文本状态下多么令人费解,为了让浏览器正常运行它,混淆器必须将“如何执行、何时解密、如何求值”的完整逻辑同时打包在同一个脚本中并随网络交付给客户端。这就决定了它对拥有客户端控制权的逆向者而言是全透明的。
二、JS 混淆的技术原理:AST 变换未改变执行语义
为了理解混淆的边界,需要先了解现代混淆器究竟对代码做了什么。混淆工具通常基于抽象语法树(AST,Abstract Syntax Tree)进行遍历与重写,主要手段包括:
- 标识符混淆(Mangle / Renaming):将具有业务语义的变量名、函数名(如
calculatePaymentAmount)替换为无意义的短字符或高混淆字符(如_0x1b4c、O0O0OO)。 - 字符串提取与移位加密(String Array Extraction):扫描整个 AST,将所有字符串字面量抽取到一个全局数组中,并在代码初始化时通过自执行函数对数组进行位移旋转(Rotator),代码内部通过下标与解密辅助函数动态取值。
- 控制流平坦化(Control Flow Flattening):打破原本的
if-else与for循环,将所有代码块切片包装为switch语句的多个case,通过一个不断更新的状态变量来驱动跳转,彻底掩盖真实的调用链。 - 死代码与反调试注入(Dead Code & Anti-Debugger):注入大量永远不会执行的代码分支,并在关键节点插入包含
debugger语句的无限递归或定时器,企图在开发者工具开启时冻结页面。
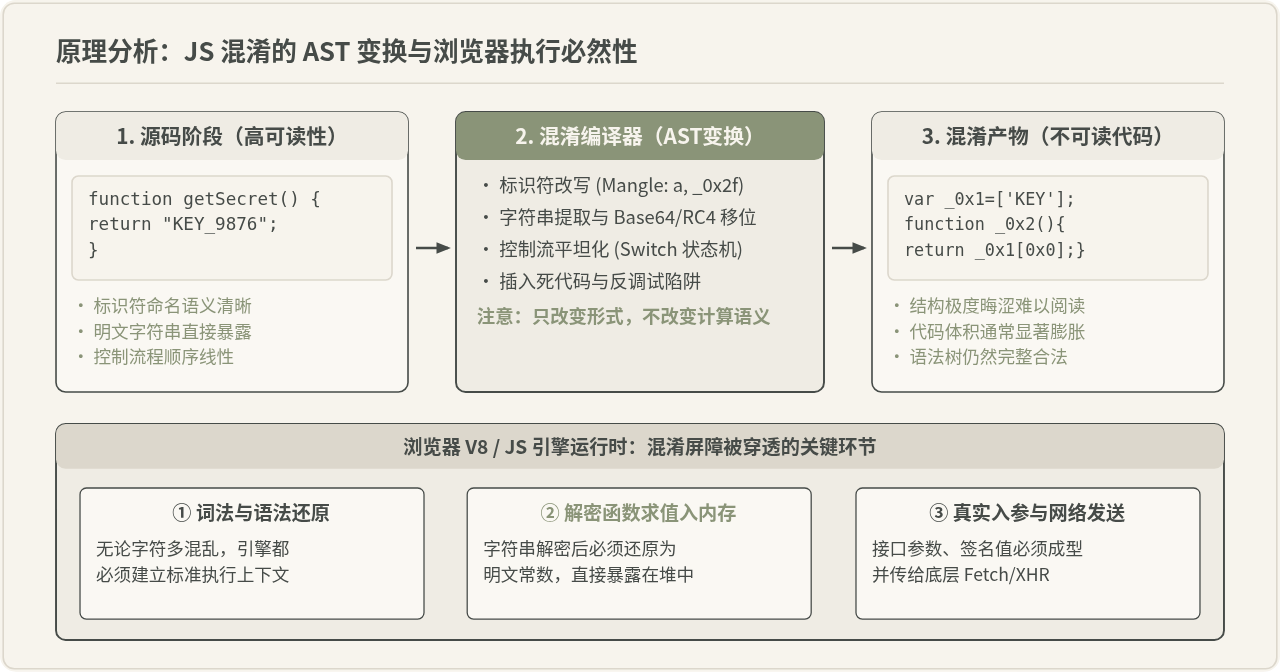
从图 1 可以清晰看出,AST 变换虽然极大地扭曲了代码的表面结构,但它遵守等价计算原则。如果一段混淆代码改变了程序的计算结果,那它就破坏了业务本身。正因如此,JavaScript 引擎在执行这些代码时,依然必须一步不差地进行内存分配、函数调用与网络通信,这就给逆向分析留下了绝对清晰的切入点。
三、攻击者如何逆向突破混淆?四步实操推导
很多人认为破解混淆代码需要耗费大量时间去逐行读懂代码。事实上,经验丰富的安全研究人员或爬虫逆向工程师几乎不会去逐行通读混淆后的源码。利用浏览器环境赋予的完全掌控权,逆向突破往往遵循一套非常标准、高效的排查步骤:
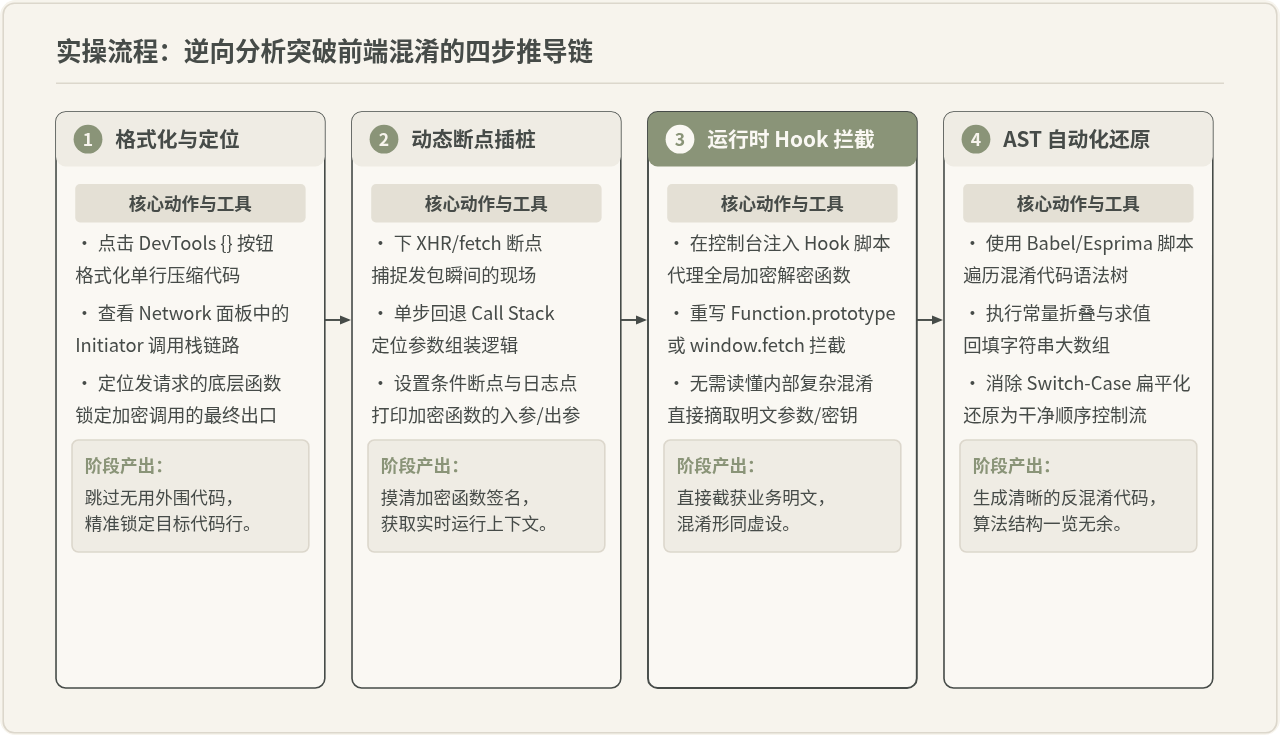
步骤 1:格式化与网络回溯定位
面对单行数兆字节的打包文件,首先使用 Chrome DevTools 提供的 {} Pretty-Print 功能展开代码。接着,逆向者并不急于阅读代码,而是切换到浏览器的 Network 面板,触发目标操作(如点击提交订单或查询敏感接口)。在抓到的网络请求中,点击 Initiator 列查看该请求的调用栈(Call Stack),浏览器会精准指出是哪一个混淆文件、哪一行、哪个函数发起了网络调用。这一步瞬间帮攻击者过滤掉了 99% 的无关代码。
步骤 2:下发断点与动态调用栈回溯
在 Initiator 定位的代码位置打上断点,或者在 DevTools 的 XHR/Fetch Breakpoints 中添加目标 URL 规则。重新触发操作后,浏览器会精准在数据发出前夕暂停执行。此时,右侧面板中的 Scope(作用域变量) 和 Call Stack(调用栈) 将完全展开:即便函数名叫做 _0x3a(),但传入该函数的参数、正在计算的中间值全部以明文形式展示在内存树中。
步骤 3:运行时 Hook 提取明文(降维打击)
混淆器最引以为傲的往往是字符串数组加密。但在运行时,JavaScript 的动态特性决定了原型链和全局对象是开放的。逆向者根本不需要解开其加密算法,只需在控制台执行一小段 Hook 脚本:
// 示例:Hook 常见的底层网络接口与解密调度器
const originalFetch = window.fetch;
window.fetch = function(...args) {
  console.log("[Hook] 拦截到网络请求 URL:", args[0]);
  console.log("[Hook] 拦截到待发送 Payload:", args[1]?.body);
  return originalFetch.apply(this, args);
};

// 若定位到混淆的字符串解密函数 _0x4b12
const originalDecrypt = window._0x4b12;
if (typeof originalDecrypt === "function") {
  window._0x4b12 = function(index, key) {
    const result = originalDecrypt(index, key);
    console.log("[StringDecrypt] 索引:", index, "=> 明文:", result);
    return result;
  };
}
通过这段不到十行的代码,整个混淆体系中所有的字符串常数在浏览器加载运行的同时就被全部输出。甚至连生成签名的核心逻辑,攻击者都可以通过 Puppeteer 或 RPC 框架直接在控制台调用 window.generateSign(params),实现“黑盒白嫖”,完全无需逆向算法本身。
步骤 4:基于 AST 的自动化脚本反混淆
如果逆向者必须还原算法离线运行,他们会使用 Babel 解析混淆代码生成 AST 树,编写几段简单的访问者插件(Babel Visitors):
- 常量折叠(Constant Folding):自动计算
1 + 2或简单表达式并直接替换为结果值。 - 字符串还原:在 Node.js 环境中将顶部字符串解密函数执行一遍,遍历 AST 找到所有调用解密函数的地方,直接替换为明文字符串。
- 死代码剔除:移除所有
if (false)或恒假分支。 - 控制流还原:将包含
switch-case的状态机数组按顺序拼接,还原为原始的顺序执行代码。
四、JS 混淆的四大核心局限性分析
基于上述原理与逆向实践,我们可以明确归纳出 JS 混淆在前端安全层面的四大根本局限:
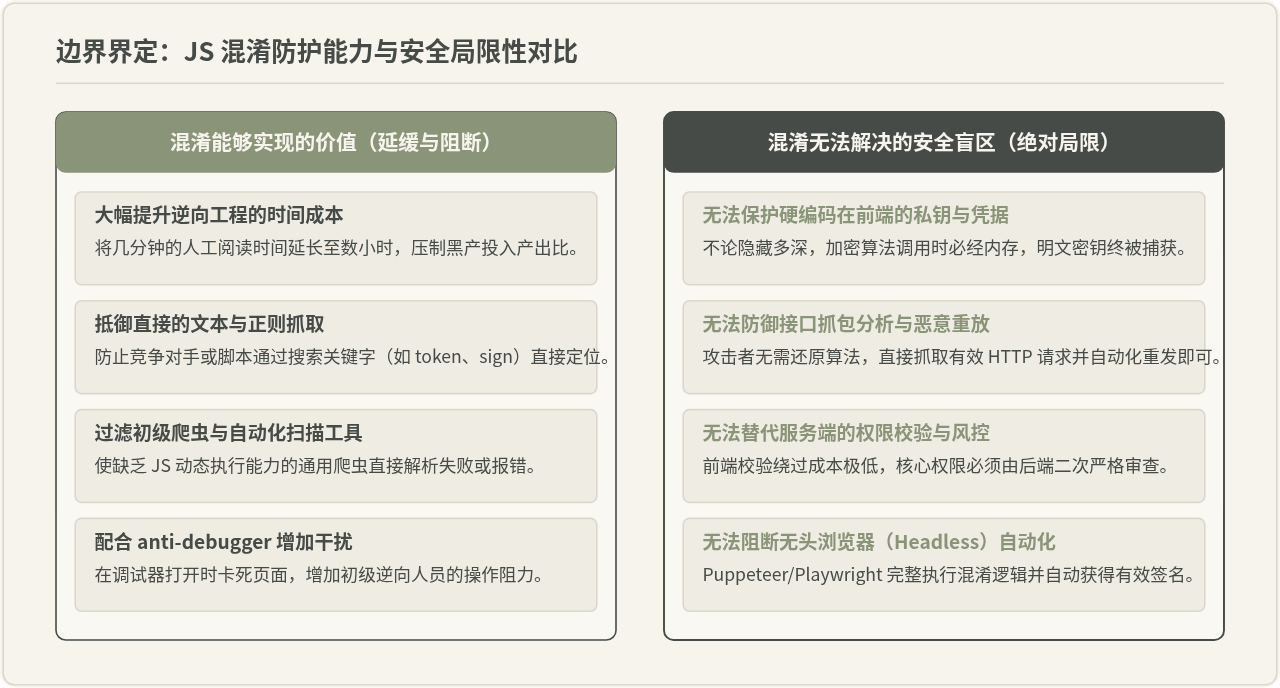
1. 无法安全存储任何敏感密钥(静态凭证死穴)
很多初学者会犯一个致命错误:把第三方支付密钥、短信服务私钥或自定义 AES 密钥直接写在前端,寄希望于深度混淆让黑客找不到。然而,无论通过多少层移位、异或或动态计算,只要前端需要使用这个密钥向外部发包,在调用 crypto.subtle.encrypt 或组装 Header 的那一刻,明文密钥必须完整出现在内存中。只需一行断点,密钥便彻底失守。
2. 无法防御中间人抓包与请求重放
前端混淆保护的是“代码表现层”,而不是“网络通信层”。攻击者甚至不需要打开代码编辑器,直接配置 Charles、mitmproxy 或 Fiddler 抓取 HTTP 报文。只要接口缺乏基于时间戳、一次性随机数(Nonce)和防篡改签名的服务端校验机制,攻击者拿抓取到的完整 Payload 重复发送,就能无限制批量调用业务接口。
3. 无法阻断无头浏览器(Headless Browser)自动化
传统的爬虫通过正则表达式抓取 HTML,混淆可能让这类简易爬虫失效。但现代黑产普遍采用 Puppeteer、Playwright 等真实 Chromium 驱动框架。无头浏览器本身就是一个拥有完整 V8 引擎与渲染树的真实客户端,混淆代码在其中会毫无阻碍地自然运行并计算出正确的签名、Token 与 Cookies。混淆对这种基于真实运行时的自动化攻击几乎毫无抵抗力。
4. 带来显著的工程负收益与性能损耗
过度追求混淆强度还会对工程质量带来严重反噬:
- 包体积剧烈膨胀:字符串数组、控制流扁平化和死代码注入通常会导致打包体积增加 30% 到 200%,极大地拖慢网页首屏加载速度。
- 运行期 CPU 消耗激增:由于控制流被打散并引入大量的函数间接寻址与解密循环,低端移动设备在执行代码时可能出现肉眼可见的卡顿。
- 线上 Bug 排查噩梦:生产环境一旦抛出异常,由于变量名和调用栈被彻底粉碎,且出于保密考虑不能公开 Source Map,排查线上故障的难度将成倍上升。
五、前端安全的正确打开方式:构建全链路纵深防御
认识到混淆的局限性,并不意味着我们要彻底放弃混淆。正确的做法是将混淆从“被寄予厚望的绝对防线”,回归到它本应属于的位置——作为多层防御中的一个辅助阻尼器。真正的前端安全必须遵循“零信任客户端”原则,依靠全链路协同治理。
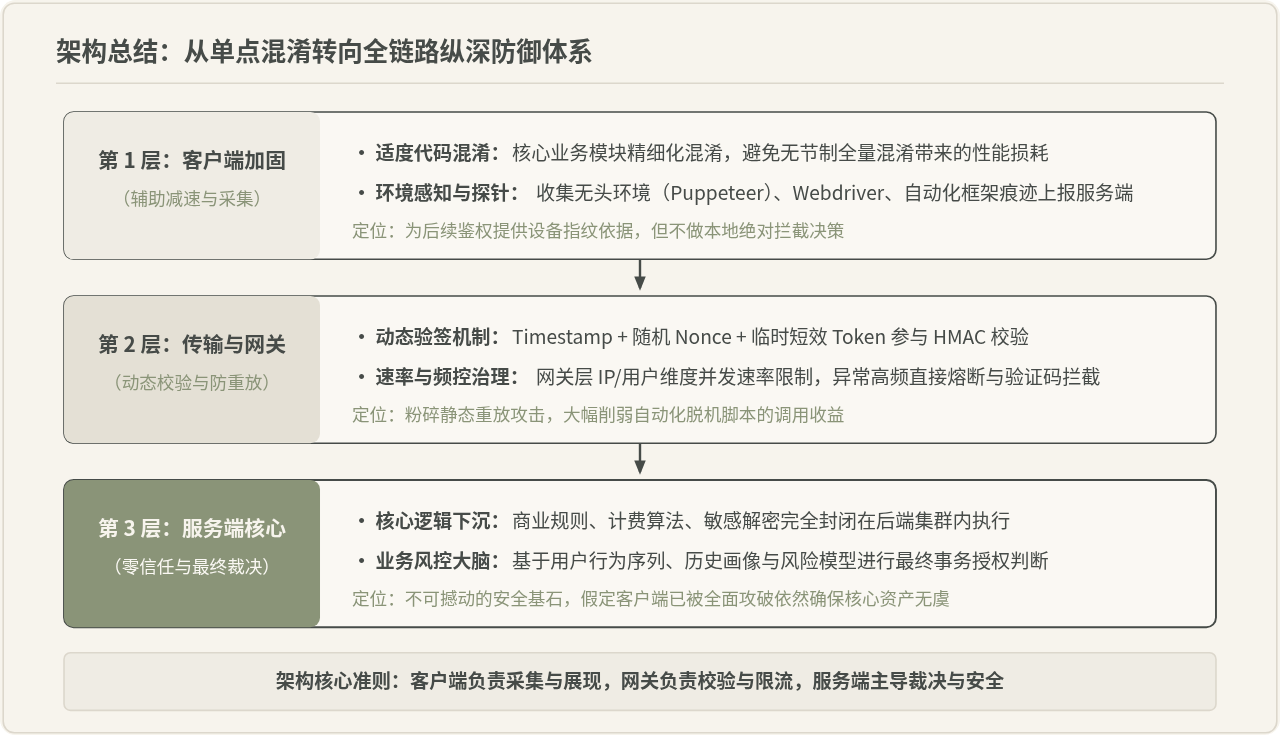
一个健壮的前端安全架构应由以下三层体系构成:
架构准则 1:核心业务逻辑与敏感凭据必须下沉服务端
前端只负责用户交互展示与数据收集。所有的价格计算、打折策略、风控判断与权限鉴权必须由后端独立执行。前端永远不要硬编码任何长期密钥,需要调用第三方云服务时,前端应通过后端换取具备严格权限限制和有效期的临时凭证(如 AWS STS / 阿里云 STS)。
架构准则 2:传输层构建动态防重放与验签闭环
对于高价值接口(如转账、投票、下单),前端发包时应携带由请求参数、当前时间戳(Timestamp)、唯一随机字符串(Nonce)计算出的哈希签名(Sign)。服务端网关进行双重校验:校验时间戳是否在合理窗口期内(如 30 秒以内)、校验 Nonce 是否在 Redis 缓存中已存在(防重放)、校验 HMAC 摘要是否匹配。一旦检测到异常调用,联动弹出滑块或短信人机验证(CAPTCHA)。
架构准则 3:客户端实施适度加固与环境感知
在客户端层面,无需对所有业务代码进行全量重度混淆。建议仅对核心的签名算法、设备指纹上报模块进行针对性的适度混淆。同时在运行时加入基础的环境探针(检测 navigator.webdriver、检测控制台打开状态、检测常用自动化工具特征)。采集到的异常标记直接作为风险特征加密上报给服务端风控引擎,由服务端做出封禁或降级决策,而不是在前端直接阻断。
总结
回到最初的问题:“JS 混淆真的能保护前端代码安全吗?”
答案是:不能提供绝对安全,但能提高攻击门槛。如果你期望通过混淆来隐藏商业机密、保护接口不被抓取,或者防止核心资产被逆向,这种期望在架构上注定会落空;但如果你将混淆作为纵深防御体系中最外层的“减速带”,用来过滤通用脚本、增加逆向分析的时间成本,并配合服务端的严格鉴权、动态验签与业务风控,它就能在整体安全链条中发挥其应有的协同价值。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章