
深入解析JavaScript中向数组末尾追加元素的两种主流方案:Array.prototype.push方法与ES6展开运算符(...)。详解语法、底层内存机制、执行效率、React状态更新契约与常见避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组末尾追加元素:push方法与展开运算符用法
作者:拾光
时间:2026-11-18
浏览:601
文章目录
分类:JavaScript 技术教程
阅读时长:约 8 分钟
代码规范:ES6+ / 生产可用
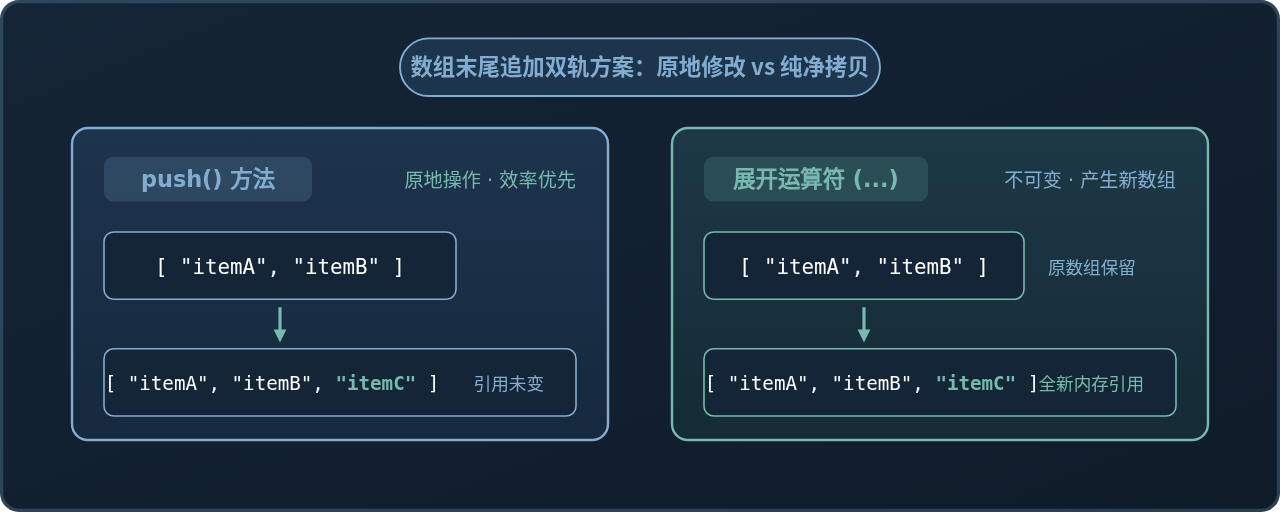
向数组末尾追加元素是日常开发中最频繁的操作之一。在分页加载列表追加新数据、表单收集多项输入、或者在应用中追加日志记录时,开发者通常有两种主流做法:经典的 Array.prototype.push() 方法与 ES6 引入的展开运算符(Spread Operator ...)。
两者的根本区别在于数据可变性与内存引用策略:push() 会直接在原数组末尾扩展连续槽位,属于原地修改(In-place Mutation),具有最高的执行性能;而展开运算符 [...arr, item] 则是分配全新堆内存空间、复制原有元素并拼接新项,属于不可变数据操作(Immutable Operation)。在现代 React、Vue 等响应式框架中,选错方法不仅会导致逻辑异常,还会导致视图无法触发更新。
一、使用 Array.prototype.push() 原地追加
push() 是 JavaScript 数组原型链上最古老也是最高效的方法之一。它直接操作调用它的数组实例,将一个或多个参数依次追加到数组的末尾槽位中。
1. 基础用法与追加单项/多项元素
push() 接受可变参数列表,可以单次传入一个元素,也可以一次传入多个元素:
const list = ["Vue", "React"];

// 追加单个元素
list.push("Angular");
console.log(list);
// 示例输出: ["Vue", "React", "Angular"]

// 一次性追加多个元素
list.push("Svelte", "Solid");
console.log(list);
// 示例输出: ["Vue", "React", "Angular", "Svelte", "Solid"]
2. 核心细节:方法的返回值是“新长度”而非数组
这是初学者最容易踩中的语法陷阱:push() 返回的是数值类型的新数组长度,而不是被修改后的数组本身。如果尝试在调用 push() 后进行链式调用,程序会立刻抛出 TypeError。
const scores = [88, 92];
const result = scores.push(95);

console.log(result); // 示例输出: 3 (数值,代表数组新长度)
console.log(scores); // 示例输出: [88, 92, 95]

// 常见错误写法:链式调用将直接崩溃报错
// const filtered = scores.push(100).filter(n => n > 90);
// 运行时异常: TypeError: scores.push(...).filter is not a function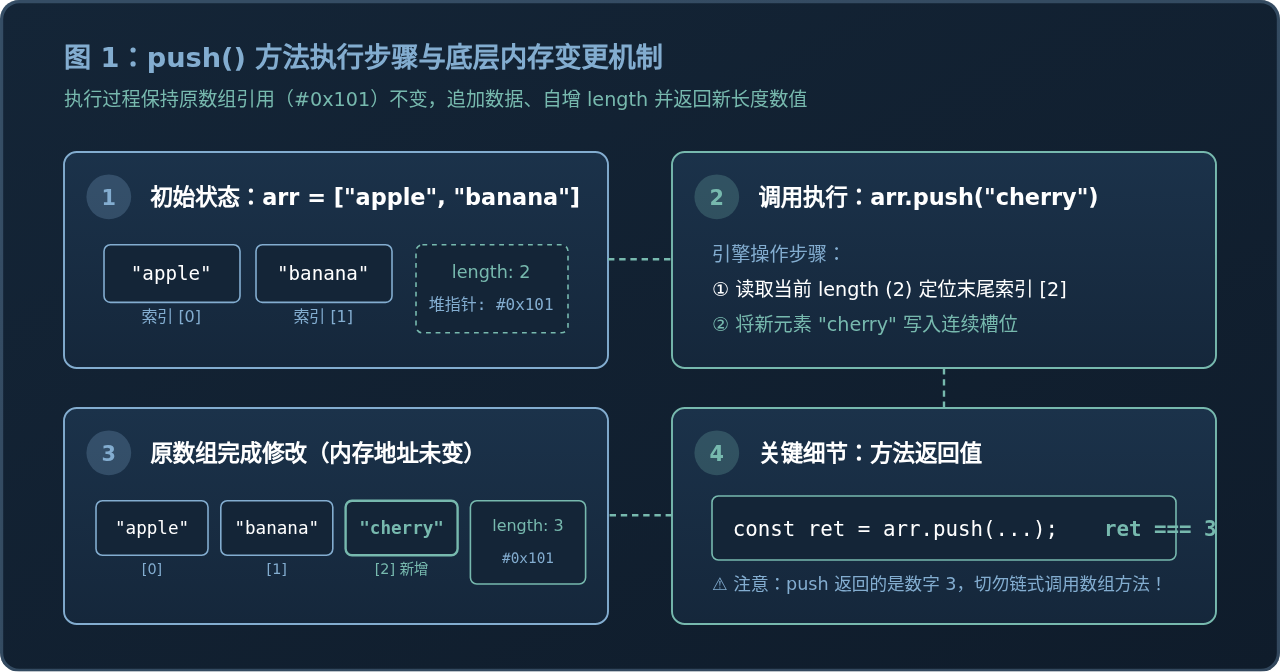
3. 底层机制与性能特点
如上图 1 所示,JavaScript 引擎在执行 push() 时,会读取该数组内部的 length 属性,直接在索引 length 对应的内存槽位写入新元素,随后将 length 的值加 1。整个操作期间,指向该数组的堆内存指针地址(例如 #0x101)保持恒定不变。
由于无需重新申请大块内存和逐个搬运旧数据,push() 的平摊时间复杂度为 O(1)。在需要循环构建数万级规模数组的重度计算场景中,push() 的性能优势极其显著。
⚠️ 注意事项与边界规避
1. 误将待追加数组作为单一参数传入:若执行 arr.push([1, 2]),结果会将整个 [1, 2] 作为嵌套数组推入末尾,变成 [..., [1, 2]]。若要平铺追加,需配合展开运算符 arr.push(...[1, 2])。
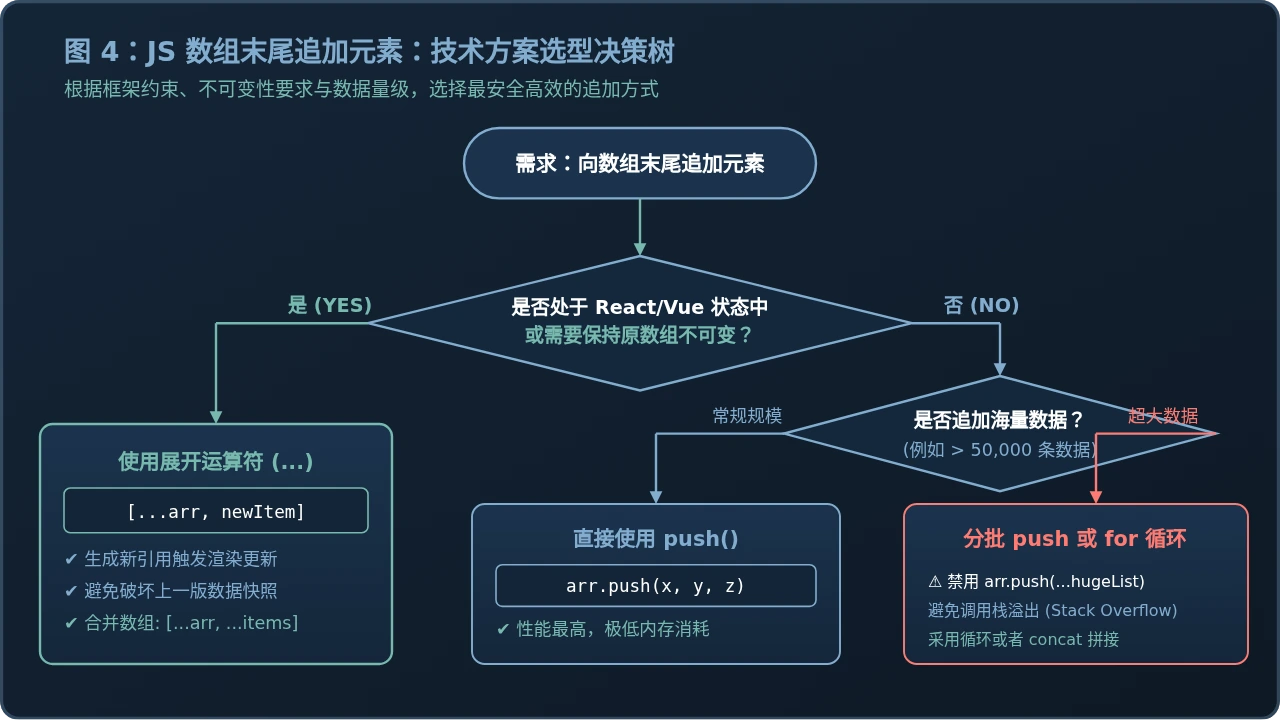
2. 超大数组传参引发调用栈溢出:使用 arr.push(...hugeList) 时,底层是将 hugeList 中的每一项拆解为函数实参。如果 hugeList 包含 10 万以上元素,会超出 JS 引擎的单次函数最大实参数量限制,抛出 RangeError: Maximum call stack size exceeded。超大数组应改用常规循环分批追加或使用 concat()。
二、使用展开运算符 (...) 构建新数组
ES6 引入的展开运算符(Spread Operator,写作 ...)为数组操作带来了声明式的语法表达。通过 [...originalArray, newElement],开发者可以在不改变原有数据结构的前提下,迅速生成包含末尾新元素的新数组。
1. 基础用法与多项合并
展开运算符解开原有数组的迭代器,并与后续直接声明的元素拼接在一个新的中括号字面量内:
const baseConfig = ["host", "port"];

// 追加单个元素
const configWithTimeout = [...baseConfig, "timeout"];
console.log(baseConfig);        // 示例输出: ["host", "port"] (原数组完好无损)
console.log(configWithTimeout); // 示例输出: ["host", "port", "timeout"]

// 同时追加多个元素或拼接另一个数组
const extraKeys = ["retry", "ssl"];
const fullConfig = [...baseConfig, "logLevel", ...extraKeys];
console.log(fullConfig);
// 示例输出: ["host", "port", "logLevel", "retry", "ssl"]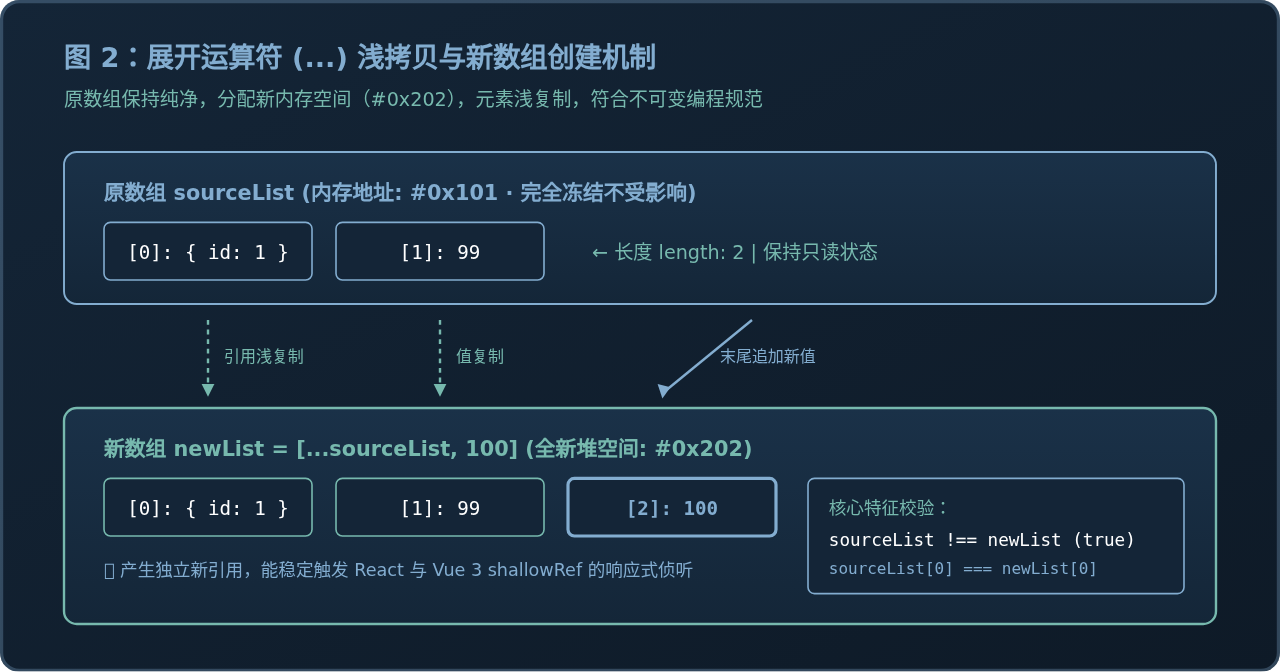
2. 内存模型与不可变性契约
如图 2 所示,展开运算符的底层运作包含三个明确步骤:
- 开辟独立内存空间:在堆内存中申请一个全新的数组容器(例如内存地址
#0x202)。 - 逐项执行浅拷贝:依次遍历原数组(
#0x101),将基本类型的值或对象类型的内存地址指针逐个填充到新容器中。 - 放入末尾新元素:在新容器的末尾槽位追加新传入的元素项。
这种机制保证了原数组 sourceList 绝对不会被修改。在现代工程中,这种特性被称为不可变更新(Immutable Update)。
3. 为何 React / Vue 状态管理高度偏好展开运算符?
在 React 的 useState 或 Vue 3 的 shallowRef 体系中,组件为了性能考量,采用的都是浅层引用对比(Object.is)来判断数据是否发生改变。如果使用 push() 直接修改数组,数组在堆内存里的指针地址没有变,组件侦听器会判定“状态未变更”,从而导致界面根本不会重新渲染。
// React 状态更新最佳实践示例
const [todos, setTodos] = useState(["阅读文档", "整理代码"]);

function handleAddTodo(newTodo) {
  // 错误做法:虽然内容变了,但内存地址未变,React 判定无变化,不触发重新渲染
  // todos.push(newTodo);
  // setTodos(todos);

  // 正确做法:利用展开运算符产生全新的引用地址
  setTodos(prevTodos => [...prevTodos, newTodo]);
}
💡 深度理解:浅拷贝的对象共享特性
需要牢记:展开运算符执行的是浅拷贝(Shallow Copy)。如果原数组中包含对象或嵌套数组,新数组中拷贝的只是对象的引用指针。修改新数组中某个对象的属性,依然会影响到原数组中对应的对象。如果需要彻底断开所有层级的对象引用,需配合深拷贝(例如 structuredClone())进行处理。
三、深层特性对比与性能权衡
为了直观展现两者在工程应用中的差异,下表与图示梳理了它们在语法表现、内存影响与运行效率维度的全貌:
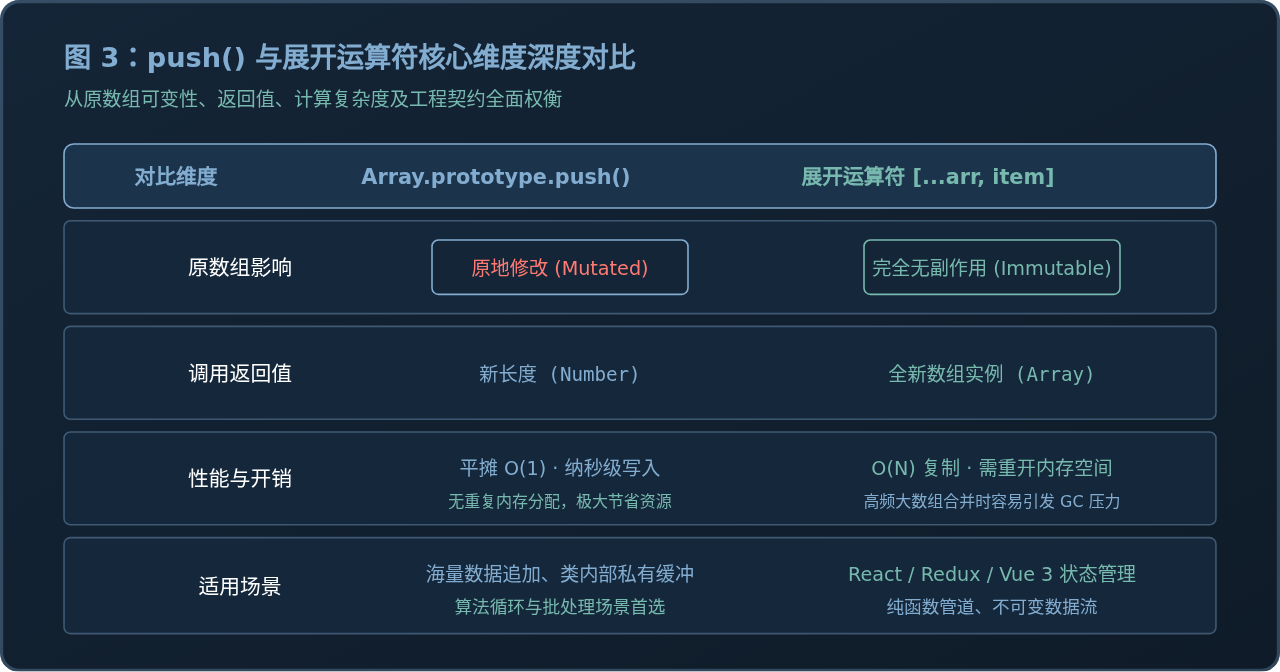
| 对比维度 | Array.prototype.push() | 展开运算符 [...arr, item] |
|---|---|---|
| 数据副作用 | 原地修改原数组(破坏原数据结构) | 纯函数风格,原数组保持不变(Immutable) |
| 调用返回值 | 返回数值(操作后的数组新 length) |
返回新数组实例(具备独立内存地址) |
| 时间复杂度 | 平摊 O(1)(直接末尾寻址写入) | O(N)(必须遍历复制原有全部元素) |
| 空间开销 | 极低,仅在容量不足时触发引擎阶梯扩容 | 较高,每次均需分配包含 N+1 项的新内存块 |
| 垃圾回收 (GC) | 不产生多余临时对象,GC 友好 | 高频循环中会频繁创建废弃旧数组,增加 GC 频次 |
| 框架响应式支持 | 对基于引用对比的框架(React/Vue shallow)不友好 | 原生契合响应式变更通知机制 |
四、实际开发中的方案选型决策
在了解了执行机制之后,选型其实非常清晰。可以依据下图 4 所示的决策流程进行判断:
1. 优先选择展开运算符的场景
- 前端框架状态更新:在 React 组件状态、Redux Reducer、Zustand、Pinia 或 Vue
shallowRef中更新列表数据,必须使用[...arr, item]确保引用地址改变。 - 纯函数与业务历史快照:如果编写的函数属于公共工具库,或者需要保留历史版本支持“撤销/重做”功能,必须保证输入参数不被隐式修改。
- 语义化声明式代码:希望在一行代码中连贯地组合初始数据、末尾元素和多组配置项时,展开运算符的可读性最高。
2. 优先选择 push() 方法的场景
- 内部私有临时集合:在某个函数内部局部声明的数组(外部无法访问),例如用循环筛选数据、转换树形结构。此时原地修改完全无外部副作用,且效率最高。
- 海量数据高频追加:在数据量达数万、数十万条的算法循环中,或者实时 WebSocket 数据流缓存队列中,必须使用
push()避免频繁创建新对象引发严重的 GC 卡顿。
3. 海量数据合并安全实践:警惕展开参数溢出
当需要向已有数组追加另一个包含数万条元素的数组时,切勿轻率使用 arr.push(...hugeArray)。安全高效的实现方式如下:
// 场景:targetArray 已经存在,需将 largeBatch 的数据高效追加进去
const targetArray = [1, 2, 3];
const largeBatch = new Array(60000).fill(99);

// ❌ 危险操作:超过 JavaScript 引擎函数参数上限,直接报 RangeError
// targetArray.push(...largeBatch);

// ✅ 安全方案 A:常规 for 循环追加(原地修改,性能极致)
for (let i = 0; i < largeBatch.length; i++) {
  targetArray.push(largeBatch[i]);
}

// ✅ 安全方案 B:concat 拼接生成新数组(不会受参数数量限制)
const combinedArray = targetArray.concat(largeBatch);
五、总结
向 JS 数组末尾追加元素看似只是一个基础动作,但其实代表了过程式原地修改与函数式不可变数据两种不同的架构思维:
- 需要极致吞吐与性能、且数据属于局部受控变量时,使用
push();注意其返回的是长度数值。 - 需要触发界面响应式更新、保证数据流纯净无副作用时,使用展开运算符
[...arr, item];注意其每次都会带来一次内存浅拷贝开销。
掌握两者的底层逻辑和适用边界,就能在日常业务和系统架构中写出既稳定又高效的高质量 JavaScript 代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章