
针对JavaScript树结构在路径查找中触发Maximum call stack size exceeded报错的问题,本文深入剖析递归调用栈限制根源,并提供稳健的迭代法替代方案,涵盖DFS显式栈查找、父节点映射内存优化及广度优先BFS实现。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript树路径查找栈溢出怎么办?迭代法替代递归方案
作者:异步漫步
时间:2026-11-18
浏览:195
文章目录
前端架构 / 算法与数据结构
适用场景:UI级联树、组织架构树、复杂AST及嵌套数据路径定位
在处理多层嵌套树结构时,若采用递归方式查找目标节点并收集路径,当树的层级较深(通常在数千至上万级)或存在极端退化单链时,JavaScript 引擎会立即抛出
RangeError: Maximum call stack size exceeded。彻底解决该问题的根本方案是将隐式函数调用栈转为显式堆栈,利用普通的 JavaScript 数组在堆内存中模拟深度优先遍历(DFS)或广度优先遍历(BFS),彻底消除执行上下文对调用栈的占用。
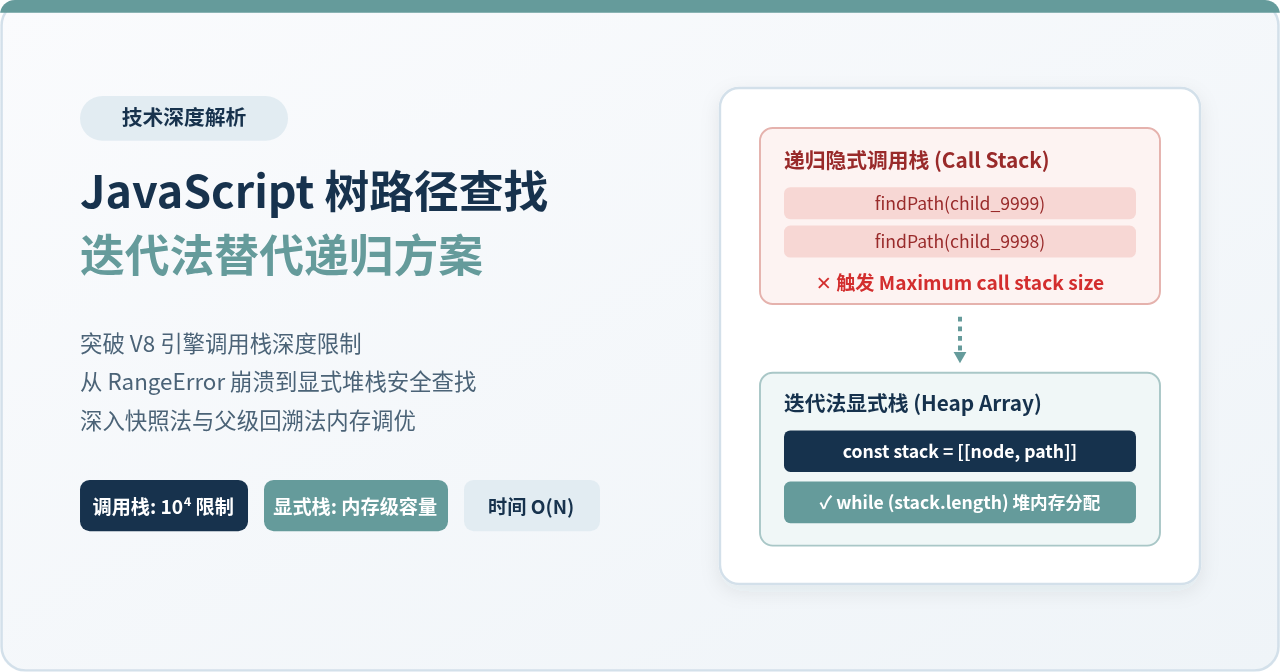
缩略图:JavaScript 树路径查找从递归调用栈向迭代显式栈的迁移方案
一、为什么递归树查找会发生栈溢出?
在日常开发中,查找树中某一节点并回溯获取“根到叶”的完整路径是一项常见需求。例如,在级联选择器(Cascader)、权限系统路径校验、分类目录联动和代码 AST 解析中,开发者往往顺手写出深度优先的递归函数。
这种写法在几层或几十层的常规 UI 数据中表现良好,但在真实工业场景下潜藏严重风险:
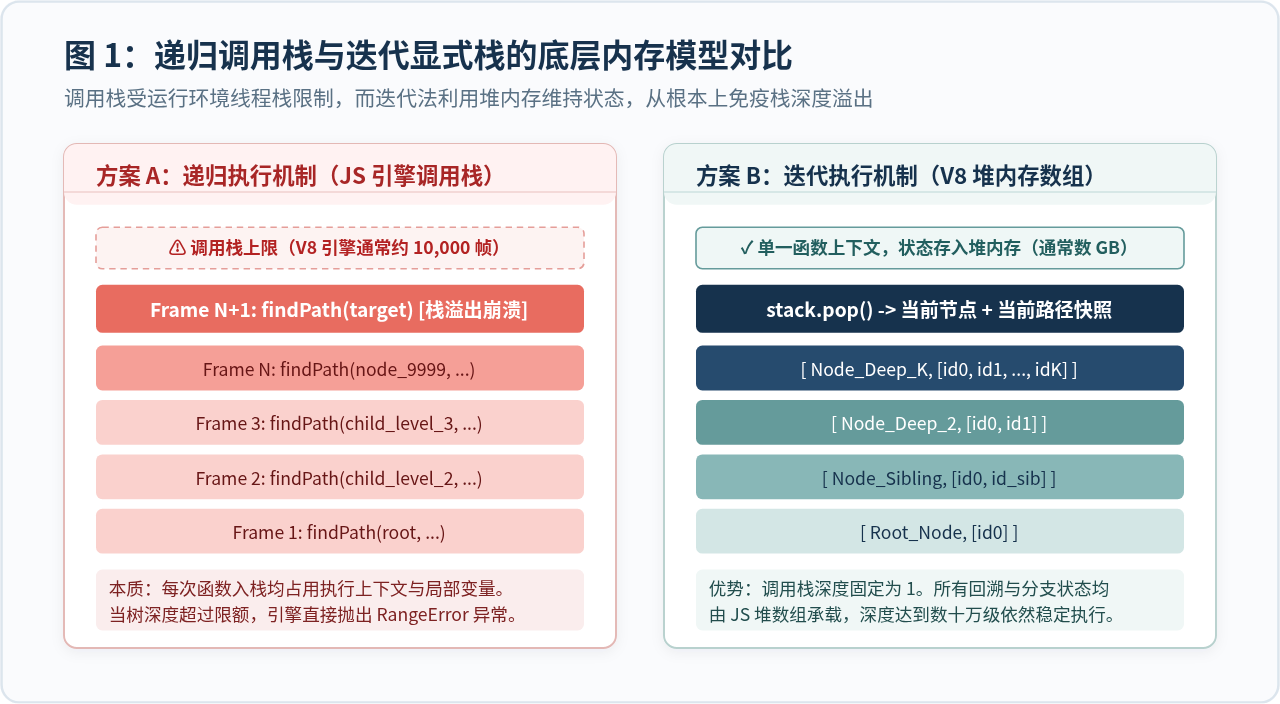
- 物理栈帧限额:JavaScript 引擎(如 Chrome 与 Node.js 搭载的 V8)为防止死循环耗尽系统资源,给执行线程的函数调用栈设定了硬性帧数上限。在大多数现代宿主环境中,这个上限大约在 10,000 到 15,000 帧之间。
- 深度退化与单链树:当数据来源于组织架构、层级审批流、动态递归派生节点,或由于脏数据产生深达上万层的链路时,每一次
findPath的向下探寻都会创建一个新的活动执行帧。 - 不可控的 RangeError:一旦栈深度越过临界点,引擎直接中断当前脚本,抛出
RangeError: Maximum call stack size exceeded,导致页面崩溃或 Node.js 进程意外终止。
典型错误重现:
很多开发者认为加了
很多开发者认为加了
try...catch 即可兜底,但栈溢出属于执行引擎级别的不可恢复中断。即使捕获到了 RangeError,当前的查询逻辑也已完全中断,无法正常返回查找结果。
图 1:递归调用栈与迭代显式栈的底层内存模型对比
二、传统递归查找的脆弱之处:代码复盘
为了清晰对比,先审视产生溢出的典型递归代码:
// 传统的递归路径查找实现(存在溢出隐患)
function findTreePathRecursive(root, targetId) {
  if (!root) return null;

  function traverse(node, currentPath) {
    const nextPath = [...currentPath, node.id];
    if (node.id === targetId) {
      return nextPath;
    }

    if (Array.isArray(node.children)) {
      for (const child of node.children) {
        // 核心风险点:每深入一层,调用栈便推入一个未返回的函数帧
        const result = traverse(child, nextPath);
        if (result) return result;
      }
    }
    return null;
  }

  return traverse(root, []);
}
在这段代码中,如果构建一棵深度为 12,000 的单链树并查找末端节点,Node.js 或浏览器控制台会立刻报错退出。根本原因在于:traverse 函数必须等待子调用的返回,因而所有的父级上下文全部滞留在执行栈中无法释放。
三、方案一:基于显式栈的迭代法(路径快照方案)
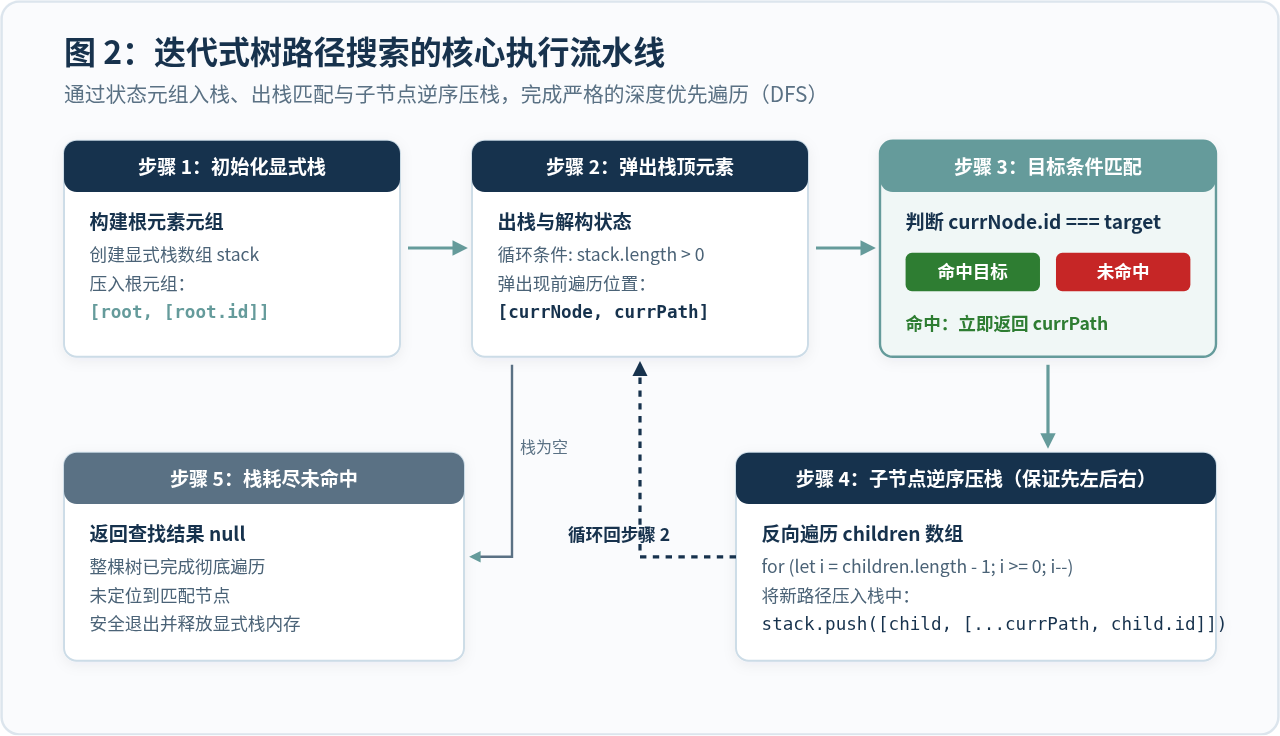
迭代法的核心思想是“将控制权从引擎调用栈接管到代码内部的堆数组中”。通过自己维护一个名为 stack 的数组,将每次需要处理的节点与当前路径组合成一个元组 [node, currentPath] 压入栈中,然后使用 while 循环不断出栈处理。
这样,无论树有多深,全局的函数调用栈深度始终为 1,所有的遍历历史与分支状态均保存在 V8 堆内存中。现代运行时的堆内存通常以 GB 计,足以为数十万级别的节点提供充足的周转空间。
图 2:迭代式树路径搜索的核心执行流水线
完整可执行代码:DFS 迭代快照法
/**
 * 迭代法实现树节点路径查找(防栈溢出)
 * @param {Object} root - 树的根节点
 * @param {string|number} targetId - 待定位的目标节点 ID
 * @returns {Array|null} - 返回从根到目标节点的 ID 数组,未找到返回 null
 */
function findTreePathIterative(root, targetId) {
  if (!root) return null;

  // 显式栈:存储元组 [当前节点, 沿途路径]
  const stack = [[root, [root.id]]];

  while (stack.length > 0) {
    // 弹出栈顶节点进行校验
    const [currentNode, currentPath] = stack.pop();

    // 命中目标:立即返回收集好的路径
    if (currentNode.id === targetId) {
      return currentPath;
    }

    // 若存在子节点,将子节点逆序压栈以保证与递归相同的“先左后右”遍历次序
    if (Array.isArray(currentNode.children) && currentNode.children.length > 0) {
      for (let i = currentNode.children.length - 1; i >= 0; i--) {
        const child = currentNode.children[i];
        if (child) {
          stack.push([child, [...currentPath, child.id]]);
        }
      }
    }
  }

  // 遍历完毕未命中
  return null;
}
关键实现细节 —— 为什么要逆序压栈?
因为数组的
因为数组的
pop() 是从尾端弹出元素(LIFO 后进先出)。若希望按照 children 数组由左至右(索引 0 至 N-1)的先序顺序遍历,就必须先压入索引大的右侧子节点,再压入索引小的左侧子节点。
四、方案二进阶:超深树与大分支的内存优化(父级回溯法)
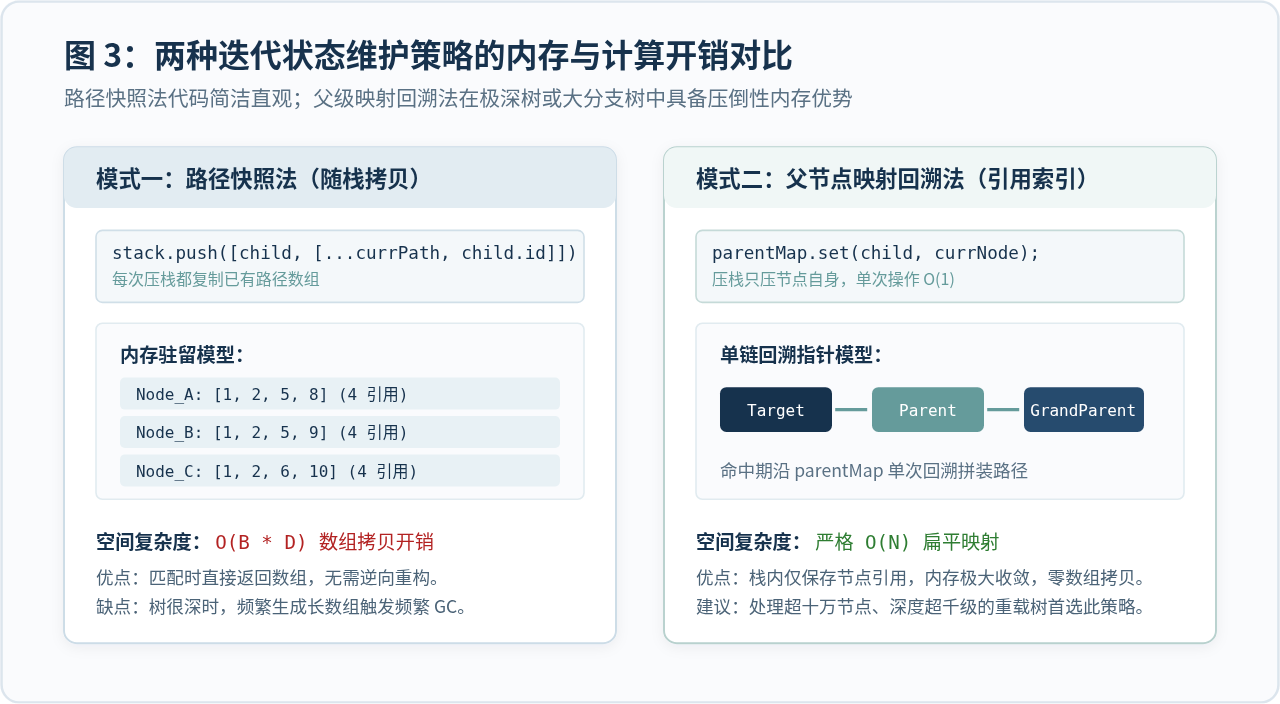
虽然上述快照方案彻底解决了 Maximum call stack size 崩溃问题,但它存在一个性能副产物:每次向栈中压入子节点时,都需要通过 [...currentPath, child.id] 浅拷贝一次历史路径。
在极度茂密的庞大树中,栈内可能同时驻留大量长数组,导致瞬间产生大量短生命周期的内存垃圾,触发引擎的垃圾回收(GC)卡顿。为了达到极客级的内存利用率,推荐使用父节点映射回溯法。
图 3:两种迭代状态维护策略的内存与计算开销对比
父节点映射优化代码
该方案在压栈时仅压入节点对象指针(O(1) 开销),并通过 Map 记录 childNode -> parentNode 的单向血缘指针。只有在真正命中目标时,才从目标节点逆向向上爬升组装出最终路径:
/**
 * 零路径拷贝的高性能迭代查找(极低内存开销)
 * @param {Object} root - 树根节点
 * @param {string|number} targetId - 目标节点唯一标识
 * @returns {Array|null} - 从根至目标的完整节点或 ID 列表
 */
function findTreePathOptimized(root, targetId) {
  if (!root) return null;

  // 仅存储节点本身,不携带长路径数组
  const stack = [root];
  // 维护节点与父节点的映射关系
  const parentMap = new Map();
  parentMap.set(root, null);

  let targetNode = null;

  while (stack.length > 0) {
    const current = stack.pop();

    if (current.id === targetId) {
      targetNode = current;
      break;
    }

    if (Array.isArray(current.children)) {
      for (let i = current.children.length - 1; i >= 0; i--) {
        const child = current.children[i];
        if (child) {
          parentMap.set(child, current);
          stack.push(child);
        }
      }
    }
  }

  // 未找到目标
  if (!targetNode) return null;

  // 从目标节点逆向回溯至根节点
  const path = [];
  let curr = targetNode;
  while (curr !== null) {
    path.push(curr.id); // 亦可 push(curr) 保存完整节点对象
    curr = parentMap.get(curr);
  }

  // 翻转为根到叶的正向顺序
  return path.reverse();
}
五、分支场景补充:寻找“最短路径”时选用 BFS 队列
DFS(深度优先)沿着一条分支扎到最深处,但如果树的某些深处分支极其冗长,而目标节点其实位于较浅的同级兄弟节点中,使用 DFS 可能会过早遍历无意义的深坑。
若业务要求“如果有多处匹配,优先返回层级最浅的节点路径”,则应该采用广度优先遍历(BFS)。BFS 同样免疫调用栈溢出,仅需把 stack.pop() 换为队列出队操作即可:
/**
 * 广度优先(BFS)路径查找:天然保证找到层级最浅的路径
 */
function findTreePathBFS(root, targetId) {
  if (!root) return null;

  // 使用数组模拟队列,初始装载根节点元组
  const queue = [[root, [root.id]]];

  while (queue.length > 0) {
    const [current, path] = queue.shift();

    if (current.id === targetId) {
      return path;
    }

    if (Array.isArray(current.children)) {
      for (let i = 0; i < current.children.length; i++) {
        const child = current.children[i];
        if (child) {
          queue.push([child, [...path, child.id]]);
        }
      }
    }
  }

  return null;
}
生产环境提示:原生数组的
queue.shift() 时间复杂度为 O(N)。若队列中的待处理元素超过数万个,建议引入基于双向链表或环形缓冲区的标准 Queue 结构以保持常数级 O(1) 的出队耗时。
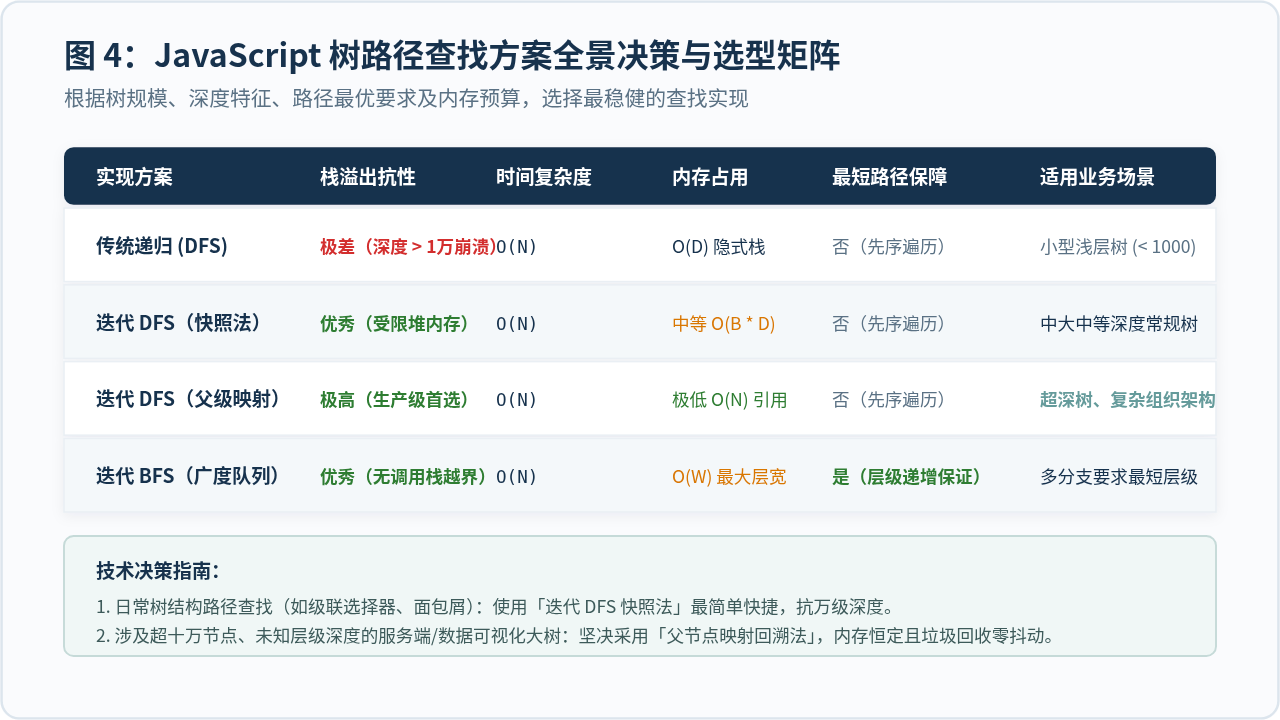
图 4:JavaScript 树路径查找方案全景决策与选型矩阵
六、工程落地注意事项与防御性设计
在企业级项目中替换或重构树算法时,除了将递归改为迭代,还应兼顾以下防御性边界条件:
-
循环引用防范(环检测):
如果前端接收到的树数据被错误处理,存在
child.parent = node等自引用循环,迭代法虽然不会报调用栈溢出,但会陷入死循环耗尽堆内存。建议引入visited = new Set()对已访问节点的引用进行排重。 -
多根节点与森林结构:
业务数据常常是
const tree = [node1, node2]数组而非单个根对象。初始化栈时,只需将森林数组中的所有根节点逆序压入stack即可直接复用全部逻辑。 -
字段命名灵活性:
不同后端的树形结构中,子节点键名可能是
children、nodes或subList,标识字段可能是id或key。在封装工具函数时,最好支持配置项(如options = { idKey: 'id', childrenKey: 'children' })。
七、验证与自测用例
读者可将以下验证脚本复制到 Node.js 环境或浏览器 DevTools 控制台中直接运行,直观体验递归与迭代在万级深树上的天壤之别:
// 1. 构造一个深度为 20,000 的深层单链树(足以彻底撑爆调用栈)
const DEEP_LEVEL = 20000;
const root = { id: 0, children: [] };
let current = root;

for (let i = 1; i <= DEEP_LEVEL; i++) {
  const nextNode = { id: i, children: [] };
  current.children.push(nextNode);
  current = nextNode;
}

console.log("深树构造完成,总层数:", DEEP_LEVEL);

// 2. 验证递归方案
try {
  findTreePathRecursive(root, DEEP_LEVEL);
} catch (err) {
  console.error("【递归方案】如期抛出异常:", err.message);
  // 输出:RangeError: Maximum call stack size exceeded
}

// 3. 验证迭代方案
console.time("【迭代优化方案】执行耗时");
const result = findTreePathOptimized(root, DEEP_LEVEL);
console.timeEnd("【迭代优化方案】执行耗时");

console.log("【迭代优化方案】成功返回路径长度:", result.length);
console.log("路径首末节点:", result[0], "-> ... ->", result[result.length - 1]);
// 正常输出:耗时约 8~15ms,安全返回 20,001 个节点路径!
八、总结
当 JavaScript 树路径查找抛出栈溢出异常时,问题的症结在于递归算法对调用栈帧的深度绑定。消除隐患的唯一根本办法不是盲目增加运行参数,而是将逻辑重构为基于显式栈或队列的迭代方案。
在大多数前端常规场景下,迭代 DFS 快照法以其清晰直观的代码结构足以满足日常需求;而面对数万级节点、深度未知或内存严苛的服务端与大数据场景,父节点映射回溯法能做到近乎完美的内存收敛与线性耗时。理解这两种迭代模型的内在差异,能让你在面对任何复杂的树形结构时游刃有余。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章