
深入讲解JavaScript对象数组按指定属性求交集的高效实现方案。通过Set与filter两步法降低时间复杂度至O(N+M),涵盖复合多属性匹配、去重合并与边界防御的完整工程实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS对象数组怎么按指定属性求交集
作者:拾光
时间:2026-11-18
浏览:87
文章目录
标准解法:基于 Set 与 filter 的两步过滤法
在前端交互或 Node.js 服务端业务中,经常需要依据唯一标识(如 id 或 userId)在两个对象列表中找出公共部分。例如,页面中已选中的用户列表需要与最新获取的全量组织架构列表进行交集运算,以剔除已经失效的用户。
最直接也是性能最优的原生实现方式如下:
// 1. 定义源数据:两个包含对象的数组
const listA = [
  { id: 1, name: '张三', dept: '技术部' },
  { id: 2, name: '李四', dept: '产品部' },
  { id: 3, name: '王五', dept: '设计部' }
];

const listB = [
  { id: 2, role: 'Admin' },
  { id: 3, role: 'Editor' },
  { id: 4, role: 'Guest' }
];

// 2. 提取 listB 中所有目标属性值构建 Set 集合
const allowedIds = new Set(listB.map(item => item.id));

// 3. 对 listA 进行过滤,仅保留 id 存在于 allowedIds 的项
const intersection = listA.filter(item => allowedIds.has(item.id));

console.log(intersection);
示例运行输出
[
{ id: 2, name: '李四', dept: '产品部' },
{ id: 3, name: '王五', dept: '设计部' }
]
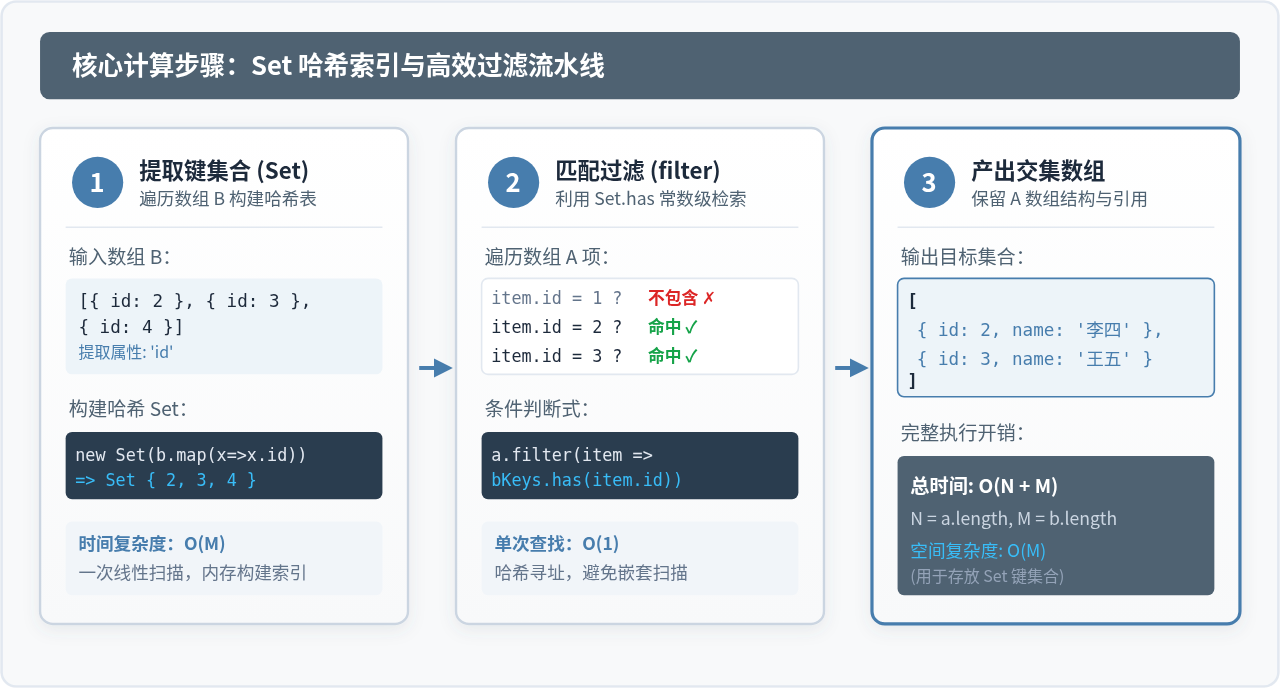
该解法的执行流程清晰地分为两个独立阶段:
- 阶段一(哈希集合构建):利用
listB.map(item => item.id)收集全部对比键,并通过new Set(...)实例化底层哈希表。这一步的耗时与listB的长度 M 成正比,时间复杂度为 O(M)。 - 阶段二(线性常数查找):调用
listA.filter(...)逐项遍历,判断allowedIds.has(item.id)。由于Set.prototype.has基于哈希索引,其查找时间复杂度接近 O(1),因此这一步的整体耗时与listA的长度 N 成正比,时间复杂度为 O(N)。
性能探究:为什么坚决避免双重循环(filter + some)
很多初次处理该问题的开发者倾向于写出类似下面的单行代码:
// 不推荐的写法:嵌套双重循环
const badResult = listA.filter(itemA =>
  listB.some(itemB => itemB.id === itemA.id)
);
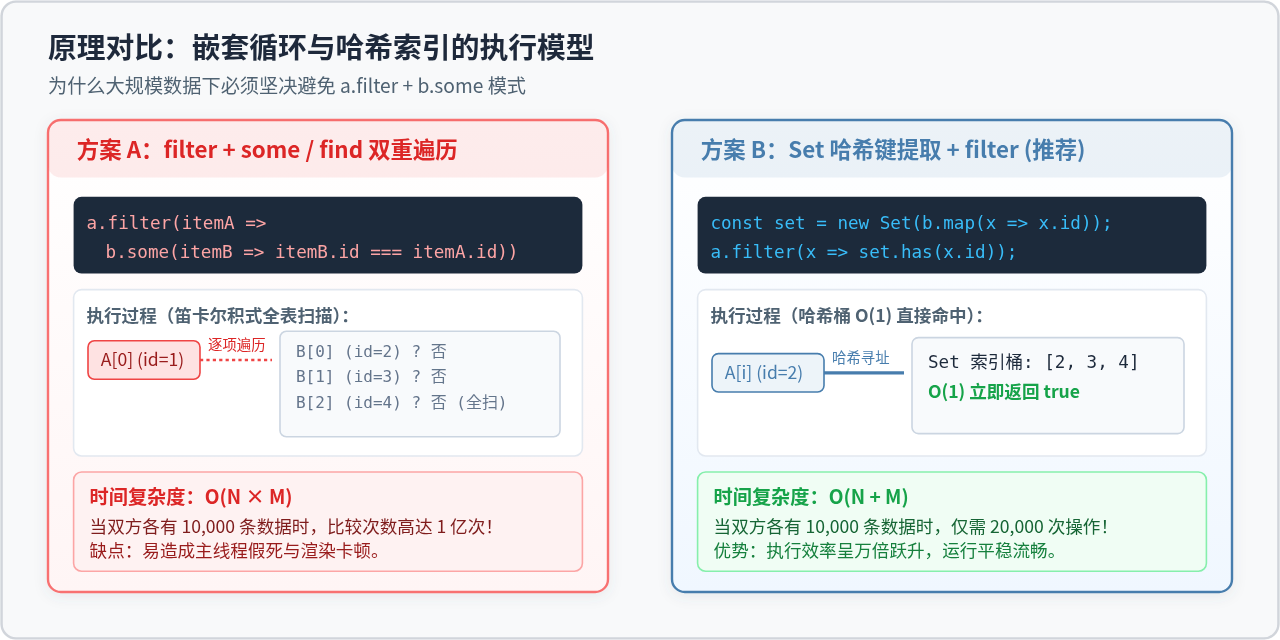
虽然上述代码语法简洁、逻辑直观,但在处理真实项目数据时隐藏着严重的性能隐患。在双重嵌套结构下,外层 filter 每次遍历,内层 some 都会从头到尾线性扫描 listB。每次比较的最坏时间复杂度为 O(M),整个表达式的时间复杂度达到 O(N × M)。
| 数据规模 (N = M) | 嵌套循环比较次数 (N × M) | Set 哈希处理次数 (N + M) | 理论性能差距 |
|---|---|---|---|
| 100 条 | 10,000 次 | 200 次 | 快 50 倍 |
| 1,000 条 | 1,000,000 次 | 2,000 次 | 快 500 倍 |
| 10,000 条 | 100,000,000 次 (1亿次) | 20,000 次 | 快 5,000 倍 |
当数组规模达到上万条时,双重循环会产生上亿次计算,直接导致浏览器页面掉帧卡死甚至触发无响应告警。而 Set 解法仅需数万次运算,几乎在几毫秒内即可完成。
进阶场景一:多字段复合属性求交集
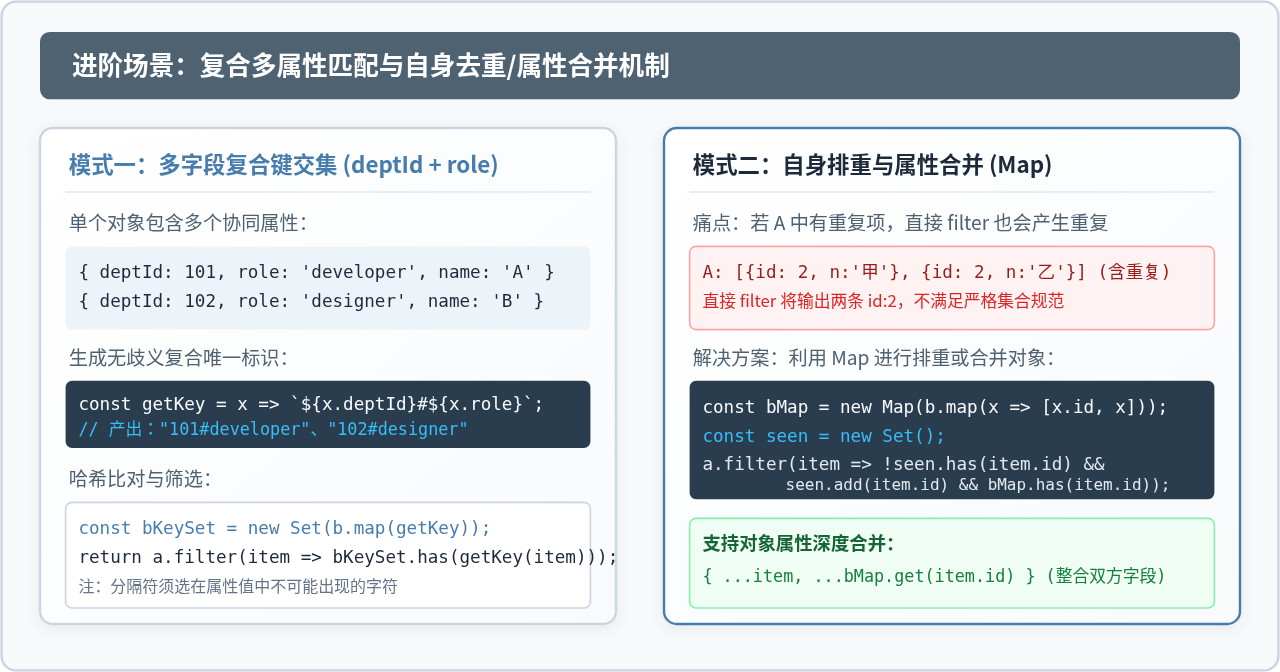
在权限矩阵、库存批次或协同表格中,单一属性往往无法唯一代表一项实体,可能需要同时匹配多个字段(例如要求 deptCode 与 role 均相同)。
此时可以采用复合唯一键(Compound Key)策略:为每个对象提取多个字段值,并用明确无歧义的分隔符拼接成单一字符串键,随后依旧利用 Set 进行常数级检索。
const usersA = [
  { deptCode: 'DEV', role: 'lead', name: 'Alice' },
  { deptCode: 'DEV', role: 'intern', name: 'Bob' },
  { deptCode: 'QA',  role: 'tester', name: 'Charlie' }
];

const usersB = [
  { deptCode: 'DEV', role: 'lead', budget: 50000 },
  { deptCode: 'QA',  role: 'tester', budget: 30000 }
];

// 生成复合标识的辅助函数
const makeCompoundKey = item => `${item.deptCode}#${item.role}`;

// 构造复合键哈希集合
const bCompoundKeys = new Set(usersB.map(makeCompoundKey));

// 快速过滤
const matchedUsers = usersA.filter(item => bCompoundKeys.has(makeCompoundKey(item)));

console.log(matchedUsers);
示例运行输出
[
{ deptCode: 'DEV', role: 'lead', name: 'Alice' },
{ deptCode: 'QA', role: 'tester', name: 'Charlie' }
]
注意:拼接字符串时选用的分隔符(如示例中的
# 或 $$)必须保证在属性值原本的内容中绝不会出现,以避免发生“键碰撞”(例如 dept='a'、role='b_c' 与 dept='a_b'、role='c' 在使用下划线拼接时产生歧义)。若字段内可能包含各类特殊字符,建议采用 JSON.stringify([item.deptCode, item.role]) 来确保严格序列化。
进阶场景二:源数据排重与对象属性合并
在更严苛的数据处理场景中,通常还会面临两个衍生需求:
- 源数组自身去重:若源数组 A 中本身存在多个指定属性相同的对象,常规的
filter会将所有匹配项无差别保留。如果要求交集结果中每个属性值必须唯一,就需要引入排重机制。 - 合并对照对象属性:不仅需要从数组 A 中挑出交集项,还希望顺带把数组 B 对应对象中的扩展属性融合进来。
针对这两个需求,使用 Map 替代 Set 是最佳实践。Map 不仅保留了哈希查询的快速特性,还能以键值对的形式将整个目标对象存储下来便于取用。
const sourceList = [
  { id: 101, name: '产品A-条目1' },
  { id: 101, name: '产品A-条目2' }, // 数组自身含重复 id
  { id: 102, name: '产品B' }
];

const extraList = [
  { id: 101, price: 99.8, stock: 500 },
  { id: 103, price: 150.0, stock: 200 }
];

// 1. 将 extraList 转换为以 id 为键的 Map
const extraMap = new Map(extraList.map(item => [item.id, item]));

// 2. 用 Set 记录已处理过的 id,实现严格去重
const seenIds = new Set();

const mergedIntersection = sourceList
  .filter(item => {
    // 若已被处理,或者不在 extraMap 中,则过滤掉
    if (seenIds.has(item.id) || !extraMap.has(item.id)) {
      return false;
    }
    seenIds.add(item.id);
    return true;
  })
  .map(item => ({
    ...item,
    ...extraMap.get(item.id) // 合并来自 extraList 的属性
  }));

console.log(mergedIntersection);
示例运行输出
[
{ id: 101, name: '产品A-条目1', price: 99.8, stock: 500 }
]
边界防御与通用工具函数封装
在实际工程代码中,为了应对未知输入及潜在的隐式类型缺陷,必须增加以下防御措施:
- 非空与类型防御:源参数可能为
null、undefined或非数组对象;数据项本身可能是null; - 属性解析灵活性:既支持直接传入属性名字符串,也支持传入属性解析函数(类似于 Lodash 的
iteratee); - 数据类型对齐:部分业务接口可能返回字符串类型的
"123",而本地对象使用的是数字123。如果直接放入Set,由于Set内部使用SameValueZero比较,123 !== "123"会导致匹配落空。可根据业务统一做类型归一化。
/**
 * 通用对象数组按属性求交集函数
 * @param {Array} arrayA - 源对象数组
 * @param {Array} arrayB - 对比对象数组
 * @param {string|Function} keyResolver - 属性名称或键值提取函数
 * @param {Object} options - 配置项(如是否严格去重)
 * @returns {Array} 交集结果数组
 */
function intersectBy(arrayA, arrayB, keyResolver, options = {}) {
  // 基础入参防御
  if (!Array.isArray(arrayA) || !Array.isArray(arrayB)) {
    return [];
  }

  // 解析键值提取器
  const getKey = typeof keyResolver === 'function'
    ? keyResolver
    : item => (item && typeof item === 'object' ? item[keyResolver] : undefined);

  // 提取 arrayB 键集合并过滤掉无效键
  const bKeySet = new Set();
  for (const item of arrayB) {
    const key = getKey(item);
    if (key !== undefined && key !== null) {
      bKeySet.add(key);
    }
  }

  const { unique = false } = options;
  const seenKeys = unique ? new Set() : null;

  return arrayA.filter(item => {
    if (!item || typeof item !== 'object') return false;
    const key = getKey(item);
    if (key === undefined || key === null || !bKeySet.has(key)) {
      return false;
    }
    if (unique) {
      if (seenKeys.has(key)) return false;
      seenKeys.add(key);
    }
    return true;
  });
}
测试封装函数的通用调用效果:
const records1 = [{ uid: 'A' }, { uid: 'B' }, { uid: 'B' }, { uid: 'C' }];
const records2 = [{ uid: 'B' }, { uid: 'C' }];

// 1. 按属性名筛选
console.log(intersectBy(records1, records2, 'uid'));
// 2. 按属性名筛选并开启结果去重
console.log(intersectBy(records1, records2, 'uid', { unique: true }));
示例运行输出
// 调用 1 输出:
[ { uid: 'B' }, { uid: 'B' }, { uid: 'C' } ]
// 调用 2 (开启去重) 输出:
[ { uid: 'B' }, { uid: 'C' } ]
总结与方案选型决策
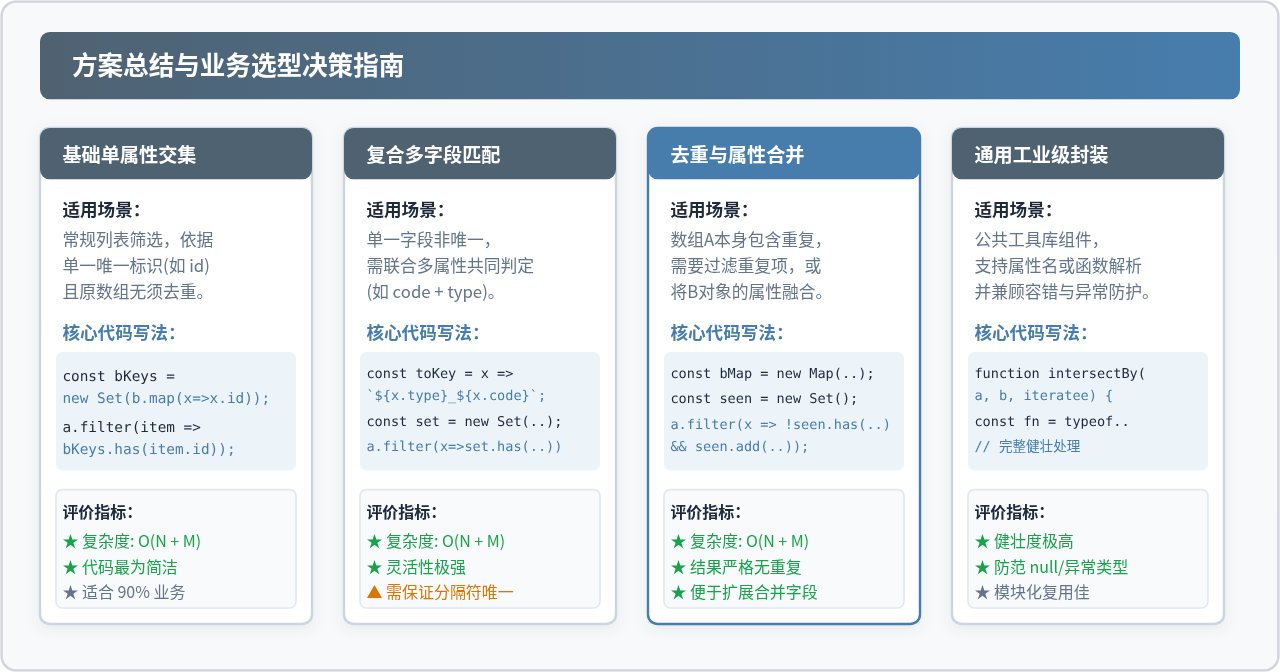
在 JavaScript 中对对象数组按属性求交集,本质是在时间和空间之间做出合理权衡。实际开发中无需引入庞大的外部函数库,根据实际业务特征选择对应策略即可:
- 单一属性且无需去重:直接采用
new Set(b.map(...))搭配a.filter(...),代码量仅需两行,可读性好且性能优异。 - 多属性协同判定:采用复合字符串键
`${key1}_${key2}`构建 Set,低成本解决复合逻辑。 - 需去重或合并对象字段:使用
Map存储对照数据对象,配合seen Set达成去重与字段组装。 - 模块化公用工具:采用封装后的
intersectBy,内置类型校验与空值防护,提供稳健的基础支撑。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章