

针对JavaScript代码混淆后引发的运行时报错与包体积异常膨胀两大痛点,系统拆解AST转换机理,提供五步定位修复工作流、关键参数降额调优策略及分层差异化构建方案。
JS混淆后代码报错或体积过大怎么解决?
作者:极速慢跑
时间:2026-11-17
浏览:100
文章目录
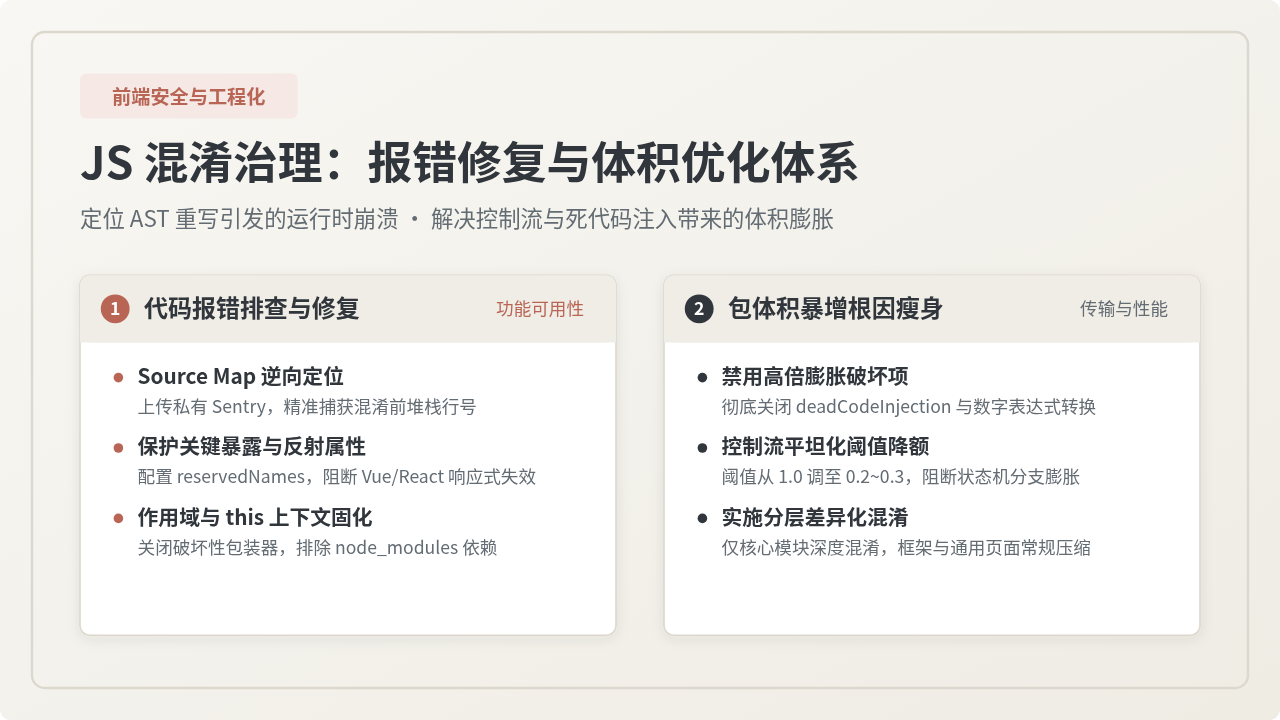
JS代码混淆后出现运行报错或产物体积急剧膨胀,本质上是混淆器对抽象语法树(AST)进行了激进的破坏性重写——重命名了动态依赖的标识符、改变了代码的原生作用域与执行上下文,同时注入了大量状态机和冗余逻辑。解决这一问题的核心路径是:运行时报错通过“锁定问题开关、保留关键属性、隔离第三方库”进行定向修复;体积过大则通过“彻底关闭死代码注入、调低控制流平坦化阈值、仅对核心业务模块进行差异化分层混淆”来实现系统性瘦身。
一、为什么混淆会引发报错与体积失控?
在前端现代构建流程中,标准的压缩工具(如 Terser、esbuild)主要关注在保证 AST 等价语义的前提下消除空格、缩写变量与剔除未引用代码(Tree Shaking)。但专业混淆工具(如 javascript-obfuscator)的目标是制造阅读与逆向障碍。为了达成这一目标,混淆器会执行多项语义变换,这些变换正是稳定性与性能问题的根源:
- 对象属性被暴力重命名破坏反射关系:开启
renameProperties时,混淆器无法识别通过字符串动态访问的属性(如obj["user_id"])或后端接口返回的 JSON 键名,导致运行时取值为undefined,进而引发级联的TypeError: Cannot read properties of undefined。 - 作用域提升与 this 上下文脱敏丢失:控制流平坦化将连续函数代码打散为
switch-case分发结构,原有的闭包引用被提取到外层,导致隐式this绑定丢失,调用 DOM 接口或组件实例方法时报出Illegal invocation。 - 死代码注入引发体积雪崩:开启
deadCodeInjection时,混淆器会强行塞入成百上千个虚假的分支判断、未调用的复杂函数和数学计算,让一个 100KB 的源码瞬间膨胀到 800KB 甚至数兆,彻底摧毁浏览器网络传输与解压缩效率。 - 数字与字符串的过度编码:将常规数字
1转为(0x19a ^ 0x19b),将普通字符串全部提取到全局数组并通过 RC4 加密循环偏移,造成高额运行时解析与内存驻留开销。
二、运行时报错的定向排查与逐项修复
当混淆产物在控制台抛出无从下手的压缩行号异常时,盲目猜测只会增加上线风险。遵循标准化排查工作流,能够在十分钟内准确定位并修复故障。
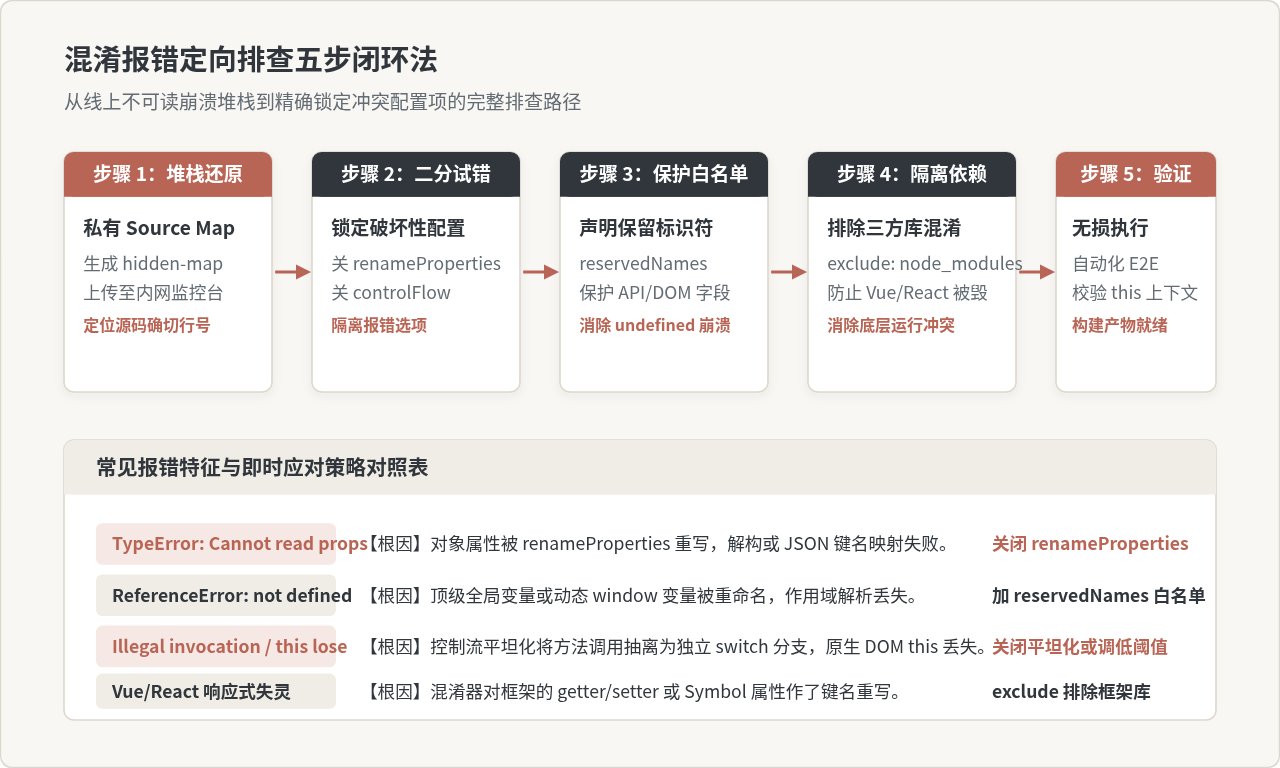
步骤 1:挂载私有 Source Map 还原真实调用栈
排查混淆故障的前提是看到源码行号。很多开发者因为担心泄露代码而彻底关闭 Source Map,导致线上排查彻底失明。正确做法是在构建工具中开启 hidden-source-map。此时产物中不包含 //# sourceMappingURL= 注释,外部浏览器无法探测,但构建系统会输出独立的 .map 文件。将其上传至内网 Sentry 或私有异常监控平台,便可在完全不泄密的前提下秒级还原真实源码出错位置。
步骤 2:采用二分法锁定破坏性混淆参数
在 javascript-obfuscator 中,90% 以上的崩溃由以下四个参数引起。在排查时可临时将其设为 false,观察报错是否消失:
renameProperties:对象属性名混淆(最容易破坏 Vue/React 响应式、DOM 事件绑定与 API 数据)。controlFlowFlattening:控制流平坦化(极易引发this丢失或异步流程执行错序)。deadCodeInjection:死代码注入(偶尔会引入具有作用域副作用的废弃变量)。transformObjectKeys:对象键名重写转换。
步骤 3:配置 reservedNames 与 reservedStrings 保护关键标识
当业务确实需要部分变量混淆但又存在外部交互时,必须显式声明保留白名单。例如前端与后端约定的传输 DTO 字段、挂载到 window 上的全局 SDK 接口名称:
// javascript-obfuscator 保护配置示例
module.exports = {
  compact: true,
  controlFlowFlattening: false,
  renameProperties: false, // 业务层强烈建议关闭属性重命名
  reservedNames: [
    '^on[A-Z].*',        // 保护所有 onInit, onClick 等生命周期与事件钩子
    'userInfo',          // 保护接口实体字段
    'token',
    'myGlobalSdk'        // 保护挂载在 window 上的全局入口
  ],
  reservedStrings: [
    'react.element',     // 保护框架内部标识符
    'application/json'
  ]
};
步骤 4:严格排除第三方依赖(node_modules)
永远不要对 node_modules 中的第三方成熟类库进行二次混淆。Vue、React、Axios、Lodash 本身在发布时已经经过了深度优化与兼容性处理,二次混淆不仅无法增加安全性,反而会破坏框架底层的 Symbol 机制与组件挂载逻辑。在 Webpack、Vite 或 Rollup 中必须严格配置 exclude:
// Webpack 配置过滤规则
const WebpackObfuscator = require('webpack-obfuscator');

module.exports = {
  plugins: [
    new WebpackObfuscator({
      rotateStringArray: true,
      stringArray: true,
      stringArrayThreshold: 0.75
    }, [
      '**/node_modules/**', // 排除所有第三方依赖
      '**/vendor/**'        // 排除内联的基础公共库
    ])
  ]
};
三、产物体积暴增的根因与参数瘦身法则
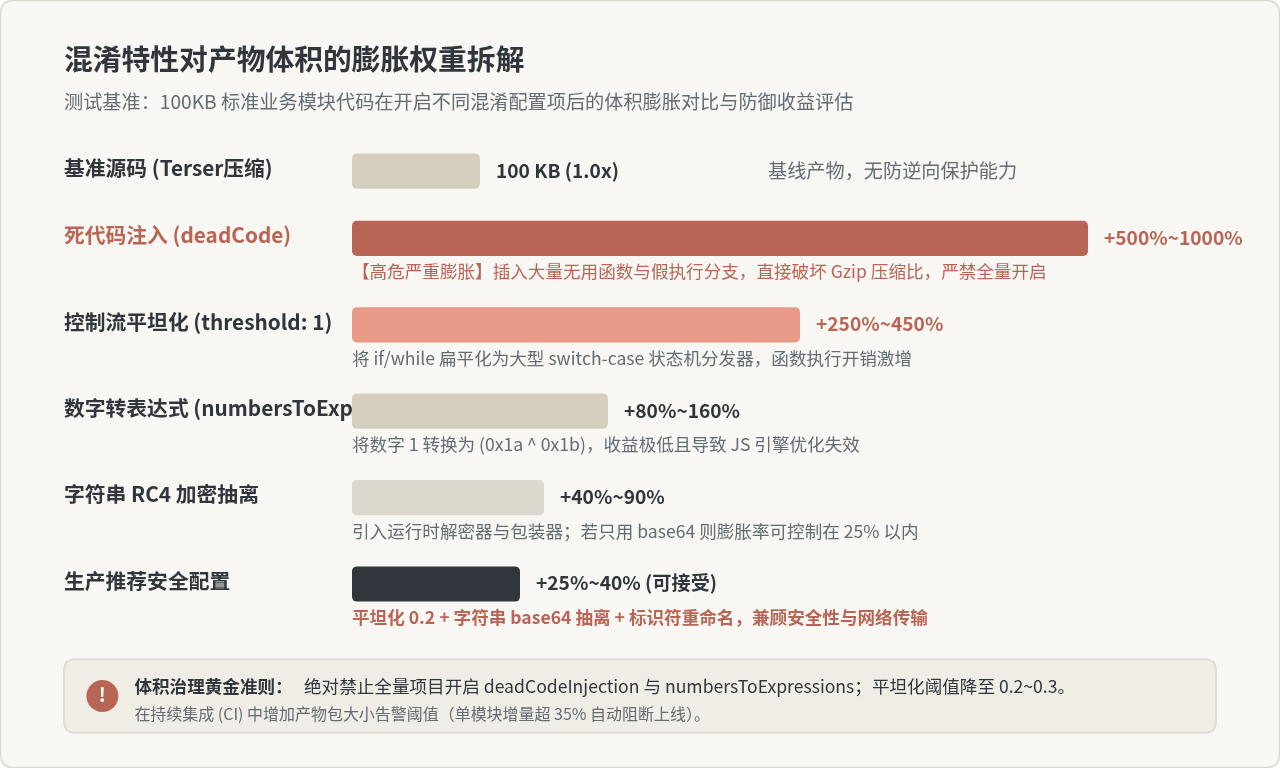
不少团队在接入混淆后发现 Bundle 体积从几百 KB 飙升至数兆,首屏加载时间从 1 秒劣化到 8 秒。这并非不可避免,而是因为开启了高倍膨胀的激进特性。
1. 必须立即关闭的高危膨胀项
- 彻底禁用
deadCodeInjection:死代码注入会在 AST 中无中生有地编造巨量虚假循环和废弃代码块。这些废弃代码之间还存在复杂的依赖关系,导致后续的 Gzip/Brotli 压缩算法无法有效识别重复字节,体积膨胀可达 5~10 倍,必须坚决设置为false。 - 关闭
numbersToExpressions:将数字100拆分成包含异或与位移的长算术表达式对防御逆向破解几乎没有额外实质贡献,但会显著增加词法解析耗时和代码体积,必须保持false。
2. 关键参数的精细化降额平衡
对于确实需要保留的核心混淆特性,应当通过合理的阈值将其限制在性能与体积的黄金分割点:
| 混淆参数 | 高危全量值 | 生产推荐值 | 效果与影响 |
|---|---|---|---|
controlFlowFlatteningThreshold |
1.0 (全量平坦化) | 0.2 ~ 0.3 | 仅平坦化 20%~30% 的核心分支,体积增量从 +400% 骤降至 +30% 以内。 |
stringArrayThreshold |
1.0 (全部抽取) | 0.6 ~ 0.75 | 仅将关键业务字符串抽取到数组,保留常规通用提示字符串。 |
stringArrayEncoding |
['rc4'] | ['base64'] | RC4 解密需要引入额外解码函数运行时并消耗 CPU,base64 兼顾轻量与混淆。 |
splitStrings |
true (chunkLength: 3) | false | 强行按3字符切分字符串会产生海量连接符 +,显著劣化体积。 |
四、工程化落地:生产环境分层差异化混淆
在成熟的工程架构中,绝对不能把整个项目作为一个单一体采用相同强度进行混淆。最健康的前端安全防线应当采用分层治理:
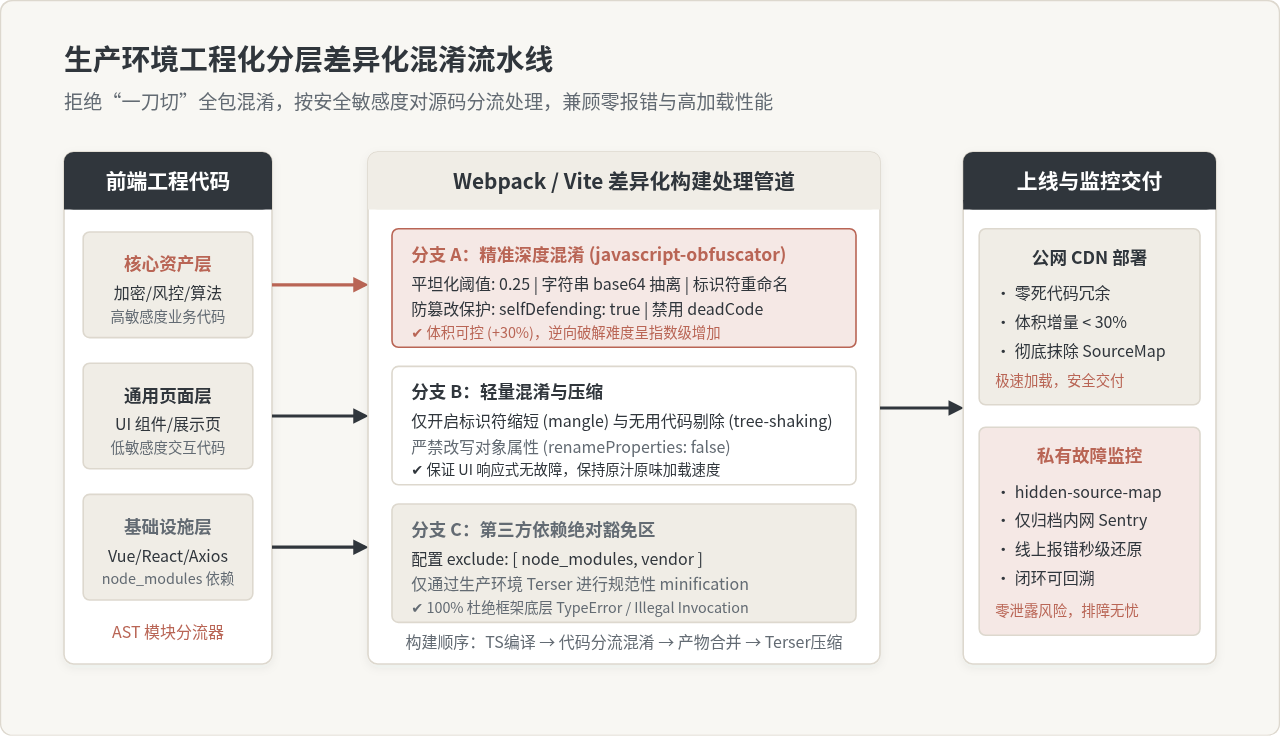
架构分层指导原则
1. 核心资产层(高敏):加解密核心密钥派生、前端签名算法、风控反欺诈指纹采集模块。独立打包为独立 Chunk,开启中度控制流平坦化(0.25)与 selfDefending 内存防篡改。
2. 业务交互层(中敏):常规页面组件、表单验证、UI 渲染逻辑。仅开启常规标识符缩短(Terser)与基础字符串抽离,绝不平坦化,确保 60FPS 渲染性能与零 Bug。
3. 基础设施层(低敏):Vue、React、Pinia、Element Plus 等公共框架。直接排除在混淆器之外,由构建工具标准 Tree-shaking 压缩。
Vite 生产环境差异化配置示例
在 Vite 项目中,可通过 rollup-plugin-javascript-obfuscator 并结合 filter 钩子实现精准按文件路径定向混淆:
import { defineConfig } from 'vite';
import vue from '@vitejs/plugin-vue';
import obfuscator from 'rollup-plugin-javascript-obfuscator';

export default defineConfig({
  plugins: [
    vue(),
    obfuscator({
      include: ['src/security/**/*.js', 'src/crypto/**/*.ts'], // 仅混淆核心资产代码
      exclude: [/node_modules/, 'src/views/**'],               // 豁免通用视图与依赖
      options: {
        compact: true,
        controlFlowFlattening: true,
        controlFlowFlatteningThreshold: 0.25,
        deadCodeInjection: false,            // 坚决关闭死代码
        numbersToExpressions: false,         // 坚决关闭数字运算
        simplify: true,
        stringArray: true,
        stringArrayEncoding: ['base64'],
        stringArrayThreshold: 0.7
      }
    })
  ],
  build: {
    sourcemap: 'hidden', // 输出私有映射文件,不在 bundle 中暴露 url
    minify: 'terser',
    terserOptions: {
      compress: {
        drop_console: true,
        drop_debugger: true
      }
    }
  }
});
五、验证与上线防劣化核对清单
为了防止在版本迭代过程中混淆配置被无意修改或引发新的隐蔽故障,应建立自动化防御卡口与发布核对机制。
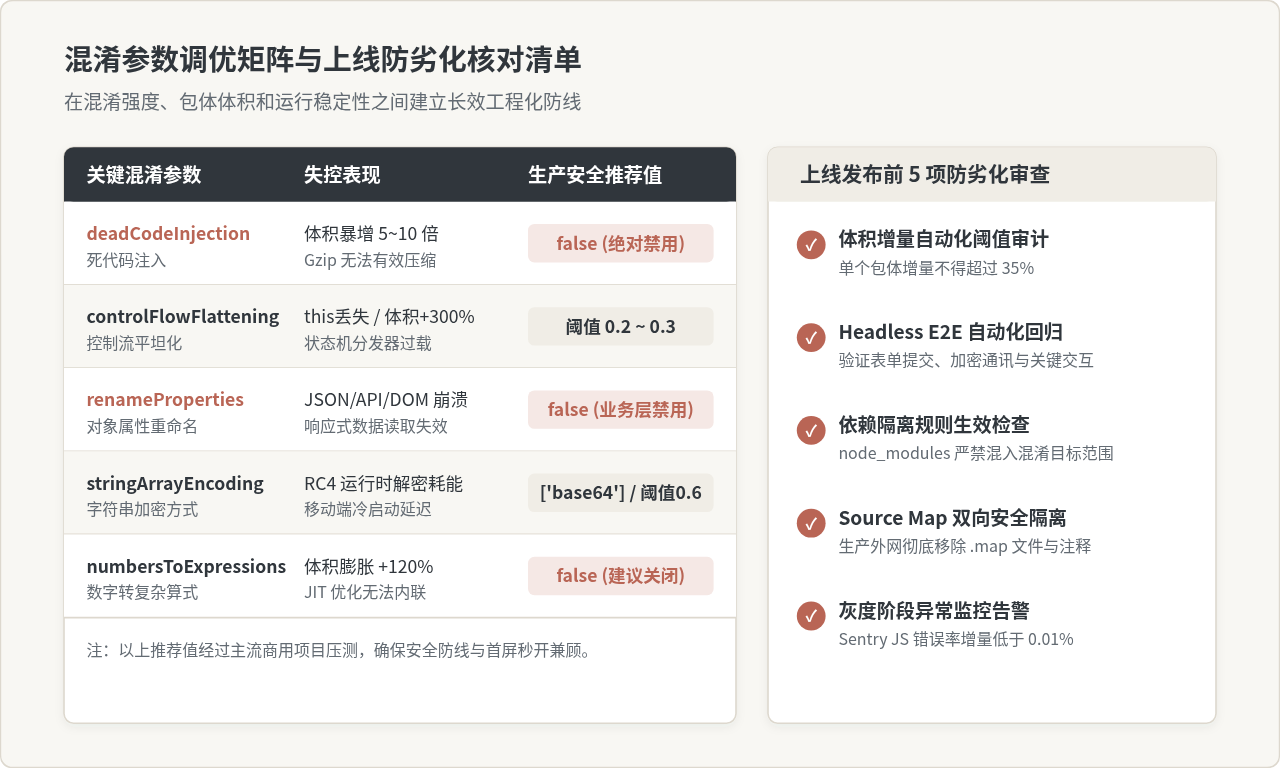
1. CI/CD 构建体积自动化阻断阈值
在持续集成流水线中编写简单的比对脚本:比对未开启混淆分支与开启混淆分支的最终 dist 产物体积。设定红线规则——若核心模块体积膨胀率超过 35%,或整体静态资源体积增长超过 15%,CI 自动化构建直接报错阻断,促使开发者检查是否误开了死代码或高额平坦化。
2. 发布前五项必查清单
- 依赖隔离确认:检查构建输出报告,确认
node_modules打包产物(如vendor.js)中的标准函数未被破坏性重命名。 - 自动化 E2E 烟雾测试:利用 Playwright 或 Puppeteer 在无头浏览器中运行核心业务闭环(如用户登录、下单结算、加密数据上传),验证无控制台未捕获异常。
- Source Map 隔离清点:上线部署脚本中执行自动化清理,确认所有
.map文件已同步上传至私有监控系统(如 Sentry/Bugsnag),并在公网 CDN 上彻底删除,防止源码直接外泄。 - 灰度发布监控:采用 5% 灰度放量机制,重点观察线上新版 JS 报错率(Error Rate)指标,若出现未定义的属性访问异常即刻回滚。
- 关键参数固化:确保配置文件纳入版本控制,代码审查中将
deadCodeInjection、renameProperties变更列为高风险变更项。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章