

深入解析前端在浏览器端导出万级至十万级数据 Excel 时的性能瓶颈成因,系统讲解格式选型、Web Worker 线程解耦、分块流式生成与零拷贝落盘的实战优化策略。
JS 前端导出万级数据 Excel 的性能优化策略
作者:极速慢跑
时间:2026-11-17
浏览:97
文章目录
前端性能优化 · 核心实战
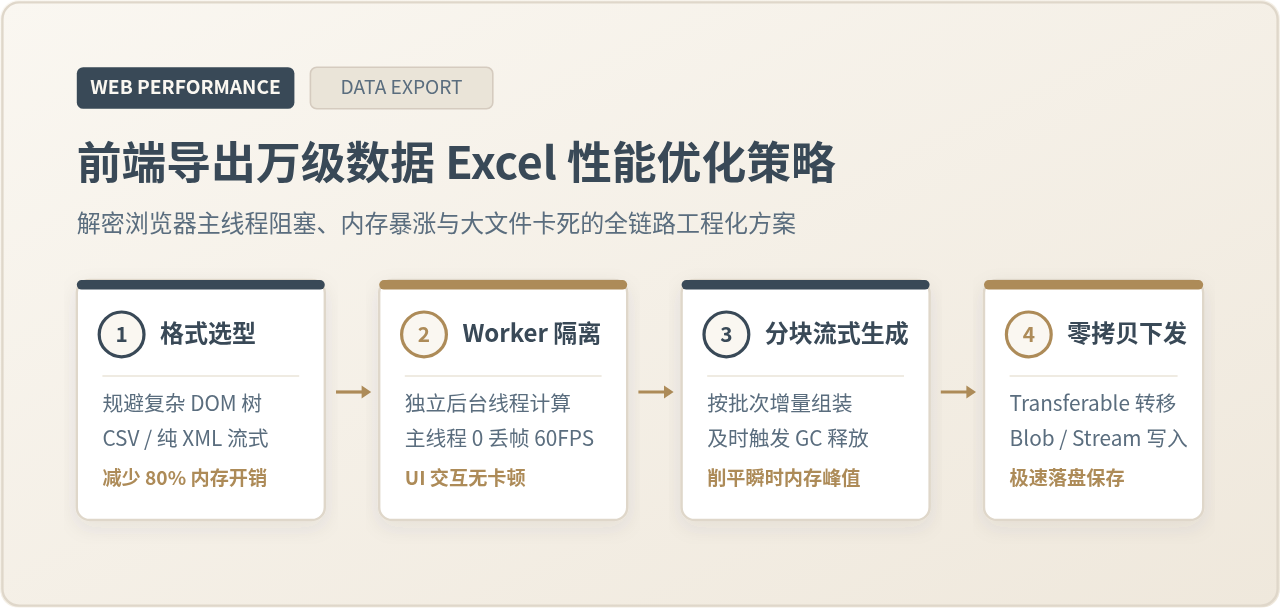
图 0:前端万级数据 Excel 高性能导出架构概览
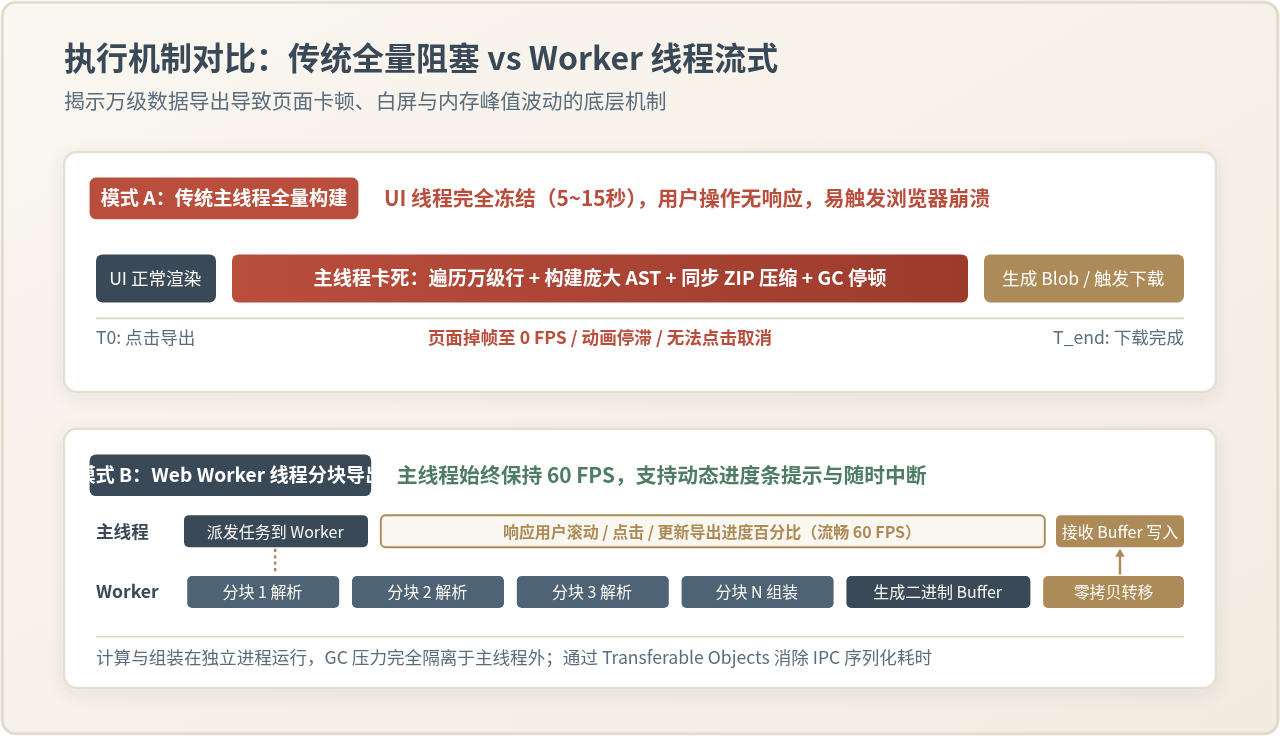
图 1:传统主线程阻塞模式与 Web Worker 流水线导出机制的时序对比
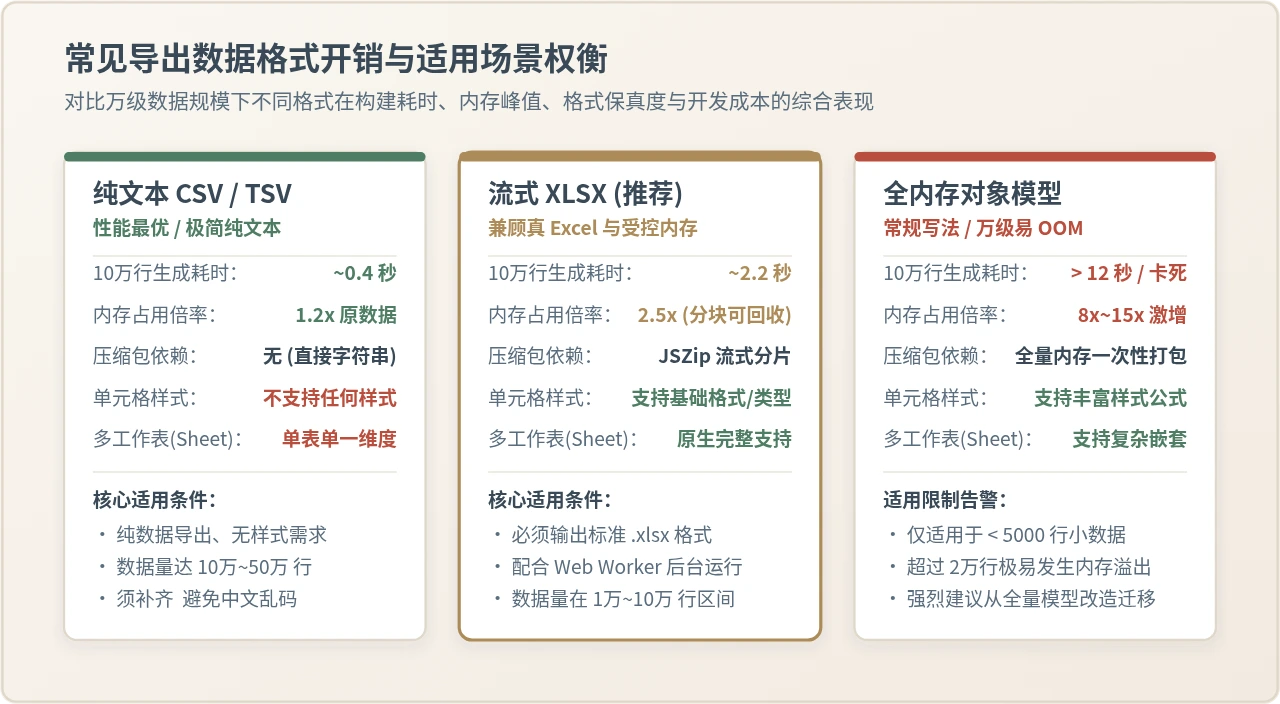
图 2:不同导出格式在耗时、内存倍率与功能支持上的量化对比
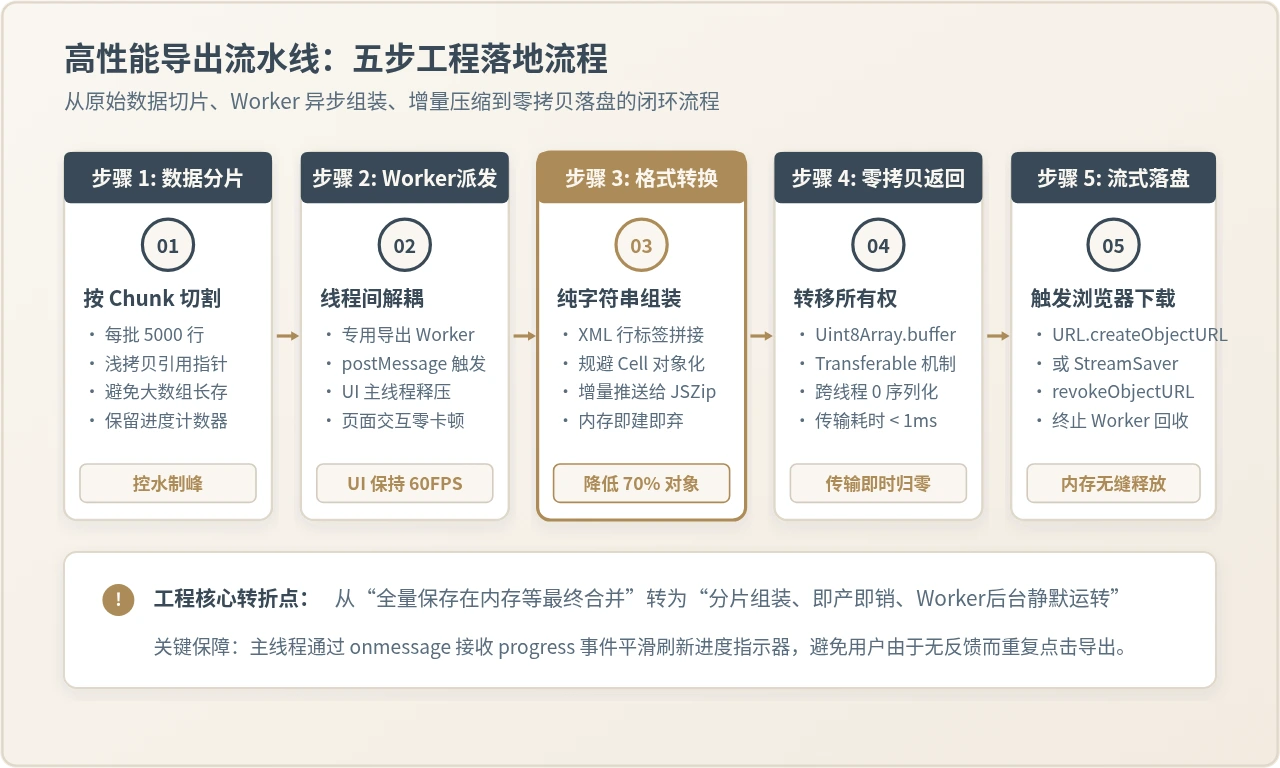
图 3:高性能导出流水线的五步工程化闭环执行流
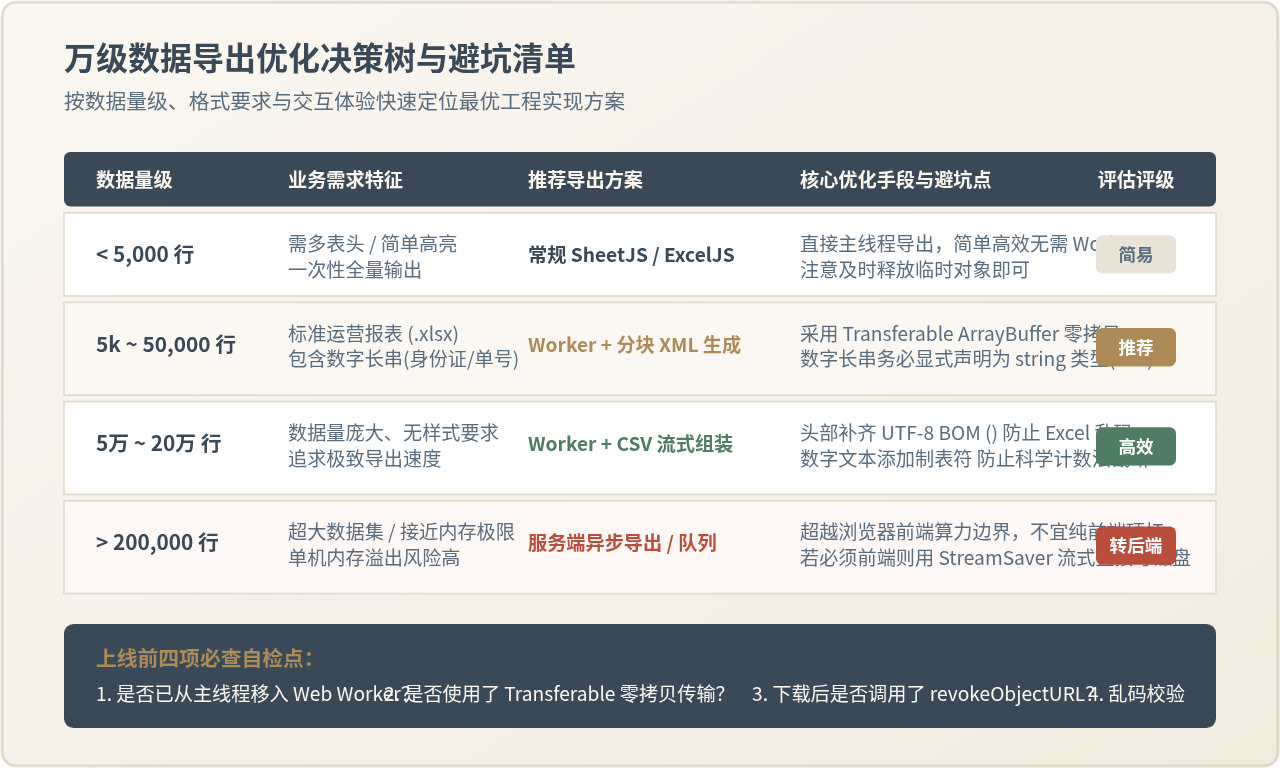
图 4:万级数据导出架构决策树与核心上线自检清单
前端导出几十条数据时,常规写法几毫秒内便可完成;但当数据量攀升至 1 万到 10 万行时,浏览器主线程往往会瞬间卡死数秒乃至数十秒,伴随着页面掉帧、用户操作无响应,严重时直接触发浏览器内存崩溃(Out of Memory)。要在纯前端优雅且高效地导出万级数据,核心在于实施四维流水线改造:格式合理选型控制基础体量、Web Worker 剥离主线程密集计算、分块增量组装削平内存波峰,以及使用 Transferable Objects 实现零拷贝下发。
一、万级数据导出的核心瓶颈与耗时根源
许多开发者在初次遇到万级数据导出需求时,通常沿用小数据量时封装的工具函数,例如直接调用社区常用的导出库,传入完整的二维数组或 JSON 列表,调用一次写入方法后直接生成 Blob 并下载。在数据量只有几百行时,这种方式直观简便;但一旦数据突破数万行,浏览器便会出现严重的操作停滞。造成这种现象的深层原因主要包含以下三个方面:
- 主线程执行与渲染引擎互斥:浏览器的 JavaScript 引擎与 GUI 渲染线程在同一个事件循环中共享执行权。传统导出逻辑包含全量数据深拷贝、字符串模板转换、XML 树构建及庞大 ZIP 压缩包的打包,这些计算密集型任务长时间独占主线程,导致浏览器无法响应任何用户输入事件,造成 0 FPS 的死锁假死状态。
-
内存对象指数级膨胀:标准的
.xlsx格式本质上是一个符合 OpenXML 规范的压缩包,内部包含多个由 XML 节点构成的表结构文件(如sheet1.xml、sharedStrings.xml等)。当在内存中将万级数据转化为完整的工作表 AST(抽象语法树)或庞大对象树时,所消耗的堆内存往往是原始 JSON 数据的 8 到 15 倍。 - 频繁触发 V8 Major GC 停顿:在同步大循环中短时间内创建数百万个微小的单元格对象,会瞬间填满 V8 引擎的新生代内存空间,迫使引擎频繁进行晋升判定并触发代价高昂的全局垃圾回收(Full GC)。GC 带来的“Stop-The-World”效应与循环计算交替发生,使整个耗时成倍延长。
二、方案选型与格式权衡:CSV、轻量 XLSX 与全量模型
在着手优化代码执行之前,首先需要明确业务场景对导出文件格式的真正诉求。很多时候,业务方仅要求“能用 Excel 正常打开并查看数据”,并不强制需要复杂的公式、多工作表或自定义单元格底色。选对目标文件格式,往往能够直接削减 70% 以上的运算和内存负担。
1. 纯文本 CSV / TSV:极致性能首选
如果导出仅为数据归档、清单核对或后续数据导入,CSV 格式是性能最优解。它不需要任何 ZIP 压缩开销,也不需要构建复杂的 XML 节点,本质上就是带有特定分隔符的纯文本流。在万级数据规模下,JavaScript 处理纯文本字符串拼接的效率极高,处理 10 万行数据通常可以在 400 毫秒以内完成。
生产避坑要点:UTF-8 BOM 与科学计数法
直接导出的 CSV 在 Windows 系统下的 Microsoft Excel 打开时,中文极易出现乱码。这是因为 Excel 默认使用本地编码识别文本。解决办法是在文件开头显式插入 UTF-8 BOM 字符标识()。另外,针对身份证号、订单流水号等长数字,需在字符串前后添加半角制表符 ,防止 Excel 默认以科学计数法显示导致末尾精度丢失。
2. 流式 OpenXML (.xlsx):兼顾真实 Excel 格式与内存控制
若业务强制要求生成 .xlsx 格式,应规避传统将整个工作簿保持在内存中的全量对象模型,转为基于模板的流式 XML 片段写入。一个标准的 .xlsx 文件主体是压缩包内的 xl/worksheets/sheet1.xml。通过流式行构建器逐行产出形如 <row r="1"><c t="inlineStr"><is><t>值</t></is></c></row> 的 XML 片段,并直接流式喂给压缩器,无需在内存中维护全量对象。
三、架构重构:基于 Web Worker 的计算隔离与零拷贝传输
要彻底消除导出期间的页面卡顿感,必须将所有耗时的运算与文件组装移出主线程。HTML5 提供的 Web Worker 允许在独立的后台线程中执行脚本。主线程只负责接收导出指令、展示带有动态百分比的遮罩层,而数据切分、XML 组装、压缩包打包等重负载工作全部在 Worker 线程内部完成。
消除通信瓶颈:Transferable Objects(可转移对象)
常规的 Worker 通信使用 postMessage(data),底层采用结构化克隆算法(Structured Clone)。当传递的数据体积达到几十兆时,内存复制本身就会引发数以百毫秒计的主线程卡顿。
为实现真正的高性能传输,在 Worker 完成二进制打包后,应将其转化为 ArrayBuffer,并通过 postMessage([buffer], [buffer]) 的形式将内存所有权直接转移给主线程。转移过程仅传递内存指针,传输耗时通常小于 1 毫秒,且不会产生双倍内存占用。
核心示例代码:主线程与 Worker 调度实现
以下示例展示了如何在项目中通过内联 Blob Worker 或独立 Worker 脚本构建隔离式导出流水线:
// 1. main.js:主线程控制器
export async function exportBigExcel(rawList, filename = '万级数据导出.xlsx') {
  return new Promise((resolve, reject) => {
    // 实例化专用 Worker(支持本地文件或 Blob URL)
    const worker = new Worker(new URL('./export.worker.js', import.meta.url), {
      type: 'module'
    });

    // 监听 Worker 派发的消息
    worker.onmessage = (event) => {
      const { type, progress, buffer, error } = event.data;

      if (type === 'PROGRESS') {
        // 平滑更新 UI 进度指示器,主线程维持 60 FPS
        updateExportProgressBar(progress);
      } else if (type === 'SUCCESS') {
        // 接收通过零拷贝转移过来的 ArrayBuffer
        const blob = new Blob([buffer], {
          type: 'application/vnd.openxmlformats-officedocument.spreadsheetml.sheet'
        });

        // 触发浏览器直接保存
        const downloadUrl = URL.createObjectURL(blob);
        const link = document.createElement('a');
        link.href = downloadUrl;
        link.download = filename;
        document.body.appendChild(link);
        link.click();

        // 必须及时回收对象 URL 并终止 Worker,释放内存
        setTimeout(() => {
          URL.revokeObjectURL(downloadUrl);
          link.remove();
          worker.terminate();
        }, 1000);

        resolve();
      } else if (type === 'ERROR') {
        worker.terminate();
        reject(new Error(error));
      }
    };

    // 向 Worker 发送待处理数据
    worker.postMessage({
      type: 'START_EXPORT',
      data: rawList
    });
  });
}
// 2. export.worker.js:后台 Worker 执行上下文
self.onmessage = async (e) => {
const { type, data } = e.data;
if (type !== 'START_EXPORT') return;
try {
const CHUNK_SIZE = 5000;
const totalRows = data.length;
let processedRows = 0;
// 采用轻量 XML 行生成器(伪代码核心段)
const xmlRows = [];
xmlRows.push('<?xml version="1.0" encoding="UTF-8"?>');
xmlRows.push('<worksheet xmlns="http://schemas.openxmlformats.org/spreadsheetml/2006/main"><sheetData>');
// 分批次处理,避免单个同步循环占用 Worker 执行栈过久
for (let i = 0; i < totalRows; i += CHUNK_SIZE) {
const chunk = data.slice(i, i + CHUNK_SIZE);
for (let r = 0; r < chunk.length; r++) {
const rowData = chunk[r];
const rowIndex = i + r + 1;
let rowXml = `<row r="${rowIndex}">`;
// 使用 inlineStr 避免维护全局 sharedStrings.xml
for (let col = 0; col < rowData.length; col++) {
const cellVal = String(rowData[col] ?? '');
rowXml += `<c t="inlineStr"><is><t>${escapeXml(cellVal)}</t></is></c>`;
}
rowXml += '</row>';
xmlRows.push(rowXml);
}
processedRows += chunk.length;
// 定期向主线程同步进度
self.postMessage({
type: 'PROGRESS',
progress: Math.floor((processedRows / totalRows) * 80) // 0~80% 为生成阶段
});
}
xmlRows.push('</sheetData></worksheet>');
// 使用 JSZip 生成压缩工作簿
const zip = new JSZip();
setupWorkbookStructure(zip, xmlRows.join(''));
// 流式压缩打包为 Uint8Array
const uint8Array = await zip.generateAsync({
type: 'uint8array',
compression: 'DEFLATE',
compressionOptions: { level: 4 } // 权衡速度与压缩率,推荐 4~6
}, (metadata) => {
self.postMessage({
type: 'PROGRESS',
progress: 80 + Math.floor(metadata.percent * 0.2) // 80~100% 为压缩阶段
});
});
// 关键优化:使用 Transferable 零拷贝传回 ArrayBuffer
const buffer = uint8Array.buffer;
self.postMessage({
type: 'SUCCESS',
buffer: buffer
}, [buffer]); // 注意第二个参数传递所有权
} catch (err) {
self.postMessage({ type: 'ERROR', error: err.message });
}
};
function escapeXml(str) {
return str.replace(/[<>&'']/g, (c) => {
switch (c) {
case '<': return '<';
case '>': return '>';
case '&': return '&';
case ''': return ''';
case '"': return '"';
}
});
}四、内存平抑:分块流式生成与磁盘持久化
即便使用了 Web Worker,如果一次性将 10 万行完整数据拼装为一个上百兆的单体字符串,依然可能在 Worker 内部触发 V8 堆内存溢出(在 32 位浏览器或受限移动端环境下,堆上限通常仅有 1GB 左右)。因此,分块流式(Chunked Streaming)是保持低内存占用的核心手段。
1. 分块节流与即建即弃
在遍历原始数据集时,以 5,000 ~ 10,000 行为一个分块(Chunk)。每次拼接出当前块的文本或二进制段后,立即将其写入底层的流式收集器中,并主动切断对局部变量的引用,使新生代垃圾能够在下一次循环前被回收。
2. 突破 Blob 内存上限:StreamSaver.js 与 File System Access API
浏览器中创建 new Blob([buffer]) 时,数据仍然驻留在浏览器的虚拟内存中。如果数据体量突破 50 万行或文件尺寸超过 500MB,分配单块连续内存会面临极高的失败率。
对于这种超大数据集场景,推荐采用流式落盘方案:
-
现代标准:File System Access API (
showSaveFilePicker):现代 Chromium 浏览器支持直接获取磁盘文件的可写流句柄(FileSystemWritableFileStream),Worker 生成一个分片即可通过writer.write(chunk)直接刷入磁盘,内存占用始终恒定在极低的水平。 - 跨浏览器兼容:StreamSaver.js:利用 Service Worker 拦截浏览器下载流的特性,模拟出一个 HTTP 边下载边存盘的过程,使浏览器直接将内存块流向磁盘文件,规避单次生成几百兆 Blob 的内存硬壁垒。
五、生产环境避坑指南与极限性能实践
在前端导出落地的过程中,细节处理决定了方案的健壮度。以下是生产环境高频出现的典型问题及标准化解决方案:
1. 禁用全局共享字符串池(SharedStrings)
标准 Excel 规范推荐将重复字符串抽离到 sharedStrings.xml 中建立字典索引以节省磁盘体积。但对于前端导出万级数据而言,维护这个全局字典需要在内存中常驻庞大的 Map/Hash 结构,查找与维护键名的 CPU 消耗极大。
性能策略:在生成单元格时,统一使用内联字符串格式(<c t="inlineStr"><is><t>内容</t></is></c>),虽然生成的 .xlsx 压缩包会稍微增大 5%~10%,但可以省去全量字典检索,生成速度提升 40% 以上。
2. 压缩等级权衡
在调用 JSZip 或其他打包工具时,默认的压缩等级通常为 6 或 9。对于结构规律的 XML 纯文本,过高的压缩等级带来的体积缩减极小(仅缩减 3%~5%),却会导致 CPU 压缩耗时翻倍。
性能策略:在生产环境中将压缩等级设置为 level: 4,在压缩率与压缩吞吐量之间取得最优平衡点。
3. 及时撤销 Blob URL 防止内存泄漏
通过 URL.createObjectURL(blob) 创建的引用会常驻在浏览器的内存管理表中,直到当前文档卸载(页面刷新或关闭)。单页面应用(SPA)中如果用户多次执行大文件导出,累积的 Blob 会迅速吃光客户端可用内存。
性能策略:在模拟触发 <a> 标签点击完成下载后,务必通过 setTimeout 显式调用 URL.revokeObjectURL(url) 将其销毁。
六、总结
在前端实现万级数据 Excel 导出,核心不是寻找某一个“万能第三方库”,而是从线程分配、内存模型、格式特征与 I/O 传输四个层面对传统同步方案进行解耦重构:
- 优先厘清业务真实诉求:如果仅需数据归档,首选带 BOM 的 CSV 纯文本流,耗时处于百毫秒级;
- 如果必须提供带网格与标准扩展名的
.xlsx报表,坚决放弃在主线程进行全量构建,采用 Web Worker 承接密集运算; - 在 Worker 内部摒弃笨重的全量 DOM 对象模型,采用分块(5000行/批)轻量 XML 字符串流式组装,并采用内联字符串(inlineStr)替代共享字典;
- 利用 Transferable Objects 将生成的二进制
ArrayBuffer零拷贝转移至主线程,并配合URL.revokeObjectURL完成内存闭环回收。
通过实施上述分层优化策略,前端即可在保持 60 FPS 丝滑交互和清晰进度反馈的前提下,稳定导出万级乃至十万级数据的 Excel 文件。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章