

深入解析纯前端JavaScript导出大型Word文档时的性能瓶颈与OOM崩溃根源,提供基于任务分片、Web Worker隔离计算、流式写盘及对象生命周期回收的完整优化方案与工程落地代码。
纯前端js导出word大文件性能优化:分片处理与内存管理
作者:极速慢跑
时间:2026-11-16
浏览:633
文章目录
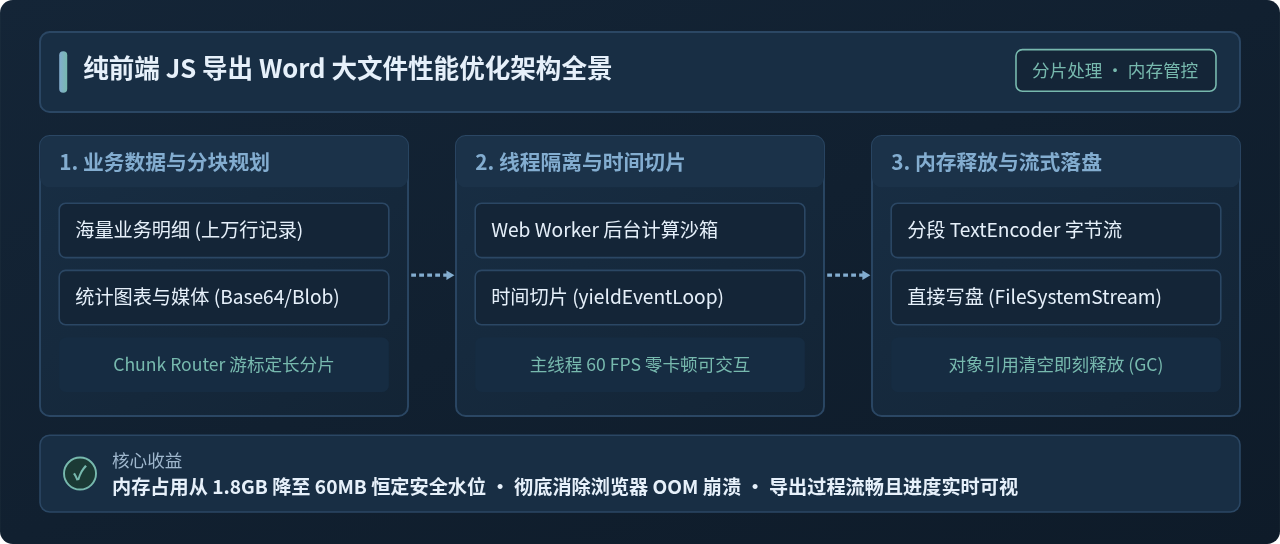
假设在企业后台的报表中心,你需要纯前端将一份长达三千页的年度审计清单或包含上万行嵌套明细的数据集导出为 Word (.docx) 文件。当用户点击“立即导出”按钮后,页面通常会迅速陷入假死状态,加载转圈动画直接停滞,几秒钟后浏览器弹窗提示“页面无响应”或标签页直接闪退崩溃(提示 Error code: Out of Memory)。这一故障的根源在于:传统导出方案在主线程中一次性构造整颗包含数十万个节点的 DOM/AST 语法树,随后在内存中强行拼接数百万字符的巨大 XML 字符串,最后再由压缩库全量打包为单个庞大 Blob。整套流程导致 V8 堆内存瞬时飙升数倍,极易冲破浏览器单标签页的内存配额。
解决纯前端大文件导出的确定路径在于两项核心改造:基于数据分片与 Web Worker 彻底剥离主线程的重度计算,以及采用分块流式持久化(Streaming Save)配合严格的对象生命周期释放机制消灭内存中间冗余。本文将针对纯前端导出 Word 大文件的性能瓶颈,从底层原理、分片流水线设计、流式写盘到内存管理细节进行完整拆解并提供可落地的工程代码。
一、根因剖析:为什么纯前端导出 Word 会把内存撑爆?
在着手优化之前,需要先从底层看清 Word 文档的文件本质以及现代浏览器对内存与线程的处理机制。
标准 Word (.docx) 文件本质上是一个基于 Open Packaging Conventions 的 ZIP 归档压缩包。解压任意 .docx 文件后,内部包含 [Content_Types].xml、描述文档间依赖的 _rels/ 目录,以及最为核心的 word/document.xml 正文描述文件。在动辄上千页的文档中,document.xml 往往占据了整个解压体积的 95% 以上。
内存倍增陷阱:如果一个生成的文档解压后 document.xml 文本大小为 150MB,使用常规库(如 docx.js 或 docxtemplater)在内存中同步构建时,所消耗的 V8 堆内存绝不仅是 150MB,而是往往超过 1.5GB 甚至 2GB,导致内存雪崩。
造成这种几倍甚至十几倍内存膨胀的核心原因有四点:
- 巨大的中间对象树(AST 开销):通用库倾向于面向对象封装,每一个段落
<w:p>、行<w:tr>、单元格<w:tc>乃至文本片段<w:t>都会实例化为一个包含原型链、样式属性和事件槽的独立 JavaScript 对象。5 万行表格会瞬间产生上百万个细碎对象,单这些对象的堆引用就能占满上百兆内存。 - 不可变字符串拼接的反复分配:JavaScript 中的字符串是不可变的。当全量将对象树序列化拼接为一个超长 XML 字符串时,连续的字符串相加会产生大量的临时子字符串与垃圾回收标记,频繁诱发 V8 引擎的全量垃圾回收(Full GC),导致 CPU 占用率 100%。
- JSZip 全量缓冲生成 Blob:常规流程会将所有生成的 XML 文本一次性喂给 JSZip,JSZip 内部将文本解码成 Uint8Array 并缓存在内存压缩字典中,最后通过
generateAsync({type: 'blob'})再次分配一大块连续内存生成最终 Blob。此时,原始数据、DOM 对象树、XML 巨型字符串、压缩内部块以及最终 Blob 五者同时驻留在内存中,内存瞬时峰值达到极限。 - 主线程 Event Loop 饥饿:由于所有计算密集型代码都在浏览器的 JavaScript 单线程执行,漫长的同步遍历独占了主线程,浏览器既无法执行微任务渲染帧(导致 60 FPS 骤降为 0 FPS),也无法接收用户点击取消操作,进而被浏览器内核 watchdog 机制判定为死锁弹窗。
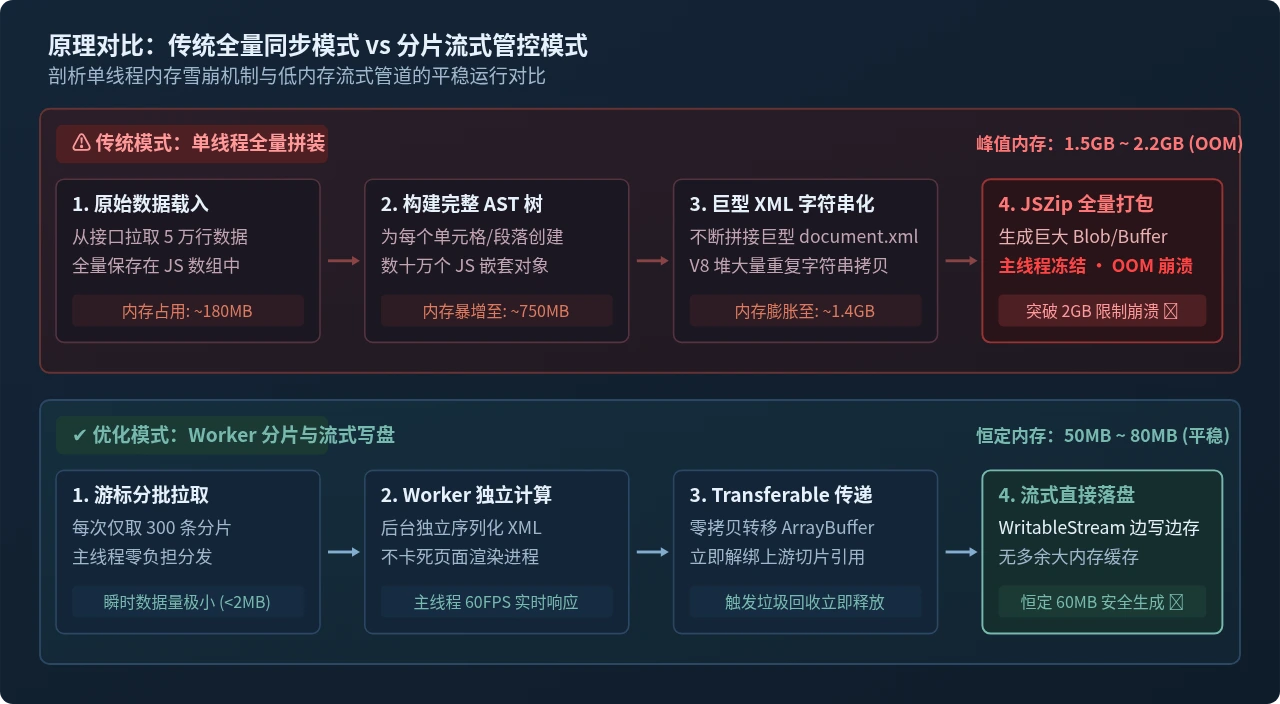
二、计算解耦:Web Worker 线程隔离与时间切片
优化纯前端大文件导出的第一道防线,是将所有“耗 CPU、产字符串”的计算逻辑从浏览器主线程中完全剥离。UI 主线程必须仅负责渲染交互和分发指令,其余工作由后台独立线程完成。
1. 主线程与 Worker 职责边界
通过创建独立的 Web Worker 实例,主线程与后台线程建立清晰的职责边界:
- 主线程职责:负责调起文件保存对话框(获取文件流句柄)、读取或分发分页数据、根据 Worker 发出的进度事件平滑更新 UI 进度条、监听用户的“取消”按钮。
- Worker 线程职责:接收分批数据片段,在沙箱环境中完成 OpenXML 模板渲染、局部表格行与单元格拼装、分段将字符串转换为
Uint8Array字节流。
2. 时间切片(Time Slicing)与异步让渡
即便是将部分逻辑保留在主线程或 Worker 内部循环处理,也不能使用单一的 for 循环一次性跑完几万条记录。必须引入时间切片机制,在批次处理间隙主动将控制权交还给事件循环(Event Loop):
// 异步让出主线程控制权,给浏览器渲染引擎预留排版重绘窗口
function yieldEventLoop() {
  if (typeof scheduler !== 'undefined' && scheduler.yield) {
    return scheduler.yield(); // 现代浏览器原生调度优先
  }
  return new Promise((resolve) => setTimeout(resolve, 0));
}
通过每处理固定数量(例如 300 条)的记录后 await yieldEventLoop(),主线程的帧率可以稳固维持在 55~60 FPS,页面上的导出进度百分比、动态脉冲动画始终流畅,用户随时可以点击取消。
3. Transferable Objects 零拷贝传输
在主线程与 Worker 之间通信时,如果直接传递庞大的对象数组或字符串,浏览器的 postMessage 默认会使用结构化克隆算法(Structured Clone),在目标线程深拷贝一份完整副本,这等于在瞬间使内存占用再次翻倍。
正确的做法是:Worker 将每批序列化好的数据直接编码为 Uint8Array,并在调用 postMessage(message, [transferable]) 时,将该 ArrayBuffer 加入传输列表。如此一来,内存所有权直接转移,不会发生任何数据拷贝,传输耗时近乎为零,发送端的 Buffer 随即脱落,立即解除内存占用。
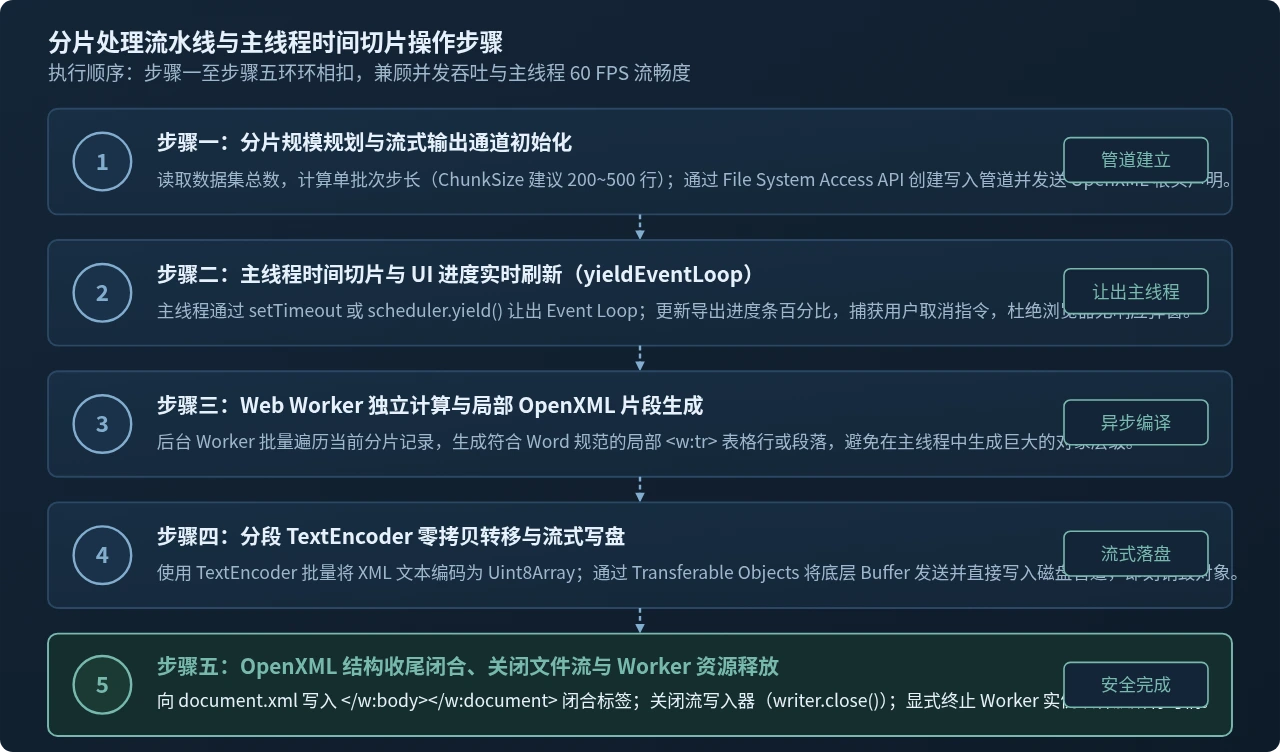
三、内存精细化管理:流式落盘与对象生命周期闭环
将计算移到 Worker 并做好切片只是解决了“页面卡死”的问题;若最终还是要把数百万行的数据拼接为一个数百兆的巨大 Blob,在低配机器上依然会遇到内存溢出。真正彻底解决内存压力的关键,在于分块流式持久化落盘(Streaming Save)与严格的对象生命周期释放。
1. 告别巨型 Blob:边生成边写盘
传统前端下载文件通常使用 URL.createObjectURL(blob) 配合 <a download> 标签。这种方式的前提是整个文件已经在客户端内存中完整生成为一个完整的 Blob 对象。当文件达到 300MB~500MB 时,移动端或内存紧张的设备极易崩溃。
在现代浏览器中,应当优先使用 File System Access API(window.showSaveFilePicker)。该 API 允许在导出之初让用户选择保存路径,直接拿到可写流句柄 FileSystemWritableFileStream。随后,无论生成多少批次,每一批通过 writer.write(chunk) 直接写入客户端本地磁盘,内存中永远只驻留当前正在写入的几个 KB 或 MB 的切片缓冲区。写入完成后调用 writer.close(),整个过程的内存占用与最终文件大小完全解耦,即便导出 1GB 大小的文档,内存水位也可恒定保持在 60MB 以内。
兼容性考量:在不支持 File System Access API 的浏览器(如 Firefox 或旧版 Safari)中,可采用 StreamSaver.js 作为优雅降级方案,其内部利用 Service Worker 模拟 HTTP 流式响应并交由浏览器下载器接管,同样无需在 JavaScript 内存中驻留完整文件。
2. Word 容器内部的结构解耦与针对性治理
回顾前文所述的 .docx 组织结构,我们针对 ZIP 容器内的不同文件采取精细化的内存处理策略:
- 针对
word/document.xml:放弃任何巨型字符串拼接。使用分块TextEncoder对局部模板产生的 XML 片段分段编码为二进制字节。前置写入<w:document ...><w:body>,流式追加所有行块,最后末尾闭合</w:body></w:document>。 - 针对
word/media/(内嵌图表与图片):图片是内存消耗大户。如果一个文档插入了上百张统计截图,切忌把所有图片以 Base64 字符串形式长久保存在数组中。应将图片通过canvas.toBlob()转为二进制 Buffer 写入 Zip 包中,写入完成后立即将原始变量赋值为null,对于生成的临时预览地址必须显式调用URL.revokeObjectURL(url),防止浏览器底层 C++ 媒体缓存池滞留。 - 针对
word/styles.xml:严禁在每一行、每个单元格上内联重复的大段样式 XML 代码(例如字体系列、颜色、间距等)。应在styles.xml中统一定义轻量的全局样式 Class ID,在document.xml正文中仅使用<w:pStyle w:val="MyCustomStyle"/>引用。这一项优化可直接将正文 XML 文本精简 60% 以上。
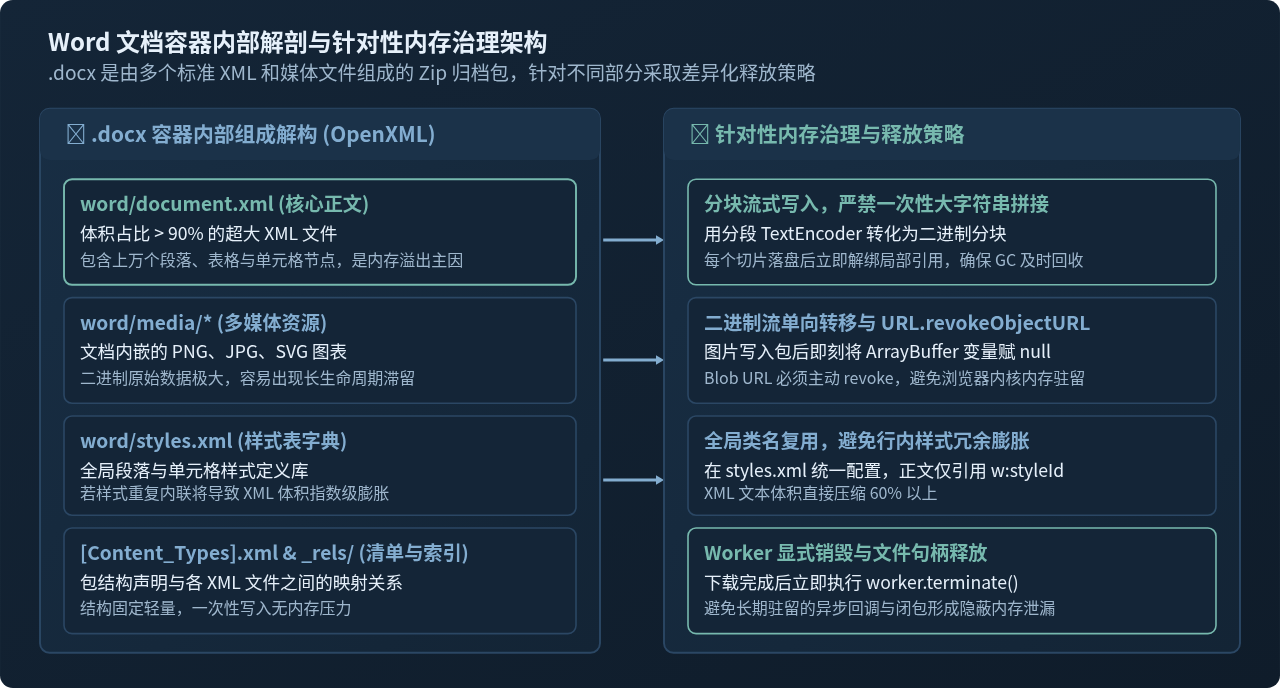
3. 闭包与垃圾回收(GC)闭环
在分片处理的大型异步链路中,很多前端工程师容易无意识地在闭包中引用上一轮的数据列表,导致 V8 的垃圾回收器无法判定对象已死亡。要保持内存平稳,必须遵循以下纪律:
- 循环内部变量立即断引:当前分片在写入流通道后,将存储当前分片数据的临时数组长度设为 0(
chunk.length = 0),并将局部对象赋null。 - 避免在全局或长生命周期对象中挂载事件监听:进度汇报与错误处理应采用一次性发布订阅机制,导出完毕后立即解绑所有 listener。
- 主动销毁 Worker 进程:当整个导出流程收尾(无论是成功导出还是中途取消),必须显式调用
worker.terminate(),切断 Worker 上下文与主线程之间的所有引用关系,确保整个执行栈被操作系统安全回收。
四、实战演练:完整工程级分片流式导出核心代码
下面给出可以在现代浏览器环境中直接参考落地的完整工程实现架构。代码分为两部分:在 Worker 内部安全拼装 OpenXML 片段的生成器,以及在主线程调度分片与流式写盘的控制器。
1. 后台 Worker 脚本逻辑(export.worker.js)
Worker 接收分块数据,将业务数据逐条映射为 OpenXML 标签,并利用 TextEncoder 分段输出 Uint8Array:
// export.worker.js - 独立计算线程
const encoder = new TextEncoder();
// 安全转义 XML 特殊字符
function escapeXml(str) {
if (str === null || str === undefined) return '';
return String(str)
.replace(/&/g, '&')
.replace(/</g, '<')
.replace(/>/g, '>')
.replace(/"/g, '"')
.replace(/'/g, ''');
}
// 监听主线程派发的分片数据
self.onmessage = function (e) {
const { type, chunkData, batchIndex, isLast } = e.data;
if (type === 'PROCESS_CHUNK') {
let xmlChunk = '';
// 遍历当前分片记录,生成标准 Word 表格行 XML
for (let i = 0; i < chunkData.length; i++) {
const item = chunkData[i];
xmlChunk += `
<w:tr>
<w:tc><w:p><w:r><w:t>${escapeXml(item.id)}</w:t></w:r></w:p></w:tc>
<w:tc><w:p><w:r><w:t>${escapeXml(item.title)}</w:t></w:r></w:p></w:tc>
<w:tc><w:p><w:r><w:t>${escapeXml(item.amount)}</w:t></w:r></w:p></w:tc>
<w:tc><w:p><w:r><w:t>${escapeXml(item.date)}</w:t></w:r></w:p></w:tc>
</w:tr>`;
}
// 将生成的字符串转换为二进制 Uint8Array
const buffer = encoder.encode(xmlChunk);
// 使用 Transferable Objects 零拷贝返回给主线程
self.postMessage(
{
type: 'CHUNK_PROCESSED',
batchIndex,
buffer,
isLast
},
[buffer.buffer] // 转移底层 ArrayBuffer 引用,避免深拷贝
);
}
};2. 主线程流式调度器(DocumentStreamExporter.js)
主线程初始化文件保存流,按步长分批提取数据,并通过异步时间切片驱动 Worker 计算并完成流式落盘:
// DocumentStreamExporter.js - 主线程流式导出控制器
export class DocumentStreamExporter {
  constructor(options = {}) {
    this.chunkSize = options.chunkSize || 300; // 每批分片 300 条
    this.onProgress = options.onProgress || (() => {});
    this.worker = null;
    this.fileStream = null;
    this.isCancelled = false;
  }

  // 1. 初始化文件选择器与写入流
  async initFileStream(defaultFileName = 'LargeReport.docx') {
    if (!('showSaveFilePicker' in window)) {
      throw new Error('当前浏览器环境不支持 File System Access API,请降级处理');
    }
    const handle = await window.showSaveFilePicker({
      suggestedName: defaultFileName,
      types: [{
        description: 'Word Document',
        accept: { 'application/vnd.openxmlformats-officedocument.wordprocessingml.document': ['.docx'] }
      }]
    });
    this.fileStream = await handle.createWritable();
  }

  // 2. 主导出流程
  async exportLargeData(totalRecords) {
    this.isCancelled = false;
    const totalCount = totalRecords.length;
    let processedCount = 0;

    // 实例化 Worker
    this.worker = new Worker(new URL('./export.worker.js', import.meta.url), { type: 'module' });

    try {
      // 写入 OpenXML 头部结构
      const docHeader = `<?xml version="1.0" encoding="UTF-8" standalone="yes"?>
<w:document xmlns:w="http://schemas.openxmlformats.org/wordprocessingml/2006/main">
  <w:body>
    <w:p><w:r><w:t>超大数据明细统计报告</w:t></w:r></w:p>
    <w:tbl>
      <w:tr>
        <w:tc><w:p><w:r><w:t>编号</w:t></w:r></w:p></w:tc>
        <w:tc><w:p><w:r><w:t>名称</w:t></w:r></w:p></w:tc>
        <w:tc><w:p><w:r><w:t>金额</w:t></w:r></w:p></w:tc>
        <w:tc><w:p><w:r><w:t>日期</w:t></w:r></w:p></w:tc>
      </w:tr>`;
      await this.fileStream.write(new TextEncoder().encode(docHeader));

      // 分批次分发与写入
      for (let cursor = 0; cursor < totalCount; cursor += this.chunkSize) {
        if (this.isCancelled) throw new Error('导出已被用户取消');

        const chunkData = totalRecords.slice(cursor, cursor + this.chunkSize);
        const isLast = (cursor + this.chunkSize) >= totalCount;

        // 向 Worker 派发任务并等待当前分片生成完毕
        const chunkBuffer = await this.dispatchToWorker(chunkData, cursor, isLast);

        // 将分段 ArrayBuffer 直接追加写入本地硬盘
        await this.fileStream.write(chunkBuffer);

        processedCount += chunkData.length;
        this.onProgress(Math.min(100, Math.round((processedCount / totalCount) * 100)));

        // 时间切片让渡:给浏览器排版重绘预留间隔,保持 60 FPS
        await this.yieldEventLoop();
      }

      // 写入尾部闭合标签
      const docFooter = `</w:tbl></w:body></w:document>`;
      await this.fileStream.write(new TextEncoder().encode(docFooter));

      // 关闭流,完成持久化
      await this.fileStream.close();
    } finally {
      // 显式终止 Worker 释放所有句柄
      if (this.worker) {
        this.worker.terminate();
        this.worker = null;
      }
    }
  }

  // 辅助函数:Worker 异步调用 Promise 化
  dispatchToWorker(chunkData, batchIndex, isLast) {
    return new Promise((resolve, reject) => {
      const handler = (e) => {
        if (e.data.type === 'CHUNK_PROCESSED') {
          this.worker.removeEventListener('message', handler);
          resolve(e.data.buffer);
        }
      };
      this.worker.addEventListener('message', handler);
      this.worker.postMessage({ type: 'PROCESS_CHUNK', chunkData, batchIndex, isLast });
    });
  }

  // 让出主线程
  yieldEventLoop() {
    return new Promise(resolve => setTimeout(resolve, 0));
  }

  // 取消导出
  cancel() {
    this.isCancelled = true;
  }
}
五、工程实践避坑指南与总结
在真实业务场景落地纯前端大文件导出时,除了核心的分片与内存管控外,还有几项极易被忽略的细节风险:
1. XML 标签配对严格性与实体转义
Word 对 OpenXML 的格式容错能力几乎为零。只要出现一个未闭合的 <w:tc>、多余的斜杠,或者在文本中包含未转义的字符(如未转义的 & 或 <),用户在 Microsoft Word 中打开该文件时就会遭遇弹窗报错:“Word 在尝试打开文件时遇到错误……该文件已损坏”。因此在 Worker 遍历拼装时,必须对所有动态业务字段进行严格的 XML 实体转义,并且切片时绝对不能将一个完整的单元格或段落标签拦腰截断在两个不同的批次中。
2. 批次阈值(Chunk Size)的选择边界
批次划分并非越小越好。如果 chunkSize 设为 10,频繁的跨线程 postMessage 通信和事件循环上下文切换会使导出总耗时呈倍数增加;若 chunkSize 设为 5000,则单次任务执行时间过长,主线程可能会感知到轻微的微卡顿。在实际工程实践中,200~500 条数据为单批次是吞吐量与界面响应平滑度之间的黄金平衡点。
3. 多种环境下的降级矩阵
由于各浏览器平台对底层流式写入 API 的支持情况存在差异,生产环境建议采用以下降级策略表:
| 客户端环境 | 推荐方案 | 内存控制效果 | 交互表现 |
|---|---|---|---|
| Modern Chromium (Chrome, Edge, Opera) | File System Access API | 极高 (内存维持 50~80MB) | 弹出保存对话框,直写本地磁盘,支持随时取消 |
| Firefox / Safari | StreamSaver.js (Service Worker) | 高 (由 Service Worker 缓冲转接) | 接管系统原生下载流,平稳写盘 |
| 受限 Webview / 旧版移动端浏览器 | 分块 Blob 组合降级 | 中 (最终合并阶段有短暂内存峰值) | 依赖 ArrayBuffer 数组拼接,需提示用户大文件风险 |
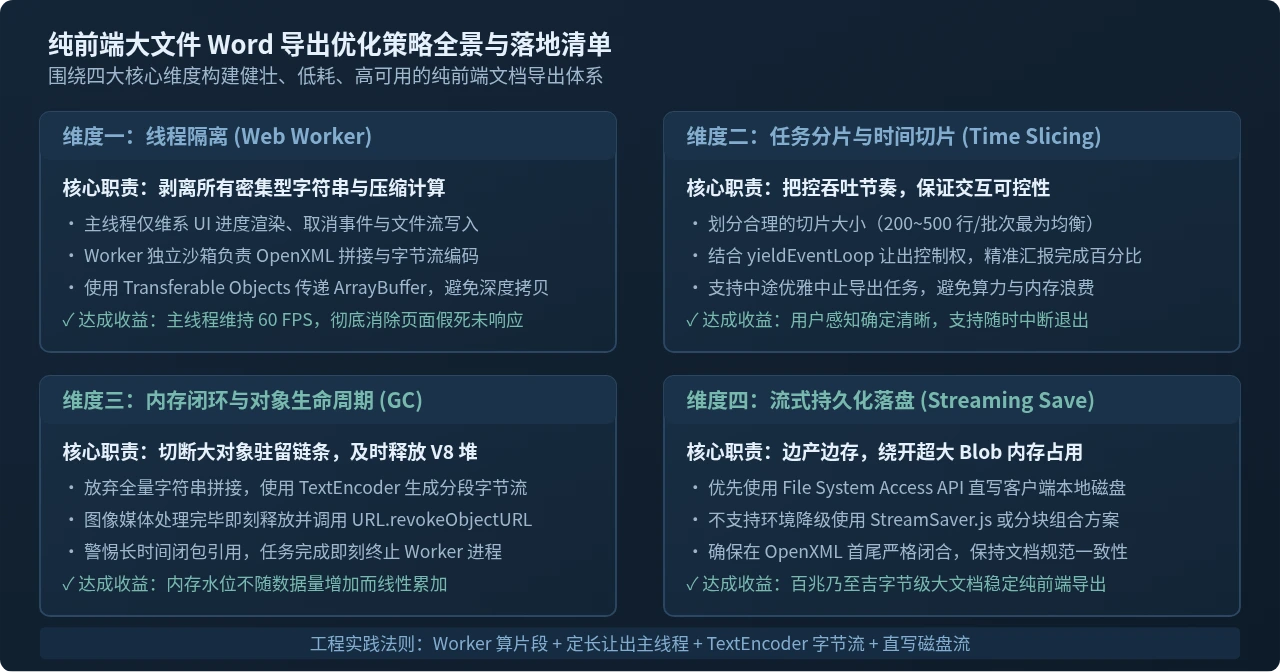
总结:纯前端导出 Word 大文件并不是一个不可逾越的性能瓶颈。只要跳出“单线程全量构造巨型 AST 对象并在内存全量生成 Blob”的思维定式,将架构演进为“Web Worker 计算隔离 + 游标任务分片 + 分段 TextEncoder 字节流 + FileSystemWritableFileStream 直写落盘”的流式流水线,就能以数十兆微弱且恒定的内存消耗,稳定可靠地导出上万行甚至更庞大的企业级业务文档。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章