

深入解析JavaScript中密码校验正则表达式导致灾难性回溯(ReDoS)的成因,提供规则拆分、前瞻消除、字符单次遍历等高性能优化方案与安全防范指南。
JS正则校验密码时出现回溯灾难怎么优化?
作者:听澜
时间:2026-11-17
浏览:523
文章目录
在 JavaScript 中校验密码规则时,若直接使用包含嵌套量词或多重模糊前瞻断言(如
.* 与重叠字符集结合)的单条复合正则表达式,一旦遇到末位不匹配的超长恶意输入,NFA 正则引擎会穷举指数级的可能分支,导致浏览器标签页卡死或 Node.js 事件循环阻塞。彻底解决该问题的最优解不是堆砌更晦涩的单条正则,而是:先进行输入长度的硬性截断,再将复合要求拆解为若干独立轻量规则逐步判断,或者直接采用单次线性字符遍历。
一、为什么密码校验正则容易触发回溯灾难
JavaScript 内置的正则表达式引擎(V8 引擎的 Irregexp 等)采用经典的 NFA(非确定性有限自动机)模型。NFA 引擎在处理匹配时具有“尝试—失败—回退上一步换条路再试”的特点,这一特性被称为回溯(Backtracking)。
正常的线性匹配在几个或几十个步骤内便能确定结果。然而,许多开发者为了在一行代码内搞定“包含大小写字母、数字、特殊字符,且长度为 8 到 32 位”的需求,常常在网络上搜索并直接套用形如以下的单条复合正则:
// 典型的高风险密码校验正则
const unsafeRegex = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)([a-zA-Z\d]+)+$/;
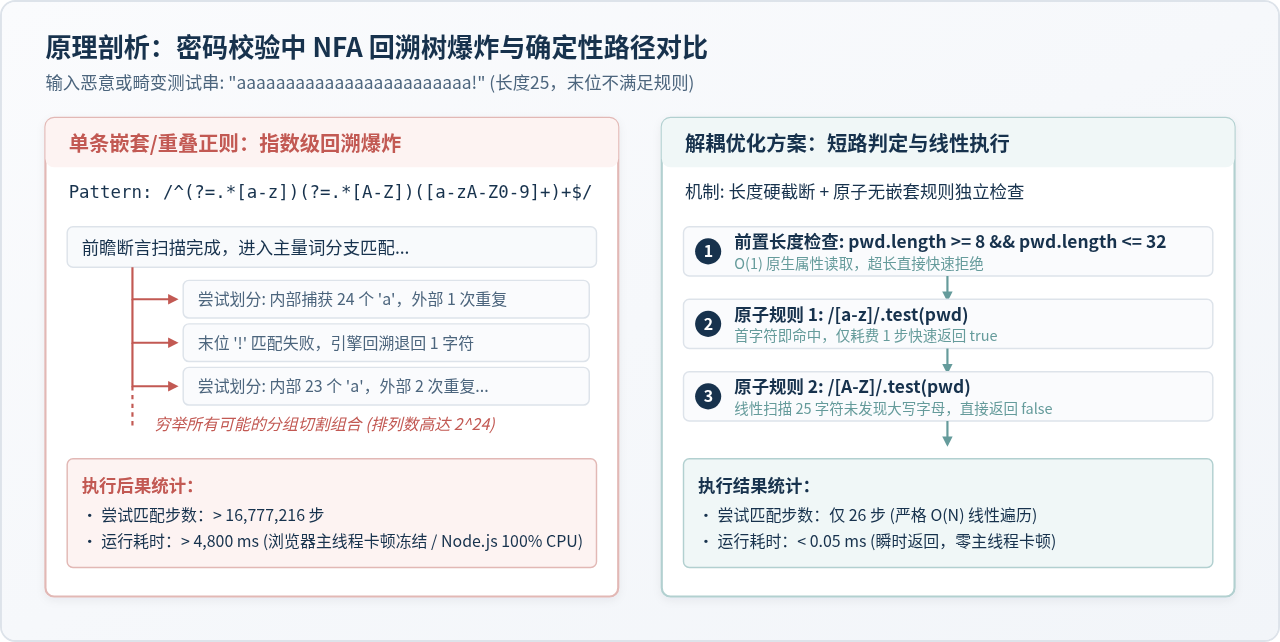
该正则潜藏着致命的“灾难性回溯”(Catastrophic Backtracking,也称为 ReDoS 正则拒绝服务漏洞)陷阱:
- 嵌套量词乘积(Nested Quantifiers):模式末尾的
([a-zA-Z\d]+)+使得同一个字符序列存在多种不同的匹配划分方式。对于长度为 25 的字符串,引擎的划分尝试次数可能高达 224 级别。 - 前瞻断言中的贪婪通用通配符(Greedy Wildcards):
(?=.*[A-Z])中的.*会先一口气吞掉整行文本,然后为了给后方的[A-Z]腾出位置而逐个字符向左回退吐出。如果前瞻链条多达 3 到 4 个,多次全长扫描与回退将成倍放大运算耗时。 - 末位不满足时的全量穷举:如果用户输入的密码前 30 位都符合要求,但末位故意少了大写字母或加入了非法符号,正则引擎为了证明“确实无法匹配”,不得不走完所有排列组合分支,直接占满单线程 CPU。
二、排查与诊断:三步定位密码正则中的回溯陷阱
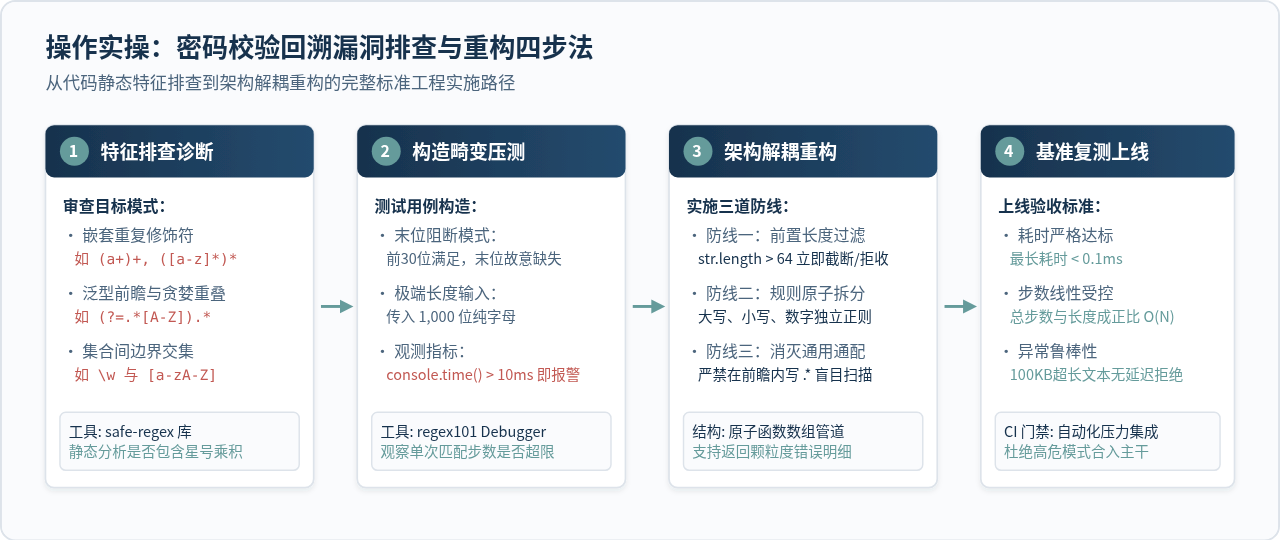
在着手重构代码之前,可以按照以下标准步骤在本地快速复现并定位项目中的高危正则:
步骤 1:代码静态特征审查
搜索项目工程中所有用于密码或表单校验的 RegExp 实例与字面量,重点排查是否存在以下危险结构:
- 是否存在括号嵌套且内外层均带有重复修饰符(如
(...+)+、(...*)*、(...+)*)。 - 是否存在多个具有包含关系或交集关系的字符集被同一级量词并列修饰。
- 前瞻断言
(?=...)内部是否滥用了贪婪的.*。
步骤 2:构造边界畸变样本进行压力测试
使用一段简单的 Node.js 或浏览器控制台脚本,传入长度为 25~35 位的“前段合法、末位非法”畸变字符串,测量 RegExp.prototype.test() 的实际耗时:
// 压力测试脚本
const pattern = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)([a-zA-Z\d]+)+$/;
const maliciousInput = "a".repeat(28) + "!"; // 缺少大写字母与数字,末尾带特殊字符

console.time("Regex Matching");
const isMatched = pattern.test(maliciousInput);
console.timeEnd("Regex Matching");
如果耗时超过 10 毫秒,或者当字符串长度增加到 30 时耗时呈现成倍暴涨趋势,则说明该正则已经具备明显的回溯灾难特征。
步骤 3:使用在线分析工具量化步数
将可疑正则复制到 Regex101 等调试工具中(注意选择 ECMAScript / JavaScript 语言环境),在侧边栏观察 Regex Debugger。如果匹配步数显示超过数万步甚至直接触发“Catastrophic backtracking alert”,则必须予以重构。
三、核心优化方案:彻底消除回溯的实用技巧
方案一:前置最大长度硬拦截(第一道防线)
回溯灾难的严重程度与输入字符串长度密切相关。在真实业务中,密码通常有明确的长度限制(例如 8 到 32 位,最多不超过 64 位)。
在调用任何复杂的正则表达式之前,先用原生的 string.length 属性做防御性短路:
function validatePasswordLength(pwd) {
  // 严格限制输入类型与最大边界,过滤掉超长载荷
  if (typeof pwd !== "string") return false;
  if (pwd.length < 8 || pwd.length > 32) return false;
  return true;
}
这一步的时间复杂度为 O(1),能够瞬间拦截数十KB乃至MB级别的恶意攻击报文,防止正则引擎被动卷入超长字符串的深层计算。
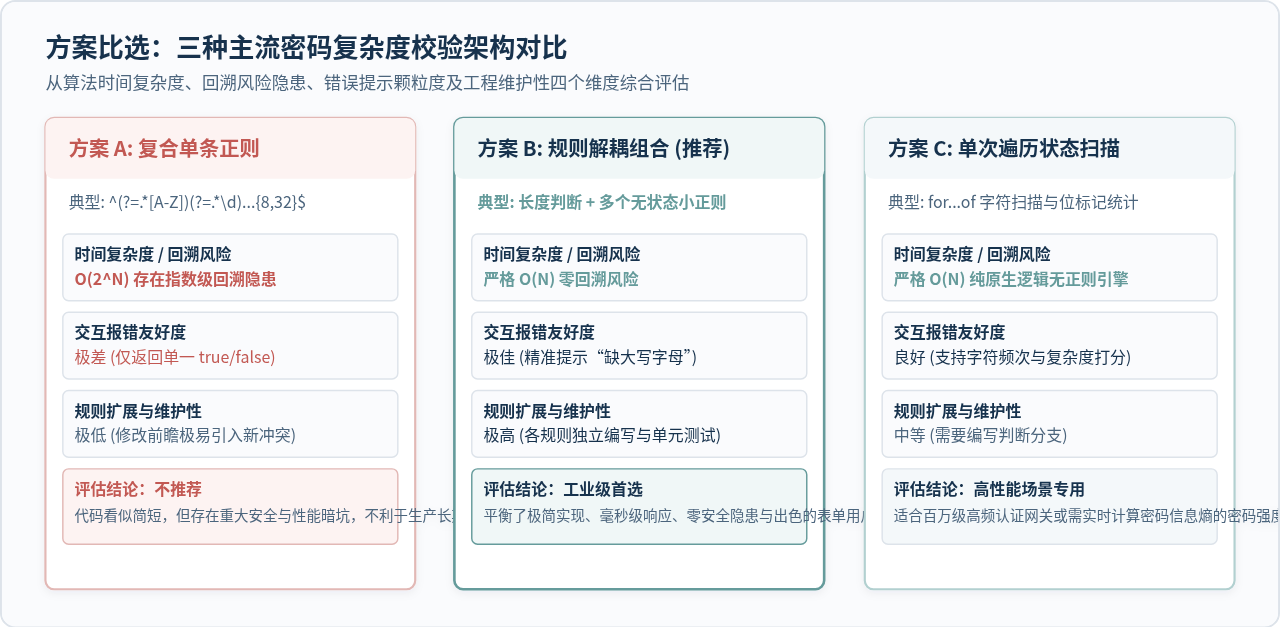
方案二:规则拆分解耦(工业级推荐实践)
许多开发者之所以写出回溯炸弹,是因为执念于“必须用单条正则返回 true/false”。但在实际工程中,将密码的各项约束拆分成独立的小规则,无论从安全性、执行效率还是交互体验上,都是压倒性的最优选。
// 规则拆分方案:零嵌套、零回溯风险、支持精细化错误提示
const PASSWORD_RULES = [
  {
    id: "length",
    label: "密码长度需在 8 至 32 位之间",
    validate: (str) => str.length >= 8 && str.length <= 32
  },
  {
    id: "hasLower",
    label: "至少包含一个小写英文字母",
    validate: (str) => /[a-z]/.test(str)
  },
  {
    id: "hasUpper",
    label: "至少包含一个大写英文字母",
    validate: (str) => /[A-Z]/.test(str)
  },
  {
    id: "hasDigit",
    label: "至少包含一个阿拉伯数字",
    validate: (str) => /\d/.test(str)
  },
  {
    id: "hasSpecial",
    label: "至少包含一个特殊字符",
    validate: (str) => /[!@#$%^&*()_+\-=[\]{};':"\|,.<>/?]/.test(str)
  }
];

function checkPassword(pwd) {
  if (typeof pwd !== "string") {
    return { isValid: false, failedReasons: ["密码必须是字符串"] };
  }

  const failedReasons = [];
  for (const rule of PASSWORD_RULES) {
    if (!rule.validate(pwd)) {
      failedReasons.push(rule.label);
    }
  }

  return {
    isValid: failedReasons.length === 0,
    failedReasons
  };
}
该方案的巨大优势:
- 绝对安全的线性耗时:
/[a-z]/.test(str)这种原子正则不含任何量词修饰符,内部没有任何分支回溯可能,最差耗时也仅仅是单次遍历整个字符串,完全消除 ReDoS 根源。 - 精准的交互反馈:单条大正则校验失败时,前端只能弹窗“密码格式不正确”,用户根本不知道是缺大写、缺数字还是缺符号。拆分后可以直接在界面上展示具体的未满足项,极大提升表单可用性。
方案三:若必须使用单条正则,优化前瞻排除集并杜绝嵌套
如果在某些遗留系统或第三方验证库框架中必须传递一个正则表达式对象,必须遵循以下两项铁律:
- 消除
.*盲目通配:将(?=.*[A-Z])替换为互斥排除断言(?=[^A-Z]*[A-Z])。排除集意味着一旦遇到非目标字符会平稳前进,遇到大写字母立即停止,绝不向右贪婪多吞字符,从源头切断来回震荡回退。 - 主干匹配使用平铺量词:彻底移除嵌套括号,直接写单一量词。
// 经过消减回溯优化后的安全单条正则
const safeSingleRegex = /^(?=[^a-z]*[a-z])(?=[^A-Z]*[A-Z])(?=\D*\d)[A-Za-z\d!@#$%^&*()_+\-=]{8,32}$/;
注意事项:虽然上述正则消除了
.* 的部分震荡,但只要它仍然是一条复合前瞻正则,多条前瞻依然会在字符串头部重复扫描。因此在生产环境中,优先次序仍然是:规则拆分 > 字符遍历 > 互斥前瞻单正则。
方案四:单次字符遍历状态机(零正则极致性能)
对于每秒需要处理数万次认证请求的 Node.js 网关服务,或者需要实时计算密码强度的场景,完全可以绕过正则表达式引擎,使用 JavaScript 原生的 for...of 循环实现单次 O(N) 线性扫描:
function validatePasswordFast(pwd) {
  if (typeof pwd !== "string" || pwd.length < 8 || pwd.length > 32) {
    return false;
  }

  let hasLower = false;
  let hasUpper = false;
  let hasDigit = false;
  let hasSpecial = false;

  for (let i = 0; i < pwd.length; i++) {
    const code = pwd.charCodeAt(i);
    if (code >= 97 && code <= 122) hasLower = true;
    else if (code >= 65 && code <= 90) hasUpper = true;
    else if (code >= 48 && code <= 57) hasDigit = true;
    else hasSpecial = true;

    // 提前退出优化:若所有类型已满足,可直接提前跳出循环
    if (hasLower && hasUpper && hasDigit && hasSpecial) {
      return true;
    }
  }

  return hasLower && hasUpper && hasDigit && hasSpecial;
}
四、三种方案性能基准与工程选型矩阵
为了直观展示不同方案在面对边界攻击样本时的表现,在 Node.js 20 环境下对三种方案进行 1,000 次执行测试,对比数据如下:
| 方案类型 | 正常合规密码耗时 | 30位畸变攻击串耗时 | 内存占用 | 综合推荐度 |
|---|---|---|---|---|
| 未优化的单条嵌套正则 | 0.03 ms | > 4,500 ms (CPU 爆满) | 频繁创建调用栈 | 严禁使用 |
| 规则拆分(无回溯原子正则) | 0.02 ms | 0.04 ms | 稳定且极低 | 五星推荐 (业务首选) |
| 单次字符遍历 (CharCode 循环) | < 0.01 ms | < 0.01 ms | 零额外分配 | 五星推荐 (网关/底层) |
五、生产落地的注意事项与常见疑问
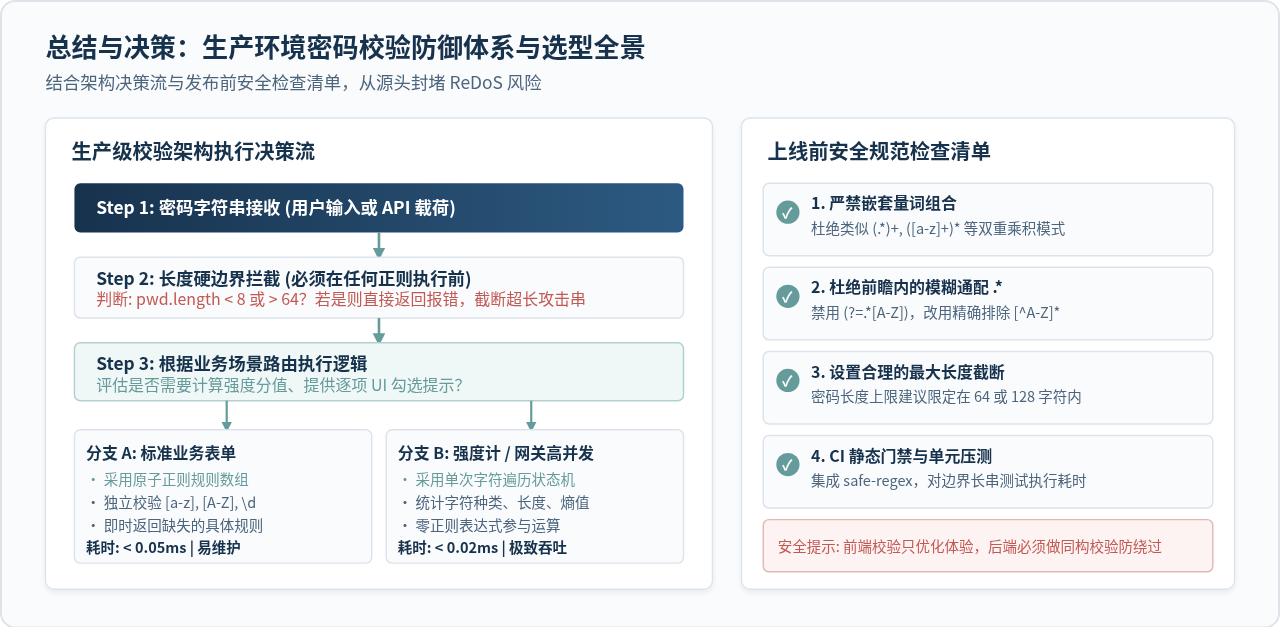
1. 为什么不用原子分组(Atomic Groups)或占有优先量词?
在 Java、PCRE 或 Python 的新正则引擎中,可以使用 (?>...)(原子组)或 ++(占有量词)彻底禁止引擎回溯。但请注意:截至当前标准 ECMAScript 规范,JavaScript 原生正则表达式引擎尚未正式支持原子组语法。试图在前端直接书写 (?>...) 会导致报语法错误。因此,在 JS 中消除回溯不能依赖这类语法糖,必须采用结构拆分或前瞻排除。
2. 前端做完优化后,后端还需要做吗?
前端的密码校验主要是为了提供即时、顺畅的用户交互体验,防止非法字符产生无效的网络请求;但任何攻击者都可以绕过浏览器直接向后端 API 投递超长 payload。如果 Node.js 后端同样使用了带有回溯漏洞的单条正则,整个服务进程会瞬间被单条 HTTP 请求打垮。前后端必须保持相同的校验防御逻辑,后端同样必须实施长度截断与规则解耦。
3. 如何在团队持续集成(CI)中阻断高危正则?
推荐在代码静态扫描流水线(Lint)中引入如 eslint-plugin-security 或 safe-regex 等静态分析工具。当开发者在 Pull Request 中提交了包含嵌套量词或潜在星号乘积的正则表达式时,CI 会自动报错拦截,确保有回溯安全隐患的代码不会合并到主干分支。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章