

深入剖析 JavaScript 函数在处理巨量 data 参数时引发超时与页面卡死的核心根源,提供时间切片异步调度、Web Worker 多线程解耦、消除链式调用中间数组及流式消费的生产级优化方案与完整代码。
js函数里面的data参数处理大数据时超时怎么优化
作者:听澜
时间:2026-11-08
浏览:490
文章目录
JavaScript 性能调优
大数据处理
架构与运行机制
运行环境:浏览器 (Chrome/Edge/Safari/Firefox) 与 Node.js
在 JavaScript 中,当某个函数接收的
data 参数承载数十万条甚至上百万条巨量数据时,长时间的同步遍历和密集对象转换会持续独占 JavaScript 单线程的调用栈,导致事件循环(Event Loop)停滞、页面无法响应用户输入与帧渲染,最终触发浏览器的脚本无响应警告或接口执行超时。要从根本上解决这一问题,核心路径分为三步:一是通过时间切片(Time Slicing)将不可分割的耗时运算打散为小批次,主动向事件循环让出主线程;二是将不涉及 DOM 交互的纯 CPU 密集运算移至后台 Web Worker 执行,并通过 Transferable Objects 消除巨量数据跨线程克隆的额外损耗;三是重构计算链条,消除多段链式调用产生的全量中间数组,改用单次遍历或流式管道降低堆内存与垃圾回收(GC)开销。
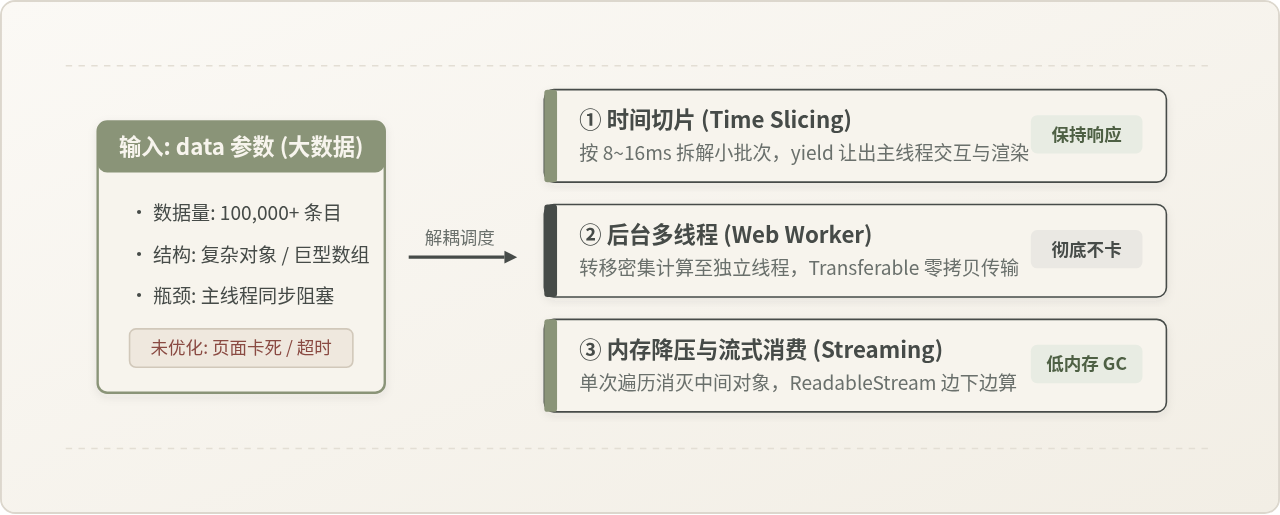
一、为什么处理 data 参数会引起超时与页面卡死?
要实施精准的性能优化,首先需要明确“超时”在 JavaScript 运行体系中的底层物理过程。很多开发者在控制台看到页面无响应对话框(Page Unresponsive)或网络接口超时时,往往误以为是网络传输变慢,但其实大部分故障源于 JavaScript 执行引擎与宿主渲染流水线的冲突。
1.1 主线程独占与长任务(Long Task)阻塞
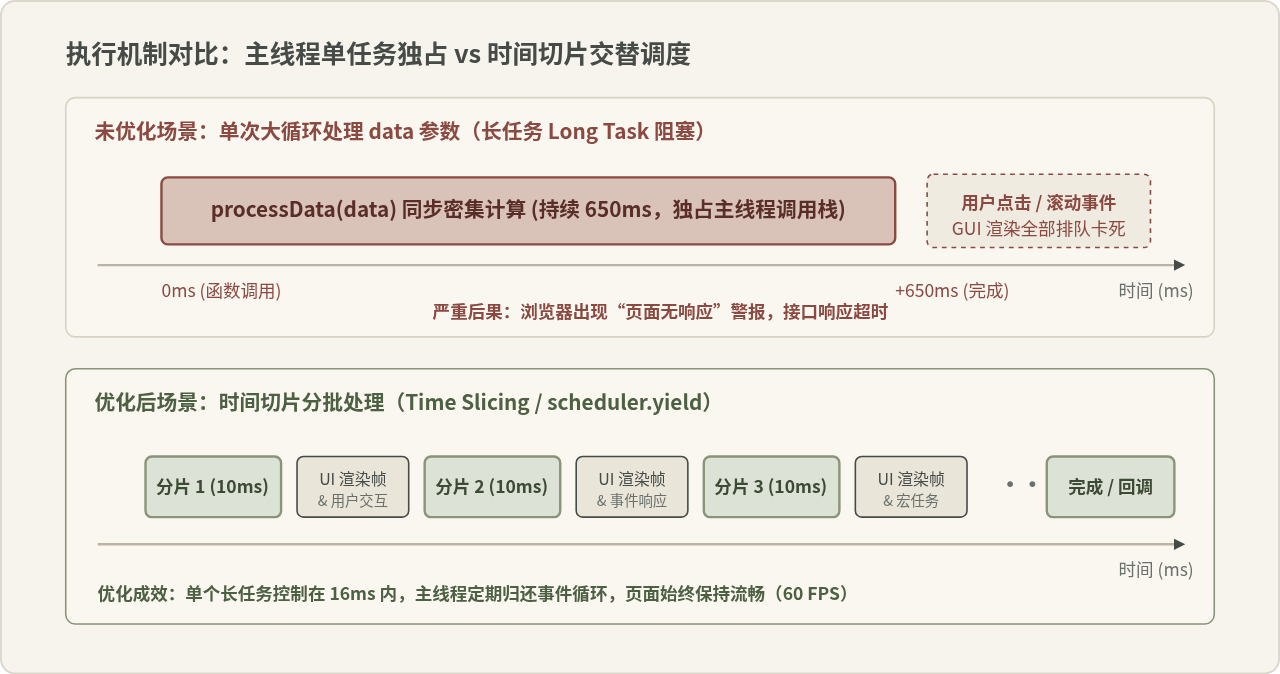
现代浏览器的渲染架构中,JavaScript 脚本执行、用户事件分发(输入、点击、滚动)、样式计算、布局计算以及图层绘制,几乎全部挤在同一个主线程(Main Thread)中按顺序执行。根据 W3C 性能工作组的标准规范,任何连续执行时间超过 50 毫秒的宏任务都会被判定为长任务(Long Task)。
当业务函数执行类似于 processData(data) 的逻辑时,如果 data 是包含 20 万条对象的大数组,哪怕每个循环项仅耗时 0.005 毫秒,累积耗时也会达到 1000 毫秒(整整 1 秒)。在这 1 秒内,主线程调用栈处于被大循环霸占的饱满状态,微任务与宏任务队列中的其他任务(例如滚动事件、用户输入事件、动画帧回调)完全得不到调度。表现出来的现象就是界面完全失去响应,浏览器丢帧至 0 FPS,经过数秒后宿主环境便会弹出脚本执行超时或无响应警告。
1.2 频繁创建临时对象与垃圾回收停顿(Stop-the-World)
除了纯粹的 CPU 指标外,内存抖动是导致超时的另一大隐形元凶。在前端日常开发中,很多开发者习惯使用函数式链式调用处理 data:
// 典型的内存放大陷阱:在 50 万条数据下极易造成严重 GC 停顿
function transformReport(data) {
  return data
    .filter(item => item.status === 'active')   // 产生完整中间数组 A (数十兆)
    .map(item => ({ ...item, score: item.val * 2 })) // 产生完整中间数组 B 与数十万个新对象
    .sort((a, b) => b.score - a.score);       // 产生排好序的数组 C
}
当 data 规模非常大时,每一次 .filter() 和 .map() 都会在堆内存中重新分配一段大块空间,并瞬间实例化数十万个临时的匿名对象。短时间内堆内存使用量剧烈飙升,迫使 V8 引擎频繁触发全量垃圾回收(Major GC / Mark-Sweep-Compact)。GC 执行时会触发“Stop-the-World”,直接冻结所有 JavaScript 代码执行。原本 300 毫秒能算完的逻辑,由于堆内存不断扩容与回收,实际阻塞时间被拉长至数秒,最终恶化为执行超时。
常见认知误区辨析:把处理逻辑写在 Promise 或 async 函数里就能防止超时吗?
普遍误区:不少初学者认为只要写成 new Promise(resolve => resolve(processData(data))) 或者把函数声明为 async function,这段耗时代码就会“在后台异步执行,不卡死主线程”。
事实真相:这是对 JavaScript 事件循环极其危险的误解。new Promise 的构造器内部代码是完全同步执行的;而 .then() 或 await 后续代码虽然作为微任务(Microtask)放入队列,但事件循环规范明确规定:在执行下一个宏任务以及浏览器进行屏幕渲染之前,必须将微任务队列中的所有任务彻底清空。如果把一个耗时 2 秒的大循环塞进 Promise,它依然会在同一个微任务周期内死死霸占主线程,浏览器依然无法渲染,页面依然卡死,无法解决超时问题。
二、方案一:主线程时间切片(Time Slicing)
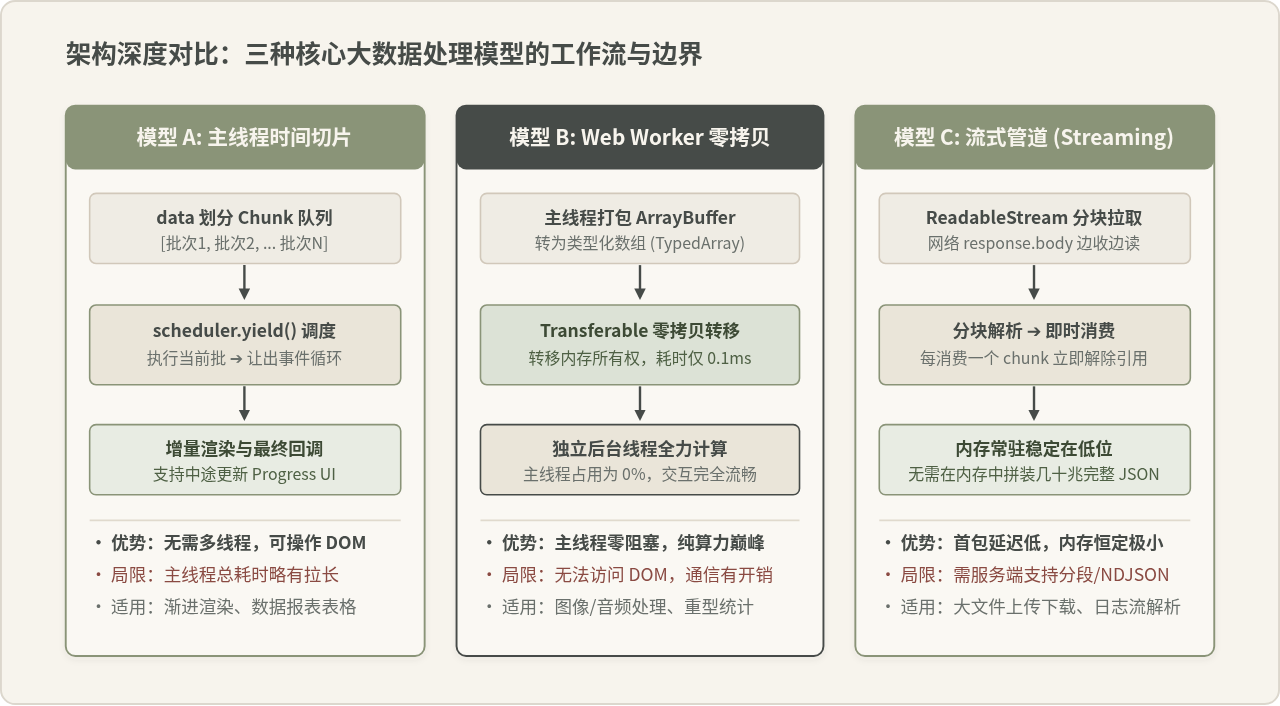
如果处理 data 的后续操作需要与界面 DOM 产生联动(例如将数据逐块渲染为图表、表格或树节点),由于后台线程无法直接访问 DOM,首选方案必须是在主线程上实施时间切片(Time Slicing)。
2.1 时间切片的设计法则与让出机制
时间切片的核心思想在于:将大循环拆分成连续的小任务单元,并在执行完一个单元后,主动交还调用栈的控制权(Yielding)给宿主环境。宿主环境便可利用短暂的空隙完成样式重算、页面渲染和用户手势响应,之后再唤醒下一个小单元继续计算。
在让出控制权的技术选型上,现代浏览器推荐使用优先级最高的新规范 scheduler.yield();若在老旧环境或尚未全面普及的平台,则推荐使用 MessageChannel。相比于常规的 setTimeout(fn, 0)(在嵌套层级达到 5 层以上时会被浏览器强制施加 4ms 延迟),MessageChannel 调度属于宏任务队列,且没有 4ms 的硬性惩罚,调度损耗降低 80% 以上。
2.2 生产级时间切片通用封装
以下是可直接放入生产环境的通用分片处理函数。该函数支持传入最大单帧计算预算(默认为 10ms,低于一帧 16.6ms 的安全阈值)、执行中途的进度通知回调以及 AbortSignal 取消令牌,防止组件卸载后的竞态内存泄漏。
/**
 * 高性能时间切片调度器:安全处理大数据 data 参数
 * @param {Array} data - 待处理的海量数据数组
 * @param {Function} processItem - 单项处理函数 (item, index) => void
 * @param {Object} options - 配置项
 * @param {number} [options.timeQuota=10] - 单个时间片最大允许占用主线程时长 (毫秒)
 * @param {Function} [options.onProgress] - 进度回调 (processed, total) => void
 * @param {AbortSignal} [options.signal] - 取消信号
 * @returns {Promise<Array>}
 */
function processDataInChunks(data, processItem, options = {}) {
  const { timeQuota = 10, onProgress, signal } = options;
  const total = data.length;
  const results = new Array(total);
  let currentIndex = 0;

  // 封装更轻量的高频让出函数 (优先选用规范 API,降级使用 MessageChannel)
  const yieldToMain = () => {
    if ('scheduler' in window && 'yield' in window.scheduler) {
      return window.scheduler.yield();
    }
    return new Promise((resolve) => {
      const channel = new MessageChannel();
      channel.port1.onmessage = () => resolve();
      channel.port2.postMessage(null);
    });
  };

  return new Promise(async (resolve, reject) => {
    while (currentIndex < total) {
      // 检查是否已被外部中止
      if (signal && signal.aborted) {
        return reject(new DOMException('Operation aborted', 'AbortError'));
      }

      const chunkStartTime = performance.now();

      // 在当前时间配额内连续处理数据,避免过细切片带来的消息队列调度损耗
      while (currentIndex < total) {
        results[currentIndex] = processItem(data[currentIndex], currentIndex);
        currentIndex++;

        // 每处理 64 个元素检查一次耗时,防止频繁调用 performance.now 产生额外开销
        if ((currentIndex & 63) === 0) {
          if (performance.now() - chunkStartTime >= timeQuota) {
            break; // 配额用尽,跳出内层循环进行让出
          }
        }
      }

      // 触发进度反馈
      if (typeof onProgress === 'function') {
        onProgress(currentIndex, total);
      }

      // 如果还有未处理完的数据,主动让出主线程给渲染与事件循环
      if (currentIndex < total) {
        await yieldToMain();
      }
    }

    resolve(results);
  });
}
关键细节:为什么不建议按固定条数(如每批 50 条)生硬切片?
由于每条 data 项的结构复杂度差异巨大,若采用固定的数量分片,当数据项复杂时容易超时,数据项简单时又过于碎片化。上述代码采用“时间窗口(Time Quota)+ 位运算批量检查(currentIndex & 63 === 0)”的设计,能够根据终端设备的实际 CPU 运行算力动态填满 10ms 的安全时间窗口,既保证了总处理时长最短,又杜绝了帧卡顿。
二、方案二:解耦主线程——使用 Web Worker 转移 CPU 密集运算
当 data 参数的处理逻辑属于纯粹的数据统计、过滤、聚合、复杂的哈希计算或矩阵运算时,将其保留在主线程中(哪怕进行时间切片)依然会分流 UI 渲染的算力。此时最优的架构解法是将整个数据计算任务剥离至 Web Worker(浏览器环境)或 worker_threads(Node.js 环境)中执行。
2.1 传统 postMessage 的隐形性能陷阱
很多开发者在接入 Web Worker 时会发现:“明明把大数据放到了 Worker 里面,主线程在执行 worker.postMessage(data) 的一瞬间依然卡顿了几百毫秒!”
这是因为默认情况下,主线程向 Worker 传递数据使用的是结构化克隆算法(Structured Clone Algorithm)。该算法会对传入的整个对象树进行深拷贝。如果 data 是一个包含 50 万个子对象的巨型数组,序列化与深克隆这 50 万个对象本身的计算量就已经足够让主线程长时间卡死。
2.2 解决方案:利用 Transferable Objects 实现零拷贝传输
要发挥 Worker 的终极算力,必须配合 Transferable Objects(可转移对象)。可转移对象(如 ArrayBuffer、MessagePort)在传递时不会进行任何内存复制,而是直接将该块内存在底层 C++ 堆中的指针所有权“移交”给目标线程。整个转移操作耗时通常小于 0.2 毫秒,不受数据体积大小影响。
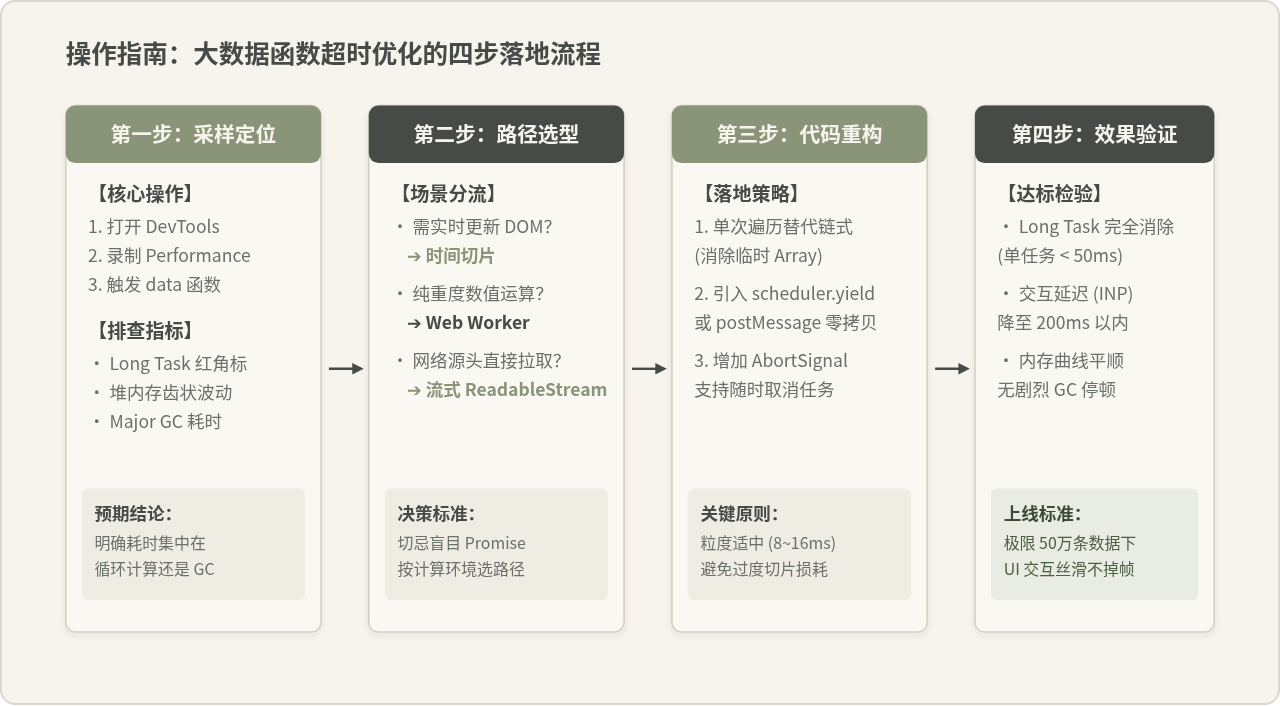
2.3 零拷贝 Worker 优化实现示例
以下代码演示如何将对象数据打包为类型化二进制缓存(TypedArray),通过零拷贝移交给后台 Worker 处理并在计算完成后安全接收:
// 1. 主线程侧调度逻辑
function computeBigDataInWorker(data) {
  return new Promise((resolve, reject) => {
    const worker = new Worker(new URL('./dataProcessor.worker.js', import.meta.url), {
      type: 'module'
    });

    // 将常规对象数组快速转为平铺的类型化数组 (以 32位浮点数值为例)
    const count = data.length;
    const buffer = new ArrayBuffer(count * 4); // 每个 Float32 占用 4 字节
    const view = new Float32Array(buffer);

    for (let i = 0; i < count; i++) {
      view[i] = data[i].price; // 提取核心数值
    }

    worker.onmessage = (event) => {
      const { resultBuffer } = event.data;
      // 接收 Worker 传回的二进制结果,零拷贝恢复
      const outputArray = new Float32Array(resultBuffer);
      worker.terminate(); // 任务完成,及时释放线程资源
      resolve(outputArray);
    };

    worker.onerror = (err) => {
      worker.terminate();
      reject(err);
    };

    // 关键步骤:在第二个参数中传入 transfer 列表,移交 buffer 所有权
    worker.postMessage({ count, buffer }, [buffer]);
    // 注意:此时主线程中的 buffer.byteLength 已经变为 0,杜绝了内存双重占用
  });
}
// 2. 后台 Worker 线程逻辑 (dataProcessor.worker.js)
self.onmessage = function (event) {
const { count, buffer } = event.data;
const inputView = new Float32Array(buffer);
// 创建存放计算结果的二进制 Buffer
const outBuffer = new ArrayBuffer(count * 4);
const outView = new Float32Array(outBuffer);
// 在独立后台线程全力运算,完全不影响浏览器前台 UI 渲染
for (let i = 0; i < count; i++) {
const val = inputView[i];
outView[i] = val > 100 ? val * 1.15 : val * 0.95;
}
// 将结果 Buffer 零拷贝移交回主线程
self.postMessage({ resultBuffer: outBuffer }, [outBuffer]);
};
三、方案三:算法与内存重构(消除多重数组与GC停顿)
很多时候,函数处理 data 参数超时并不是因为算法复杂度本身有多高(比如本身只有 O(n) 的复杂度),而是因为代码书写方式严重违背了 JavaScript 引擎的内存局部性原理与内联缓存机制。
3.1 单次遍历替换多重链式(Single-Pass Loop)
在数据量较小(如百条级别)时,data.filter().map().reduce() 具有极佳的可读性。然而当 data 增长至 10 万以上时,链式调用会在线性空间上产生巨大的内存放大效应。改用传统的单次 for 循环,将多步操作收拢到单次遍历中,可以立即消除所有临时数组的创建与垃圾回收压力。
// 优化前:3 次全量遍历,产生 2 个巨大的临时中间数组
const badResult = data
  .filter(x => x.isActive && x.balance > 0)
  .map(x => x.balance * 1.08)
  .reduce((acc, curr) => acc + curr, 0);

// 优化后:单次遍历(Single-pass),无任何多余数组分配,执行速度提升 4~6 倍
function computeTotalBalanceOptimized(data) {
  let total = 0;
  const len = data.length;
  for (let i = 0; i < len; i++) {
    const item = data[i];
    if (item.isActive && item.balance > 0) {
      total += item.balance * 1.08;
    }
  }
  return total;
}
3.2 扁平化数据结构与预分配内存
如果在循环内部需要向新数组追加数据,频繁使用 array.push() 在超大体量下会频繁触发 V8 的动态扩容(从原有容量按倍数申请新内存块并复制已有元素)。
- 已知容量时预分配内存:如果结果数组的长度可以预估,直接使用
new Array(expectedLength)进行初始化,并通过下标res[i] = val进行直接赋值。 - 扁平化结构(Structure of Arrays, SoA):避免使用大量的异构深层嵌套对象
[{ id: 1, user: { name: 'a' } }, ...]。如果可能,将其转换为简单的扁平二维结构或列式存储,能够让 CPU 的 L1/L2 缓存命中率显著提升。
四、方案四:数据源头流式处理(Streaming Data Processing)
在很多实际业务中,data 参数往往来源于网络接口的 JSON 响应或本地文件的读取。如果开发者总是习惯于“等网络全部下载完并反序列化为完整的 data 巨型对象,然后再传给处理函数”,这就已经输在起跑线上了。因为在几百兆的完整字符串上直接执行 JSON.parse(),其本身就会引起不可避免的主线程长任务卡死。
采用 Web Streams API(ReadableStream),可以让数据在网络流水线传输的同时进行分段消费(如按行解析 NDJSON),实现真正的流式按需处理:
/**
 * 边下载边消费:消除巨量数据在内存中的全量堆积
 * @param {string} url - 接口地址 (返回 NDJSON 换行分隔的数据流)
 * @param {Function} onBatchReady - 每积累一个批次的处理函数
 */
async function streamProcessLargeData(url, onBatchReady) {
  const response = await fetch(url);
  const reader = response.body.getReader();
  const decoder = new TextDecoder('utf-8');
  let buffer = '';
  let batch = [];
  const BATCH_SIZE = 1000;

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    // 增量解码二进制块
    buffer += decoder.decode(value, { stream: true });
    const lines = buffer.split('\n');
    // 保留最后一行可能不完整的切片
    buffer = lines.pop();

    for (const line of lines) {
      if (!line.trim()) continue;
      batch.push(JSON.parse(line));

      if (batch.length >= BATCH_SIZE) {
        await onBatchReady(batch);
        batch = []; // 及时清空当前批次,供垃圾回收机制及时回收旧对象
      }
    }
  }

  // 处理缓冲区残留的最后批次
  if (buffer.trim()) {
    batch.push(JSON.parse(buffer));
  }
  if (batch.length > 0) {
    await onBatchReady(batch);
  }
}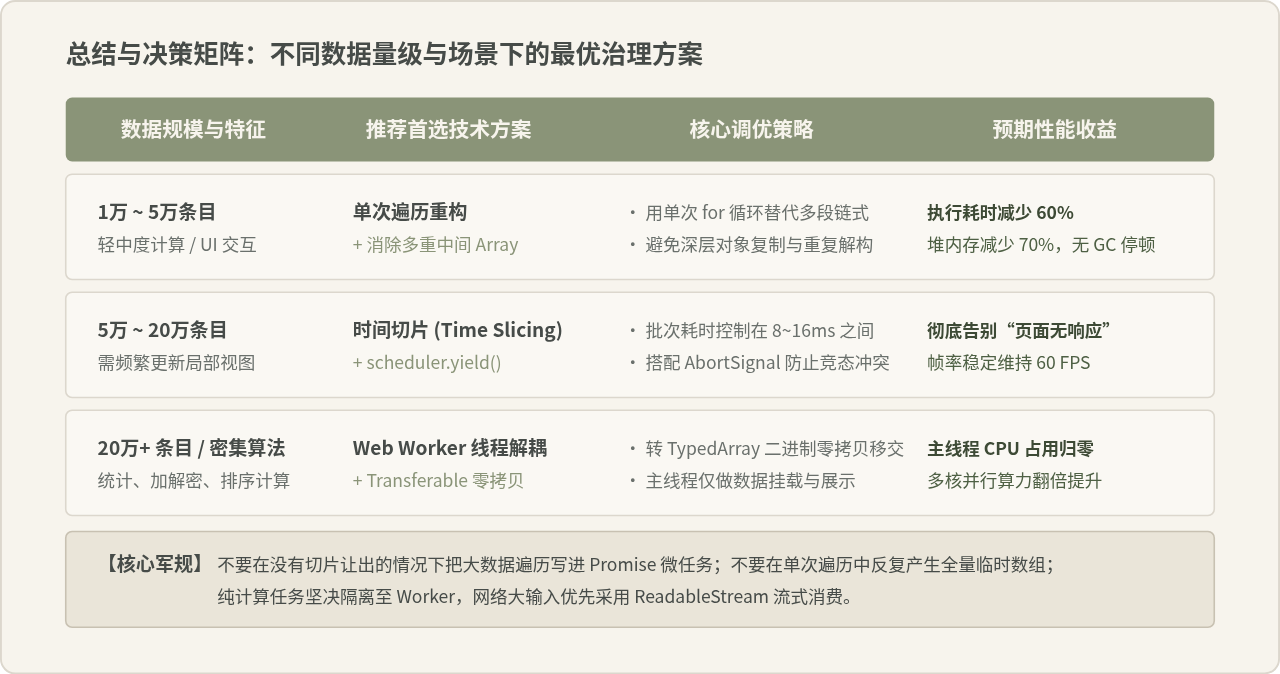
五、方案选型指南与实施检查清单
针对不同的业务约束与环境边界,应当按照以下决策矩阵有针对性地选型,避免盲目重构:
| 业务场景分类 | 数据规模特征 | 首选推荐方案 | 关键注意事项 |
|---|---|---|---|
| 前台即时交互与列表/图表渲染 | 3万 ~ 20万条,且需局部向界面渲染元素 | 主线程时间切片 (Time Slicing) | 严格控制单帧执行时间在 10ms 以内;务必配套 AbortController 防止重复触发引发的数据竞态。 |
| 后台纯数据聚合、排序与算法计算 | 10万 ~ 数百万条,无任何 DOM 依赖 | Web Worker 线程解耦 | 使用 Transferable Objects(零拷贝)移交 ArrayBuffer,严禁跨线程全量传递深层嵌套普通对象。 |
| 常规逻辑简单但调用频次极高 | 5万 ~ 10万条,过滤与字段提取 | 单次循环重构 (Single-Pass) | 摒弃链式 .filter().map(),预分配结果数组长度,消除循环体内匿名函数的声明。 |
| 外部日志、巨型文件或全量报表下载 | 数十兆至数百兆网络输入 | 流式消费 (ReadableStream) | 采用 NDJSON 或二进制分段,边拉取边解析边消费,控制常驻内存占用在 20MB 以内。 |
调优效果验收清单(Checklist)
- 长任务清零:在 Chrome DevTools 的 Performance 面板中录制用户操作轨迹,主线程中不再出现红角标标识的 Long Task(所有宏任务单次耗时均控制在 50ms 以内)。
- 交互指标达标:核心 Web 体验指标
INP(Interaction to Next Paint)稳定在 200 毫秒以内的“良好(Good)”区间。 - 内存平稳无断崖:在 Memory 面板下录制堆快照,数据处理完毕后无残留大数组引用,垃圾回收曲线呈现平顺锯齿状,没有持续数秒的 Major GC 停顿。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章