

深入分析纯前端JavaScript生成验证码的技术缺陷与安全隐患,解析攻击者如何通过控制台篡改、直接调用接口、内存读取等方式绕过校验,并提供符合安全规范的服务端验证码架构方案。
纯前端JS生成验证码有哪些安全风险
作者:白帽猫
时间:2026-11-17
浏览:148
文章目录
Web 安全与架构
阅读时长:约 10 分钟
技术领域:前端工程 / 身份防御 / 接口风控
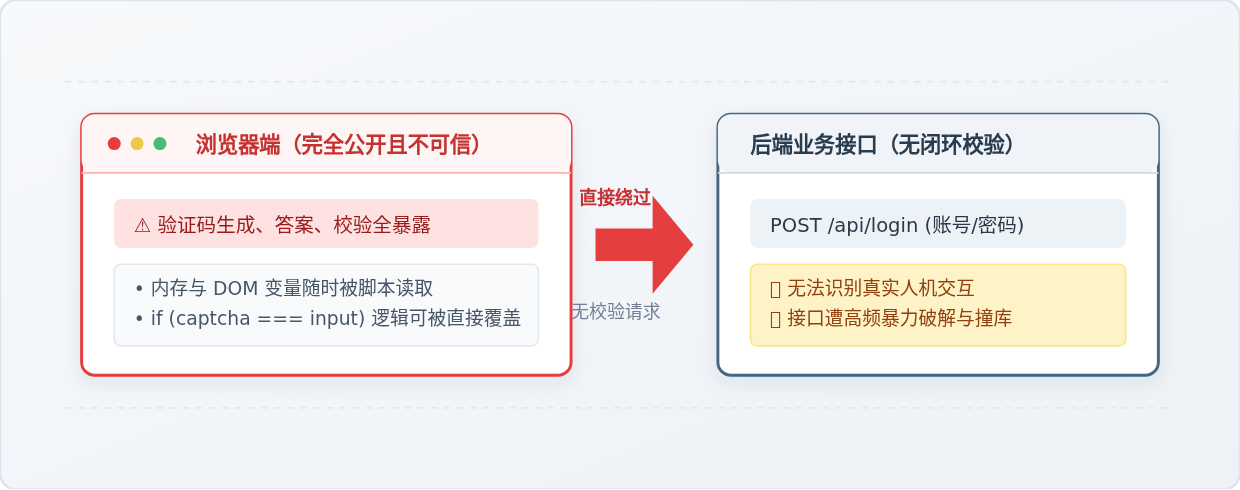
纯前端 JavaScript 生成验证码的本质问题是信任边界倒置。当生成题目、存储答案与核对校验的逻辑全部运行在不可信的客户端浏览器中时,这些防护在攻击者眼里形同虚设。本文全面拆解纯前端验证码的常见实现、四大核心安全风险与攻击利用手法,并给出真正具备防御价值的端云协同验证码架构方案。
一、纯前端验证码是什么与常见实现形式
验证码(CAPTCHA,全自动区分计算机和人类的公开图灵测试)的核心使命是在人机交互的关键入口处阻断自动化批量请求。为了实现这一目标,系统必须保证“测试题目只能由服务端掌控,测试答案不可被预知,且核验过程必须在受信端完成”。
然而在部分项目的实际开发中,一些开发者为了“图省事”、“减轻服务器压力”或“缺乏后端支持”,选择完全用前端 JavaScript 实现验证码。这类实现通常有以下几种形态:
- Canvas 随机字符绘制:在前端通过
Math.random()生成 4 到 6 位字母数字组合,使用 HTML5<canvas>绘制字符、干扰线和噪点,并将正确字符串保存在前端全局变量或闭包中。 - 纯数学算术题生成:前端随机生成
a + b = ?的算式直接插入 DOM 文本节点,用户输入答案后,由前端函数计算比较。 - 前端拼图/滑动滑块:用 JS 随机计算一个缺口坐标偏移量
offsetX,当用户拖动滑块达到该偏移量阈值时,前端直接判定为通过。
下面是一段在网络教程中屡见不鲜的典型纯前端 Canvas 验证码实现代码:
// 典型的前端生成验证码伪代码(存在严重安全缺陷)
let currentCode = "";

function generateCaptcha() {
  const chars = "ABCDEFGHJKLMNPQRSTUVWXYZ23456789";
  currentCode = "";
  for (let i = 0; i < 4; i++) {
    currentCode += chars.charAt(Math.floor(Math.random() * chars.length));
  }

  // 在 Canvas 上绘制干扰线和字符
  const ctx = document.getElementById("captchaCanvas").getContext("2d");
  drawCanvas(ctx, currentCode);
}

// 表单提交触发的校验函数
function handleFormSubmit(event) {
  event.preventDefault();
  const userInput = document.getElementById("captchaInput").value.trim().toUpperCase();

  // 致命缺陷:在前端完成校验
  if (userInput !== currentCode) {
    alert("验证码错误,请重新输入");
    generateCaptcha();
    return false;
  }

  // 校验通过后,直接向后端发送表单
  axios.post("/api/login", {
    username: document.getElementById("username").value,
    password: document.getElementById("password").value
    // 注意:许多前端验证码甚至不向后端传递验证码答案!
  });
}
关键警示:
在上述代码中,正确答案
currentCode 始终驻留在用户本地浏览器的内存环境中,校验分支 userInput !== currentCode 也完全由客户端 JS 解释器执行。这违背了安全工程的基本准则——绝对不能信任任何来自客户端的控制逻辑。
二、纯前端验证码面临的四大致命安全风险
纯前端生成验证码在面对具有基本技术能力的攻击者时,不具备任何防护能力。具体体现为以下四个不可逾越的致命风险:
1. 验证码答案在客户端内存与 DOM 中完全裸露
在纯前端架构下,浏览器既要当“出题人”,又要当“监考官”,因此验证码的原始文本必须以某种形式驻留在内存变量或 DOM 属性中。
- 如果保存在全局变量(如
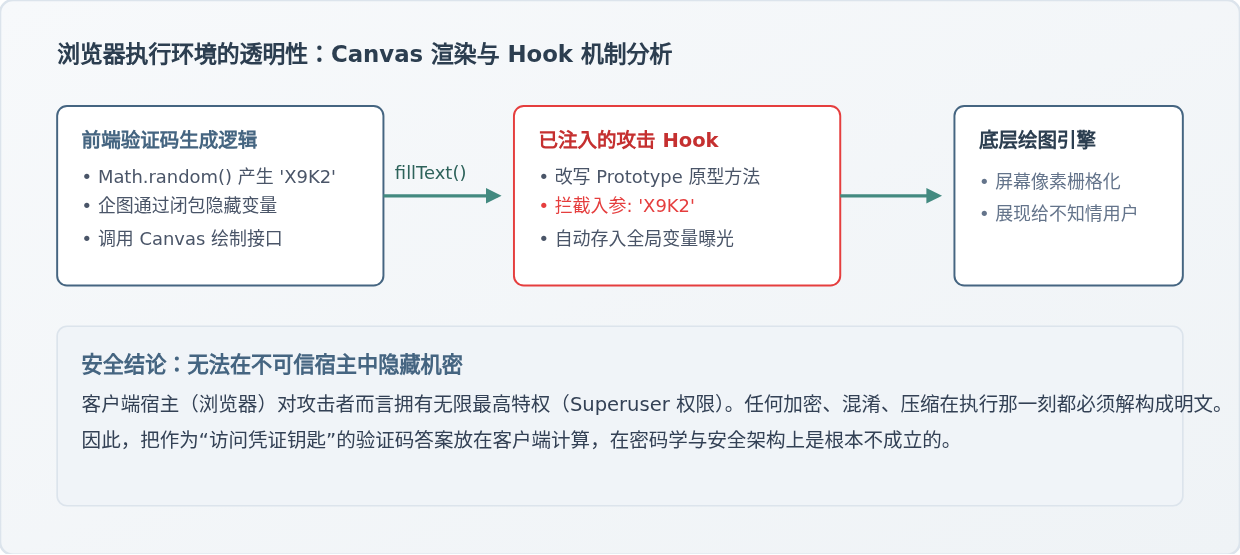
window.captchaCode)中,攻击脚本可以直接通过一行代码读取其值。 - 即使使用 ES 模块闭包或自执行函数包裹,攻击者仍可借助 Chrome DevTools 断点、覆写原型链方法(如
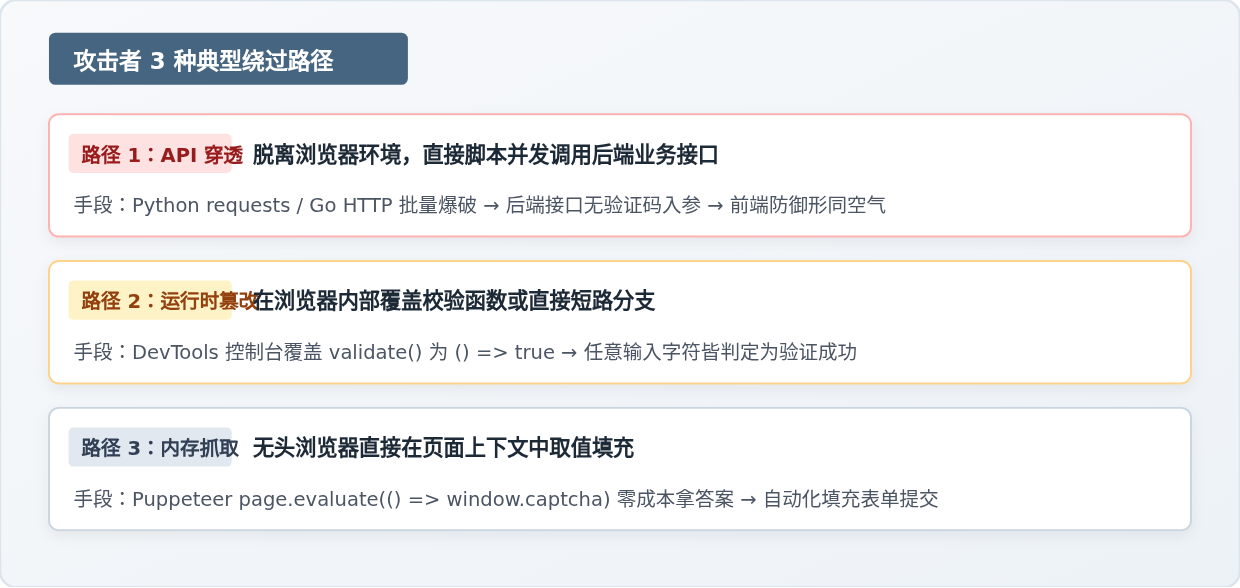
CanvasRenderingContext2D.prototype.fillText)直接拦截传入绘制的文本参数。 - 攻击者完全不需要运行任何 OCR(光学字符识别)模型,即可实现 100% 准确率的秒级答案提取。
2. 前端判断逻辑可被任意篡改与短路
前端 JavaScript 运行在用户完全可控的环境中。任何前端设置的 if...else 条件判断,在攻击者面前都可以轻易被绕过:
- 控制台函数重写:打开控制台输入
window.handleFormSubmit = function() { sendRealRequest(); },验证码分支逻辑瞬间蒸发。 - 条件断点篡改:在开发者工具中对验证语句打断点,直接将条件表达式强制评估为
true。 - 脚本覆写:通过油猴脚本(Tampermonkey)或代理抓包工具(如 Charles、Fiddler、mitmproxy)注入修改后的 JS 文件,直接移除校验拦截逻辑。
3. 后端接口脱幅裸奔,遭受暴力破解与撞库
这是纯前端验证码最严重的架构死穴。黑客发起撞库与暴力破解攻击时,根本不会通过点击浏览器的 UI 界面来提交数据。
攻击者只需在浏览器中完成一次合法操作,通过网络面板(Network)捕获后端真实的请求地址(例如 POST /api/user/login)。随后直接编写 Python 脚本、Go 脚本或使用 Burp Suite 工具,直接并发向该 API 发送成千上万次携带不同密码的 HTTP 请求。此时前端渲染的所有 Canvas、干扰线和输入框完全被无视,后端接口毫无感知地任由攻击者撞库。
4. 无法防御自动化脚本与无头浏览器(Headless Browser)
即使攻击者使用 Puppeteer、Selenium 或 Playwright 等自动化无头浏览器走正常网页渲染流程,前端验证码也起不到任何拖延作用。自动化脚本可以通过 page.evaluate() 直接在页面上下文中注入一段 JS 获取答案,或者直接调用表单的 submit 接口,全程无需人工介入。
三、实战演示:攻击者是如何瞬间绕过前端验证码的
为了让读者直观理解上述风险,我们通过两个微型示例展示在真实网络攻防中,攻击者绕过纯前端验证码有多么轻而易举。
示例 1:利用控制台重写绕过
假设网页绑定了如下校验:
// 网页原本的代码
function checkCaptchaAndLogin() {
  if (myInput.value !== correctCode) {
    alert("验证码不匹配!");
    return;
  }
  doRealLogin();
}
攻击者在 Chrome 开发者工具的 Console 中只需输入一行命令并回车:
// 攻击者执行的代码
checkCaptchaAndLogin = function() { doRealLogin(); };
此时无论在验证码输入框中填写什么内容,甚至保持空白,直接点击登录按钮都会直接执行 doRealLogin(),校验逻辑完全失效。
示例 2:利用 Hook 拦截 Canvas 的明文字符
有些开发者认为把答案写在闭包里就无法直接读取,但只要字符要在 Canvas 上绘制,就必须调用浏览器的底层 API ctx.fillText():
// 攻击者只需提前注入一个 Hook(甚至可以通过油猴脚本常驻)
const originalFillText = CanvasRenderingContext2D.prototype.fillText;
CanvasRenderingContext2D.prototype.fillText = function(text, x, y, maxWidth) {
  console.warn("嗅探到正在绘制的验证码字符:", text);
  window._stolenCaptcha = (window._stolenCaptcha || "") + text;
  return originalFillText.apply(this, arguments);
};
当页面执行 generateCaptcha() 时,控制台便会自动打印出拼接完成的完整验证码。自动化程序只需读取 window._stolenCaptcha 即可全自动填充,所谓的图形混淆和干扰线毫无阻碍作用。
四、为什么仍有开发者使用?误区剖析与适用边界
既然纯前端验证码安全性几乎为零,为什么许多入门教程甚至一些上线系统中仍然存在它的身影?主要源于以下三个认知误区:
| 常见认知误区 | 真实技术现状 | 危险等级 |
|---|---|---|
| “加了总比不加好” | 提供虚假的安全感。开发者以为系统已具备防暴破能力,从而放弃了后端频率限制等必要防线。 | 高危 |
| “服务器资源紧张,前端生成省 CPU” | 验证码正是为了保护服务器不被海量恶意请求击垮。前端验证等于门户大开,更容易导致服务器被打崩。 | 极高危 |
| “只是防普通用户频繁点击” | 如果只是为了防抖或防止手滑误操作,直接用前端防抖函数(Debounce)即可,引入验证码纯属劣化用户体验。 | 低危(误用) |
唯一合理的适用场景:
纯前端生成验证码唯一不产生安全灾难的场景是:该操作完全不涉及后端接口、敏感数据或核心逻辑。例如纯单机静态工具站中,用户清空本地缓存前的二次确认弹窗(防手滑),或者面向学龄前儿童的基础识字教学小游戏。除此之外,任何涉及登录、注册、找回密码、投票、抽奖、领取优惠券或发信的操作,均坚决禁止使用纯前端验证码。
纯前端生成验证码唯一不产生安全灾难的场景是:该操作完全不涉及后端接口、敏感数据或核心逻辑。例如纯单机静态工具站中,用户清空本地缓存前的二次确认弹窗(防手滑),或者面向学龄前儿童的基础识字教学小游戏。除此之外,任何涉及登录、注册、找回密码、投票、抽奖、领取优惠券或发信的操作,均坚决禁止使用纯前端验证码。
五、合规可靠的验证码系统架构与设计标准
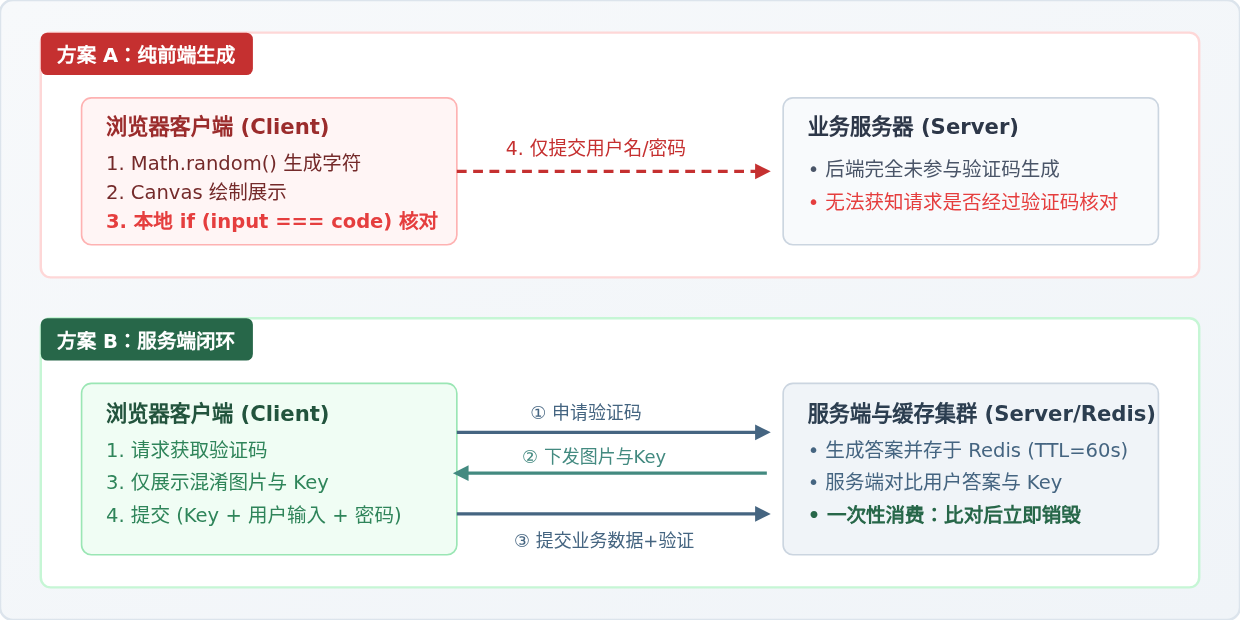
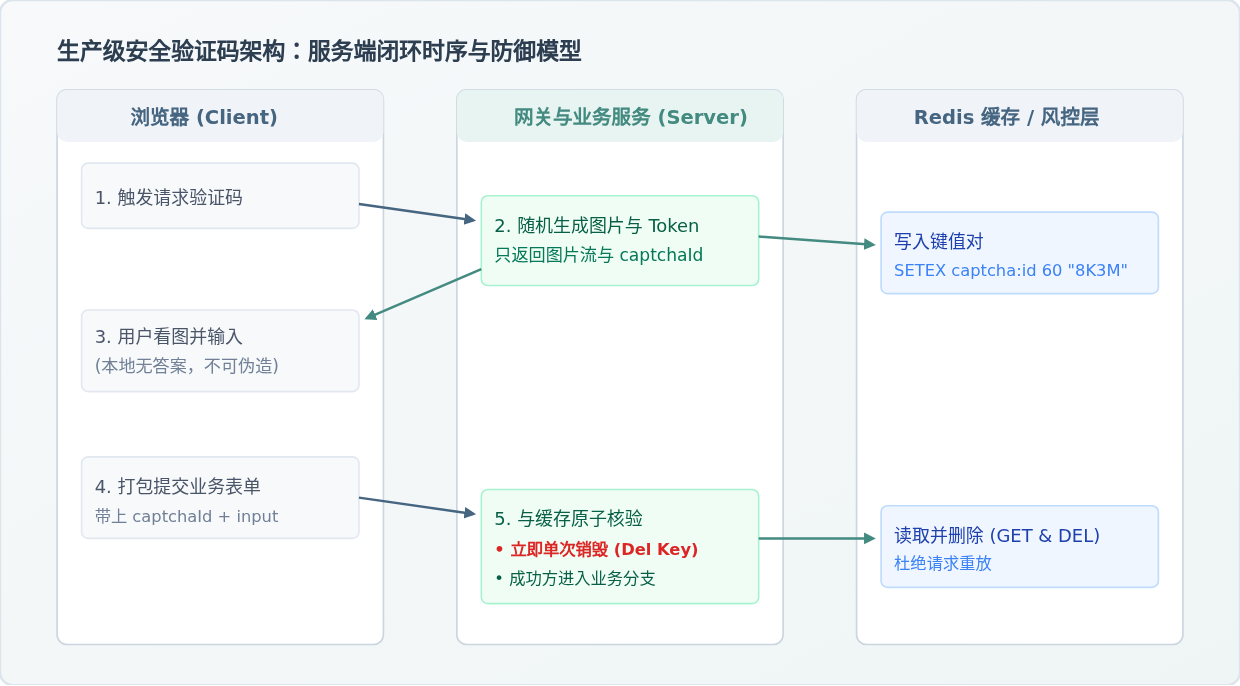
要让验证码真正发挥安全防线作用,架构设计的核心铁律只有一条:出题、存储、验证的完整生命周期必须在服务端实现闭环。
1. 标准端云协同验证码的执行时序
- 出题与凭证派发:客户端向服务端发起验证码请求。服务端在受保护的后端环境生成随机答案与唯一凭证(
captchaId),并将答案存入高性能缓存(如 Redis),设置严格的时效性(TTL 建议 60~120 秒)。 - 仅下发混淆产物:服务端将答案在服务端渲染成带干扰噪点的图片流(或返回打乱的拼图切片与加密扰动参数),连同
captchaId一同返回给客户端。客户端永远拿不到答案文本。 - 业务请求与校验捆绑:用户肉眼识图后输入答案,客户端将
username、password、captchaId、userAnswer共同打包提交给业务接口。 - 服务端原子比对与一次性销毁:后端接口在处理业务前,先在 Redis 中检索
captchaId。无论本次比对成功或失败,都必须立即从 Redis 中将该条目删除(One-Time Token),彻底阻断请求重放攻击(Replay Attack)。
2. 安全验证码设计的必检自查清单
在实际工程落地或重构遗留系统时,可依照以下清单逐一排查系统是否真正具备抗攻击能力:
- [必查] 答案驻留位置:验证码原始答案必须仅存在于服务器内存或分布式缓存中,严禁下发给客户端,严禁通过任何 Cookie 明文携带。
- [必查] 单次有效性(One-Time Use):验证码比对完成后(无论正确与否),服务端记录必须立即作废,防止暴力破解者复用同一验证码穷举密码。
- [必查] 严格有效时间窗口:设置合理的过期淘汰时间(通常建议不超过 2 分钟),防止未消耗验证码在缓存中堆积。
- [必查] IP 与频次联动限制:验证码接口自身同样需要接入限流策略(Rate Limiting)。例如对单一 IP 每分钟申请验证码次数设立上限,防止接口被高频调用消耗服务端图片渲染算力。
- [演进] 接入行为式人机验证:在现代高安全要求场景下,传统字符验证码已被自动化 OCR 模型以超过 90% 的成功率攻破。建议结合现代行为验证码(滑动拼图、空间点选、无感感知与设备指纹分析),实现兼顾用户体验与高强度防御的风控体系。
六、总结
纯前端 JavaScript 生成验证码的本质,是一道“将钥匙挂在锁芯上”的防盗门。对于初学者而言,它也许是一次有趣的 DOM 与 Canvas 练习;但在任何严谨的生产系统中,它都不能作为安全防御手段。
网络安全体系的根基在于清晰划分可信区与不可信区。始终牢记:前端负责界面渲染与人机交互引导,而关键的权限裁决、参数校验与凭证核对,必须坚定地留在受保护的服务端执行。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章