
深入拆解JavaScript中常见的手机号正则表达式 ^1[3-9]\d{9}$,详细解析起始锚点、第二位号段、\d数字元字符与量词限定符,并提供JS实战验证代码与边界考量。

当前位置:首页 > JavaScript 基础 > 正文
拆解JS手机号正则:^1[3-9]\d{9}$各部分含义解析
作者:木棉
时间:2026-11-17
浏览:287
文章目录
^1[3-9]\d{9}$ 是前端与 Node.js 开发中用于校验中国大陆 11 位手机号码最经典、最通用的基础正则表达式。它的核心逻辑是通过首尾锚点锁定整段字符串,强制要求以数字 1 开头、第二位落在 3 到 9 的合法运营号段内,随后严格跟随 9 位任意纯数字,从而在长度和格式上杜绝脏字符与异常输入。
一、整体结构:从 11 位手机号规则看正则构成
我国大陆地区的手机号码由工信部统一规划,采用国家统一标准的 11 位十进制数字编制体系(即 E.164 编码规范下的特定分配)。这一规划决定了手机号有三个刚性特征:总长度恒定为 11 位、首位恒为数字 1、第二位用于区分不同电信网络及通信大类(目前已全面开放 13x、14x、15x、16x、17x、18x、19x 等号段)。
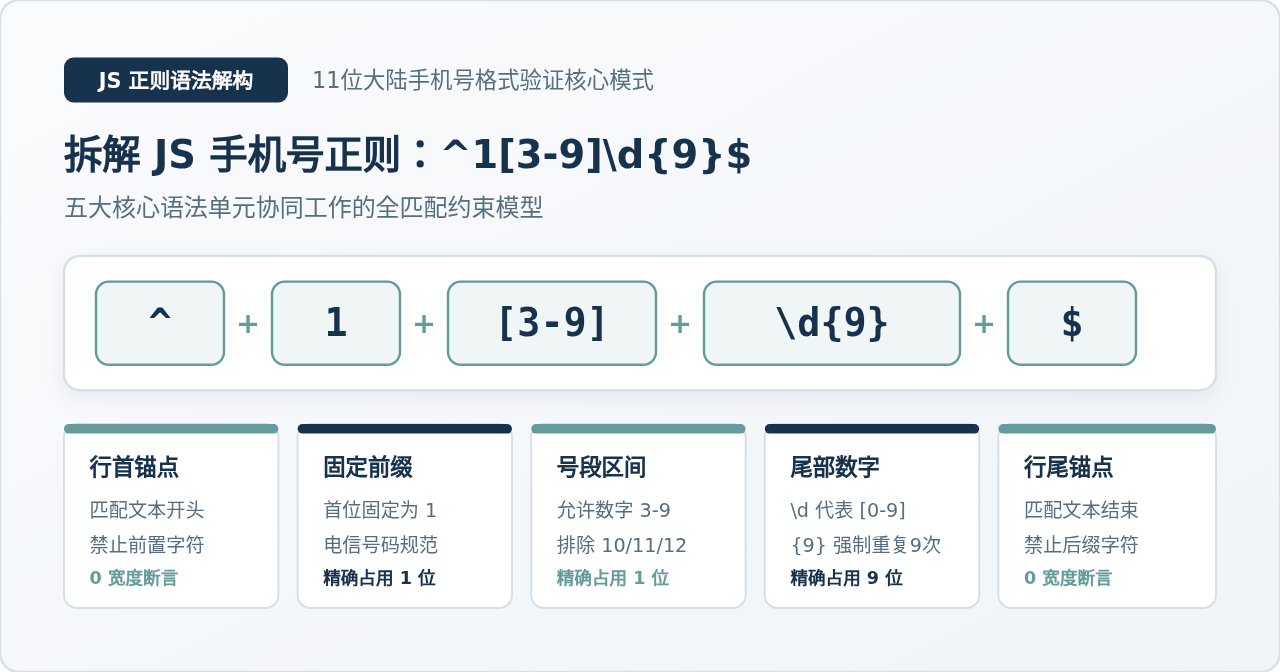
正则表达式 ^1[3-9]\d{9}$ 正是针对这套工业规则量身定制的数学描述模型。它将看似复杂的 11 位验证精准提炼成了 5 个语法单元:
^:定位字符串起始位置;1:锁定首位数字;[3-9]:限定第二位号段范围;\d{9}:精确匹配后续 9 位任意数字;$:定位字符串结束位置。
这五个部分环环相扣,既限制了每一位的字符集合,又通过精确量词确保了字符总数分毫不差(1 + 1 + 9 = 11)。
二、逐字符深度拆解:各部分的语法含义与运作机制
要彻底掌握并安全使用该表达式,需要逐一厘清每个符号在 JavaScript 正则引擎内部所扮演的语法角色。
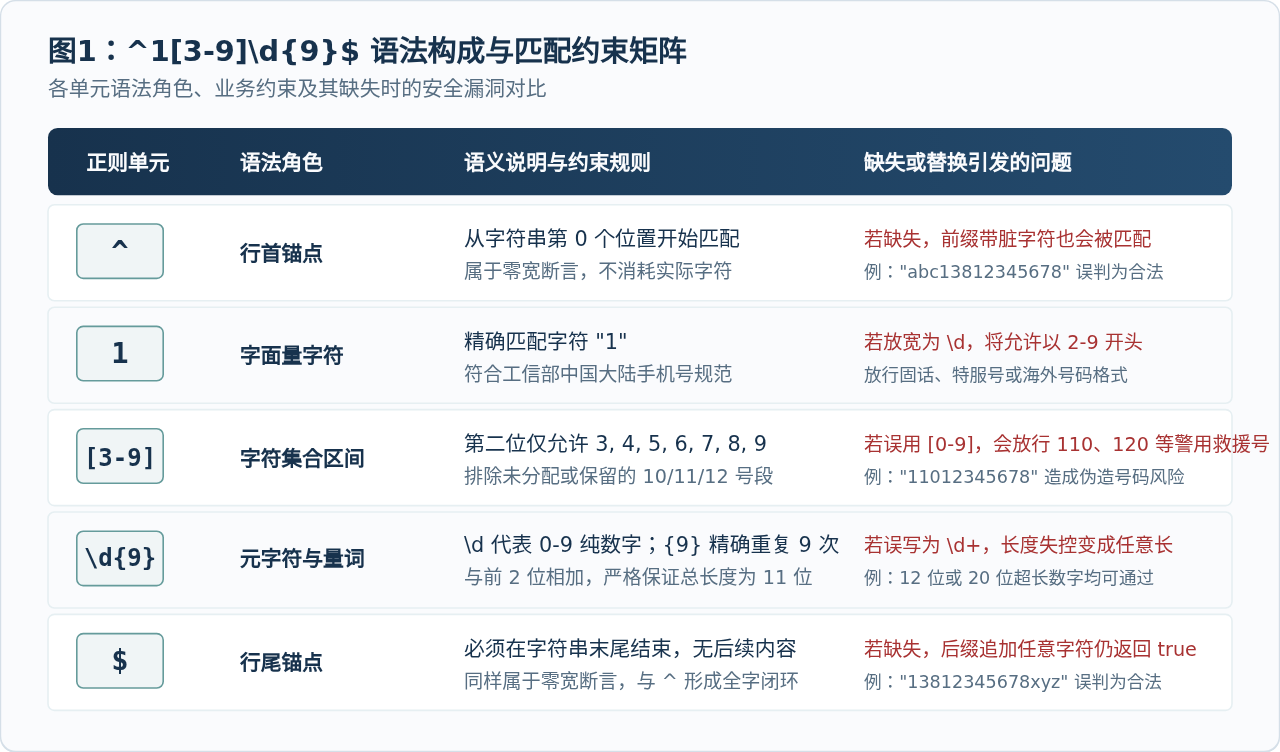
1. ^ 行首锚点(Start Anchor)
符号 ^ 在正则表达式的最前侧时被称为“脱字符”或“行首锚点”。在语法分类上,它属于零宽断言(Zero-width Assertion),这意味着它本身不消耗任何实际字符,也不与任何具体的数字或字母对应,而是用来匹配输入文本的最左端边界(即字符索引位置 0)。
如果没有 ^,正则引擎只要在输入文本的任何中间位置找到匹配子串就会判定通过。例如 1[3-9]\d{9}$ 会将 "vip_user_13812345678" 误判为合法手机号。加上 ^ 后,引擎强制要求必须从文本第 0 个位置直接开始比对。
2. 1 固定首位字符字面量(Literal Character)
数字 1 是一个普通字符字面量,表示严格精确匹配 ASCII 码中的字符 '1'。
在我国公用移动通信网络中,所有移动电话号码分配均以 1 开头(而固定电话以 0 开头、国际电话服务以 00 开头等)。因此在第一位直接硬编码数字 1,能够在一瞬间过滤掉固话号码、400/800 企服号、海外号码以及以其他数字开头的无效字符。
3. [3-9] 第二位号段字符集区间(Character Class)
中括号 [...] 声明了一个字符集合,表示匹配该集合中的任意单个字符;横线 - 在字符集中是范围连字符,3-9 表示包含从 '3' 到 '9' 的连续数字区间,其等价展开形式为 [3456789]。
这一设计的核心目的是排除以 10、11、12 开头的特种号码。例如 110、119、120 等紧急特服号,以及历史保留测试号段。目前三大运营商和中国广电所分配的民用手机号第二位均处于 3 至 9 的区间内(如 13x、15x、17x、18x、19x,以及物联网/虚拟运营商所用的 14x、16x)。采用 [3-9] 既严格拦截了非手机号,又具备良好的前瞻性,未来工信部在 13~19 范围内下发新号段时无需频繁修改代码。
4. \d{9} 元字符与精确重复量词(Meta Character & Quantifier)
这部分由元字符 \d 和量词限定符 {9} 组合而成:
\d:等价于字符集[0-9],匹配任意一个 ASCII 数字(0 到 9 之间)。{9}:属于花括号量词,表示前置匹配项必须精确连续出现 9 次,不能多也不能少。
由于前两位(1 和 [3-9])已经固定消耗了 2 个字符,11 位号码扣除前 2 位后正好剩余 9 位。通过 \d{9},引擎强制要求后续必须由 9 个纯数字填满。如果将 {9} 误写为 +(一次或多次)或 *(零次或多次),将彻底丧失对手机号位数的控制能力。
5. $ 行尾锚点(End Anchor)
符号 $ 是与 ^ 遥相呼应的另一个零宽断言,用于匹配字符串的最右侧结束位置。它要求在完成前述全部字符的匹配后,文本必须立即宣告结束,右侧不得残留任何多余内容。
若缺少 $,形如 ^1[3-9]\d{9} 的正则只要前 11 位合规即可,例如 "13812345678extra_info" 或 12 位长数字 "138123456789" 都会被引擎视作匹配成功。只有首尾双锚点同时存在,才能构成完整的“全词精确匹配闭环”。
三、正则引擎的匹配执行流程
当调用 JavaScript 的 RegExp.prototype.test() 执行校验时,引擎内部的状态机是按从左往右的顺序逐步驱动比对的。理解这一底层步骤,有助于直观把握引擎的短路机制。
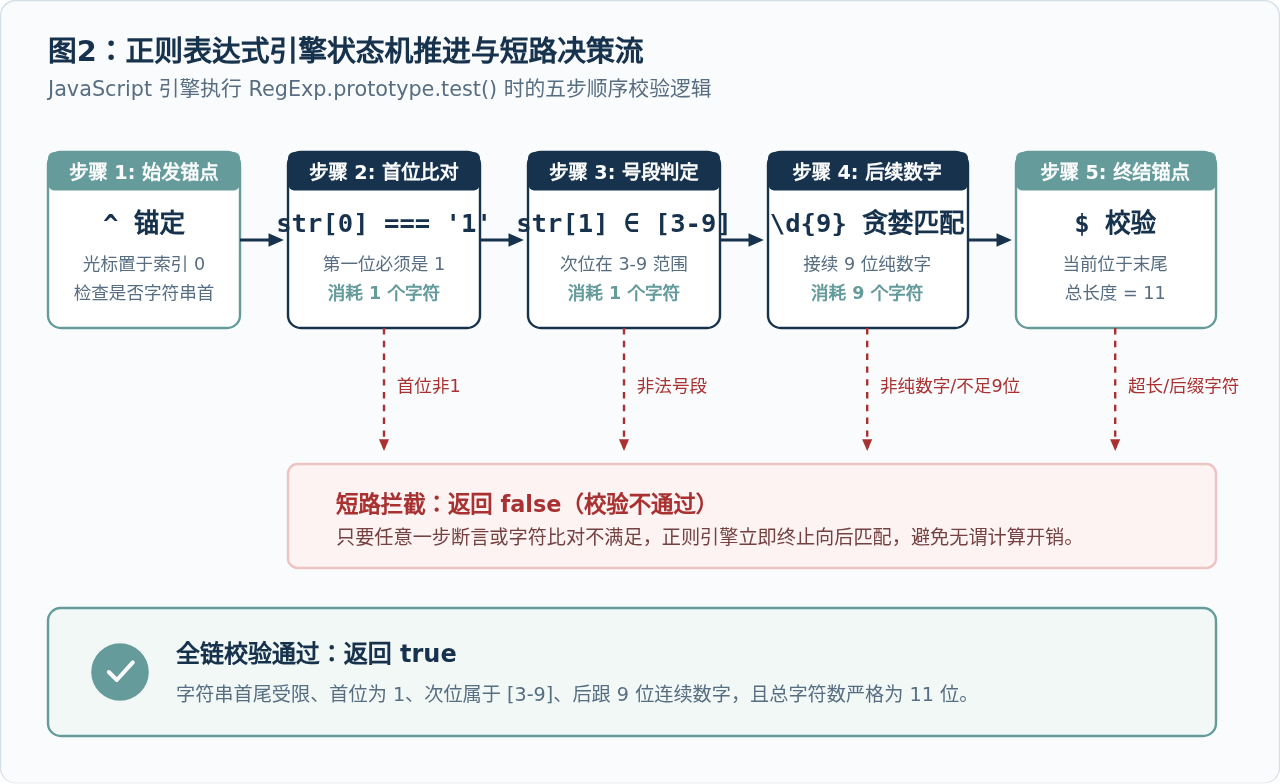
整个匹配流程遵循快速失败(Fail-Fast)原则:
- 位置复位:引擎定位至字符串首字符位置(索引 0);
- 首字符检查:比对索引 0 处的字符是否恒等于
'1'。若不匹配,直接退出并返回false; - 第二字符检查:比对索引 1 处的字符是否属于
'3'~'9'。若属于则指针后移,否则立即返回false; - 连续 9 位遍历:逐个检查索引 2 到索引 10 的字符是否全为
[0-9]。中间任何一位遇到非数字或文本提前终止,立即短路失败; - 终点断言:检查指针当前是否恰好位于字符串终点(索引 11,即文本尾部)。若尾部仍有残留字符则断言失败,全部通过则返回
true。
四、常见边界用例对比分析
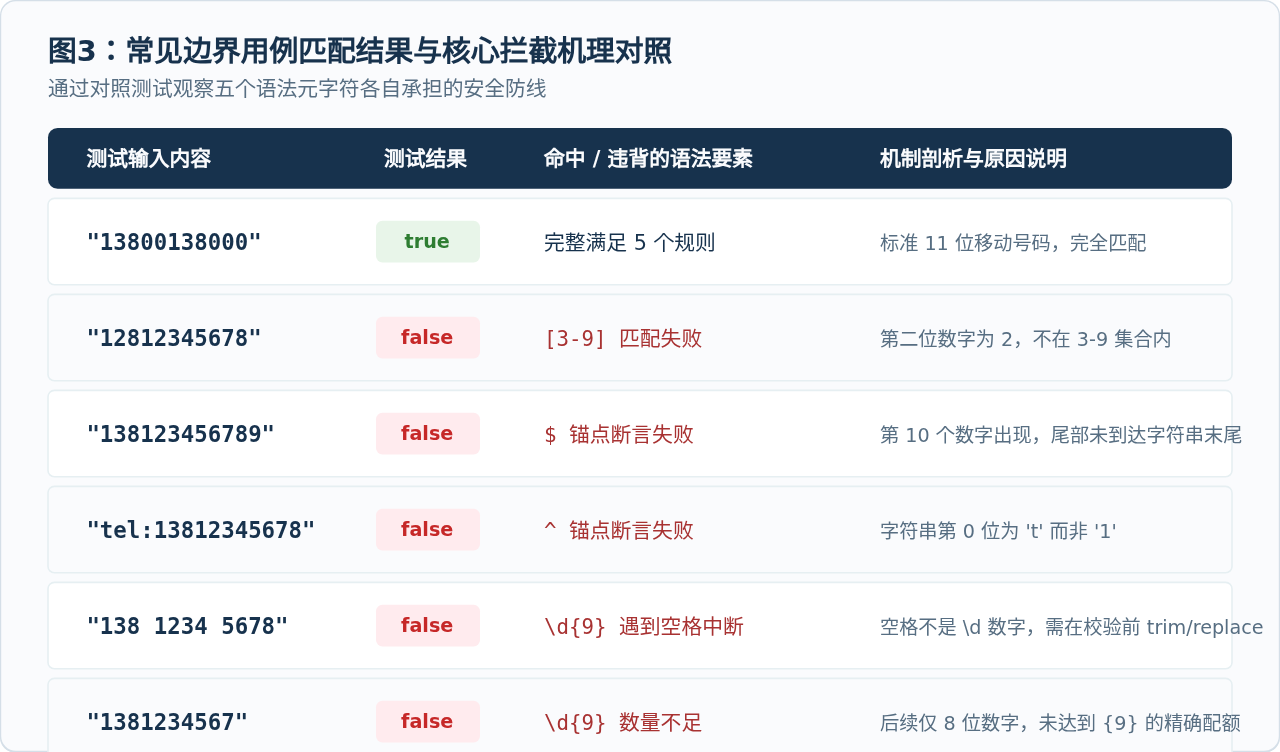
在表单验证或数据清洗过程中,用户输入的数据往往包含各种畸形格式。通过下面的对照矩阵,可以清晰看出各个语法单元是如何发挥“拦截哨兵”作用的。
特别提醒:空格与分隔符预处理
许多移动端输入法或第三方接口可能会在手机号中间自动填充空格或连字符(例如 "138 1234 5678" 或 "138-1234-5678")。由于 \d 严格限定为 ASCII 纯数字,这类带有排版分隔符的字符串会直接被判定为 false。在执行正则校验前,应当在代码中先行剔除所有非数字字符或执行空白清洗。
五、JavaScript 实战代码与工程避坑指南
在实际的前端工程或 Node.js 服务端逻辑中,使用该正则有几个极其重要的编码细节需要格外注意。
1. 标准验证函数封装示例
下面是一个经过防御性处理的手机号格式校验函数:
/**
 * 校验是否为合规的中国大陆 11 位手机号码
 * @param {string} phone - 待检测的手机号码输入
 * @returns {boolean}
 */
function isValidChineseMobile(phone) {
  // 1. 防御性类型检查
  if (typeof phone !== 'string') {
    return false;
  }

  // 2. 清洗用户可能误输入的两端多余空白字符
  const cleaned = phone.trim();

  // 3. 执行严格的全字符串正则匹配
  const mobileRegex = /^1[3-9]\d{9}$/;
  return mobileRegex.test(cleaned);
}

// 测试验证
console.log(isValidChineseMobile("13812345678")); // true
console.log(isValidChineseMobile(" 13988889999 ")); // true(经 trim 清洗)
console.log(isValidChineseMobile("12812345678")); // false(号段非法)
console.log(isValidChineseMobile("138123456789")); // false(12位超长)
2. 致命陷阱:千万不要在表单验证中添加全局修饰符 /g
高频踩坑:带有 /g 标志导致的奇偶交替失效
在 JavaScript 中,如果为正则表达式附加了全局匹配修饰符 /g,该正则对象就会变成有状态对象(Stateful)。引擎每次调用 test() 并在匹配成功后,会将正则对象的 lastIndex 属性更新为上一次匹配成功的末尾索引(此时为 11)。
当同一个带 /g 的正则实例去校验下一个相同合法号码时,它会从 lastIndex = 11 开始向后找,直接导致第二次验证莫名其妙地返回 false!第三次又重置为 0 返回 true,出现极其难以排查的“偶数次失败、奇数次成功”Bug。
// ❌ 错误示范:带 /g 标志的正则
const badRegex = /^1[3-9]\d{9}$/g;
console.log(badRegex.test("13812345678")); // true,此时 badRegex.lastIndex 变为 11
console.log(badRegex.test("13812345678")); // false!从索引 11 开始匹配失败,重置为 0
console.log(badRegex.test("13812345678")); // true!

// ✅ 正确做法:表单校验始终不要带 /g 标志
const goodRegex = /^1[3-9]\d{9}$/;
console.log(goodRegex.test("13812345678")); // true
console.log(goodRegex.test("13812345678")); // true
3. 构造函数中的双重转义(Double Escaping)
如果你使用 new RegExp() 动态构造正则表达式,传入的参数是普通字符串,而字符串字面量中的反斜杠 \ 本身就是转义字符。在字符串中写 "\d" 会被 JavaScript 词法解析器直接转义为字符 "d",导致最终正则变成了 ^1[3-9]d9$(要求后面连续出现 9 个英文字母 'd')。
因此,在构造函数中必须写成双反斜杠 \d:
// ❌ 错误:反斜杠被字符串转义吃掉
const wrong = new RegExp("^1[3-9]\d{9}$"); // 实际等同于 /^1[3-9]d{9}$/

// ✅ 正确:显式双重转义
const correct = new RegExp("^1[3-9]\\d{9}$");
4. 业务边界认知:格式合规 ≠ 真实有效
必须认识到:^1[3-9]\d{9}$ 解决的是结构合规性(Structural Validity),而不是真实归属性(Real-world Existence)。
例如,13800000000 在语法格式上完全符合该正则表达式,但在运营商系统中可能是一个从未下发或已经停机的空号。前端通过正则表达式校验,首要目标是快速拦截用户的粗心笔误(如漏输一位、误夹杂字母、输入了座机号码),降低后端无效请求量;若业务需要确认该手机号真实属于当前操作者且正常在网,必须依赖短信验证码(SMS OTP)或运营商一键登录服务完成最终闭环。
六、核心总结与知识速查
为了方便日常开发查阅,下图将 ^1[3-9]\d{9}$ 的核心机制与工程实施要点汇总为结构化速查卡片:
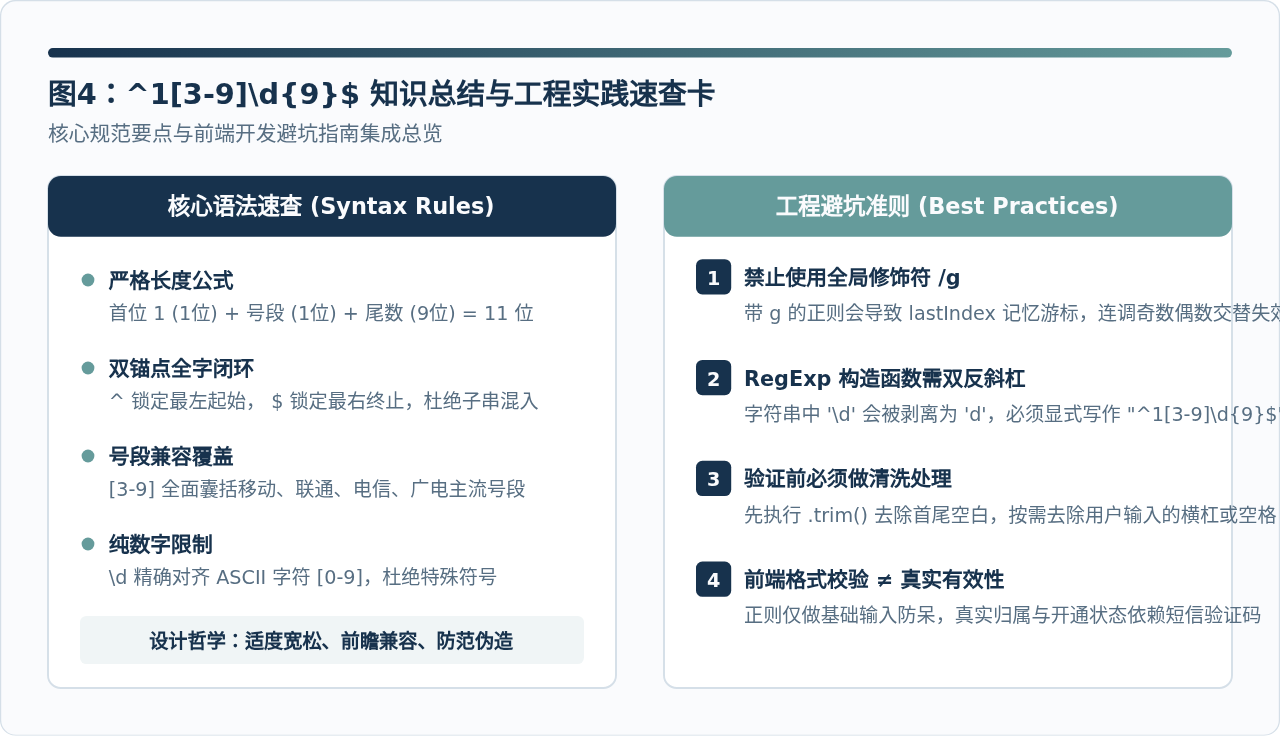
总结来说,^1[3-9]\d{9}$ 的设计精髓在于适度约束与前瞻兼容并存。它既没有使用生硬的 138|139|150... 庞大枚举表导致未来新号段发布时代码失效,也没有过于宽泛地使用 ^\d{11}$ 放行无效号码。在绝大多数 Web 应用、移动端 App 和小程序表单场景中,它都是性价比最高、最稳健的首选验证方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章