
本文深入讲解在Node.js中如何使用fast-xml-parser库高效解析XML,涵盖依赖安装、格式校验、核心参数调优、数组歧义解决、大文件流式处理及常见陷阱防范。

当前位置:首页 > Node.js 性能优化 > 正文
Node.js中怎么使用fast-xml-parser高效解析XML
作者:接口漫谈
时间:2026-11-17
浏览:257
文章目录
在 Node.js 中处理第三方接口对接、传统企业服务以及配置文件时,XML 解析是一项常见却经常引发性能瓶颈的任务。
fast-xml-parser 是目前 Node.js 生态中纯 JavaScript 编写的高吞吐解析器,它无原生 C/C++ 依赖绑定,通过精简的词法分词(Tokenizer)直接映射 JavaScript 对象。本文将按照“安装接入、格式校验、核心解析参数调优、数组歧义解决、大文件流式处理及常见陷阱防范”的完整实战路径,带你掌握如何在生产环境中高效率、低内存地解析 XML。
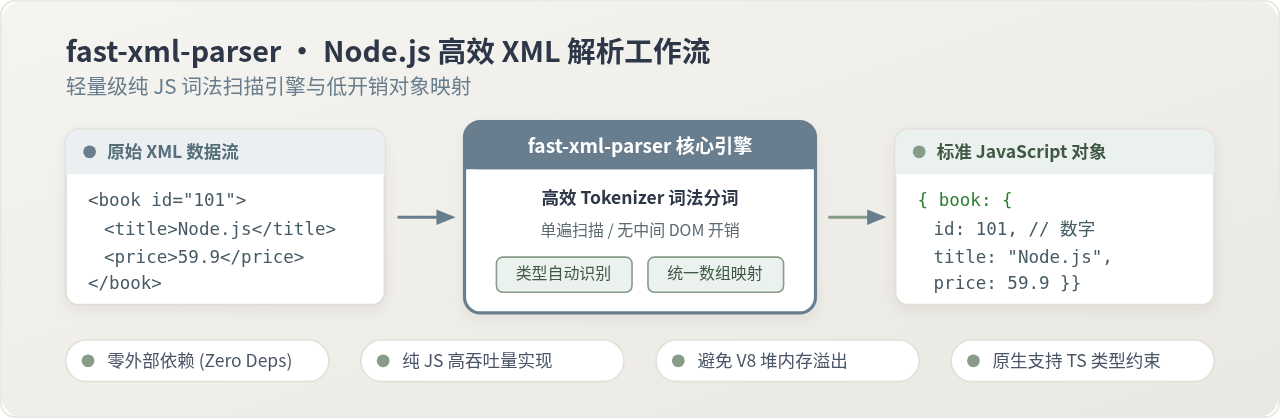
fast-xml-parser 解析管道概览:从原始 XML 到结构化 JavaScript 对象
一、快速了解:为什么选择 fast-xml-parser
在 Node.js 生态中,历史上广为使用的解析库是 xml2js。然而,随着高并发微服务和海量报文处理场景的增加,传统解析器的弊端逐渐显现。理解两者的根本差异,有助于根据业务特征做出合理的技术选型:
| 对比维度 | 传统方案 (如 xml2js) | fast-xml-parser | 关键影响 |
|---|---|---|---|
| 底层实现机制 | 基于 SAX 事件模型驱动,生成深层 DOM 包装树 | 线性词法扫描(Tokenizer),直接生成扁平键值对象 | 减少 60% 以上的中间层垃圾对象分配,降低 V8 GC 压力 |
| API 调用形态 | 以异步回调(Callback)或 Promise 为主 | 原生同步调用,直接返回目标对象 | 规避微任务队列调度开销,执行吞吐量提升 3~8 倍 |
| 数据类型推断 | 默认值全为纯字符串,需二次遍历转换 | 内置标量解析器,扫描时就地转换为数字、布尔等类型 | 消除下游业务代码冗长的类型转换逻辑 |
| 外部依赖 | 依赖 sax 等多层中间包 | 零外部运行时依赖(Zero Dependencies) | 更轻的 node_modules 体积与更小的供应链安全风险 |
对于绝大多数 Web 服务、网关转发及报文解析场景,fast-xml-parser 能够在同等 CPU 与内存开销下承载更高的请求量。
二、安装与环境准备
fast-xml-parser 遵循语义化版本发布,当前主流版本为 v4(API 全面重构为类架构)。在任何安装了 Node.js(推荐 LTS 16+、18+ 或 20+)的项目根目录下,执行如下命令安装依赖:
npm install fast-xml-parser
安装完成后,可以在代码中按需解构引入 XMLParser(核心解析器)与 XMLValidator(格式校验器)。该库原生提供 TypeScript 类型定义,支持 CommonJS 与 ES Module:
// CommonJS 规范
const { XMLParser, XMLValidator } = require('fast-xml-parser');

// 或 ES Module / TypeScript 规范
// import { XMLParser, XMLValidator } from 'fast-xml-parser';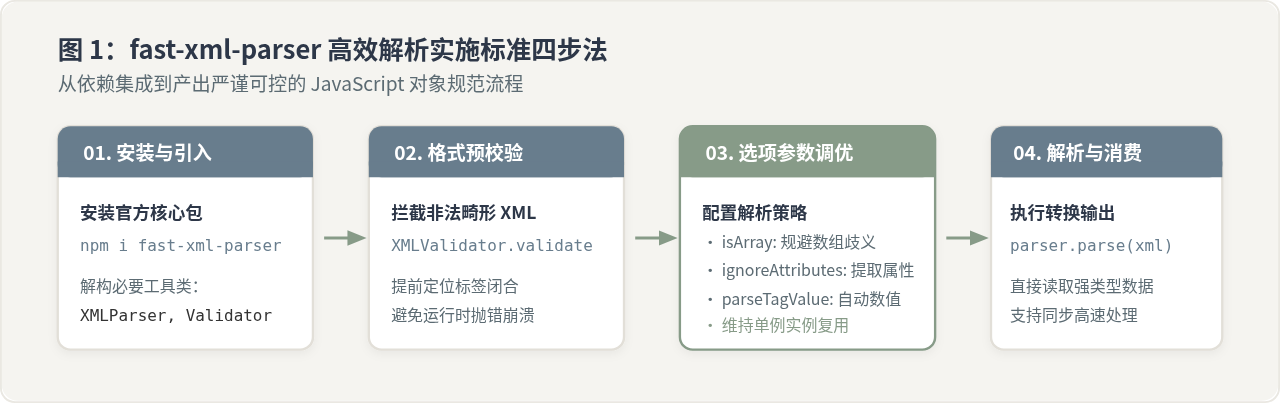
图 1:fast-xml-parser 高效解析实施标准四步法
三、基础解析流程:从验证到对象提取
高吞吐服务的第一道防线是报文合法性检查。在将可能包含畸形标签的 XML 文本送入解析器前,建议先使用 XMLValidator.validate 进行廉价校验。
const { XMLParser, XMLValidator } = require('fast-xml-parser');

// 示例待解析 XML 文本
const xmlData = `
<order id="PO-2026-001" status="completed">
  <customer>
    <name>张三</name>
    <email>zhangsan@example.com</email>
  </customer>
  <items>
    <item>
      <sku>KB-01</sku>
      <quantity>2</quantity>
      <price>199.50</price>
    </item>
  </items>
</order>`;

// 步骤 1:格式校验
const validationResult = XMLValidator.validate(xmlData);
if (validationResult !== true) {
  console.error('XML 格式不合法:', validationResult.err);
  process.exit(1);
}

// 步骤 2:初始化解析器(使用默认选项)
const parser = new XMLParser();

// 步骤 3:执行同步解析
const result = parser.parse(xmlData);
console.log(JSON.stringify(result, null, 2));
示例输出 (默认配置下)
{
  "order": {
    "customer": {
      "name": "张三",
      "email": "zhangsan@example.com"
    },
    "items": {
      "item": {
        "sku": "KB-01",
        "quantity": 2,
        "price": 199.5
      }
    }
  }
}
从输出可以看出,fast-xml-parser 默认将 quantity 解析为了数字 2,将 price 解析为了浮点数 199.5。但是,标签上的 id 和 status 属性却丢失了,且单个 item 被直接映射为了对象而非列表。为了满足工业级应用,必须进入配置调优阶段。
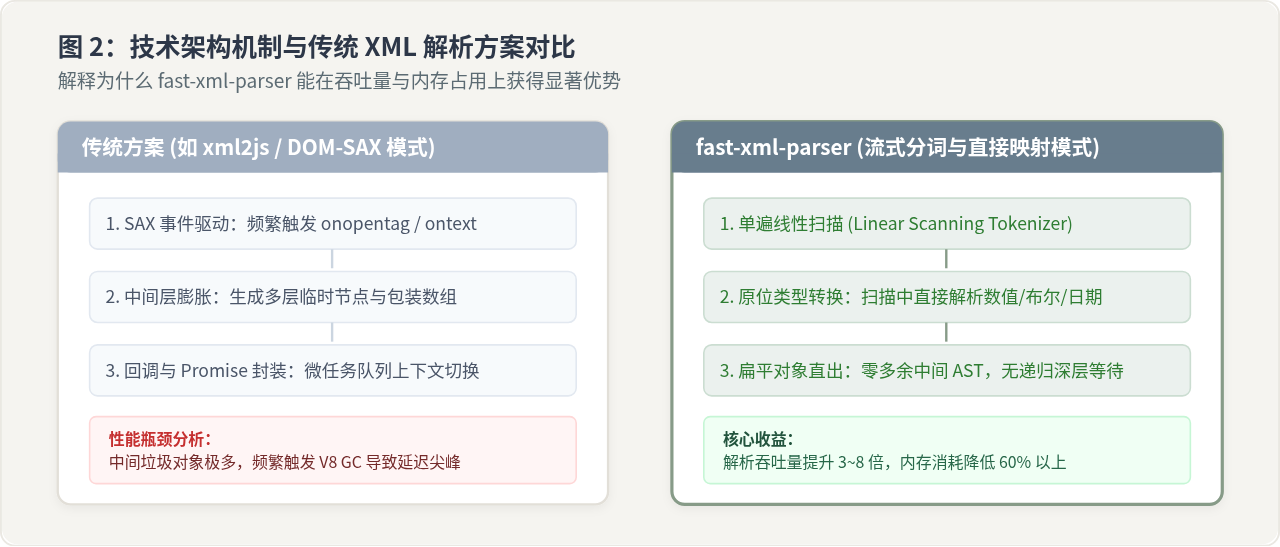
图 2:技术架构机制与传统 XML 解析方案对比
四、核心配置调优:消除数据歧义与规整化输出
真实业务场景中,XML 解析最令人头疼的问题往往是“数据结构的动态变化”。例如:当返回一条订单项时,节点被解析为单个对象;当返回两条订单项时,节点被解析为数组。如果下游代码直接调用 result.items.item.forEach(...),在单条数据时就会抛出 TypeError: ...forEach is not a function 致命异常。
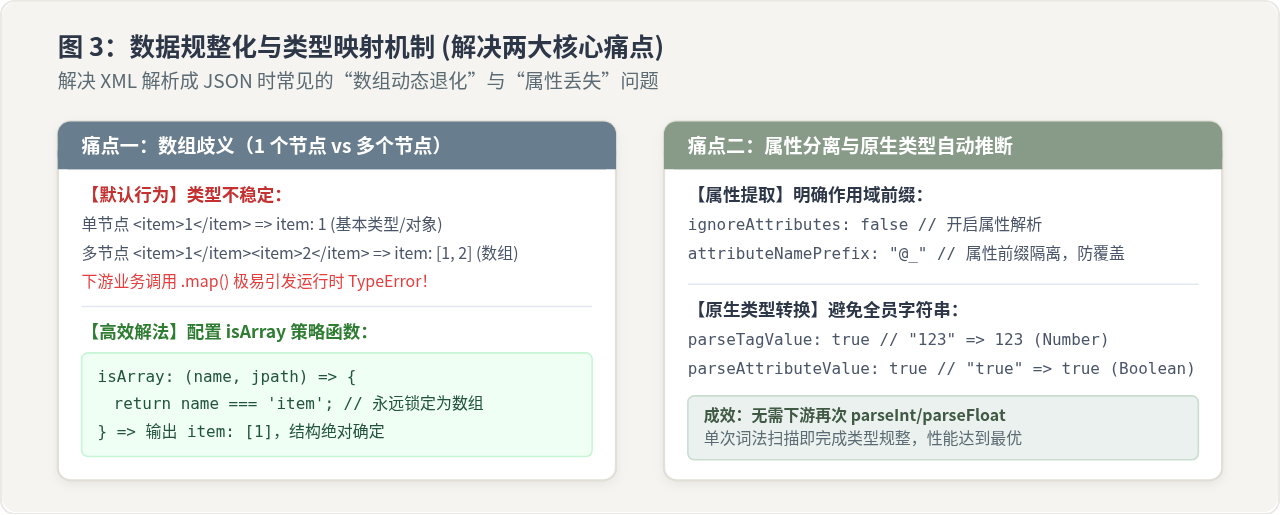
图 3:数据规整化与类型映射机制 (解决两大核心痛点)
1. 强制数组映射:isArray 规则函数
通过提供 isArray 选项回调,可以精确指定哪些标签或路径必须始终保持数组形式,无论 XML 报文中包含 0 个、1 个还是多个子标签。
2. 保留并隔离节点属性:ignoreAttributes 与 attributeNamePrefix
将 ignoreAttributes 设为 false 即可保留属性;配合 attributeNamePrefix: "@_",能够有效防止节点属性与同名子标签产生命名冲突。
3. 原生类型转换:parseAttributeValue 与 parseTagValue
默认情况下,标签体文本会自动转换类型,而属性值通常保持字符串。如果希望属性中的数值(如 id="101")和布尔值(如 active="true")同样转换为对应 JavaScript 原生类型,需开启 parseAttributeValue: true。
以下是生产级推荐的标准配置范例:
const { XMLParser } = require('fast-xml-parser');

const options = {
  // 1. 保留属性并添加 @_ 前缀隔离
  ignoreAttributes: false,
  attributeNamePrefix: '@_',

  // 2. 标签文本与属性值均进行原生标量类型推断 (Number, Boolean)
  parseTagValue: true,
  parseAttributeValue: true,

  // 3. 去除文本首尾空白字符
  trimValues: true,

  // 4. CDATA 节点专门存储属性名
  cdataPropName: '__cdata',

  // 5. 核心:统一数组输出规则,彻底解决单条/多条数据结构不一致问题
  isArray: (tagName, jPath, isLeafNode, isAttribute) => {
    // 当标签名为 item 时,无论出现多少次均以 Array 承载
    if (tagName === 'item') return true;
    return false;
  }
};

const configuredParser = new XMLParser(options);
const safeResult = configuredParser.parse(xmlData);

console.log(JSON.stringify(safeResult, null, 2));
示例输出 (优化配置后)
{
  "order": {
    "@_id": "PO-2026-001",
    "@_status": "completed",
    "customer": {
      "name": "张三",
      "email": "zhangsan@example.com"
    },
    "items": {
      "item": [
        {
          "sku": "KB-01",
          "quantity": 2,
          "price": 199.5
        }
      ]
    }
  }
}
关键效果提醒:开启
isArray 后,即使 XML 中只有一个 <item>,解析结果中的 safeResult.order.items.item 依然是标准数组。前端或下游逻辑可以无顾虑地使用 .map() 或 .filter(),不再需要编写 Array.isArray(x) ? x : [x] 的样板防御代码。
五、生产级高吞吐与大文件流式解析实践
1. 坚决避免在请求处理周期中重复 new XMLParser
XMLParser 的构造函数会执行配置项解析、内部正则表达式编译与处理链组装。在 Express/Koa/NestJS 等服务端框架中,务必在模块顶层创建解析器单例,并在所有并发请求中复用此单例:
// 正确做法:模块级别单例复用
// parserService.js
const { XMLParser } = require('fast-xml-parser');
const parser = new XMLParser({ /* 选项配置 */ });

module.exports = {
  parseXml: (xmlString) => parser.parse(xmlString)
};
2. 超大 XML 文件的流式分块解析
如果 XML 文件体积达到数百兆甚至几个 G(例如大型数据备份、离线交易流水),使用 fs.readFileSync 一次性将全部内容读入内存会导致 Node.js 触发 V8 堆内存溢出(JavaScript heap out of memory)。
对于超大文件,推荐利用 Node.js 原生 readline 或管道流配合 fast-xml-parser,在读取到业务块标签闭合时分段送入解析:
const fs = require('fs');
const readline = require('readline');
const { XMLParser } = require('fast-xml-parser');

async function processLargeXml(filePath) {
  const parser = new XMLParser({ ignoreAttributes: false });
  const fileStream = fs.createReadStream(filePath, { encoding: 'utf8' });

  const rl = readline.createInterface({
    input: fileStream,
    crlfDelay: Infinity
  });

  let recordBuffer = '';
  let insideRecord = false;
  let totalProcessed = 0;

  for await (const line of rl) {
    if (line.includes('<record>')) {
      insideRecord = true;
      recordBuffer = '';
    }

    if (insideRecord) {
      recordBuffer += line + '\n';
    }

    if (line.includes('</record>')) {
      insideRecord = false;
      // 局部单条解析,内存瞬时释放
      const recordObj = parser.parse(recordBuffer);
      totalProcessed++;

      // 业务处理逻辑,例如批量入库
      handleRecord(recordObj.record);
      recordBuffer = '';
    }
  }

  console.log(`处理完成,共处理记录: ${totalProcessed} 条`);
}

function handleRecord(record) {
  // 处理单条记录...
}
六、异常排查与常见错误防御
1. 实体扩展与外部实体防御 (XXE)
fast-xml-parser 本质上是面向数据的转换器,默认不解析外部 DTD 实体,从设计机制上规避了传统解析器常见的 XML 外部实体注入(XXE)漏洞。但对于不受信任的外部输入,仍需防范嵌套过深的畸形报文消耗 CPU 计算资源。
2. 常见报错及应对措施
- 报错:
TypeError: Cannot read properties of undefined
原因:XML 结构缺失某一层级(例如缺少<items>容器)。
应对:在访问前使用可选链操作符(Optional Chaining):result?.order?.items?.item。 - 校验报错:
Closing tag '...' is expected inplace of '...'
原因:标签未正确闭合或嵌套交叉。
应对:调用XMLValidator.validate(data)捕获err.line与err.col,在网关层直接向客户端返回 400 Bad Request 与定位信息,避免无谓进入复杂业务计算。
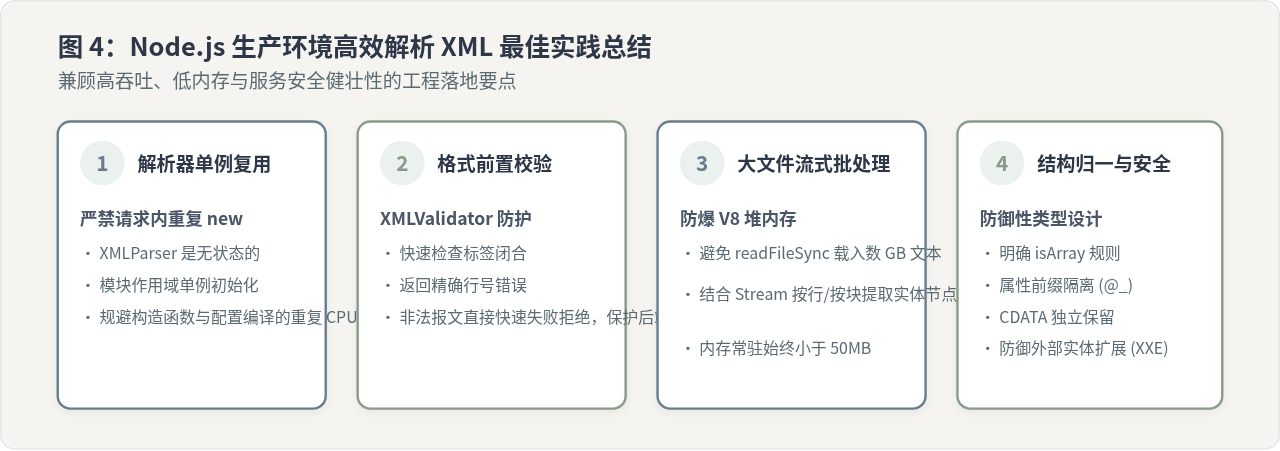
图 4:Node.js 生产环境高效解析 XML 最佳实践总结
七、总结与最佳实践清单
在 Node.js 中高效解析 XML 的核心在于:以轻量的解析引擎为基础,以单例复用和精准的映射配置为保障。在实际项目落地时,建议遵循以下清单执行:
- 优选引擎:在无特殊 DOM 操纵需求的常规场景下,优先选用
fast-xml-parser,享受零依赖与原生纯 JS 高吞吐红利。 - 前置校验:针对外部或非可信来源输入,先用
XMLValidator.validate进行快速扫描,尽早拦截语法错误。 - 结构归一:务必为数组类型的业务节点配置
isArray规则,彻底消除 1 个元素与 N 个元素时输出结构不一致的隐患。 - 资源保护:将
XMLParser实例保存在模块作用域单例复用;面对超大体量文件时采用流式拆块解析,让单机内存常驻保持在安全水准。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章