

本文详细讲解如何使用原生 JavaScript TextEncoder API 正确处理中文编码。涵盖 UTF-8 变长字节原理、encode 与 encodeInto 方法、内存优化技巧及中文截断乱码排查方案。
JavaScript TextEncoder API处理中文编码教程
作者:流萤
时间:2026-11-16
浏览:110
文章目录
假设你正在开发一个 WebSocket 实时聊天客户端或网络协议封包模块,服务端协议规定每个数据包由 4 字节的长度包头与后续字节载荷构成。如果直接拿 JavaScript 字符串的 str.length 计算包体大小,一旦文本包含中文,程序就会立即出现丢包或粘包解析失败。例如字符串 '你好' 的 length 是 2,但在网络实际传输中它占据了 6 个字节。浏览器和现代 JavaScript 运行时原生提供的 TextEncoder API,正是用于将包含中文等字符的字符串正确转换为标准 UTF-8 字节流的核心工具。本文将从底层编码差异、核心 API 步骤、零内存分配优化到常见乱码排查,完整介绍如何利用 TextEncoder 稳定处理中文编码。
一、为什么中文编码不能使用 string.length 计算
JavaScript 内部对字符串采用了 UTF-16 编码方式,每个字符单元(Code Unit)占用 2 个字节。在 UTF-16 下,绝大部分常用汉字(位于 Unicode 基本多文种平面 BMP 内)只需要一个 UTF-16 代码单元表示,因此 "汉".length 的结果是 1。然而在当今的网络通信、文件存储和加密算法(如 SHA-256、HMAC)中,事实上的通用传输标准是 UTF-8。
UTF-8 是一种变长字节编码标准:
- 标准英文字符(ASCII 范围
0x00 ~ 0x7F)占用 1 字节; - 希腊字母、阿拉伯文等扩展字符占用 2 字节;
- 汉字、日文假名及常用全角中文标点(范围
0x0800 ~ 0xFFFF)占用 3 字节; - 生僻汉字(如“𠮷”)或 Emoji 表情符号超出基本平面(范围
0x10000 ~ 0x10FFFF)则占用 4 字节。
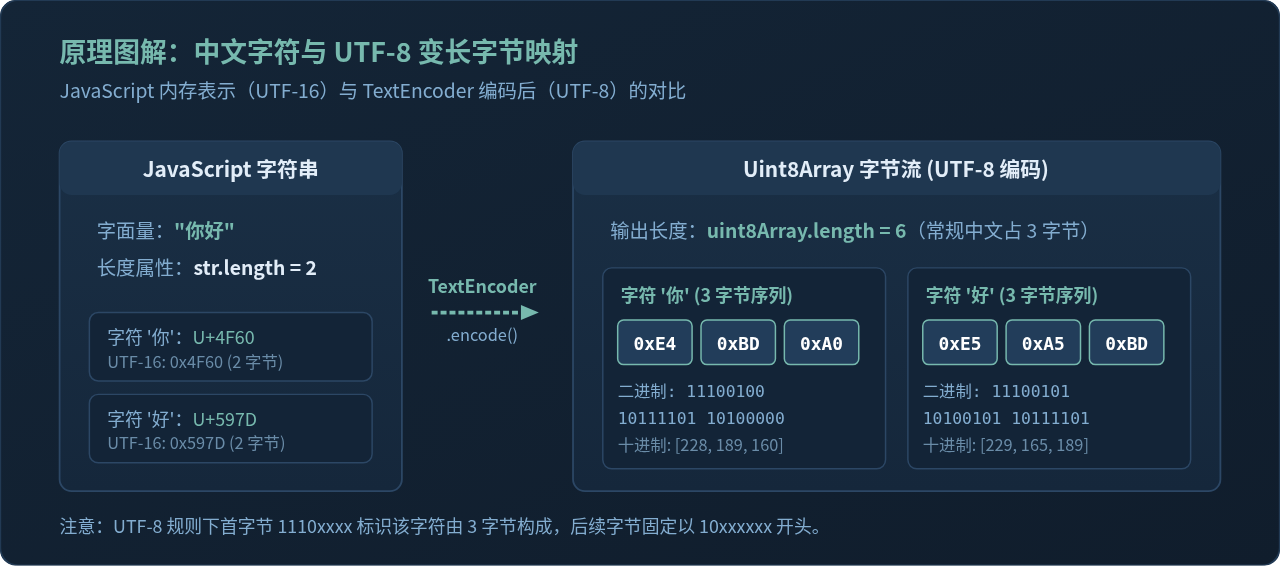
正如图 1 所示,汉字“你”在 Unicode 中的码点是 U+4F60,经过 UTF-8 规则转换后,被拆分成 3 个字节:0xE4、0xBD 和 0xA0。首字节 1110xxxx 明确告知解码器当前字符由 3 个字节拼接而成。因此,在任何需要按字节统计大小或向二进制通道发送数据的场景下,必须使用 TextEncoder 获取其实际字节长度。
二、TextEncoder API 基础使用与步骤演示
TextEncoder 遵循 WHATWG 编码规范,设计极为简洁。与历史遗留的各种第三方编码库不同,它作为宿主环境的原生接口,执行效率高且不需要外部依赖。
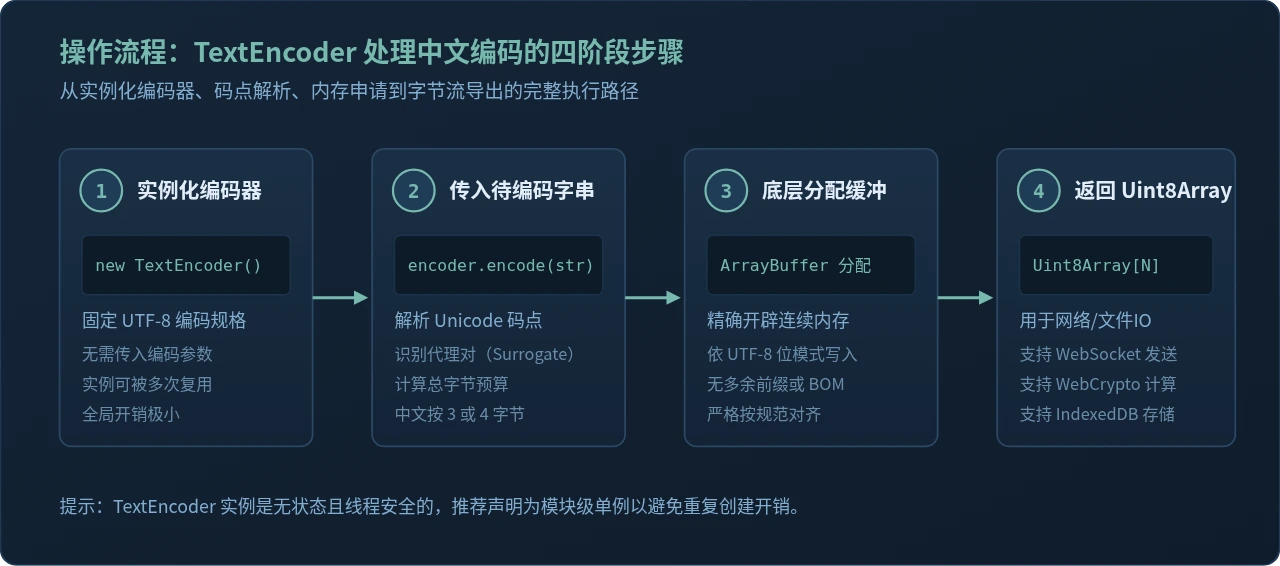
1. 实例化编码器
根据规范,TextEncoder 仅支持 utf-8 编码。它的构造函数不接收任何必选参数,调用方式如下:
const encoder = new TextEncoder();
// encoder.encoding 属性只读,恒为 "utf-8"
console.log(encoder.encoding); // 输出: "utf-8"
提示:由于
TextEncoder 是无状态的纯计算工具,同一个实例可以在整个应用生命周期中无限次复用,无需在每次编码时重新执行 new TextEncoder(),将其挂载为模块单例即可。
2. 使用 encode() 方法完成编码
encode() 接收一个字符串,返回一个全新的 Uint8Array 类型化数组,数组内容即为对应文本的 UTF-8 原始字节序列。
// 准备包含中文、英文与标点的混合字符串
const message = "你好,JavaScript!";
const encoder = new TextEncoder();

// 执行编码操作
const bytes = encoder.encode(message);

console.log("字符串长度 (str.length):", message.length);
// 示例输出: 14(3个汉字及全角逗号共4字符,加上10个英文字符)

console.log("实际 UTF-8 字节长度 (bytes.length):", bytes.length);
// 示例输出: 22(4个中文字符各占3字节=12字节,10个ASCII字符各占1字节=10字节,总计22)

console.log("生成的 Uint8Array:", bytes);
// 示例输出: Uint8Array(22) [228, 189, 160, 229, 165, 189, 239, 188, 140, 74, 97, 118, 97, 83, 99, 114, 105, 112, 116, 33]
3. 十六进制直观查看中文编码结果
为了直观观察字节内容,可以编写一个辅助函数将 Uint8Array 转为常见网络抓包工具展示的十六进制格式:
function toHexString(uint8Array) {
  return Array.from(uint8Array)
    .map(b => b.toString(16).padStart(2, '0').toUpperCase())
    .join(' ');
}

const cnBytes = encoder.encode("汉字");
console.log(toHexString(cnBytes));
// 示例输出: E6 B1 89 E5 AD 97
// 其中 E6 B1 89 代表“汉”,E5 AD 97 代表“字”
三、高性能场景:利用 encodeInto 避免内存二次分配
在普通业务逻辑中,encode() 已经足够简便好用。但在高吞吐场景(例如每秒数十万次的 WebSocket 游戏协议封包、音视频信令分发或长文本分片流式上传)中,encode() 每次调用都会在底层堆内存中新分配一个 ArrayBuffer 和 Uint8Array 包装对象。这种短生命周期小对象的密集创建,会引发 V8 虚拟机的频繁 Minor GC(垃圾回收暂停),造成应用卡顿。
为了解决该性能瓶颈,规范为 TextEncoder 提供了 encodeInto(string, destinationUint8Array) 方法。该方法允许将编码结果直接写入一个事先准备好的 Uint8Array 缓冲区中,实现真正的零堆内存分配(Zero Allocation)。
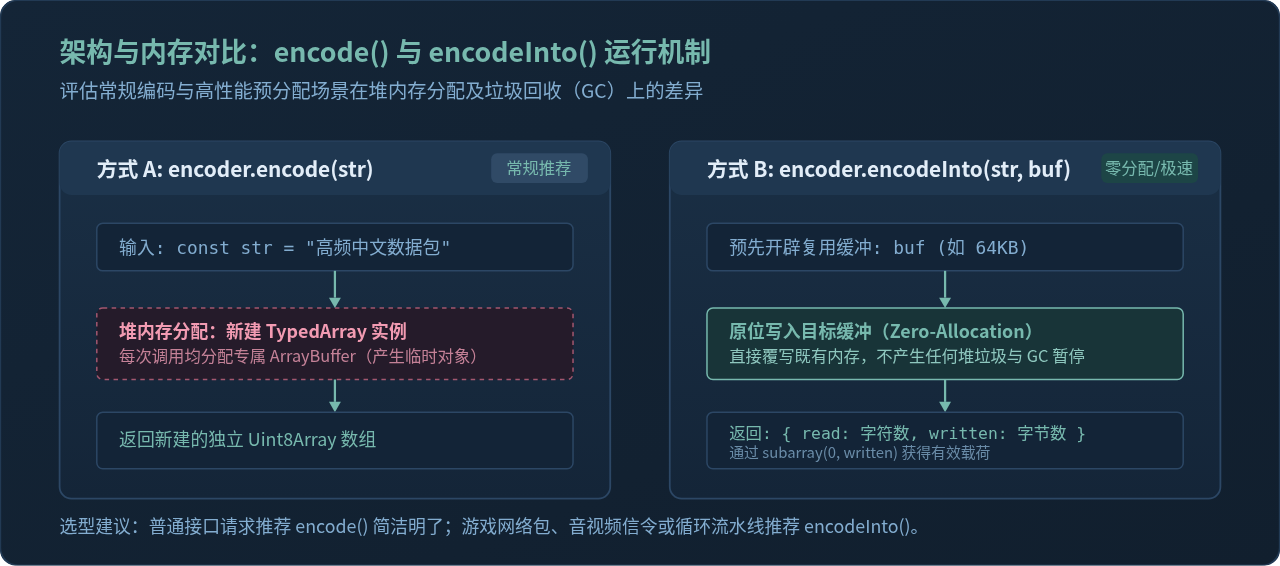
1. encodeInto 的运行机制与返回值
encodeInto 接受两个参数:待编码字符串与目标 Uint8Array 容器。它的执行过程是原位写入的,并返回一个包含两个状态指标的字典对象:
read:本次成功读取并转换的 UTF-16 字符数(代码单元数);written:本次实际向目标数组写入的 字节数。
2. 中文预分配缓冲区容量设置
由于中文字符可能占用 3 甚至 4 字节,预分配缓冲区的容量必须足够容纳最大可能字节数。最稳妥的预估公式是:str.length * 3(若包含大量 Emoji 或生僻字,可设置为 str.length * 4)。
const encoder = new TextEncoder();

// 模拟循环封包函数
function packChineseMessage(text) {
  // 1. 为目标缓冲区预估足够容量(常规中文按 length * 3 预留)
  const maxBytes = text.length * 3;
  const buffer = new Uint8Array(maxBytes);

  // 2. 原位编码写入
  const result = encoder.encodeInto(text, buffer);

  // 3. 查看读写状态
  console.log(`读取字符: ${result.read}, 写入字节: ${result.written}`);

  // 4. 使用 subarray 获得精确长度的有效视图(不产生内存复制)
  const payload = buffer.subarray(0, result.written);
  return payload;
}

const payload = packChineseMessage("高性能编码实战");
console.log("有效载荷长度:", payload.length); // 示例输出: 21 (7个汉字 * 3字节)
如果目标 Uint8Array 尺寸不足以装入全部内容,encodeInto 会在最后一个完整字符的边界处安全停下,并将 read 停在相应字符数,绝不会写入半个破损的 UTF-8 字符。开发者可以通过对比 result.read === text.length 判断是否完全写入。
四、中文编码常见问题排查与避坑指南
1. 字节流截断导致的中文乱码(U+FFFD 替换符)
在网络分片或数据库字段长度限制(如限长 100 字节)的业务中,开发者容易犯一个严重错误:先用 encode() 得到字节流,然后直接执行 bytes.slice(0, 100) 截取前 100 个字节。
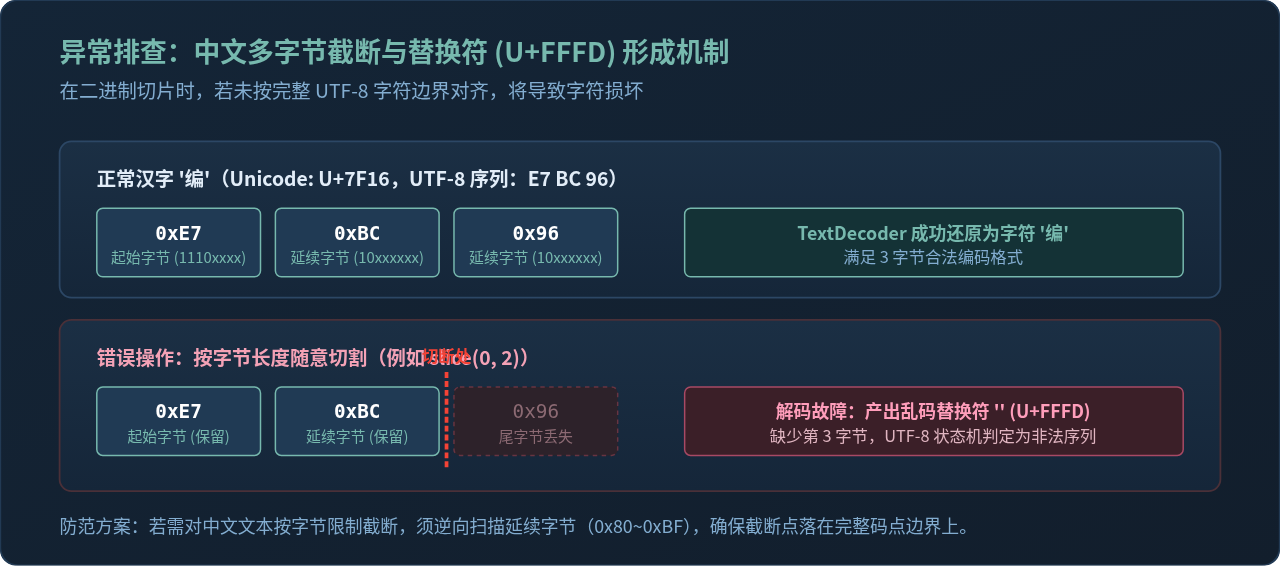
如果切断的位置恰好落在某个汉字的第 1 字节与第 2 字节之间,后续的 TextDecoder 在解析时将无法在剩余字节中找到合法的延续字节模式,状态机就会将这几个不完整的字节替换为 �(即显示为黑色菱形问号 ),导致永久性数据损坏。
避坑策略:若必须按最大字节数限制截断中文,应从切断点往前检查字节。若发现处于 0x80 ~ 0xBF(UTF-8 延续字节),说明切到了汉字中间,应继续向前回退直到跳过整个未闭合字符。
安全截断中文 UTF-8 字节的通用代码实现:
function safeTruncateUtf8(uint8Array, maxBytes) {
  if (uint8Array.length <= maxBytes) return uint8Array;

  let index = maxBytes;
  // UTF-8 规范:延续字节的高两位固定为 10,即 0x80 到 0xBF
  while (index > 0 && (uint8Array[index] & 0xC0) === 0x80) {
    index--;
  }
  // 此时 uint8Array[index] 是字符的首字节,若它的预定字节长度超出 maxBytes,则舍弃该首字节
  let firstByte = uint8Array[index];
  let needed = 1;
  if ((firstByte & 0xE0) === 0xC0) needed = 2;
  else if ((firstByte & 0xF0) === 0xE0) needed = 3; // 常用中文
  else if ((firstByte & 0xF8) === 0xF0) needed = 4; // 生僻汉字/Emoji

  if (index + needed > maxBytes) {
    return uint8Array.subarray(0, index);
  }
  return uint8Array.subarray(0, maxBytes);
}
2. TextEncoder 无法编码为 GBK / GB2312
初学者常常困惑:能否使用 new TextEncoder("gbk") 来支持老旧系统的 GBK 编码?
答案是否定的。W3C 规范中明确规定 TextEncoder 的唯一合法编码即为 utf-8。即便你在构造函数中传入参数 new TextEncoder("gbk"),该参数也会被忽略或直接抛出异常。相对地,TextDecoder 原生支持解码 GBK(例如 new TextDecoder("gbk")),但 编码端(Encoder)浏览器原生只开放 UTF-8。如果业务必须输出 GBK 字节数组,应引入轻量纯 JS 编码库(如 fast-text-encoding 或 iconv-lite 浏览器构建版)通过码表映射实现。
五、实战案例:网络二进制协议数据打包
为了加深理解,我们实现一个标准网络协议消息打包器。协议要求结构如下:
| 字段名称 | 偏移量 | 字节长度 | 说明 |
|---|---|---|---|
| 消息命令字 (OpCode) | 0 | 2 字节 | 大端序 Uint16,例如 0x1001 代表聊天消息 |
| 文本字节长度 (Length) | 2 | 2 字节 | 大端序 Uint16,标明后续 UTF-8 数据的实际字节数 |
| 消息正文 (Payload) | 4 | 变长 | TextEncoder 编码后的中文 UTF-8 字节流 |
const encoder = new TextEncoder();

function createProtocolPacket(opCode, textMessage) {
  // 1. 将中文消息转为 UTF-8 字节
  const textBytes = encoder.encode(textMessage);

  // 2. 计算完整封包长度: 包头(4字节) + 实际字节载荷
  const packetSize = 4 + textBytes.length;
  const buffer = new ArrayBuffer(packetSize);
  const view = new DataView(buffer);

  // 3. 写入 4 字节协议头(注意大端序网络字节序)
  view.setUint16(0, opCode, false);              // OpCode
  view.setUint16(2, textBytes.length, false);     // 中文实际字节长度

  // 4. 将中文字节序列写入载荷区
  const bodyView = new Uint8Array(buffer, 4);
  bodyView.set(textBytes);

  return new Uint8Array(buffer);
}

// 封包测试
const packet = createProtocolPacket(0x1001, "祝您编码愉快!");
console.log("完整封包长度:", packet.length);
// 示例输出: 25(包头4字节 + 7个中文字符*3字节=21字节)
六、知识总结
TextEncoder 作为 Web 标准生态中的核心编解码组件,彻底替代了早期前端依靠 encodeURIComponent 和 unescape 拼凑二进制流的非标 hack 方式。在处理中文编码时,理解字符集与编码的对应规律是写出健壮前端二进制交互代码的关键。
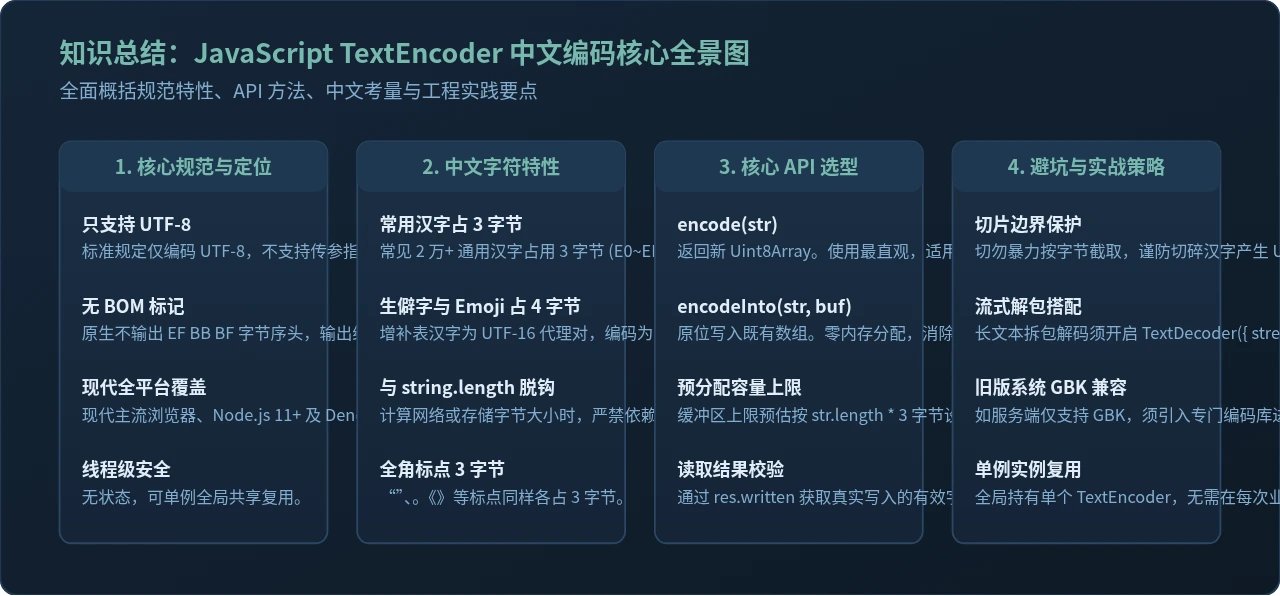
总结本教程的核心要点:
- 字节与字符分离:切勿使用
str.length代替中文字符串的二进制体积,标准中文在 UTF-8 下通常占 3 个字节。 - 选型适度:通用业务直接调用
encoder.encode(str)最为简便;高频管道通信优先采用encodeInto()实现零 GC 损耗。 - 防御式切片:严禁直接对中文字节数组按任意索引进行
slice切割,必须检测 UTF-8 码元边界,杜绝产生�乱码。 - 编码边界清醒:明确
TextEncoder仅输出标准 UTF-8,不支持传参输出 GBK,遇到遗留系统需借助专用码表库协同处理。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章