

深入解析JavaScript中btoa与atob内置函数的工作机制与限制,分析中文字符导致DOMException报错与乱码的根本原因,提供现代标准的TextEncoder/TextDecoder和兼容性URI转义两套完整解决方案与工程化封装。
JavaScript使用btoa和atob实现Base64编码解码及中文乱码解决
作者:流萤
时间:2026-11-16
浏览:550
文章目录
技术教程
Web标准API
适用环境:浏览器 / Node.js 16+
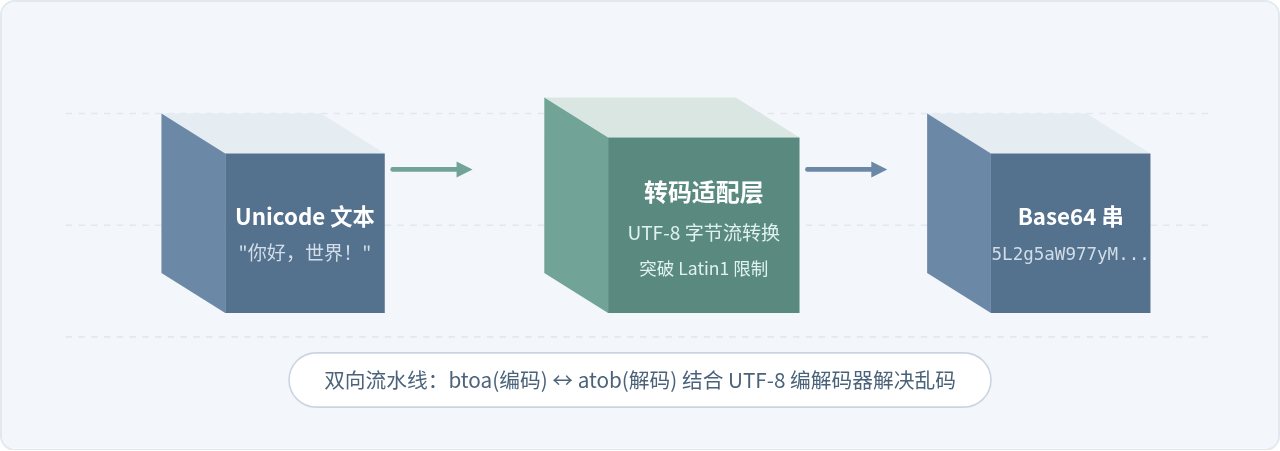
图 0:JavaScript Base64 编码解码与中文转码适配总体流程
在 JavaScript 开发中,window.btoa() 与 window.atob() 是浏览器原生的 Base64 编解码方法,但直接用它们处理包含中文的字符串时,会抛出 The string to be encoded contains characters outside of the Latin1 range 异常,或者在解码时出现混乱字符。解决该问题的核心在于:在执行 Base64 转换前,先将多字节的 Unicode 中文字符序列显式转换为单字节的 UTF-8 字节串,并在解码还原后重新按 UTF-8 规格组装字符。
一、核心解决方案:现代推荐写法与快速封装
针对现代浏览器和 Node.js(v16 及以上)环境,官方推荐的标准做法是使用 TextEncoder 和 TextDecoder API 配合 Uint8Array 进行二进制中转,既高效又完全符合 Web 标准规范。
以下为即插即用的封装函数,涵盖编码和解码两个方向:
/**
 * 将任意字符串(包含中文、Emoji等)安全编码为 Base64
 * @param {string} str 待编码字符串
 * @returns {string} Base64 字符串
 */
function utf8ToBase64(str) {
  // 1. 将字符串转为 UTF-8 字节流(Uint8Array)
  const bytes = new TextEncoder().encode(str);
  // 2. 将每个字节映射为单字节字符并组合为二进制字符串
  const binString = Array.from(bytes, (byte) => String.fromCharCode(byte)).join('');
  // 3. 调用原生 btoa 转换为 Base64
  return btoa(binString);
}

/**
 * 将 Base64 字符串安全解码还原为原字符串(支持中文)
 * @param {string} base64Str Base64 字符串
 * @returns {string} 解码后的原始字符串
 */
function base64ToUtf8(base64Str) {
  // 1. 调用原生 atob 解码为二进制字符串
  const binString = atob(base64Str);
  // 2. 从二进制字符串提取字节数组
  const bytes = Uint8Array.from(binString, (char) => char.charCodeAt(0));
  // 3. 使用 TextDecoder 按 UTF-8 规则解码回文本
  return new TextDecoder().decode(bytes);
}

// 示例运行
const originalText = "你好,世界!Hello 2026 🎉";
const encoded = utf8ToBase64(originalText);
console.log("编码结果:", encoded);
// 输出示例: 5L2g5aW977yM5LiW55WM77yISGVsbG8gMjAyNiDwn46J

const decoded = base64ToUtf8(encoded);
console.log("解码验证:", decoded === originalText); // true
二、底层剖析:为什么原生 btoa 和 atob 会报错或乱码?
为了理解上述转换的必要性,我们需要看清 btoa 与 atob 的设计历史与内部规范限制:
- 名称含义:
btoa代表 binary-to-ASCII(二进制转 ASCII 文本),而atob代表 ASCII-to-binary(ASCII 文本转二进制)。 - 输入契约:
btoa()接收的并不是通用的 Unicode 字符串,而是二进制字符串(Binary String)。在 JavaScript 规范中,这意味着传入字符串中每个字符的 Unicode 码点(Code Point)必须处于0x00至0xFF(即 0 到 255)之间,对应标准的 Latin-1 (ISO-8859-1) 字符集范围。 - 中文字符的码点超限:中文字符通常占用 3 个字节,其 Unicode 码点远超过 255。例如汉字“你”的 Unicode 码点是
U+4F60(十进制 20320),汉字“好”是U+597D(十进制 22909)。当btoa()发现字符码点大于 255 时,底层无法将其压缩映射进单字节,便会立即中断并抛出DOMException异常。
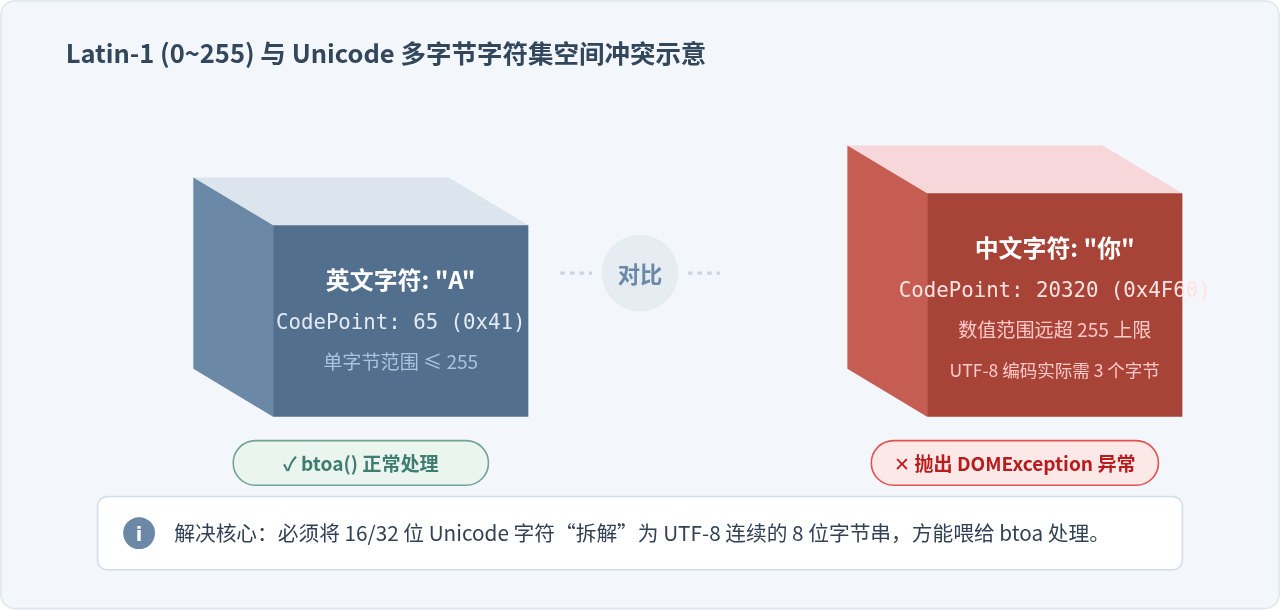
图 1:btoa() 底层 Latin-1 范围限制与中文字符越界原因剖析
三、分步推导:现代标准解法的运作流水线
现代标准方案的核心是借助浏览器自带的高性能流式文本编码组件。整个处理链条可以细分为以下三个确切的步骤:
-
文本转 UTF-8 字节(TextEncoder):
new TextEncoder().encode("中文")会根据 UTF-8 标准,将每个字符转换为 1 到 4 个字节的十进制数。例如“你好”两个字会被转换为一个包含 6 个字节的Uint8Array(6) [228, 189, 160, 229, 165, 189],所有值均严格落在0 ~ 255区间内。 -
字节流转二进制字符串(String.fromCharCode):
由于
btoa只接受字符串输入,我们需要将每个 8 位的无符号整数通过String.fromCharCode(byte)转为对应的单字节字符,然后拼接成长度为 6 的 Binary String。 -
Base64 计算(btoa):
接收符合 Latin-1 规范的字符串后,
btoa取出每 3 个字节(24 位)并划分为 4 组 6 位单元,查表生成标准的 Base64 ASCII 字符。
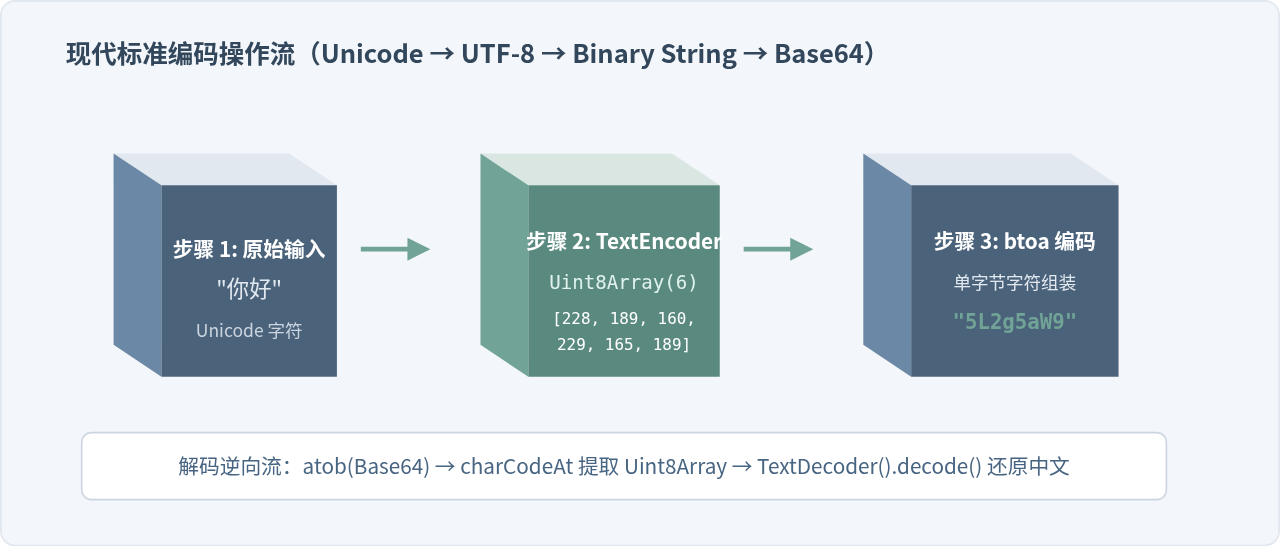
图 2:基于 TextEncoder 的字节级逐层转换与编解码步骤
大数据量调用栈优化提醒:
在处理数兆(MB)级别的大文本时,如果采用
String.fromCharCode.apply(null, bytes) 很容易触发 RangeError: Maximum call stack size exceeded。本文提供的 Array.from(bytes, callback).join('') 或分块迭代(chunking)能稳健处理大容量数据。
四、老旧环境兼容方案:基于 encodeURIComponent 的转义法
在一些不支持 TextEncoder 的老旧浏览器环境(例如早期的 IE 核心或陈旧的移动端 WebView)中,开发者常用 encodeURIComponent 作为折中方案。虽然该方法在现代项目中不作为首选,但了解其机制对维护存量项目极为重要。
1. 运作原理
encodeURIComponent 会将中文字符按照 UTF-8 编码为形如 %E4%BD%A0 的百分比编码。通过正则表达式 /%([0-9A-F]{2})/g,我们可以将每一个 %XX 提取出十六进制数值,再通过 String.fromCharCode(parseInt(hex, 16)) 转换回真正的单字节 Latin-1 字符,最后传入 btoa。
2. 兼容性代码实现
// 兼容方案:编码
function legacyUtf8ToBase64(str) {
  return btoa(
    encodeURIComponent(str).replace(/%([0-9A-F]{2})/g, function (match, p1) {
      return String.fromCharCode(parseInt(p1, 16));
    })
  );
}

// 兼容方案:解码
function legacyBase64ToUtf8(base64Str) {
  return decodeURIComponent(
    Array.prototype.map
      .call(atob(base64Str), function (c) {
        return '%' + ('00' + c.charCodeAt(0).toString(16)).slice(-2);
      })
      .join('')
  );
}

// 测试验证
const text = "中国智造";
const base64Code = legacyUtf8ToBase64(text);
console.log("兼容方案编码:", base64Code);
console.log("兼容方案解码:", legacyBase64ToUtf8(base64Code)); // 输出: 中国智造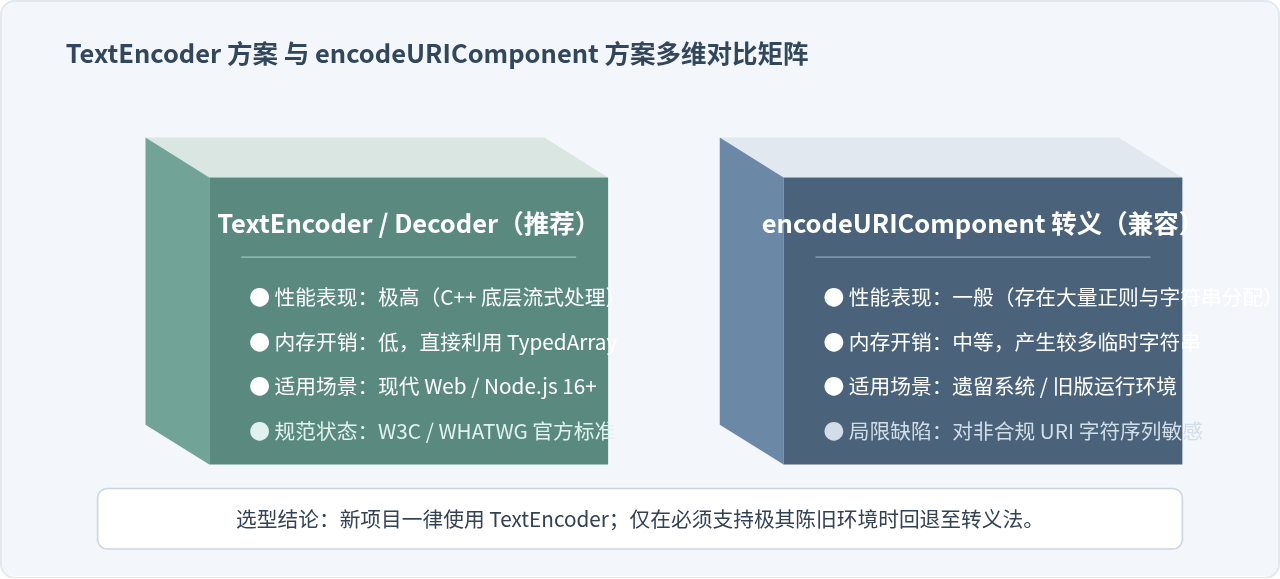
图 3:现代标准方案与传统转义方案特性对比矩阵
五、进阶实战:URL 安全型 Base64 与跨环境封装
在网络传输、JWT(JSON Web Token)或 URL 参数场景下,标准 Base64 包含的字符 +、/ 以及末尾的补位填充符 = 具有特殊语义,极易导致 URL 被解析截断。通常会采用 URL-Safe Base64(将 + 替换为 -,将 / 替换为 _,并省略尾部 =)。
同时,在 Node.js 环境中原生支持 Buffer 对象。以下给出适配 URL 安全模式并具备自动降级判断的工程级工具库:
/**
 * 跨平台工程级 Base64 工具包
 */
const Base64Helper = {
  /**
   * 编码:支持 Unicode、中文及 URL 安全模式
   */
  encode(str, urlSafe = false) {
    if (typeof str !== 'string') {
      str = String(str);
    }

    // 优先使用现代化 TextEncoder
    let base64;
    if (typeof TextEncoder !== 'undefined') {
      const bytes = new TextEncoder().encode(str);
      const binString = Array.from(bytes, (b) => String.fromCharCode(b)).join('');
      base64 = btoa(binString);
    } else if (typeof Buffer !== 'undefined') {
      // Node.js 原生 Buffer 极速通道
      base64 = Buffer.from(str, 'utf-8').toString('base64');
    } else {
      // 极端兼容回退
      base64 = btoa(encodeURIComponent(str).replace(/%([0-9A-F]{2})/g, (_, p1) =>
        String.fromCharCode(parseInt(p1, 16))
      ));
    }

    if (urlSafe) {
      return base64.replace(/\+/g, '-').replace(/\//g, '_').replace(/=+$/, '');
    }
    return base64;
  },

  /**
   * 解码:还原字符串(自动识别 URL 安全模式)
   */
  decode(base64Str) {
    if (!base64Str) return '';

    // 还原 URL 安全字符
    let standardBase64 = base64Str.replace(/-/g, '+').replace(/_/g, '/');
    // 补齐末尾缺失的 '=' 填充符
    while (standardBase64.length % 4) {
      standardBase64 += '=';
    }

    if (typeof TextDecoder !== 'undefined') {
      const binString = atob(standardBase64);
      const bytes = Uint8Array.from(binString, (c) => c.charCodeAt(0));
      return new TextDecoder().decode(bytes);
    } else if (typeof Buffer !== 'undefined') {
      return Buffer.from(standardBase64, 'base64').toString('utf-8');
    } else {
      return decodeURIComponent(
        Array.prototype.map.call(atob(standardBase64), (c) =>
          '%' + ('00' + c.charCodeAt(0).toString(16)).slice(-2)
        ).join('')
      );
    }
  }
};

// 验证用例
const sample = "前端架构与全栈实践:https://example.com/api?user=张三";
const safeB64 = Base64Helper.encode(sample, true);
console.log("URL安全 Base64:", safeB64);
console.log("解码校验还原:", Base64Helper.decode(safeB64) === sample); // true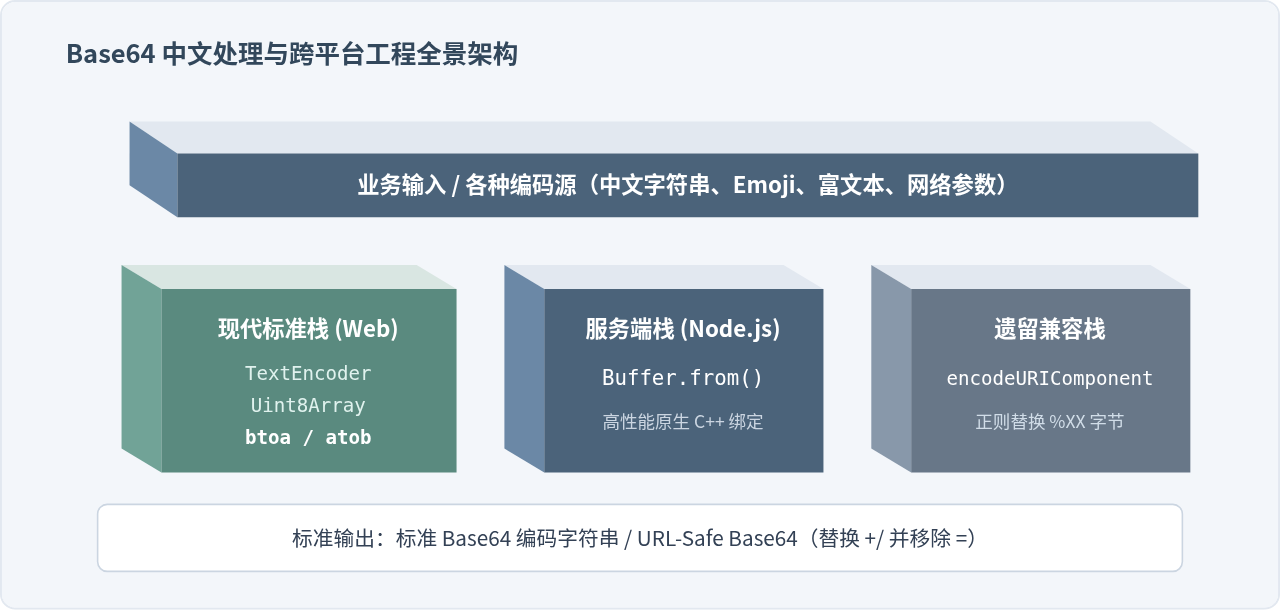
图 4:Base64 编解码全流程架构与跨环境支持概览
六、常见问题排查与注意事项
1. 解码时报“InvalidCharacterError”
当调用 atob() 时若抛出 Failed to execute 'atob' on 'Window': The string to be decoded is not correctly encoded,通常有两个原因:
- 含有非 Base64 字符:传入字符串中混入了换行符
\n、回车符\r或空格。调用前可使用base64Str.replace(/\s+/g, '')过滤空白符。 - 填充位(Padding)缺失:合法的 Base64 长度一定是 4 的整数倍。如果是 URL-Safe 模式裁剪了末尾的
=,必须先通过while (str.length % 4) str += '='补齐。
2. 解码中文仍显示乱码(例如变为 “ä½ å¥½”)
现象说明原始数据在编码时使用了 UTF-8 分割,但在解码时只调用了原生的 atob(),直接将 UTF-8 的 3 个单独字节强行以 ISO-8859-1(单字节字符)输出。必须确保解码阶段通过 TextDecoder 或逆向 decodeURIComponent 进行 UTF-8 重组。
3. 严禁用于密码加密
Base64 仅是一种数据编码格式,旨在使二进制数据能够在纯 ASCII 的文本协议(如 HTTP Header、邮件正文)中安全无损传输,不具备任何保密性或加密防护能力。涉及敏感凭据传输时,必须配合 HTTPS 以及标准的加解密算法(如 AES、RSA 或 Web Crypto API)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章