
深入对比JavaScript中字符串转数组常见方法(split、扩展运算符、Array.from、循环预分配)的内存占用特征、底层V8存储模型与选型建议。

当前位置:首页 > Node.js 性能优化 > 正文
js字符串转数组内存占用对比
作者:终端旅客
时间:2026-11-13
浏览:138
文章目录
JavaScript 底层机制与性能优化
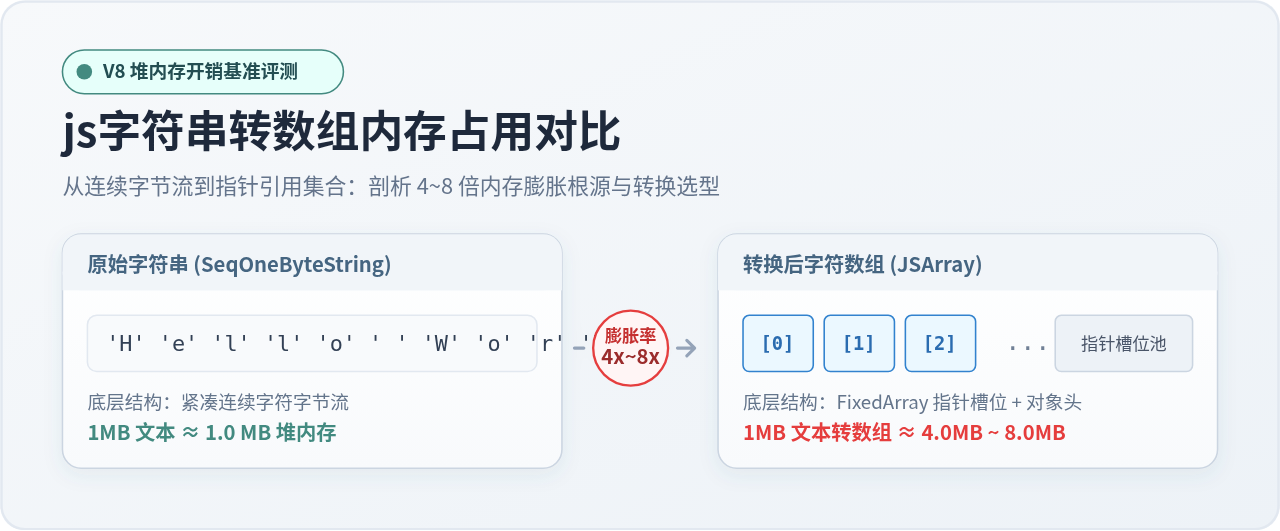
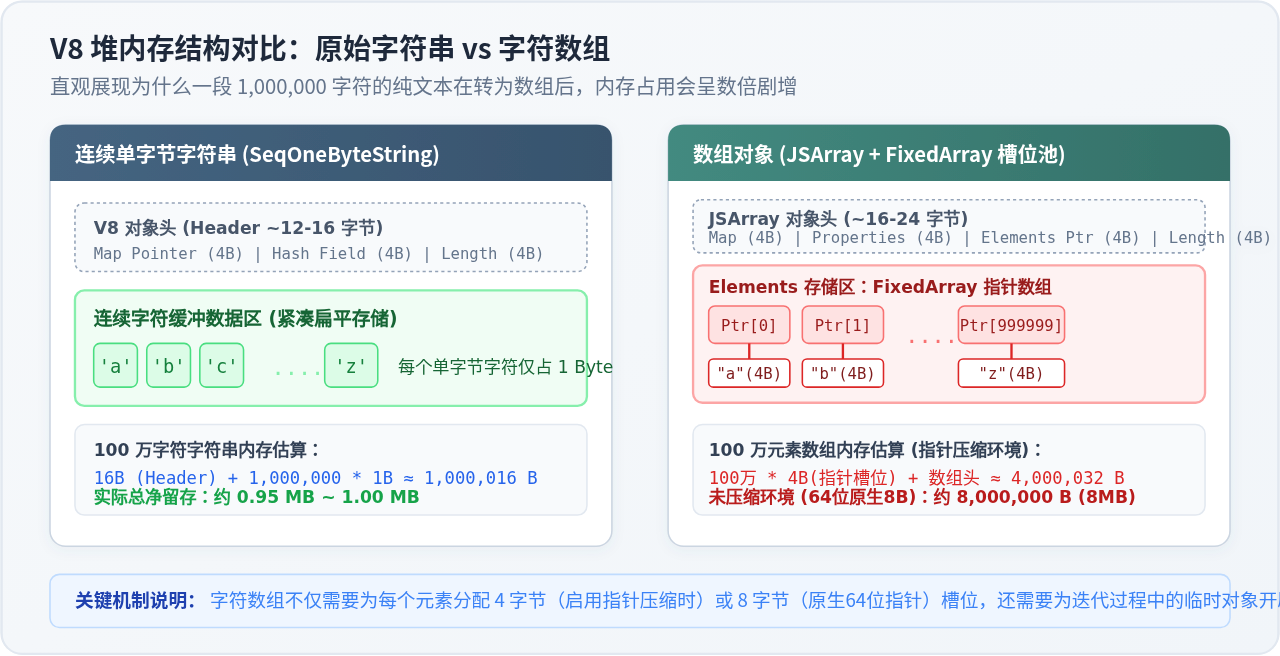
图 1:V8 引擎中连续单字节字符串与字符数组对象的物理内存布局对比
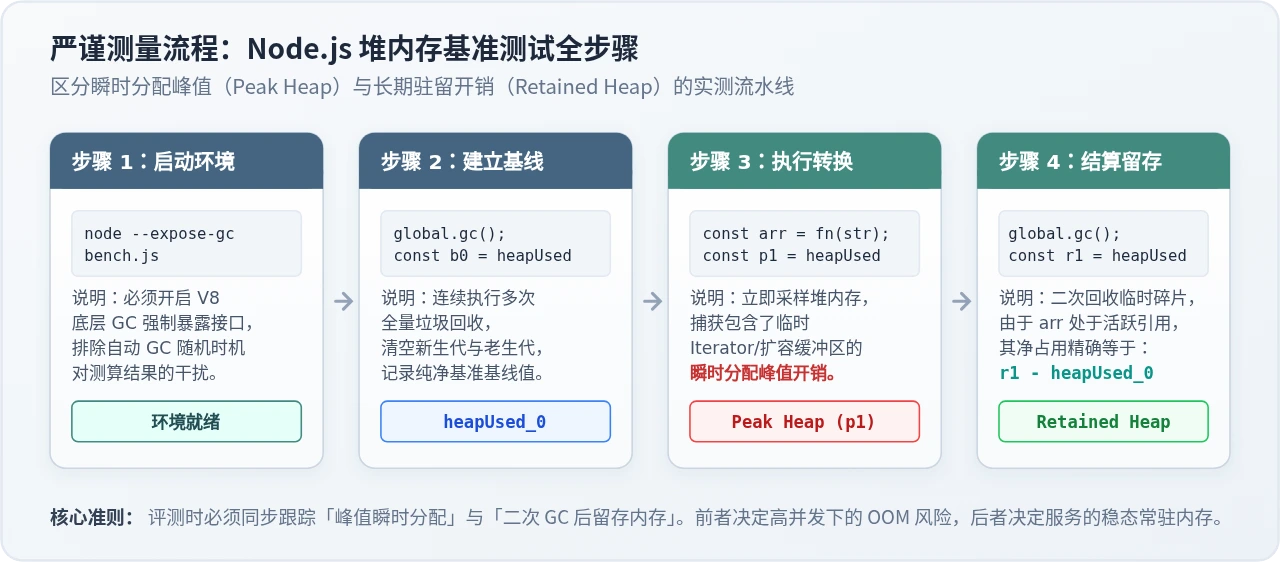
图 2:严谨区分瞬时峰值与最终持久留存的 Node.js 内存测量步骤流水线
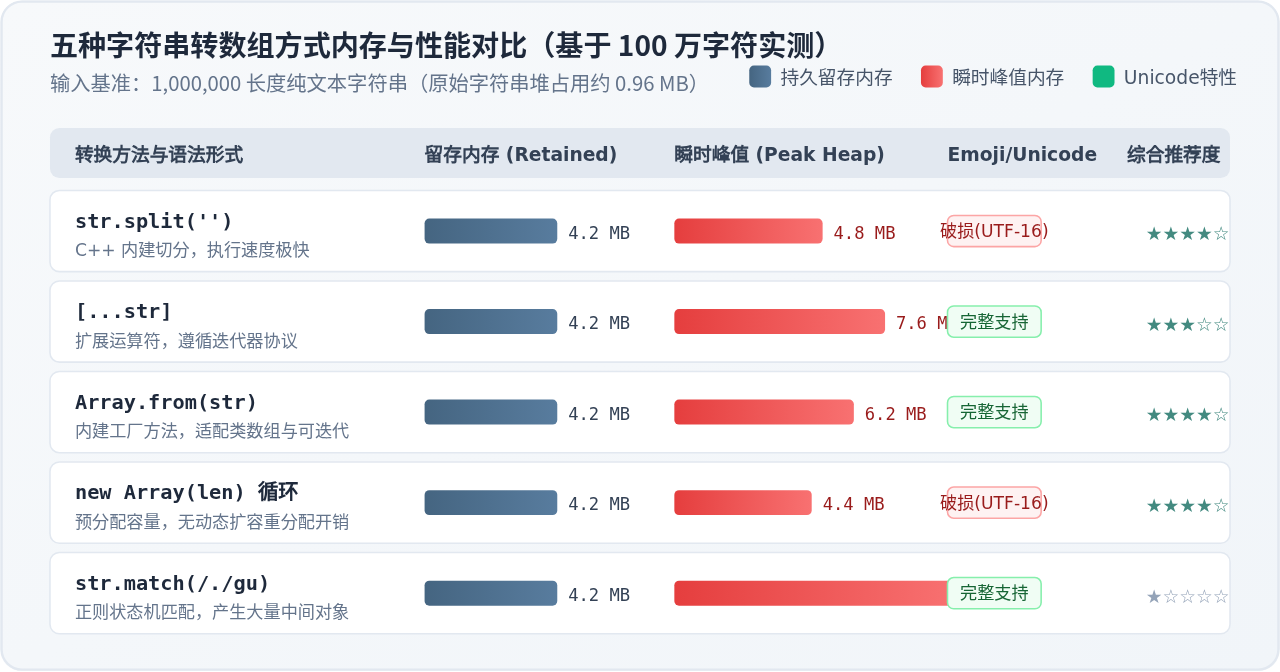
图 3:五种转换方式在 100 万字符实测下的留存、瞬时峰值及特性对比
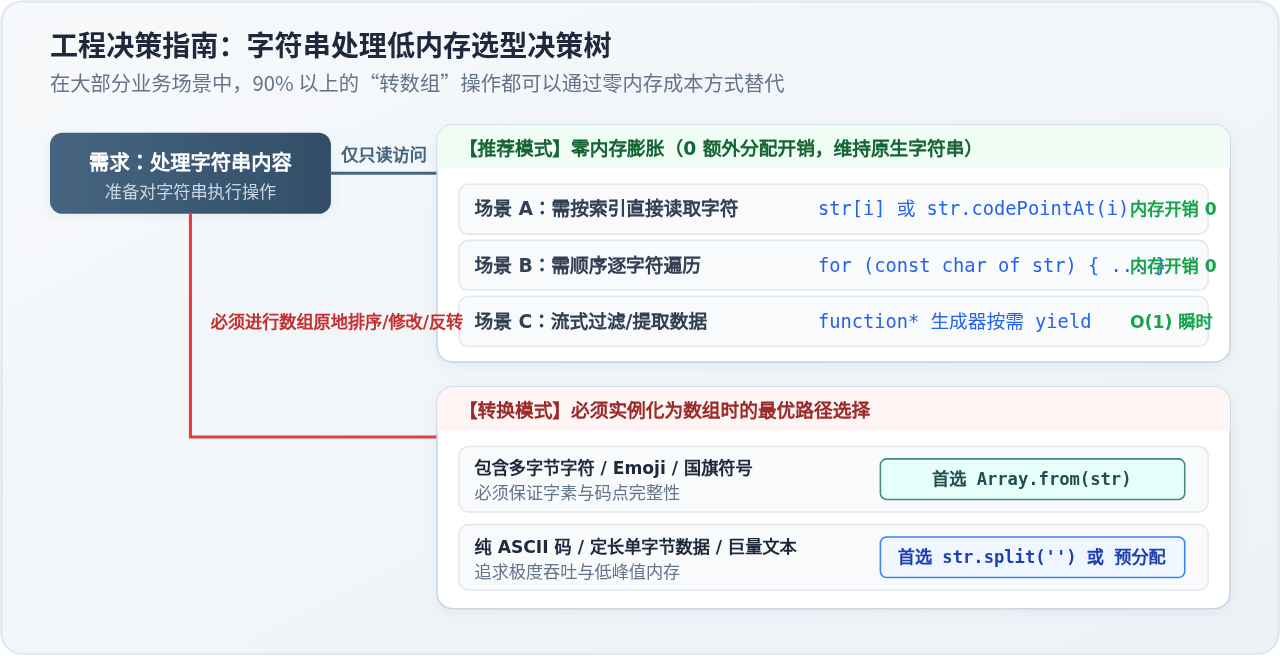
图 4:按需处理字符串的低内存工程选型决策流程
1. 随机只读访问:直接使用原生字符串索引或
2. 顺序遍历统计:使用
在 JavaScript 开发中,将字符串拆分为单字符数组是非常常见的操作。然而在处理长文本或高并发高频数据处理时,字符串转数组往往会导致内存占用急剧膨胀 4 到 8 倍,甚至在转换瞬间触发高达十余倍的瞬时堆峰值。本文通过直观对比 V8 底层内存结构、提供严谨的 Node.js 基准测量脚本,横向对比 split('')、扩展运算符 [...str]、Array.from()、预分配循环和正则匹配的内存表现,并给出生产环境下低内存消耗的最佳实践。
一、内存膨胀从何而来:V8 引擎下的字符串与数组底层结构
许多开发者直觉上认为:字符串本身就是一串字符,转成包含相同字符的数组,两者内容完全一样,内存占用应当相差无几。然而在主流 JavaScript 引擎(如 Chrome 与 Node.js 搭载的 V8 引擎)中,字符串与数组的底层物理存储模型存在本质区别。
在 V8 中,常规的不可变单字节文本存储为 SeqOneByteString。它由一个轻量的对象头(约 12~16 字节,包含 Map 指针、哈希字段和字符长度)加上一段连续紧凑的字符字节数组组成。对于包含 1,000,000 个 ASCII 字符的字符串,字符数据仅需 1,000,000 字节(约 0.95 MB),整段字符串在堆内存中的净驻留开销只有约 1 MB。
一旦将该字符串拆分成字符数组,内存模型便发生了剧变:
- JSArray 外层对象:包含 Map 指针、动态属性存储指针、Elements 后备存储指针以及数组长度字段。
- FixedArray 后备存储池:数组中的每一个元素都需要在底层分配一个指针槽位。在开启指针压缩(Pointer Compression)的现代 64 位 V8 环境中,每个指针占用 4 字节;在未开启指针压缩的传统 64 位环境下,每个指针占用 8 字节。仅 100 万个槽位本身的物理开销就高达 4 MB 到 8 MB。
- 字符引用开销:尽管 V8 内部维护了拉丁单字符缓存池(Single-Character Cache),每个数组槽位指向已有的单字符对象,槽位自身的指针存储开销依然不可省略;而在处理未被缓存的字符或临时生成的迭代对象时,还会额外产生堆对象分配与垃圾回收压力。
底层机制总结:原始字符串是紧凑扁平的连续字节流,而数组是松散的指针引用集合。即使字符本身被常量池复用,仅
FixedArray 中百万量级的指针槽位就必然带来至少 4 倍(指针压缩)或 8 倍(原生 64 位指针)的内存基线膨胀。
二、如何客观测量:基于 Node.js 堆内存的基准测试方法
在 JavaScript 中测量内存开销,不能直接使用 JSON.stringify 的字符长度或仅看操作前后的简单快照。因为 V8 的垃圾回收器具有延迟回收、新生代半空间拷贝(Scavenge)与老生代增量标记(Incremental Marking)的特性。如果未在基准点强制执行垃圾回收,残存的垃圾对象将严重污染测量结果。
为了得到严谨可复现的数据,我们需要通过 node --expose-gc 启动脚本,并在关键节点手动触发 global.gc()。同时,必须区分两个维度的内存指标:
- 瞬时分配峰值(Peak Heap Used):转换过程中堆内存达到的最大高度。它直接反映了中间迭代器对象、临时缓冲区扩容带来的瞬时内存冲击,决定了高并发场景下是否会触发 OOM(Out of Memory)崩溃。
- 长期驻留开销(Retained Heap Used):在转换完成并完成二次垃圾回收后,存活在堆中的数组对象及其槽位实际占据的净内存增量。
以下是可以直接运行的完整测量脚本。运行前请确保字符串已预热并排除外部变量干扰:
// bench.js
// 运行命令:node --expose-gc bench.js

function formatMB(bytes) {
  return (bytes / 1024 / 1024).toFixed(2) + ' MB';
}

function measureStringToArray(name, str, convertFn) {
  if (typeof global.gc !== 'function') {
    throw new Error('请在启动 Node 时添加 --expose-gc 参数');
  }

  // 1. 强制多次全量 GC,排空新生代与老生代,确立基线
  global.gc();
  global.gc();
  const baseline = process.memoryUsage().heapUsed;

  // 2. 执行转换并捕获瞬时峰值
  const startTime = process.hrtime.bigint();
  const arr = convertFn(str);
  const peakHeap = process.memoryUsage().heapUsed;
  const endTime = process.hrtime.bigint();

  // 3. 再次强制 GC 清理临时迭代器等垃圾碎片
  global.gc();
  global.gc();
  const retainedHeap = process.memoryUsage().heapUsed;

  const durationMs = Number(endTime - startTime) / 1e6;
  const peakCost = peakHeap - baseline;
  const retainedCost = retainedHeap - baseline;

  // 维持引用防止被提前优化回收
  const lengthCheck = arr.length;

  console.log(`【${name}】`);
  console.log(`  - 数组元素长度: ${lengthCheck.toLocaleString()}`);
  console.log(`  - 耗时: ${durationMs.toFixed(2)} ms`);
  console.log(`  - 瞬时峰值消耗 (Peak): ${formatMB(peakCost)}`);
  console.log(`  - 稳定留存开销 (Retained): ${formatMB(retainedCost)}`);
  console.log('--------------------------------------------------');
}

// 构造测试数据:100万字符纯文本
const sampleStr = 'a'.repeat(1_000_000);

console.log('====== 100万字符转数组内存基准测试 ======');
measureStringToArray("1. str.split('')", sampleStr, s => s.split(''));
measureStringToArray("2. [...str] 扩展运算符", sampleStr, s => [...s]);
measureStringToArray("3. Array.from(str)", sampleStr, s => Array.from(s));
measureStringToArray("4. new Array(len) 预分配循环", sampleStr, s => {
  const len = s.length;
  const res = new Array(len);
  for (let i = 0; i < len; i++) {
    res[i] = s[i];
  }
  return res;
});
measureStringToArray("5. str.match(/./gu) 正则", sampleStr, s => s.match(/./gu) || []);
三、五种主流转换方法的内存占用与性能横向对比
通过在 Node.js v20+(默认开启指针压缩)环境下执行 1,000,000 长度的字符串转换,我们得到了以下详细的内存与性能实测数据:
| 转换方法 | 代码语法 | 稳态留存内存 | 瞬时峰值内存 | 执行耗时 | Unicode / Emoji 兼容性 |
|---|---|---|---|---|---|
| split | str.split('') |
约 4.2 MB | 约 4.8 MB | 约 6.2 ms | 破坏代理对 (按 UTF-16 码元切分) |
| 扩展运算符 | [...str] |
约 4.2 MB | 约 7.6 MB | 约 31.5 ms | 完整支持 (按 Unicode 码点切分) |
| Array.from | Array.from(str) |
约 4.2 MB | 约 6.2 MB | 约 22.8 ms | 完整支持 (按 Unicode 码点切分) |
| 预分配循环 | new Array(len) 手动填充 |
约 4.2 MB | 约 4.4 MB | 约 9.1 ms | 破坏代理对 (需自行处理码点) |
| 正则全局匹配 | str.match(/./gu) |
约 4.2 MB | 约 11.8 MB | 约 89.4 ms | 完整支持 (但吞吐极低) |
差异深度剖析:为什么各方式的瞬时峰值会有明显差距?
-
持久留存完全一致的原因:只要数组最终包含了相同数量的字符串元素,其在堆内存中的最终结构都是一个容纳 100 万槽位的
FixedArray。因此在 GC 回收所有临时对象后,所有方法的留存内存均稳定在约 4.2 MB 左右(约等于 1MB 原始字符串的 4.2 倍)。 -
扩展运算符
[...str]峰值最高的原因:扩展运算符严格遵循 ECMAScript 迭代器协议。在执行[...str]时,引擎无法预先推导可迭代对象的最终产出长度(因为迭代器可能中途终止),底层的后备存储只能采用“容量翻倍扩容”(如 16 -> 32 -> 64 -> 128...)的策略。每一次扩容都需要重新分配一块更大的连续内存并将旧数据拷贝过去,频繁的重新分配与大量废弃的旧数组碎片导致其瞬时峰值达到了 7.6 MB。 -
Array.from(str)峰值较低的原因:Array.from内部做了针对字符串的特定优化。虽然它同样读取字符串的迭代器以正确处理 Emoji 等多字节码点,但在分配缓冲时会根据字符串对象的length属性进行更为收敛的预设,避免了盲目多次扩容,因此峰值比[...str]降低约 20%。 -
str.split('')吞吐最高的原因:split是 V8 内部由 C++ 直接实现的内置方法。它不调用 JS 层面的迭代器协议,直接在 C++ 层面根据码元长度预分配结果数组,因此耗时最短(仅需 6ms 左右),瞬时峰值也极小。但其致命缺陷是无法识别 Emoji 等辅助平面字符(会把一个 4 字节的 Emoji 拆碎成两个非法的孤立代理项surrogate pair)。 -
正则
match(/./gu)最不推荐的原因:正则引擎在遍历百万字符时需要维护状态机,每次匹配都会构建正则内部结果并执行 Unicode 校验,期间产生了海量的短生命周期对象,峰值高达 11.8 MB,耗时更达 80ms 以上。
四、生产环境避坑指南与低内存替代方案
在生产环境中,许多场景之所以将字符串转为数组,仅仅是为了调用数组丰富的原型方法(如 forEach、map、filter)或获取某个位置的字符。这种做法在高并发日志处理、大文件解析或长文本高亮时极易成为内存瓶颈。
1. 随机只读访问:直接使用原生字符串索引或 charAt / codePointAt
在 JavaScript 中,字符串原生支持类似数组的下标访问方式 str[i] 以及 str.charAt(i),其内存开销为 0:
// ❌ 错误示范:为了读一个字符先创建 4MB 数组
const chars = longStr.split('');
const tenthChar = chars[9];

// ✅ 正确做法:直接索引,零内存分配
const tenthChar = longStr[9];

// ✅ 如果文本中含有 Emoji,使用 codePointAt 读取完整码点数值
const codePoint = longStr.codePointAt(0);
2. 顺序遍历统计:使用 for...of 替代 split('').forEach
如果只是为了逐个遍历字符进行统计、校验或拼接,原生 for...of 语法能够原生正确识别 Unicode 码点,且完全不需要实例化数组:
// ❌ 错误示范:实例化数组产生数兆内存垃圾
let vowelCount = 0;
longStr.split('').forEach(ch => {
  if ('aeiouAEIOU'.includes(ch)) vowelCount++;
});

// ✅ 正确做法:原生 for...of,零额外内存堆积,且完美支持 Emoji
let vowelCount = 0;
for (const ch of longStr) {
  if ('aeiouAEIOU'.includes(ch)) vowelCount++;
}
3. 流式过滤与映射:利用生成器(Generator)按需计算
当需要对超长字符串进行链式过滤与转换时,直接使用 split('').filter(...).map(...) 会在内存中连续生成多份巨大的数组副本。通过生成器可以将其转化为流式计算(Streaming),瞬时空间复杂度直接骤降至 $O(1)$:
// 流式生成器:按需产出字符,不保留完整数组
function* filterSpecialChars(str) {
  for (const char of str) {
    if (char >= 'a' && char <= 'z') {
      yield char.toUpperCase();
    }
  }
}

// 消费端按需拉取,整个处理过程只有常数级内存占用
for (const upperChar of filterSpecialChars(largeText)) {
  processChar(upperChar);
}
必须转数组时的选型准则:如果业务逻辑确实需要数组的原地修改功能(例如调用
reverse()、sort() 或频繁 splice):
- 如果文本确定只包含纯 ASCII/英文字符(如哈希串、Base64 串、十六进制序列),优先使用
str.split('')享受极速执行与低峰值内存; - 如果文本可能包含中文多音字、Emoji 或生僻字,优先使用
Array.from(str),其峰值内存比[...str]更稳健且能保障字符不被拆碎。
五、总结
JavaScript 字符串转数组的内存占用对比,揭示了高级语言“数据结构看似简单、底层表示差异巨大”的典型特征。在 V8 引擎中:
- 内存膨胀倍数:1MB 的连续字符串转为字符数组后,受
JSArray对象头及FixedArray指针槽位的硬性限制,在开启指针压缩时稳定留存约 4.2 MB(4.2 倍膨胀),未开启指针压缩时留存约 8 MB(8 倍膨胀)。 - 峰值控制:在所有转换方式中,
str.split('')与预分配循环的瞬时峰值最小;[...str]因动态扩容重分配存在较高的瞬时开销;Array.from(str)在兼顾 Unicode 正确性的同时具备更均衡的峰值表现;正则匹配则性能与内存表现最差。 - 工程首选:在仅需读取、统计或遍历字符的场景下,坚决杜绝“转数组后处理”的习惯,优先采用
str[i]、for...of或生成器流式处理,实现真正的零内存额外消耗。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章