
详细解析在Node.js中将字符串转换为UTF-8 Buffer的标准方法、底层内存分配机制、字符长度与字节长度的关键差异,以及流式传输中的截断防乱码实践。

当前位置:首页 > Node.js 基础 > 正文
Node.js中字符串转UTF-8 Buffer的方法
作者:终端旅客
时间:2026-11-12
浏览:602
文章目录
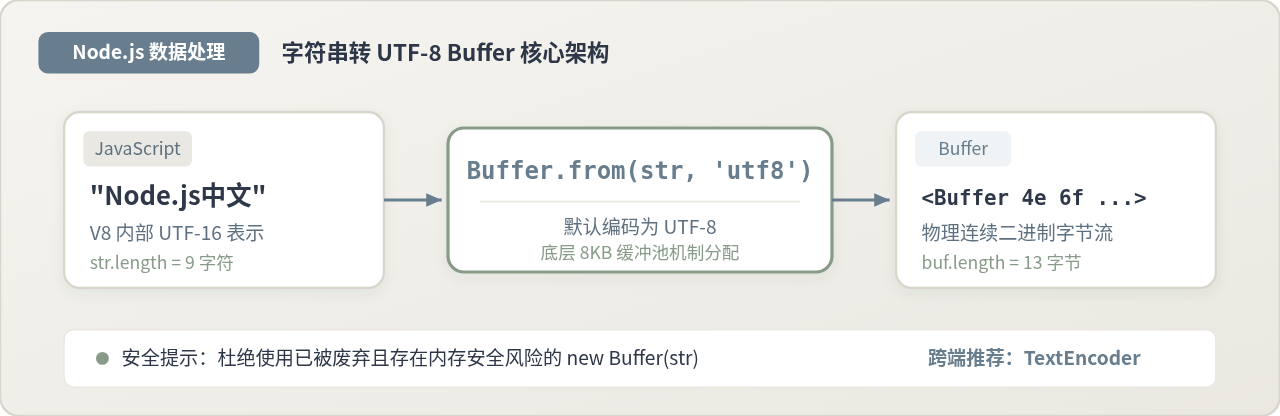
在 Node.js 中,将字符串转换为 UTF-8 编码的 Buffer 最标准、最高效的方法是直接调用内置的 Buffer.from(str, 'utf8')。由于 UTF-8 是 Node.js 处理文本时的默认编码,第二个参数在实际开发中可以省略为 Buffer.from(str)。此外,在现代跨平台 JavaScript 环境中,也可以使用 Web 标准 API new TextEncoder().encode(str) 得到 Uint8Array,并按需包装为 Buffer。本文将系统讲解核心调用方法、底层转换执行流程、字符长度与物理字节长度的本质差异,并给出多字节中文在网络分块传输时的防乱码处理方案。
一、标准基础用法:Buffer.from()
Node.js 从早期版本起就将二进制数据抽象为 Buffer 类。在日常服务端开发中,处理 HTTP 请求载荷、读写文件或进行网络 Socket 通信时,将 JavaScript 的内存字符串序列化为二进制字节是基础操作。
1. 核心转换代码示例
将一个包含英文和中文字符的字符串转换为 UTF-8 格式的 Buffer,最简洁的写法如下:
// 示例文件:convert-string-to-buffer.js
// 运行环境:Node.js v14+ / v18+ / v20+

const sourceText = 'Node.js中文';

// 方式一:显式指定 'utf8' 编码(推荐在工程中明确声明)
const bufExplicit = Buffer.from(sourceText, 'utf8');

// 方式二:省略编码参数,默认即为 'utf8'
const bufDefault = Buffer.from(sourceText);

console.log('bufExplicit 内容:', bufExplicit);
console.log('bufExplicit 字节长度:', bufExplicit.length);
console.log('两者内容是否相等:', bufExplicit.equals(bufDefault));
控制台运行输出(示例)
bufExplicit 内容: <Buffer 4e 6f 64 65 2e 6a 73 e4 b8 ad e6 96 87>bufExplicit 字节长度: 13
两者内容是否相等: true
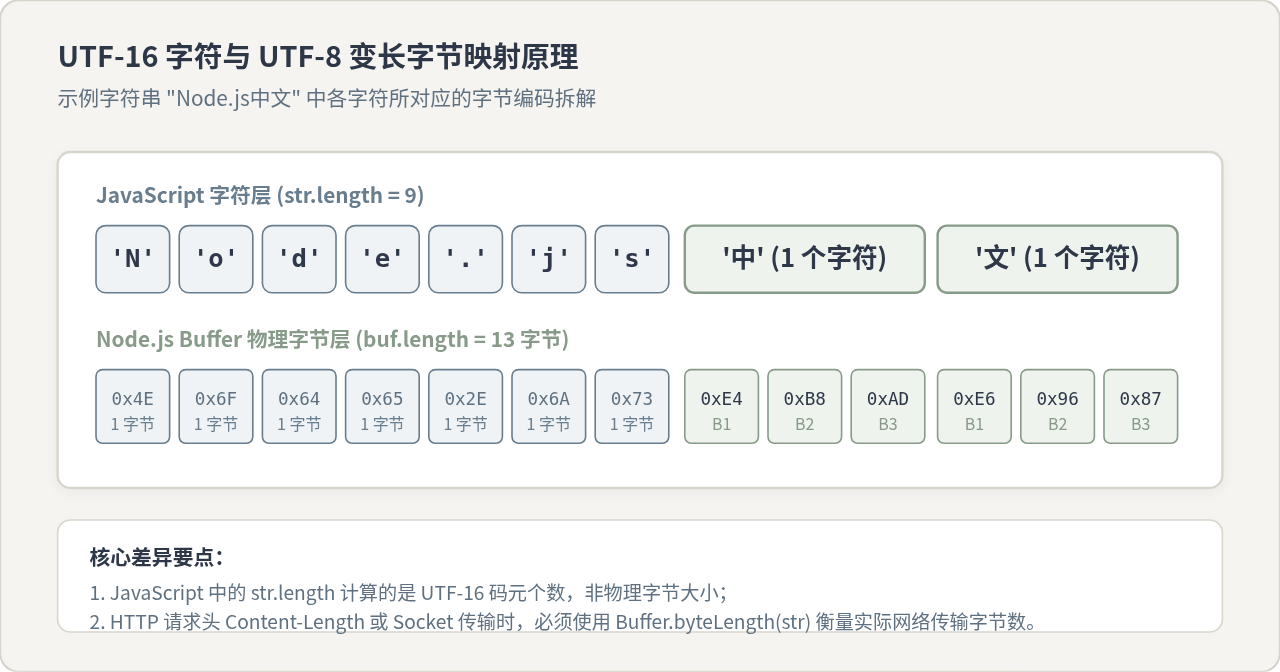
在上述代码中,Buffer.from() 接收字符串并根据 UTF-8 编码规则,将每个字符转换为 1 到 4 个十六进制字节。可以看到,英文字符 Node.js 占 7 个字节(4e 6f 64 65 2e 6a 73),两个汉字 中文 分别转换为 3 个字节(e4 b8 ad 与 e6 96 87),总计 13 字节。
安全警示:杜绝使用已被废弃的
在较旧的 Node.js 教程中常能见到
new Buffer(str)在较旧的 Node.js 教程中常能见到
new Buffer(str) 这种写法。因为 new Buffer() 在传入数字参数时不会对内存进行零填充,存在泄露服务器未初始化敏感内存的安全风险,Node.js 官方早已将其彻底废弃并发出弃用告警。在现代 Node.js 中必须统一使用 Buffer.from() 或 Buffer.alloc()。
二、底层转换执行流程与内存分配机制
当开发者调用 Buffer.from(str, 'utf8') 时,Node.js 并不是直接简单地向系统发起一次单独的内存申请,而是在内部结合 V8 引擎与底层 C++ 缓冲池完成了性能优化。
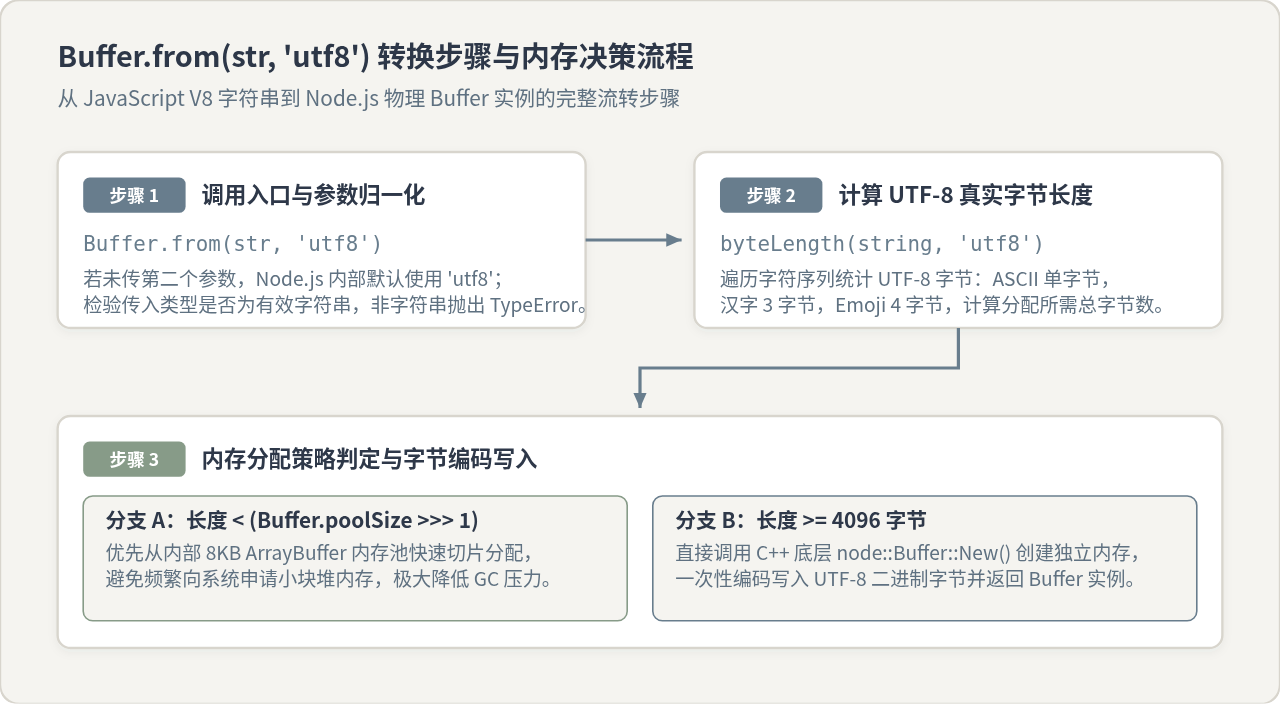
转换流程在底层主要经历以下几个关键步骤:
- 参数归一化与校验:检查传入的参数类型是否为字符串。如果传入了
null、undefined或数值,Node.js 会抛出TypeError,防止非预期类型的静默错误。 - 预估 UTF-8 字节长度:V8 内部字符串通常以 Latin1(单字节)或 UTF-16(双字节)形式存储。在分配内存前,底层会根据字符串字符分布快速计算出转为 UTF-8 所需的真实物理字节数。
- 判定内存分配策略(BufferPool):Node.js 内部维护了一个大小为 8KB(即
Buffer.poolSize = 8192)的共享ArrayBuffer缓冲池。如果计算出的字节长度小于Buffer.poolSize >>> 1(即 4096 字节),Node.js 会直接从这个已预分配的内存池中划出一个切片(Slice),省去频繁申请系统堆内存的开销;如果大于 4096 字节,则直接在堆外创建独立的内存块。 - 执行写入与返回:C++ 层的
node::StringBytes::Write方法将字符数据编码写入目标内存区域,并由 JavaScript 层包装为Buffer实例返回。
三、字符长度与物理字节长度的关键差异
在字符串转换为 Buffer 的过程中,最容易引起隐蔽 Bug 的问题是字符长度(str.length)与字节长度(buf.length)的混淆。UTF-8 是一种变长字符编码方案,不同语言的字符在编码后占用的字节数并不相同。
1. UTF-8 变长编码的存储规则
- ASCII 字符(0x00 ~ 0x7F):包含英文大小写字母、数字和常用英文标点,在 UTF-8 中固定占用 1 个字节,与 ASCII 编码完全向前兼容。
- 常见中文汉字(BMP 基本多语言平面):绝大多数中文字符在 UTF-8 编码下占用 3 个字节。
- 特殊符号与 Emoji 表情(辅助平面):如 💡、🎉 等 Emoji,在 JavaScript 字符串中由于 UTF-16 代理对机制表现为
length === 2,在 UTF-8 Buffer 中则实际占用 4 个字节。
2. 差异对比示例与 Buffer.byteLength()
通过以下代码可以清晰观察不同字符在字符串属性与 Buffer 物理占用上的差异:
// 示例文件:length-difference.js
const samples = [
  'Node.js',      // 纯 ASCII 字符
  'Node.js中文',  // 英文 + 中文
  '💡'            // Emoji 字符
];

for (const text of samples) {
  const buf = Buffer.from(text, 'utf8');
  // 无需创建 Buffer 实例即可计算实际 UTF-8 字节大小
  const calculatedBytes = Buffer.byteLength(text, 'utf8');

  console.log(`字符串内容: "${text}"`);
  console.log(`  str.length (字符码元数): ${text.length}`);
  console.log(`  buf.length (物理字节数): ${buf.length}`);
  console.log(`  Buffer.byteLength:       ${calculatedBytes}`);
  console.log('-----------------------------------');
}
控制台运行输出(示例)
字符串内容: "Node.js"str.length (字符码元数): 7
buf.length (物理字节数): 7
Buffer.byteLength: 7
-----------------------------------
字符串内容: "Node.js中文"
str.length (字符码元数): 9
buf.length (物理字节数): 13
Buffer.byteLength: 13
-----------------------------------
字符串内容: "💡"
str.length (字符码元数): 2
buf.length (物理字节数): 4
Buffer.byteLength: 4
-----------------------------------
工程准则:在构造 HTTP 响应头中的
Content-Length、或者通过 Socket 预留数据包头固定长度字段时,严禁使用 text.length,必须使用 Buffer.byteLength(text, 'utf8') 或 buf.length。若使用 text.length,会导致客户端因接收到的字节数超过 Content-Length 声明值而产生连接被挂起或传输截断错误。
四、方法对比:Buffer.from() 与 TextEncoder
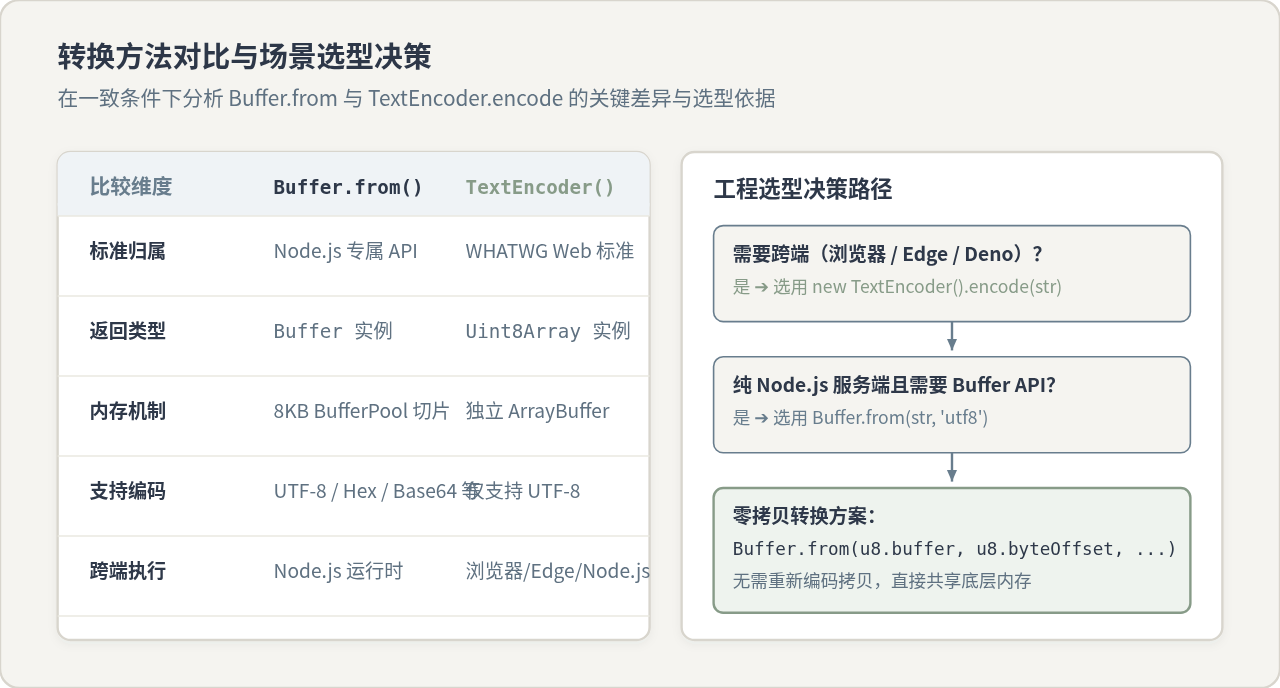
随着现代 JavaScript 运行时的演进(如浏览器环境、Edge Runtime、Deno、Bun),W3C / WHATWG 推荐的 TextEncoder 规范已成为全平台标准的文本编码工具。在 Node.js(v11 及以上全局可用)中,我们可以在 Buffer.from() 与 TextEncoder 之间根据具体场景进行选择。
1. 关键差异分析
| 对比维度 | Buffer.from(str, 'utf8') | new TextEncoder().encode(str) |
|---|---|---|
| 所属规范 | Node.js 专属内置模块 | WHATWG Web 标准(跨端通用) |
| 返回值类型 | Buffer(继承自 Uint8Array) |
纯标准 Uint8Array |
| 内存分配机制 | 内部 8KB BufferPool 切片优化(小对象极快) | 独立 ArrayBuffer 分配 |
| 支持的编码种类 | 支持 'utf8', 'hex', 'base64', 'latin1' 等 | 仅支持 UTF-8 编码 |
| 跨环境适用性 | 仅限 Node.js / Bun(浏览器需引入 Polyfill) | 浏览器、Node.js、Worker 全平台原生支持 |
2. TextEncoder 转换与零拷贝转换示例
当编写同构公共库(可在前端和后端通用)时,优先采用 TextEncoder;如果后续步骤依赖 Node.js Buffer 的特有方法,可通过底层 buffer 内存切片实现零拷贝转换:
// 示例文件:text-encoder-usage.js
const encoder = new TextEncoder();
const text = 'Node.js中文';

// 1. 使用标准 TextEncoder 转为 UTF-8 Uint8Array
const uint8Array = encoder.encode(text);
console.log('Uint8Array 字节数:', uint8Array.byteLength); // 输出:13

// 2. 零拷贝将其包装为 Node.js Buffer 实例(共享底层 ArrayBuffer 内存)
const bufFromUint8 = Buffer.from(
  uint8Array.buffer,
  uint8Array.byteOffset,
  uint8Array.byteLength
);

// 3. 此时可以直接调用 Buffer 专属方法
console.log('转换为十六进制表示:', bufFromUint8.toString('hex'));
console.log('转换为 Base64 表示:', bufFromUint8.toString('base64'));
控制台运行输出(示例)
Uint8Array 字节数: 13转换为十六进制表示: 4e6f64652e6a73e4b8ade69687
转换为 Base64 表示: Tm9kZS5qc+S4reaWhw==
五、高频应用场景与截断防乱码实践
在网络传输、流式读取或大文件分块切片时,字符串转换为 UTF-8 Buffer 之后,不能简单地按任意字节数直接截断。如果一个 3 字节的汉字恰好被切分到两个 chunk 中,直接对单个 chunk 进行 chunk.toString('utf8') 解码就会出现无法识别的乱码字符(�,显示为 )。
1. 截断引发的乱码问题复现
// 示例文件:slice-hazard.js
const source = 'Node.js中文';
const fullBuf = Buffer.from(source, 'utf8');

// 汉字“中”占用第 7、8、9 三个字节
// 若切片点落在多字节字符中间(如第 9 个字节处截断)
const chunk1 = fullBuf.subarray(0, 9);
const chunk2 = fullBuf.subarray(9);

// 直接 toString() 会破坏多字节编码
console.log('错误的直接解码 chunk1:', chunk1.toString('utf8'));
console.log('错误的直接解码 chunk2:', chunk2.toString('utf8'));
控制台运行输出(示例)
错误的直接解码 chunk1: Node.js错误的直接解码 chunk2:
2. 使用 StringDecoder 解决流式解码截断
Node.js 官方提供了内置模块 string_decoder。它的 StringDecoder 实例会在内部暂存不完整的多字节序列,并在后续 chunk 到达并补齐对应字节后再完整输出,从根本上防止中文乱码:
// 示例文件:safe-stream-decode.js
const { StringDecoder } = require('string_decoder');
const decoder = new StringDecoder('utf8');

const source = 'Node.js中文';
const fullBuf = Buffer.from(source, 'utf8');

// 模拟两个不规则分块到达
const chunk1 = fullBuf.subarray(0, 9);
const chunk2 = fullBuf.subarray(9);

// 使用 decoder.write() 逐段解码
let restored = '';
restored += decoder.write(chunk1); // 此时会先输出 "Node.js",暂存不完整的汉字字节
restored += decoder.end(chunk2);   // 汉字字节被补齐,完整还原 "中文"

console.log('安全解码后的完整结果:', restored);
控制台运行输出(示例)
安全解码后的完整结果: Node.js中文
六、全景知识总结
将字符串转换为 UTF-8 Buffer 是 Node.js 服务端进行高性能 I/O 处理的基石。在实际工程项目中,理解并遵守以下规范能够有效保障系统的可靠性与性能:
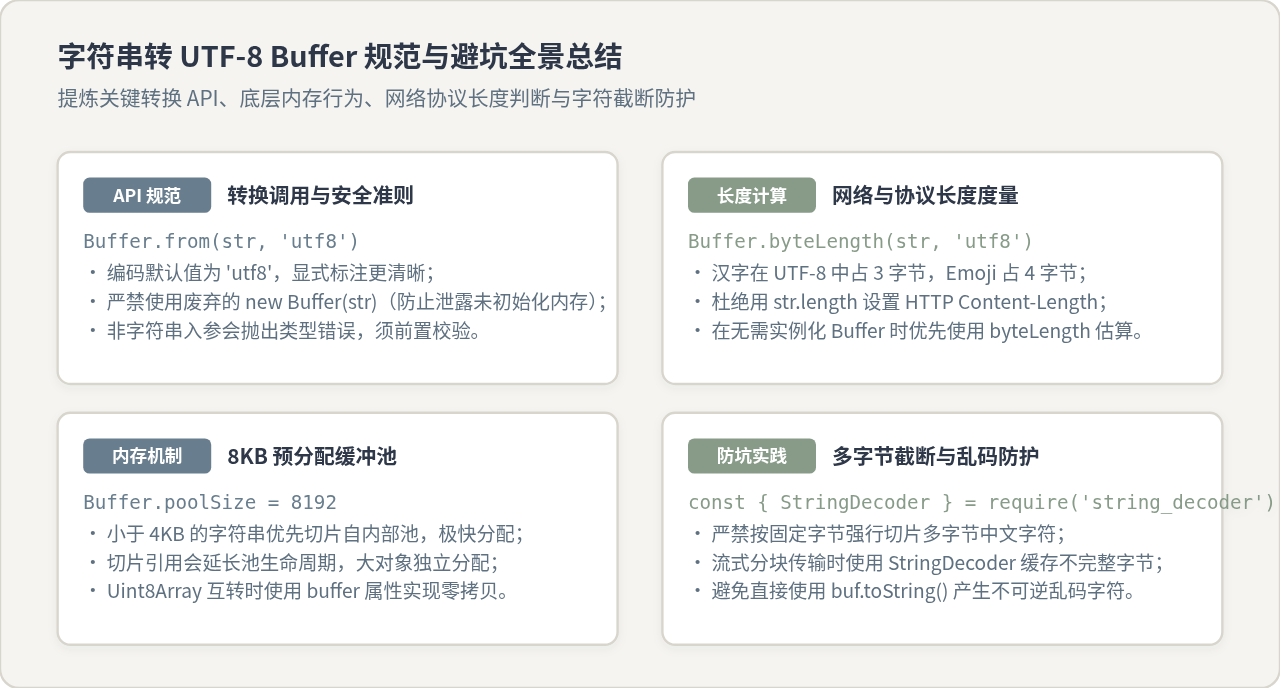
- 推荐调用方式:在 Node.js 原生业务中统一使用
Buffer.from(str, 'utf8'),显式声明字符编码,提高代码维护性。 - 跨端代码规范:在前端与 Node.js 共享的同构代码库中,优先使用
new TextEncoder().encode(str),必要时通过Buffer.from(uint8.buffer, uint8.byteOffset, uint8.byteLength)零拷贝转为 Buffer。 - 尺寸计算准则:凡涉及通信协议大小、分片阈值或
Content-Length报头,一律使用Buffer.byteLength(str, 'utf8')或buf.length,不可直接依赖str.length。 - 多字节截断保护:在流式处理(TCP Stream、HTTP 分块)中,避免对中间 Buffer 粗暴调用
.toString('utf8'),务必使用string_decoder.StringDecoder确保字符边界的完整还原。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章