
深入对比分析JavaScript中将字符串转换为数字的三种核心方法:Number()、parseInt()与parseFloat()的底层原理、运行机制、边界条件表现、基数陷阱及工程选型实践。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串转数字:Number、parseInt与parseFloat的区别
作者:桌面漫游
时间:2026-11-12
浏览:316
文章目录
在 JavaScript 中将字符串转为数字,核心差异在于底层转换机制:
Number() 属于严格的全局类型强制转换,要求整个字符串完全符合数值规范,无法容忍任何非数值杂质;而 parseInt() 与 parseFloat() 属于词法游标解析器,通过从左向右逐字符扫描来提取数字,遇到无法解析的字符便自动截断停止。
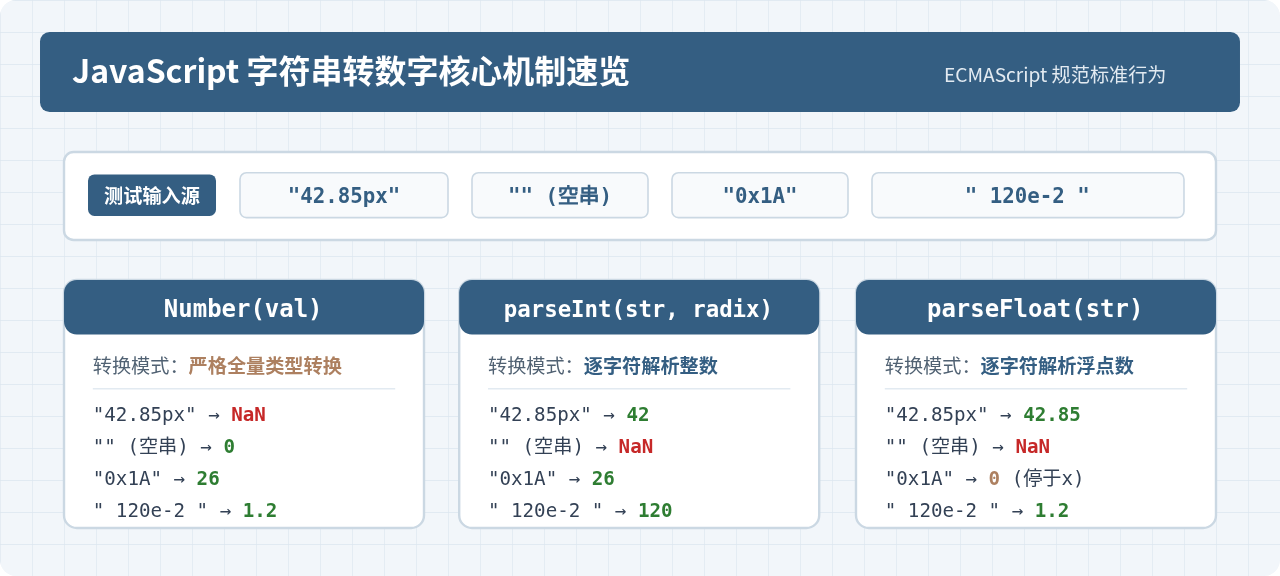
图 0:三种字符串转数字方法的核心特性与样本输出速查
一、核心机制剖析:严格全量转换 vs 逐字符截取
JavaScript 提供了两套不同维度的数字转换思路。理解这两种思路的运作规则,是避免生产环境中出现非预期 NaN 或静默数据错误的关键。
1. Number(str):ECMAScript ToNumber 抽象操作
当调用 Number("123") 时,JavaScript 引擎执行语言规范定义的 ToNumber 抽象转换。这一过程具有如下特征:
- 去除首尾空白:自动清除字符串两端的换行符、空格及制表符。
- 全串语法验证:字符串内部必须通篇属于有效的数值字面量。一旦包含诸如字母、单位(如
px)或非数字标点,直接判定失败,返回NaN。 - 支持多种字面量形式:能够原生识别十六进制(
0x)、二进制(0b)、八进制(0o)前缀以及科学计数法(1e4)。 - 空值特殊处理:空字符串
""以及纯空白字符串" "会被规范强制转换为数字0,而非NaN。
2. parseInt(str, radix) 与 parseFloat(str):字符流解析器
parseInt 与 parseFloat 源自早期的全局解析函数,它们并不验证全字符串的合法性,而是像词法分析器一样工作:
- 首先寻找第一个非空字符。如果第一个非空字符不是数字或正负符号,解析立即终止,直接返回
NaN。 - 如果头部是有效数字,解析器将沿字符流向右遍历,持续收集符合规则的字符,直到遇到第一个无法识别的字符位置。
parseInt在遇到小数点.时会将其视为非整数字符而直接停止扫描,因此它只截取整数部分;而parseFloat可以且仅可以识别一个小数点,并支持指数记法中的e/E。
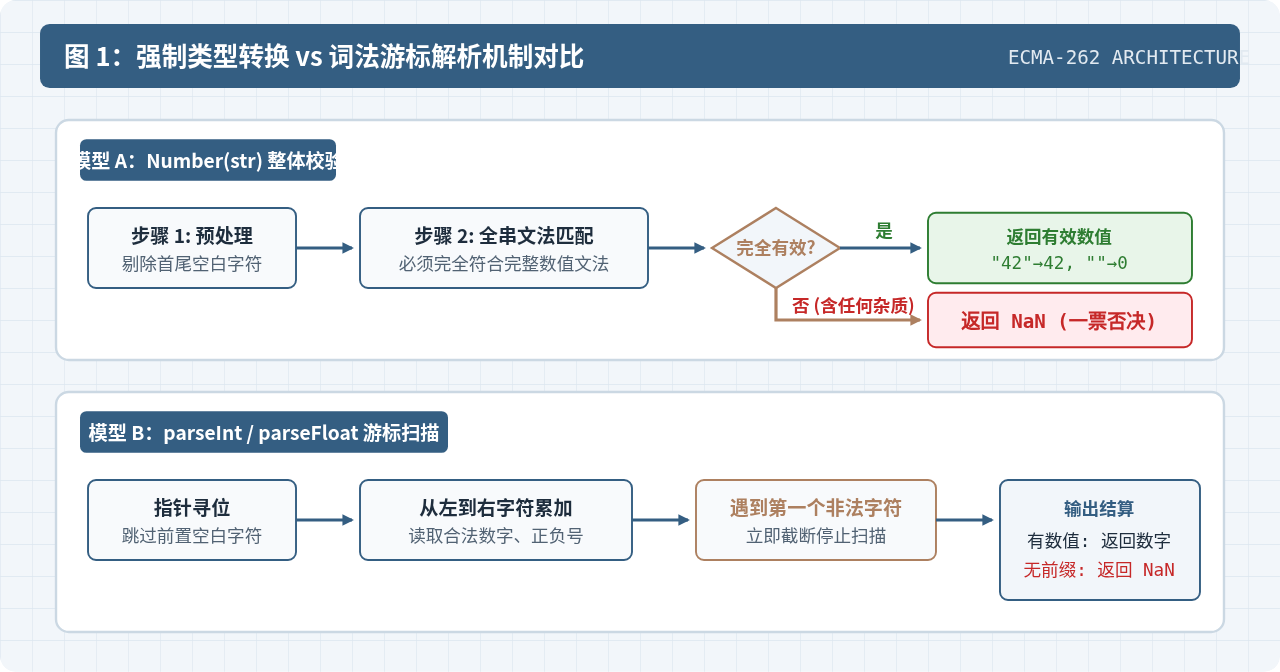
图 1:强制类型转换 vs 词法游标解析机制流程对比
二、典型边界条件与输入类型对照
在日常业务开发中,各类用户输入与接口返回数据往往伴随边界情况。下文对最容易混淆的场景进行逐项比对。
1. 带有非数字后缀的字符串(CSS单位、计量文本)
在前端处理样式属性时,经常需要处理如 "24px"、"1.5rem" 或 "100%" 这样的字符串:
// 带有单位的字符串
const width = "24px";
const ratio = "1.5rem";

console.log(Number(width));       // NaN (一票否决:含有非数字字符 'p')
console.log(parseInt(width, 10)); // 24  (遇到 'p' 停止,截取前面的 24)
console.log(parseFloat(ratio));   // 1.5 (遇到 'r' 停止,截取前面的 1.5)
如果业务目标是从类似 "32px" 的文本中提取数值量,应当使用 parseInt 或 parseFloat;如果目标是校验用户在输入框中填写的必须是纯数字,则 Number() 更为适宜。
2. 空字符串与空白字符陷阱
这是 Number() 最容易引发业务 Bug 的隐藏点:
console.log(Number(""));        // 0
console.log(Number("   "));     // 0
console.log(parseInt("", 10));  // NaN
console.log(parseFloat(""));    // NaN
注意:如果表单中的年龄或金额字段未填写(空字符串
""),直接使用 Number(value) 会将其转换为数字 0。在需要区分“未填写”与“填写的数值为0”时,必须先进行显式非空判断。
3. 十六进制与科学计数法
三种方法对于特殊记数法的支持度存在显著差异:
// 十六进制字符串
const hex = "0x1A";
console.log(Number(hex));       // 26
console.log(parseInt(hex, 16)); // 26
console.log(parseFloat(hex));   // 0 (parseFloat 不支持 0x,遇到 'x' 立即截断,返回 0)

// 科学计数法字符串
const scientific = "2.5e3";
console.log(Number(scientific));     // 2500
console.log(parseFloat(scientific)); // 2500
console.log(parseInt(scientific, 10)); // 2 (parseInt 无法解析 'e',停止于 2)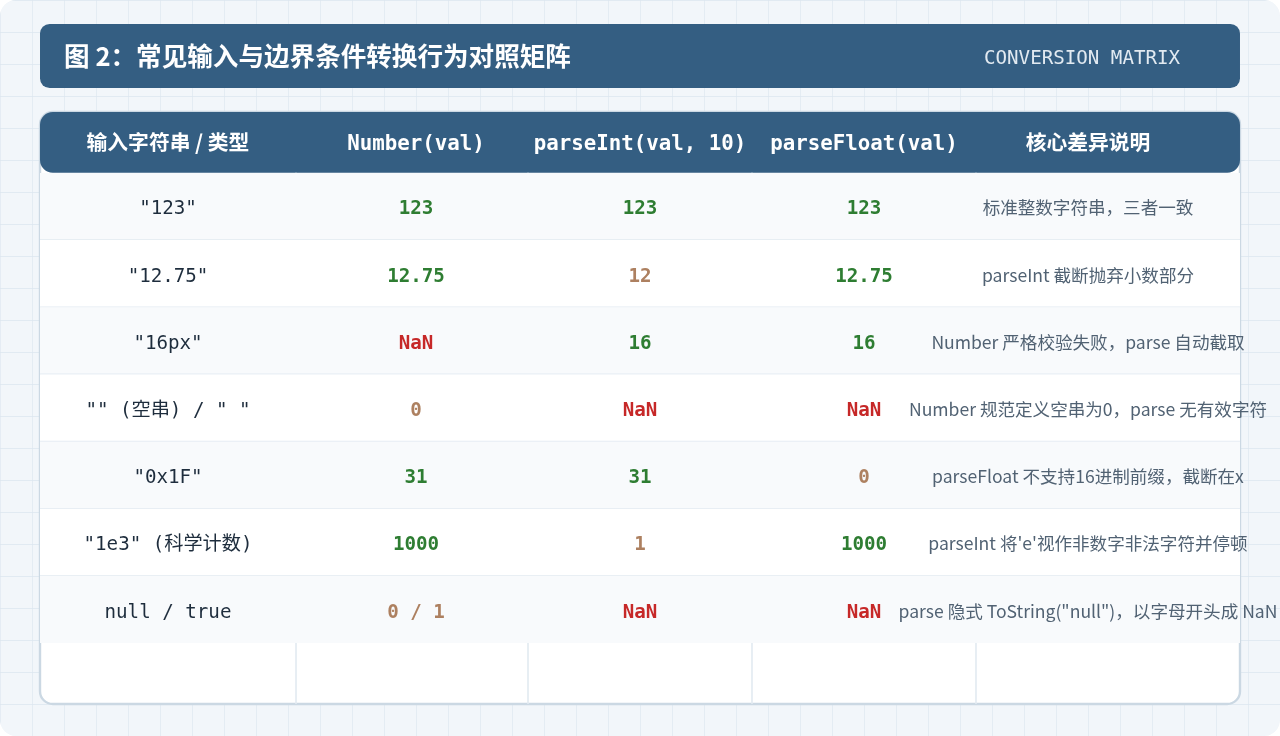
图 2:不同输入数据在三种方法下的转换结果对照矩阵
三、parseInt 的基数(radix)陷阱与最佳实践
parseInt(string, radix) 的第二个参数 radix 表示解析所基于的进制数,有效取值区间为 2 到 36。
1. 为什么必须始终显式指定 radix 为 10?
虽然现代 ECMAScript 规范规定当省略 radix 且字符串不以 0x 开头时默认采用 10 进制,但在历史实现及不同运行环境下,以 0 开头的字符串(例如 "08")曾被部分引擎解析为 8 进制,导致产生 0 的诡异行为。
因此,在任何代码检查规则(如 ESLint 的 radix 规则)中,都强制要求显式传入 10:
// 不推荐的写法:依赖环境默认推断
const num = parseInt(str);

// 规范推荐写法:显式指明十进制
const num = parseInt(str, 10);
2. 经典面试题:为什么 ['1', '2', '3'].map(parseInt) 会输出 [1, NaN, NaN]?
这是前端开发中非常著名的回调参数陷阱。Array.prototype.map 在执行回调时,会向回调函数传递三个参数:(currentValue, index, array)。而 parseInt 正好接受两个参数:(string, radix)。
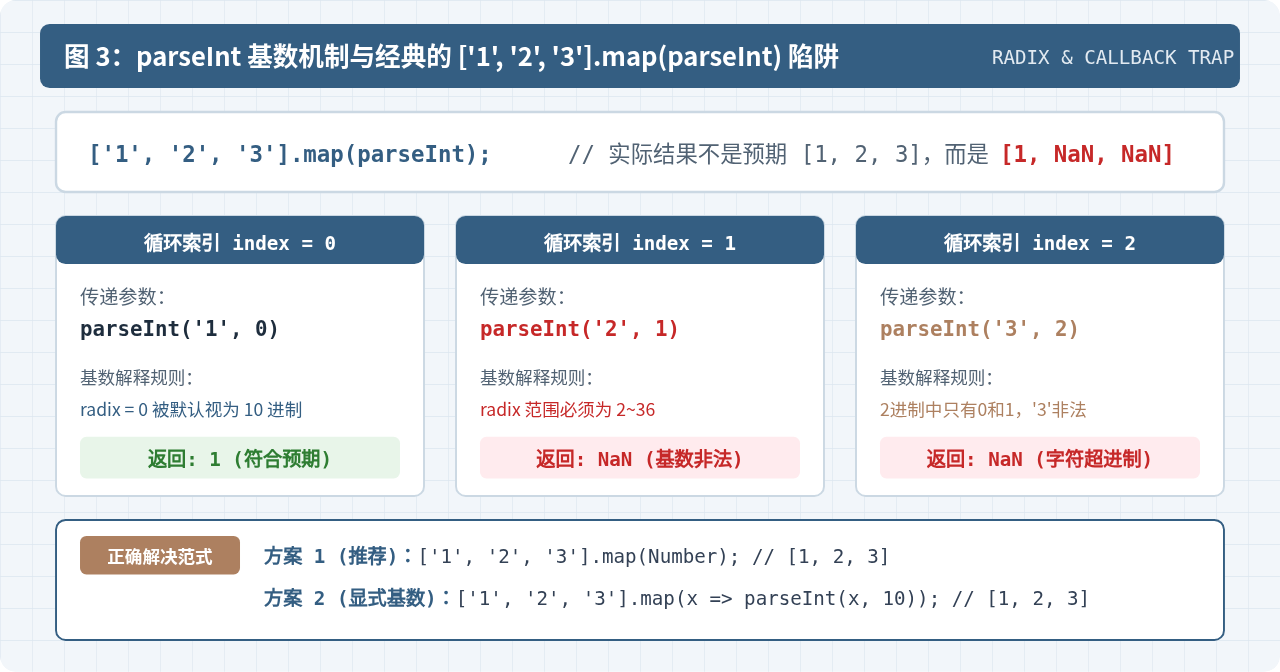
图 3:['1', '2', '3'].map(parseInt) 执行过程参数错位解析图
逐步分析每一次迭代传参:
- 第一次执行:
parseInt('1', 0)。当radix为 0 时,根据规范将其回退为 10 进制,因此返回1。 - 第二次执行:
parseInt('2', 1)。由于不存在 1 进制(进制合法范围是 2~36),参数无效,直接返回NaN。 - 第三次执行:
parseInt('3', 2)。在 2 进制下合法的字符只有0和1,字符'3'是非法字符,未解析到有效内容即中止,返回NaN。
正确的数组元素转数字写法:
// 写法一:使用只接收单参数的 Number 构造函数(最简洁)
const list1 = ['1', '2', '3'].map(Number); // [1, 2, 3]

// 写法二:使用箭头函数封装显式基数传递
const list2 = ['1', '2', '3'].map(item => parseInt(item, 10)); // [1, 2, 3]
四、一元加号运算符(+str)的定位
在工程代码中经常能见到使用一元加号转换数值:const n = +str;。从规范上看,一元加号运算符底层与 Number(str) 完全等价,均执行 ToNumber 操作。
+"42"      // 42
+"42px"    // NaN
+""        // 0
+true      // 1
+null      // 0
+undefined // NaN
一元加号编写更为简洁,但由于其语义相对隐晦,对新手可读性稍差,且与 Number() 同样存在将空字符串转为 0 的副作用。在追求代码自解释性的场景中,更推荐显式调用 Number()。
五、工程选型:如何选择最合适的转换方法?
在实际编码中,应根据输入源的确定性与数据转换意图来做出明确决策:
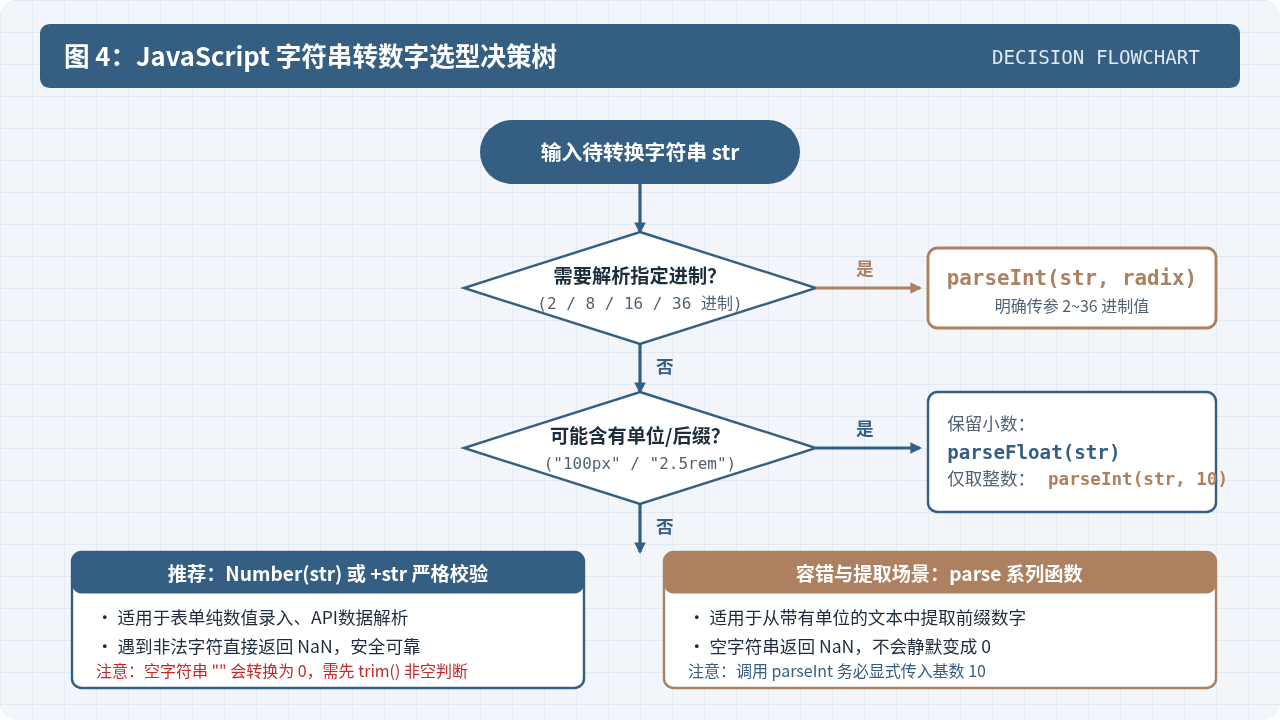
图 4:项目开发中字符串转数字的选型判断逻辑流程
| 业务场景 | 推荐方式 | 选型理由与注意事项 |
|---|---|---|
| 表单纯数字输入校验与入库 | Number(val) |
要求整体格式合法,不允许夹带非数字字符;转换后结合 Number.isNaN() 验证。 |
解析尺寸、单位文本(如 "12px") |
parseInt(val, 10) |
自动截断末尾单位并保留整数量,务必显式传入基数 10。 |
解析含小数的尺寸或百分比(如 "2.5rem") |
parseFloat(val) |
提取前置浮点数,遇到非数字后缀即停止。 |
| 颜色代码、二进制协议转换 | parseInt(val, radix) |
支持 2 到 36 任意进制解析(如 parseInt("FF", 16))。 |
| 数组批量映射转换 | arr.map(Number) |
避免 map(parseInt) 因下标传递导致的基数错位灾难。 |
健壮性建议:在获得转换结果后,建议统一使用
Number.isNaN(result) 进行安全验证,而不是使用全局的 isNaN()。因为 Number.isNaN() 不会对参数进行隐式类型转换,只有当参数真正为 NaN 时才返回 true,避免了类型混淆。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章