
本文详细讲解如何使用纯原生 JavaScript 实现轻量级 HTML 字符串缩进格式化。通过标记切分、Void 标签识别与深度状态机推导,实现零依赖、高保真的 HTML 代码美化。

当前位置:首页 > JavaScript 基础 > 正文
怎么用原生JavaScript实现简单的HTML缩进格式化
作者:橙子
时间:2026-11-12
浏览:491
文章目录
前端工程与原生开发
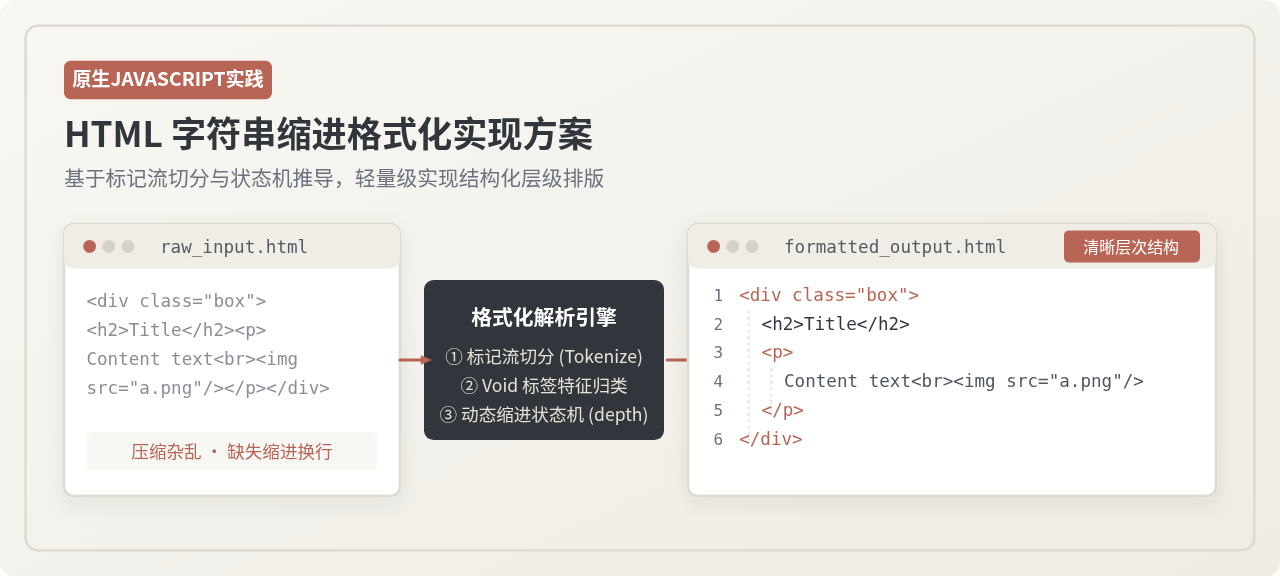 缩略图:原生 JavaScript 简易 HTML 缩进格式化核心流程概览
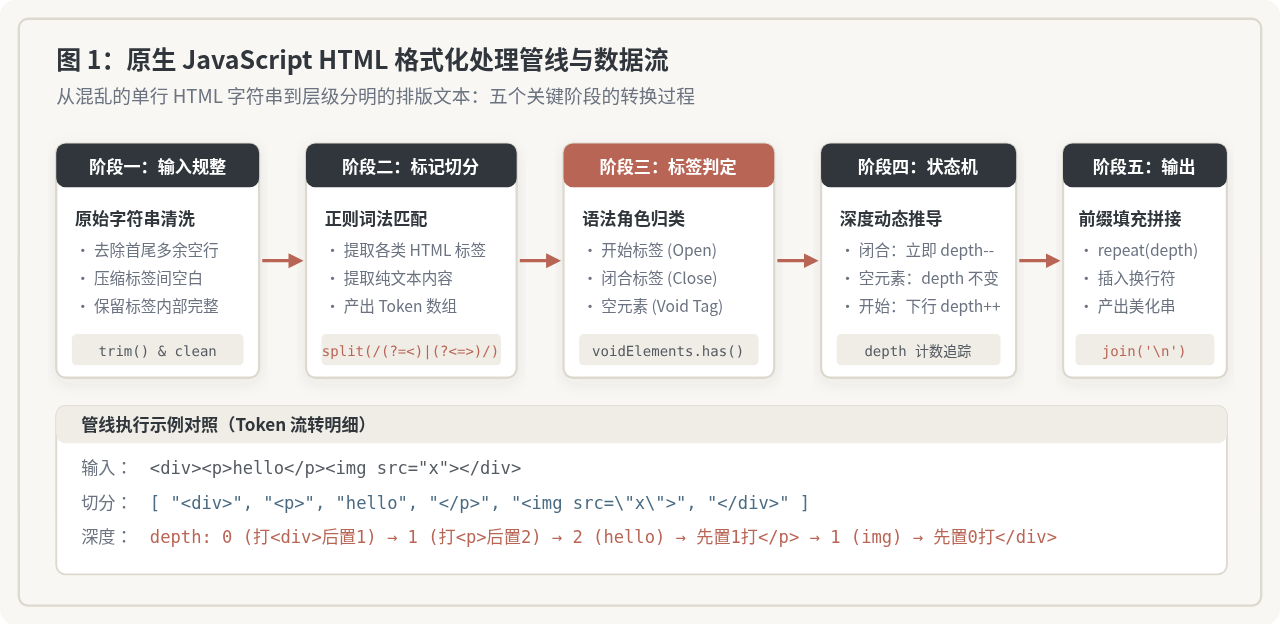 图 1:原生 JavaScript HTML 格式化处理管线与数据流
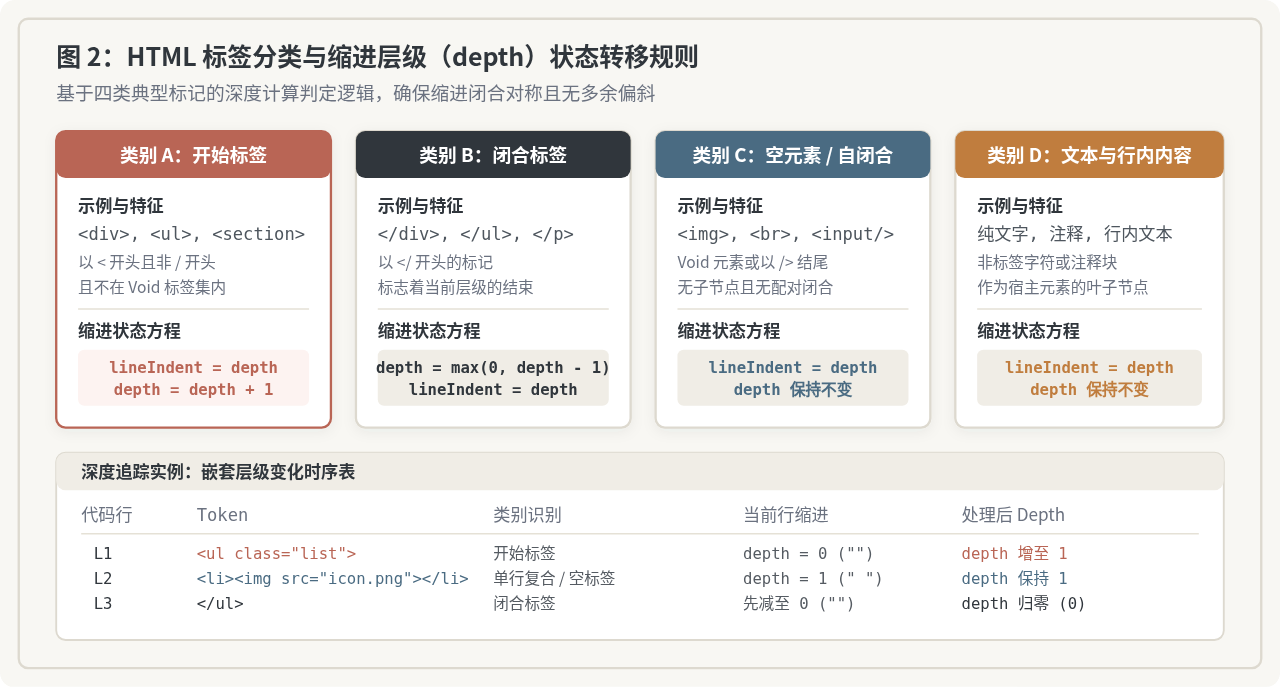 图 2:HTML 标签分类与缩进层级(depth)状态转移规则
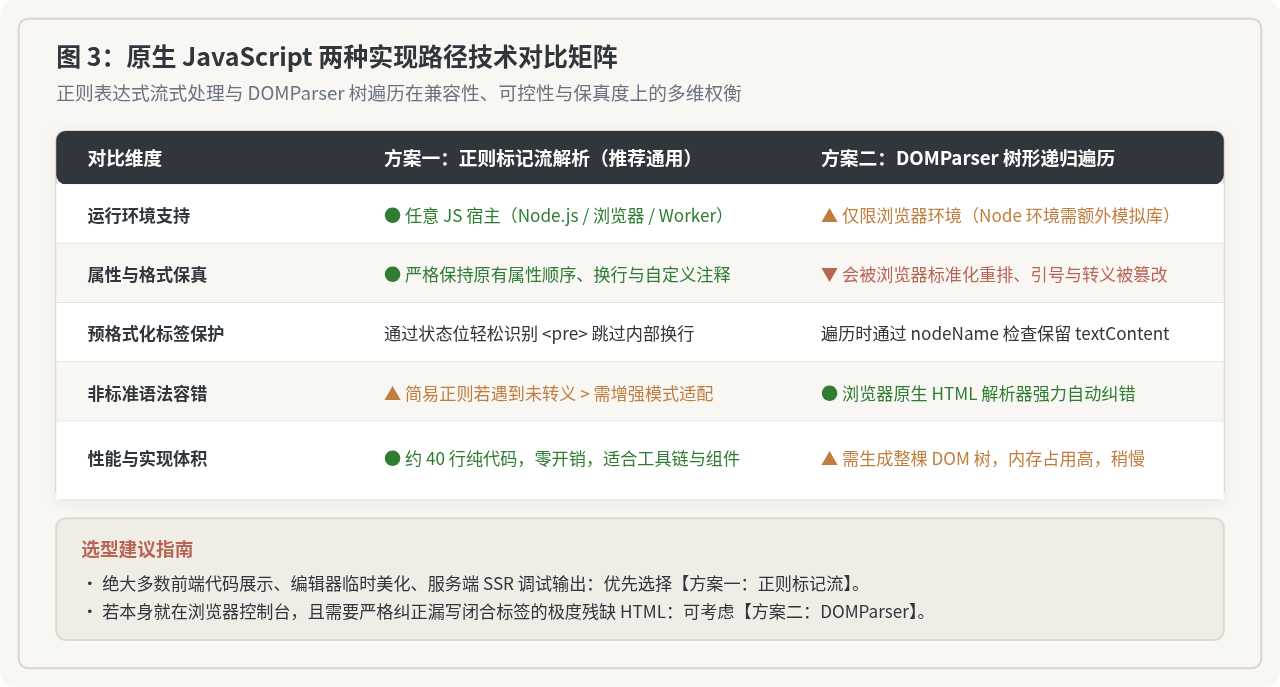 图 3:原生 JavaScript 两种实现路径技术对比矩阵
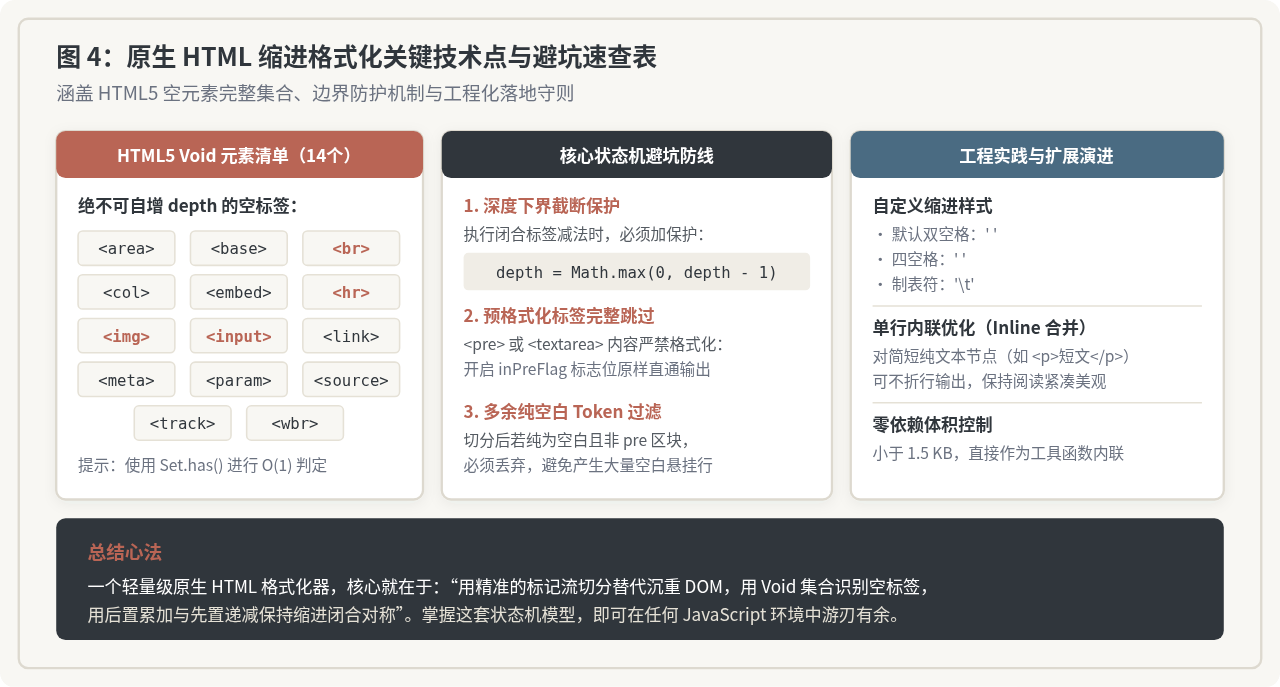 图 4:原生 HTML 缩进格式化关键技术点与避坑速查表
缩略图:原生 JavaScript 简易 HTML 缩进格式化核心流程概览
原生 JavaScript 格式化 HTML 字符串的核心逻辑,是将杂乱压缩的 HTML 文本切分为“标签”与“内容”两类标记(Token),利用深度计数器(depth)实时追踪嵌套层级,并在每行输出前拼接对应层级的缩进空白。无需引入重达数百 KB 的外部排版库,仅用不到四十行原生代码,就能实现清晰、规整的层级缩进效果。
一、格式化原理与管线流程
在许多业务场景中,例如富文本编辑器源码预览、开发者工具轻量输出或服务端返回的片段回显,我们常常拿到的是一整行被挤压在一起的 HTML 字符串。如果直接渲染在 <pre> 或日志窗口中,阅读和排查极为困难。
要将其还原为层次分明的排版格式,本质是建立一条轻量级的数据转换管线:首先消除外部多余空白,接着按照 HTML 语法边界把长字符串拆开,随后逐一分析每个标记属于“开标签”、“闭合标签”还是“空元素”,动态调整当前的缩进距离,最终拼接换行输出。
图 1:原生 JavaScript HTML 格式化处理管线与数据流
如上图所示,整个转换管线分为五个明确环节:
- 输入规整:对原始字符串调用基础清洗,去除头尾空行与标签之间无意义的连续空格。
- 标记切分(Tokenization):使用正则表达式,在遇到标签开始与闭合符号处切断,把一维连续文本转变成离散的 Token 序列。
- 标签分类判定:遍历 Token 序列,根据标签特征区分为开始标签、闭合标签、Void 标签与文本内容。
- 深度状态机推导:维护全局
depth变量,依据标签类型计算当前行与后续行的缩进值。 - 前缀填充与拼装:通过
indent.repeat(depth)生成缩进空格,与当前 Token 组合后加入换行符输出。
二、标记切分与缩进状态机规则
实现该格式化器的关键突破口,在于两项核心逻辑的设计:精准切分 Token 与 对称维护缩进深度。
1. 如何切分 HTML 标记
HTML 字符串由标签(如 <div>、</div>)和文本内容交替构成。在原生 JavaScript 中,最简单直接且无需构造完整 AST 语法树的方法,是使用零宽断言正则:
// 利用肯定环视:在 < 之前或 > 之后进行切分
const tokens = html.split(/(?=<)|(?<=>)/g);
例如将 <div><p>hello</p></div> 传入该正则切分,会得到 ["<div>", "<p>", "hello", "</p>", "</div>"]。所有完整的标签和纯文本都被干净地独立开来,切分过程中不会丢失任何尖括号字符。
2. 四类标记的状态转移方程
拿到切分后的标记流后,程序依次处理每一个标记。标记类型决定了缩进层级在“何时”发生改变。这是最容易产生缩进偏移的地方:
图 2:HTML 标签分类与缩进层级(depth)状态转移规则
-
类别 A:开始标签(Opening Tag)
如<section class="main">。它意味着内部将开启一个新的作用域。处理规则:当前行必须使用当前的depth打印,随后将depth累加 1,供下一行子元素缩进。 -
类别 B:闭合标签(Closing Tag)
如</section>。它意味着当前作用域结束。处理规则:必须先将depth减 1,再用更新后的depth输出当前行,确保闭合标签与开标签保持在同一垂直线上。为防止异常 HTML 导致缩进产生负数,需使用Math.max(0, depth - 1)兜底。 -
类别 C:空元素与自闭合标签(Void / Self-closing Tag)
如<img src="...">、<br>或以/>结尾的 XHTML 风格标签。它们没有配对的闭合标签,更不会容纳子元素。处理规则:按当前depth打印,打印后depth保持不变。如果错误地将其视作开始标签,后续所有代码都会永久右偏一级。 -
类别 D:文本节点与行内内容
如纯文字或注释节点。处理规则:按当前depth打印,depth保持不变。
三、完整代码实现与逐行解析
综合上述切分与状态机规则,我们编写一个简洁、高内聚的原生 JavaScript 函数。该实现没有任何外部包依赖,可直接粘贴在浏览器控制台或 Node.js 服务中运行:
/**
 * 用原生 JavaScript 格式化 HTML 字符串
 * @param {string} html - 待格式化的原始 HTML 字符串
 * @param {string} indent - 缩进占位字符,默认为两个空格
 * @returns {string} 格式化并缩进后的 HTML 字符串
 */
function formatHtml(html, indent = '  ') {
  if (!html || typeof html !== 'string') return '';

  // 1. HTML5 规范规定的 14 个空元素集合(永远不会出现配对闭合标签)
  const voidElements = new Set([
    'area', 'base', 'br', 'col', 'embed', 'hr', 'img', 'input',
    'link', 'meta', 'param', 'source', 'track', 'wbr'
  ]);

  // 2. 利用环视正则切分标记流
  const rawTokens = html.split(/(?=<)|(?<=>)/g);
  const formattedLines = [];
  let depth = 0;

  for (let i = 0; i < rawTokens.length; i++) {
    const token = rawTokens[i].trim();
    if (!token) continue; // 过滤纯空白标记

    // 判定 1: 是否为闭合标签(以 </ 开头)
    if (/^<\/[a-zA-Z0-9\-]+>/.test(token)) {
      depth = Math.max(0, depth - 1);
      formattedLines.push(indent.repeat(depth) + token);
      continue;
    }

    // 判定 2: 提取标签名,检查是否为 Void 元素或自闭合语法
    const openMatch = token.match(/^<([a-zA-Z0-9\-]+)(?:\s+[^>]*)?(\/?>)$/);
    if (openMatch) {
      const tagName = openMatch[1].toLowerCase();
      const isSelfClosing = openMatch[2] === '/>' || voidElements.has(tagName);

      if (isSelfClosing) {
        // 空元素:当前行打印,深度不递增
        formattedLines.push(indent.repeat(depth) + token);
      } else {
        // 普通开始标签:当前行打印,深度随后递增
        formattedLines.push(indent.repeat(depth) + token);
        depth++;
      }
      continue;
    }

    // 判定 3: 普通文本节点、HTML 注释或未闭合字符
    formattedLines.push(indent.repeat(depth) + token);
  }

  return formattedLines.join('\n');
}
测试执行与结果验证
我们准备一段包含嵌套结构、Void 元素、属性与纯文本的压缩 HTML 字符串进行验证:
// 测试用例:压缩单行 HTML
const messyHtml = '<div class="card"><header><h3>用户资料</h3></header><div class="body"><img src="avatar.jpg" alt="头像"><p>欢迎注册系统<br><input type="text" name="user"/></p></div></div>';

console.log(formatHtml(messyHtml, ' '));执行后控制台输出如下,各级缩进对称严密,<img>、<br>、<input/> 均未引起层级错乱:
<div class="card">
  <header>
    <h3>
      用户资料
    </h3>
  </header>
  <div class="body">
    <img src="avatar.jpg" alt="头像">
    <p>
      欢迎注册系统
      <br>
      <input type="text" name="user"/>
    </p>
  </div>
</div>
四、两种原生技术路径对比:正则切分 vs DOMParser
在原生 JavaScript 中,除了基于字符串和正则表达式的“标记流状态机”方案,还可以借助浏览器内置的 DOMParser 将字符串先解析为一棵虚拟 DOM 树,然后通过深度优先递归遍历节点进行重构排版。
很多开发者会有疑问:为什么不直接用 DOMParser?这两套路径在实际开发中到底该如何抉择?
图 3:原生 JavaScript 两种实现路径技术对比矩阵
从图 3 的详细对比矩阵中,我们可以看清两者的核心差异与适用边界:
方案一:正则标记流解析(推荐通用)
优势:脱离 DOM 运行,在 Node.js 服务端、Web Worker、浏览器后台脚本中通吃;严格保留原始代码的属性顺序与自定义格式,体积微小(< 1KB)。
限制:需要自行通过 Set 集合维护 HTML5 Void 标签清单,若遇到属性值中含有极端未转义的 > 时需要更严密的正则。
方案二:DOMParser 树形递归遍历
优势:依靠浏览器内核的 HTML 解析引擎,具备工业级纠错能力。即使输入的 HTML 缺失闭合标签,也能自动修补对齐。
限制:仅限前端浏览器主线程;在序列化过程中会重排属性顺序、剔除无效格式,且创建 DOM 树内存与时间开销较大。
选型结论:对于常见的文本排版、Markdown 编辑器代码块美化或轻量调试日志,方案一(正则切分)是综合性价比与可移植性最佳的实践方案。
五、工程化落地避坑与总结
实现简单的 HTML 缩进并不复杂,但要在生产开发中稳定运行,还必须防范以下三个常见隐患:
图 4:原生 HTML 缩进格式化关键技术点与避坑速查表
1. 空白敏感标签的保护(<pre> 与 <textarea>)
HTML 标准规定,<pre>、<code> 与 <textarea> 内部的所有换行和缩进都会直接呈现在用户界面上。如果在格式化时强行对这些元素内部插入缩进空格,会导致最终网页布局发生实质性改变。
防御方案:在遍历循环中引入布尔状态位
inPre = false。当遇到 <pre...> 时将其置为 true,直到遇到 </pre> 才重置。在此区间内的内容不插入任何新增缩进,保持原文直出。
2. 深度下界截断与防溢出
现实中的 HTML 代码片段经常是不完整的,例如单独截取的一段 </div></div>。若不做下界拦截,depth 会递减为负数,导致后续调用 indent.repeat(depth) 抛出 RangeError: Invalid count value 异常。因此,必须始终使用 Math.max(0, depth - 1) 保证计数器的安全下限。
3. 行内标签的单行输出优化
如果对所有的 <p>单行文字</p> 都要强制拆成三行显示,代码垂直跨度会过大,降低阅读效率。在进阶实现中,可以加入前瞻检测:如果当前开始标签紧接着纯文本和同名闭合标签,且总长度小于指定阈值(例如 80 字符),可将这三项合并在同一行缩进输出。
总结:原生 JavaScript 实现 HTML 缩进格式化的核心,在于建立“标记切分 → Void 标签过滤 → 深度状态追踪”的微型状态机。掌握了这套思维模型,不仅能在脱离三方库的环境下轻松美化 HTML,更为理解 AST 语法解析与编译器工作原理打下坚实的基础。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章