
深入剖析JavaScript代码格式化中模板字符串空格污染与长链式调用折行断裂两大常见陷阱,提供具体场景分析、工具链配置及实用防护方案。

当前位置:首页 > JavaScript 代码规范与重构 > 正文
JS代码格式化常见陷阱:怎么避免破坏模板字符串或长链式调用
作者:工具松鼠
时间:2026-11-12
浏览:334
文章目录
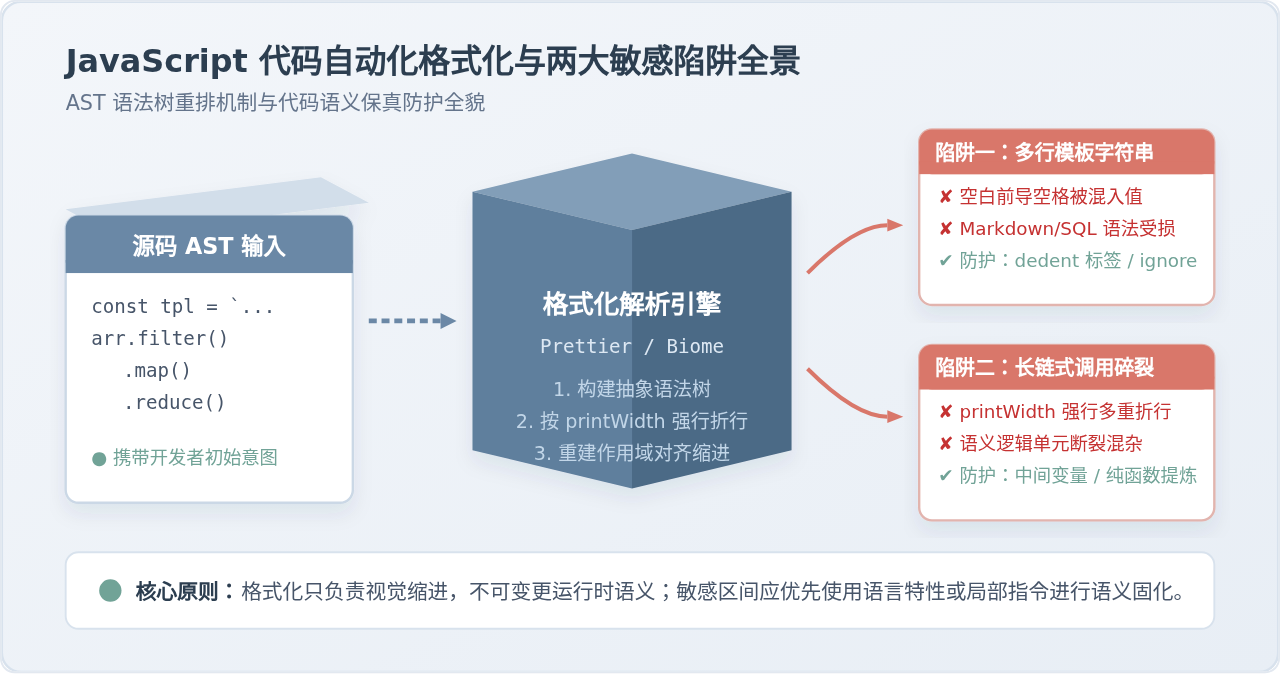
在现代 JavaScript 开发中,Prettier、Biome 与 ESLint 的自动化格式化极大地提升了团队协作规范,但若不加辨析地全盘应用,工具对语法树的重新排版极易悄悄破坏两类敏感代码:一是严格保留空格和换行的多行模板字符串,二是依赖清晰上下游关系的长链式调用。本文将针对这两类高频“重灾区”,剖析自动化工具的排版机制,并提供从局部注释防御、代码结构重构到工具链协同的完整避坑方案。
一、陷阱剖析:模板字符串为什么会被格式化“污染”?
JavaScript 中的模板字符串(Template Literals,即反引号包裹的语法结构)与普通单双引号字符串有着本质差异:反引号内部的所有换行、空格及制表符,在语法规范中都是字面量值的一部分。然而,自动化格式化工具的核心目标是保证代码在视觉层面的缩进一致性。这两者在遭遇多行嵌套时会产生直接冲突。
1. 常见表现:缩进前导空格被混入实际字符串
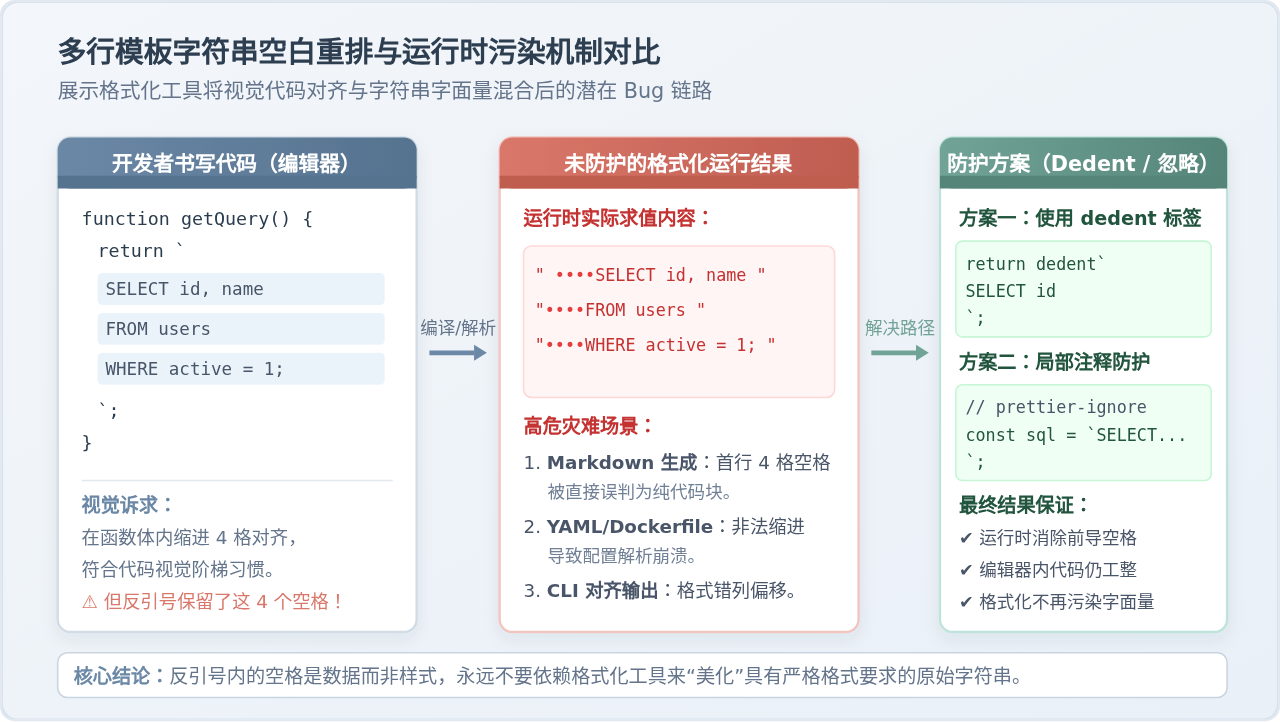
当模板字符串出现在多层缩进的函数或类方法内部时,格式化工具为了使反引号内的代码符合整体缩进阶梯,通常会将每一行文字按当前作用域层级向右缩进 2 个或 4 个空格。这在视觉上看起来整洁,但运行时的变量值中已经混入了大量的多余空格。
// 编写者期望生成的纯净SQL语句
function buildQuery(tableName, condition) {
  // 格式化器为了对齐代码,将内部每行前追加了缩进空格
  return `SELECT id, name, created_at
    FROM ${tableName}
    WHERE status = 1
      AND ${condition};`;
}

// 实际运行时输出的字符串:
// "SELECT id, name, created_at\n    FROM users\n    WHERE status = 1\n      AND role = 'admin';"
// 注意:FROM 和 WHERE 前面的4个空格已成为SQL字面量的一部分!
对于 SQL 引擎而言,前导空格通常会被词法解析器忽略;但在以下常见业务场景中,这种隐蔽的空格渗透会导致严重故障:
- 内联 Markdown / 富文本生成:Markdown 规范对行首空格极其敏感。如果一行前无意中被格式化器注入了 4 个空格,该行将直接被解析为代码块(Code Block),彻底破坏原本的排版。
- 命令行工具与 CLI 交互:终端输出的提示信息若被多重缩进,会导致控制台排版严重错乱,甚至破坏依赖固定列宽的对齐格式。
- 文件模板与代码生成器(Code Generator):自动生成配置(如
Dockerfile、YAML或代码片段)时,缩进空格具有严格语法语义,多出或减少 2 个空格就会造成语法报错。 - 插值表达式
${}换行溢出:当${...}内部的逻辑表达式较长时,格式化器会强行在其前后插入换行,导致目标字符串内部意外多出一个真实的换行符
二、模板字符串防破坏的落地方案
要解决模板字符串被破坏的问题,核心思路是“隔绝格式化介入”或“在运行时消除视觉缩进”。开发者可以根据字符串的用途选择对应的策略。
方案 A:使用 dedent 标签消除缩进偏差(推荐)
如果希望代码在编辑器中保持优雅的缩进排版,同时在运行时又绝不包含多余前导空格,最佳做法是借助标签模板(Tagged Template),例如轻量开源工具 dedent(或自写轻量函数)。
import dedent from 'dedent';

function generateDoc(title, author) {
  // 代码保留视觉缩进,dedent会在运行时自动剥离公共最小前导空白并清理首尾空行
  return dedent`
    # ${title}

    本文档由 ${author} 自动生成。
    - 状态:已验证
    - 格式:标准Markdown
  `;
}

console.log(generateDoc("API规范", "张工"));
// 输出结果首行绝无前导空格,Markdown结构完整无损
方案 B:使用行内注释屏蔽局部格式化
在不需要额外引入依赖且该字符串结构极其特殊的场景下,可以直接使用格式化工具提供的局部忽略注释(如 Prettier 的 // prettier-ignore 或 Biome 的 // biome-ignore format: explanation):
function getShellScript(env) {
  // prettier-ignore
  const script = `#!/bin/bash
set -e
export ENV="${env}"
echo "Deploying..."`;
  return script;
}
💡 关键注意
// prettier-ignore 只对其紧邻的下一行 AST 节点生效。如果作用于变量声明,则整个赋值语句及其中的模板字符串都将完全跳过格式化。
方案 C:将复杂插值表达式移出反引号
为防止格式化工具在 ${} 内部触发复杂断行,不要在插值占位符中直接编写多目三元运算、长函数调用或复杂对象取值。应当先在外部定义清晰的局部变量:
// ❌ 容易被强行折行的高危写法
const message = `Hello, ${user.isVip ? (user.points > 1000 ? 'Platinum Member' : 'Gold Member') : 'Regular User'}!`;

// ✅ 安全且易读的重构写法
const membershipTier = user.isVip
  ? (user.points > 1000 ? 'Platinum Member' : 'Gold Member')
  : 'Regular User';
const message = `Hello, ${membershipTier}!`;
三、陷阱剖析:长链式调用为什么会被机械拆散?
第二大受害者是函数式编程和构建器模式(Builder Pattern)中广泛存在的长链式调用(如 Array 操作、Promise 链、RxJS 操作符、Knex/Prisma 查询构建器等)。
1. 为什么格式化器会把链式调用切得稀碎?
主流格式化工具(以 Prettier 为代表)遵循最大打印宽度(printWidth,默认 80 字符)硬指标。当整行字符数超出限制时,其排版引擎会访问 AST 中的 CallExpression 与 MemberExpression,自右向左或自上而下进行换行拆分。
然而,格式化算法通常只识别语法树上的调用层级,缺乏对业务管道语义的理解。这就容易导致原本属于同一个“过滤-转换-聚合”业务闭环的紧密链条,被均匀而机械地切成十几行,每一个点号和括号散落各处,破坏代码的“一眼可读性”:
// 格式化工具机械折行造成的视觉灾难
const processedUsers = rawUserData
  .filter(
    (user) =>
      user.isActive &&
      user.age >= 18 &&
      user.verificationStatus === 'VERIFIED'
  )
  .map((user) => ({
    uid: user.id,
    fullName: `${user.firstName} ${user.lastName}`,
    score: calculateUserScore(user)
  }))
  .sort((a, b) => b.score - a.score)
  .slice(0, 10);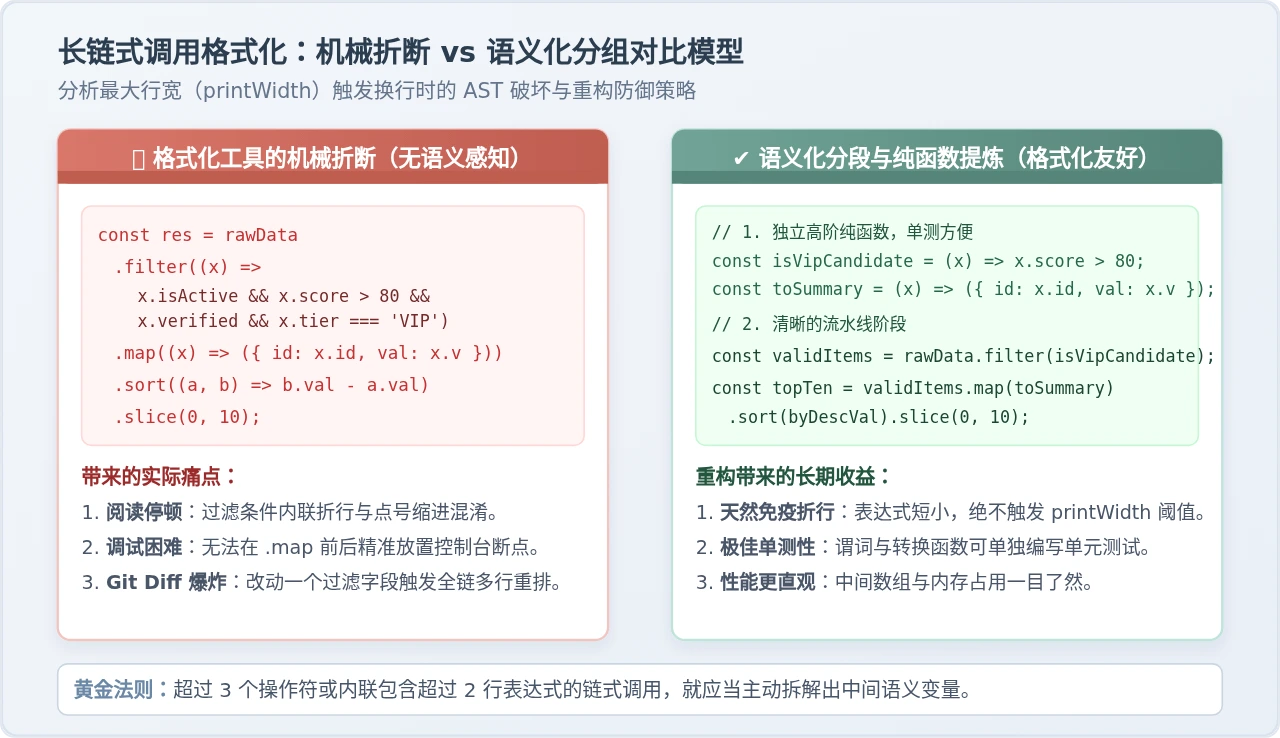
四、长链式调用防破坏的落地方案
保持链式调用整洁与稳定的核心不是“与格式化器死磕配置”,而是通过合理的架构分层与语法规范,使代码天然适应格式化算法。
方案 A:拆分为具名中间变量(Intermediate Variables)
过长的链式调用往往说明单个表达式承载了过多的业务职责。按照数据处理的逻辑阶段拆分出富有表达力的局部变量,不仅能从根本上消除行宽过长的问题,还能带来极佳的调试便利性(随时在各阶段打断点):
// 原始过长链条重构为三段具备明确语义的步骤
const eligibleUsers = rawUserData.filter(isValidAdultUser);
const enrichedProfiles = eligibleUsers.map(transformToProfile);
const topTenProfiles = enrichedProfiles
  .sort(sortByScoreDescending)
  .slice(0, 10);
方案 B:将内联匿名回调提炼为独立纯函数
长链式调用膨胀的最常见诱因就是 .map() 或 .filter() 内部塞入了庞大的内联箭头函数。将这部分业务规则提炼为外部纯函数(Pure Functions)后,链式调用即可保持高度紧凑:
// 将复杂判断逻辑提炼到外部
const isQualifiedApplicant = (candidate) => (
  candidate.isActive &&
  candidate.experienceYears >= 3 &&
  candidate.hasPassedExam
);

const toSummaryCard = (candidate) => ({
  id: candidate.id,
  name: candidate.name,
  level: candidate.grade
});

// 重构后整洁优雅的链条,即使经过格式化也不会发生断裂
const qualifiedCards = candidates
  .filter(isQualifiedApplicant)
  .map(toSummaryCard);
方案 C:针对不可分割的 DSL/QueryBuilder 实施精准忽略
在书写类似 Knex、RxJS 或 D3.js 等流式 DSL 时,由于方法具有高度前后依赖性,团队可能有一套约定俗成的垂直对齐习惯。此时可以使用格式化忽略指令:
// prettier-ignore
const query = db('orders')
  .select('id', 'total_amount', 'created_at')
  .where('status', '=', 'PAID')
  .andWhere('created_at', '>=', startDate)
  .orderBy('created_at', 'desc');
五、团队工程化配置:消除工具链规则互搏
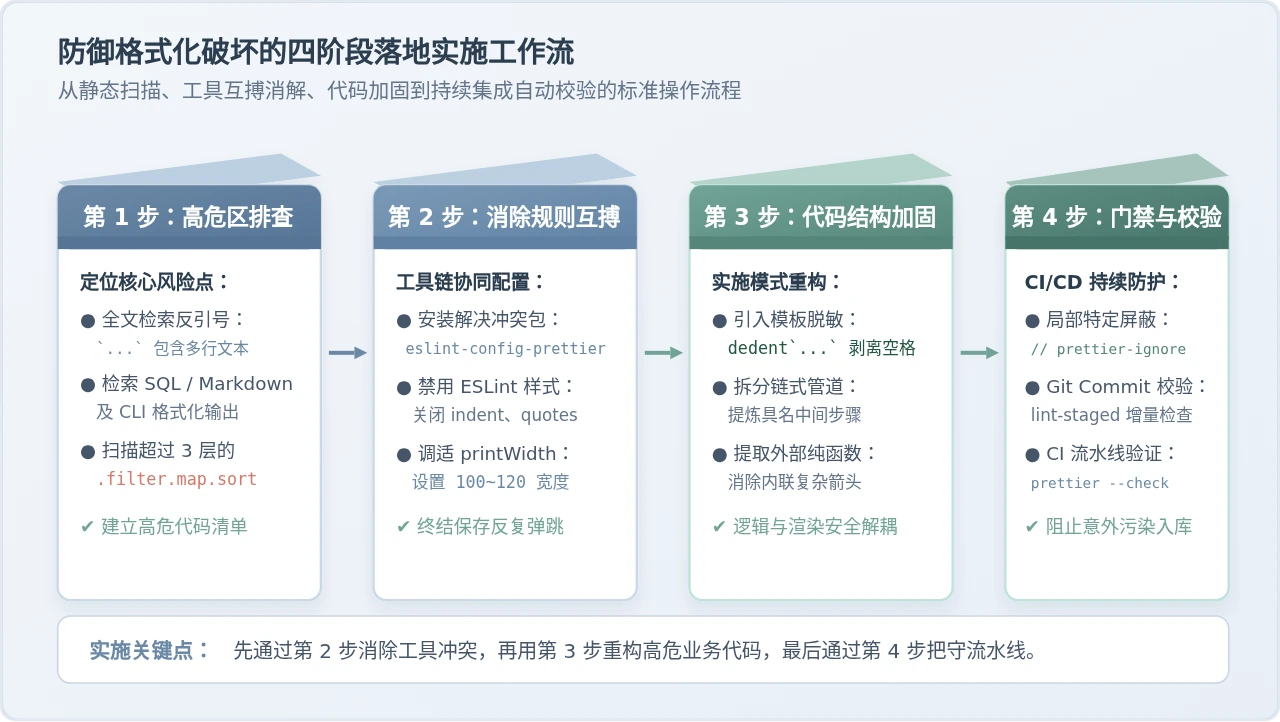
很多时候代码被“格式化破坏”,并不是工具本身有缺陷,而是ESLint、Prettier 与编辑器自带格式化器产生了冲突。例如 ESLint 的 indent 规则与 Prettier 的缩进算法不一致,导致保存代码时两者相互覆盖,引发链式调用或反引号不断弹跳和破坏。
关键防冲突配置步骤:
- 安装并启用
eslint-config-prettier:
运行npm install --save-dev eslint-config-prettier,在.eslintrc.js的extends数组最后一行加入"prettier"。这会自动关闭所有与排版冲突的 ESLint 规则,将格式化职责完全委托给专门工具。 - 统一团队编辑器设置(
.vscode/settings.json):
明确指定默认格式化程序,避免不同开发者机器上的插件版本不一:{ "editor.defaultFormatter": "esbenp.prettier-vscode", "editor.formatOnSave": true, "editor.codeActionsOnSave": { "source.fixAll.eslint": "explicit" } } - 合理设定
printWidth与tabWidth:
在.prettierrc中,不建议将printWidth设为过小的 80(在现代大屏和中文项目中容易引发密集断行),通常建议设置为100或120,给中等长度的链式调用和普通字符串留出舒适的行宽裕量。
六、策略对比与选型决策指南
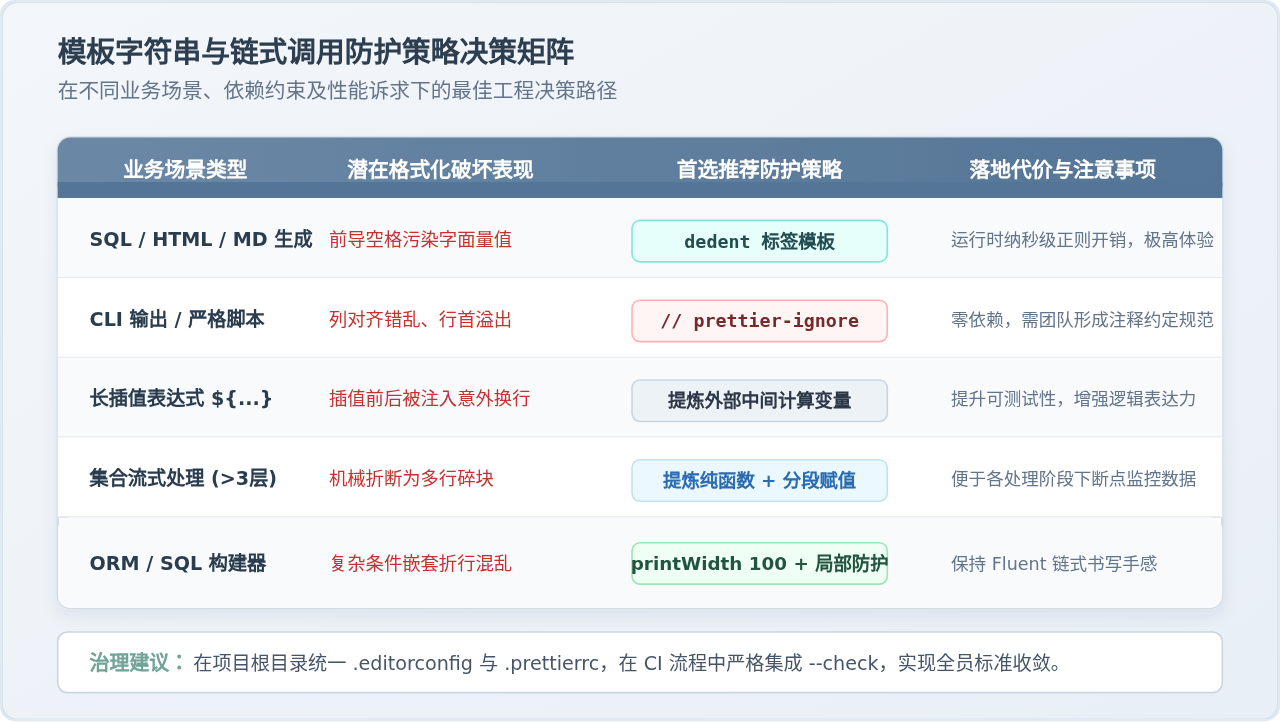
针对日常开发中遇到的不同代码模式,下表梳理了各类场景的推荐应对方案与适用边界:
| 代码形态 | 常见破坏现象 | 推荐解决方案 | 方案优势与适用边界 |
|---|---|---|---|
| 多行 SQL / HTML 模板 | 行首混入缩进空格,破坏输出格式 | dedent 标签模板 |
无缝保留代码可读性,运行时无任何多余空格侵入 |
| CLI 输出 / 严格格式文件 | 空格导致字符对齐错乱或语法失效 | // prettier-ignore |
零运行时开销,强行保留原始字符排版 |
| 插值内部逻辑复杂 | ${} 前后多出意外换行
|
提取中间变量 | 解耦计算与渲染,消除格式化器断行歧义 |
| 超过 4 层的集合运算链 | 每个点号单列一行,参数分散难辨 | 提炼高阶纯函数 + 中间变量 | 提高测试覆盖率,代码天然符合简短规范 |
| ORM / SQL QueryBuilder | 条件子句折行杂乱,语义边界断裂 | 规范 printWidth: 100 + 局部忽略 |
兼顾构建器流畅语法与局部定制格式 |
七、总结:编写“格式化友好”的稳健代码
自动化格式化工具并非“代码破坏者”,而是忠实反映抽象语法树的渲染器。避免格式化破坏的核心思维,是从“试图让格式化器猜透我的心思”转变为“主动编写具备防御性的、格式化友好的代码结构”:
- 对模板字符串保持敬畏:永远牢记反引号内的空白字符属于运行时数据,在需要精确控制格式的地方主动使用
dedent或局部忽略。 - 用高阶函数与中间变量重塑链式调用:当一条长链式调用被格式化器切得七零八落时,往往是代码复杂度发出的重构信号。拆分职责、提炼纯函数是比调大行宽更根本的解决之道。
- 收敛工具职责:让 Linter 专注代码质量与语法正确性,让 Formatter 专注视觉排版,并在工程根目录固定统一配置文件与 CI 校验命令,彻底消除团队内部的代码格式摩擦。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章