
深入对比JavaScript中split('')、扩展运算符([...str])与Array.from(str)将字符串转换为数组的区别,详解UTF-16代码单元与Unicode码点迭代机制、Emoji代理对拆分、性能与内置映射参数等实用选型依据。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS中split、扩展运算符与Array.from转换字符串的区别
作者:拾光
时间:2026-11-12
浏览:509
文章目录
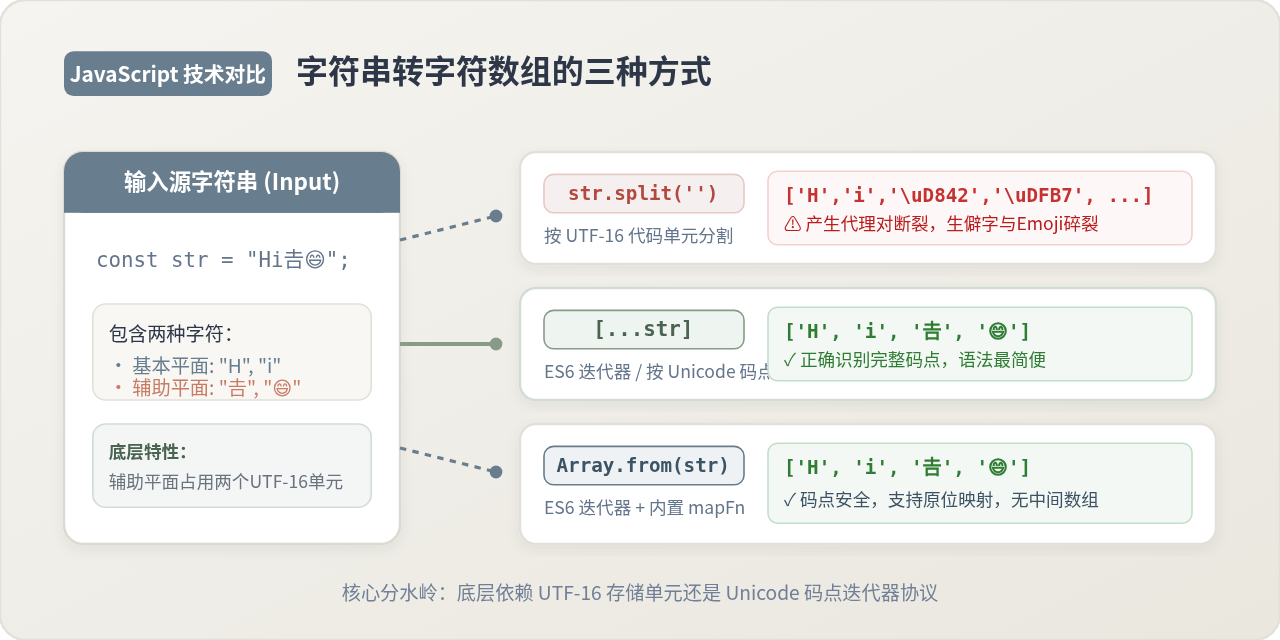
在 JavaScript 中,将字符串拆分为字符数组有三种原生常用方案:
str.split('')、扩展运算符 [...str] 与 Array.from(str)。三者的核心差异集中在两个方面:一是底层拆分依据——split('') 基于 16 位的 UTF-16 代码单元进行机械切割,遇到 Emoji 或生僻汉字等辅助平面字符时会导致高低代理对断裂形成乱码;而扩展运算符与 Array.from 遵循 ES6 字符串迭代器协议,按完整的 Unicode 码点逐字提取。二是功能扩展与执行开销——split 独有支持指定分隔符与正则表达式,Array.from 原生提供二次映射函数并避免额外分配中间数组,扩展运算符则语法极其简洁、便于就地组合。
一、三种方式的基础用法与表现对比
为了直观建立认知,首先观察在处理最基础的 ASCII 英文字符串时,三种方法的调用形式与返回值。针对纯英文或基础中文,三者均能按预期拆分为单字符数组:
// 示例输入:纯 ASCII 字符串
const str = "code";

// 1. split(''):String 原型方法
const arr1 = str.split('');
// 示例输出: ['c', 'o', 'd', 'e']

// 2. 扩展运算符 [...str]:ES6 展开语法
const arr2 = [...str];
// 示例输出: ['c', 'o', 'd', 'e']

// 3. Array.from(str):Array 构造函数静态方法
const arr3 = Array.from(str);
// 示例输出: ['c', 'o', 'd', 'e']
在上述简单场景下,三种写法得到的结果完全一致。然而,一旦面对包含多字节字符、Emoji 表情、生僻字,或者需要对拆分后的字符执行转换加工时,三者的底层机制差异便会直接影响代码的正确性与性能。
二、核心机制差异一:Unicode 码点与 UTF-16 代理对处理
要透彻理解三者的本质差别,必须先了解 JavaScript 内部的字符串存储机制。ECMAScript 规范规定,JavaScript 字符串在底层采用 UTF-16 编码。
1. 基本多语言平面与辅助平面的差异
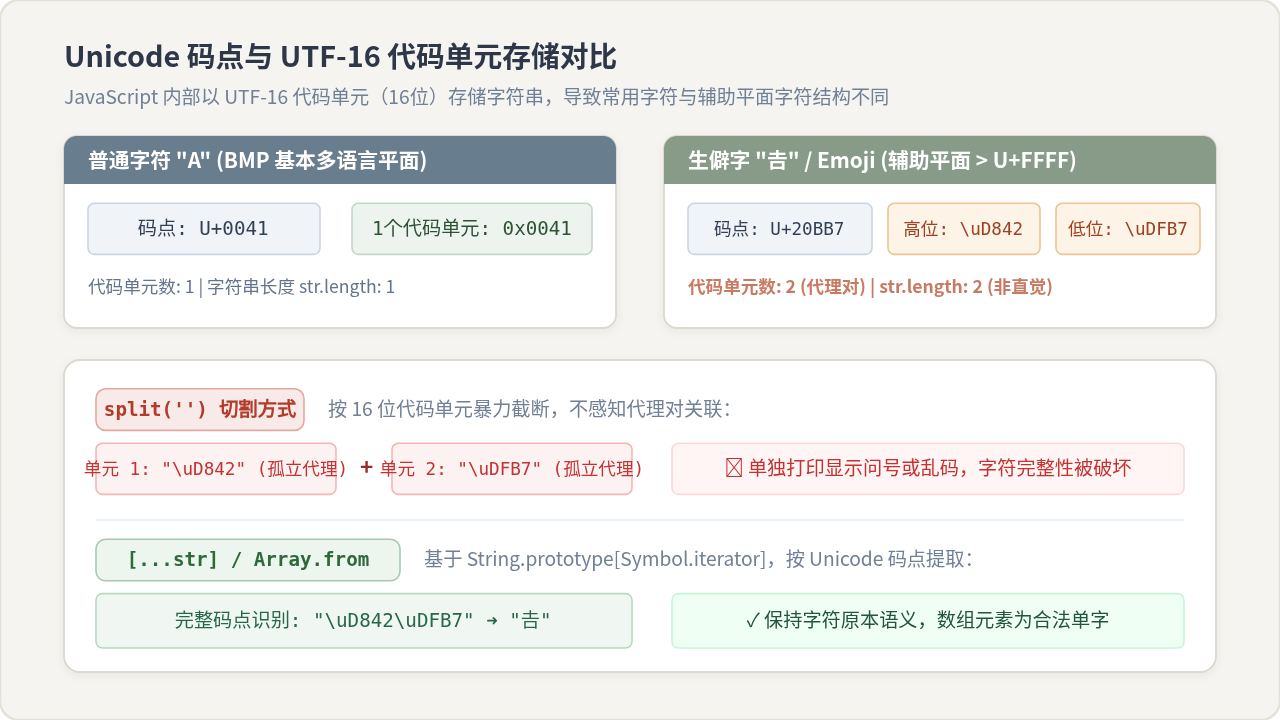
在 UTF-16 编码中,位于 U+0000 至 U+FFFF 范围内的字符被称为基本多语言平面(BMP)字符,包括英文字母、数字和绝大部分常用汉字。这些字符只需要一个 16 位的“代码单元(Code Unit)”即可存储,此时字符的长度 length 为 1。
但是,Unicode 的总字符集远超 65536 个。超出该范围的字符(从 U+010000 到 U+10FFFF,被称为辅助平面或增补平面字符),例如生僻字“𠮷”(U+20BB7)以及绝大多数 Emoji(如“😄” U+1F604),无法用单个 16 位单元表示。UTF-16 采用代理对(Surrogate Pair)机制,将一个码点拆解为“高位代理(High Surrogate)”和“低位代理(Low Surrogate)”两个 16 位代码单元联合存储。这就导致在 JavaScript 中,"𠮷".length 的结果是 2,而不是直觉上的 1。
2. split('') 的代理对碎裂缺陷
String.prototype.split(separator) 是从 ECMAScript 早期便存在的经典方法。当传入空字符串 '' 作为分隔符时,它的底层算法严格按照 16 位的 UTF-16 代码单元 进行逐一切割。它并不感知代理对之间的配对约束:
const word = "Hi𠮷😄";

const splitResult = word.split('');
console.log(splitResult);
// 示例输出: ['H', 'i', '\uD842', '\uDFB7', '\uD83D', '\uDE04']
console.log(splitResult.length); // 6
从输出可以看到,“𠮷”被硬生生切成了 \uD842 和 \uDFB7,“😄”被切成了 \uD83D 和 \uDE04。这些被拆散的孤立代理字符(Lone Surrogates)无法单独渲染,输出在控制台或界面上往往呈现为空白、问号或乱码。如果后续对该数组执行反转(reverse())或切片(slice()),高低代理位置被颠倒,字符语义将彻底损坏。
3. 扩展运算符与 Array.from 的迭代器安全保障
与之相反,扩展运算符 [...str] 和 Array.from(str) 诞生于 ES6。它们并非简单地读取字符串的索引或代码单元,而是调用了字符串原生的迭代器接口 String.prototype[Symbol.iterator]。
在 ECMAScript 规范中,字符串迭代器内置了代理对感知算法:当遍历遇到一个高位代理单元时,会自动检查后续紧邻的低位代理单元,并将两者组合为一个完整的 Unicode 码点(Code Point) 产出:
const word = "Hi𠮷😄";

// 扩展运算符
const spreadResult = [...word];
console.log(spreadResult);
// 示例输出: ['H', 'i', '𠮷', '😄']
console.log(spreadResult.length); // 4

// Array.from
const fromResult = Array.from(word);
console.log(fromResult);
// 示例输出: ['H', 'i', '𠮷', '😄']
console.log(fromResult.length); // 4
延伸提示:关于复合 Emoji 的多码点现象
虽然
[...str] 和 Array.from 能够完美处理单个 Unicode 码点的辅助平面字符(如单个 Emoji),但部分复合 Emoji(如由零宽连字符 ZWJ 连接的家庭组合 👨👩👧👦、或带有肤色修饰符的 👍🏽)本身由多个独立 Unicode 码点组合而成。由于它们本就包含多个码点,按码点拆分依然会拆解出基准人像与修饰符。若业务需要严格按人类视觉感知单元拆分字符串,建议结合现代标准的 Intl.Segmenter 进行文本分段。
三、核心机制差异二:语法特性、附加参数与转换能力
除了字符编码层面的根本差异,三者在 API 签名、参数接受度以及内存运行效率上同样有着明确的分工。
1. String.prototype.split:独有支持分隔符与数量截断
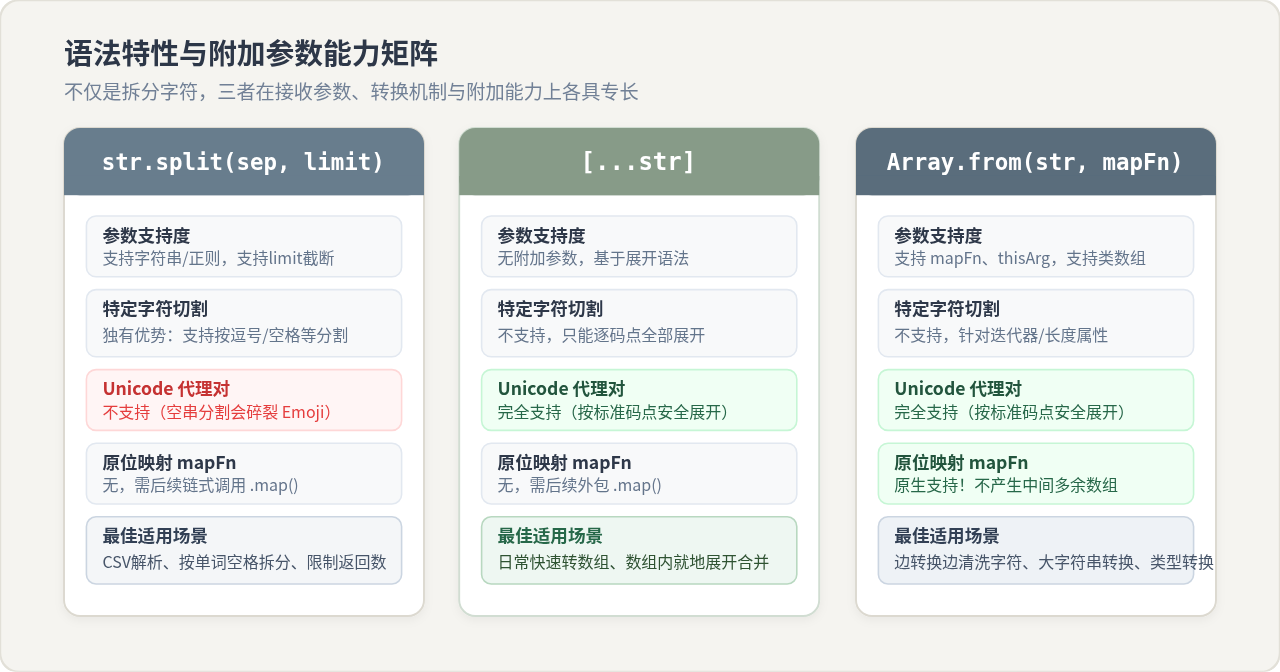
split 的定位并非单纯的“单字拆解”,而是一个通用的“定界符文本分割工具”。它的参数签名包含两个可选参数:str.split(separator, limit)。
- 任意子串与正则表达式:可以按照逗号、空格、多字符定界符甚至复杂的正则表达式(如
/\s+/)进行文本切割,这是另外两种方法完全不具备的。 - limit 截断参数:通过传入非负整数
limit,可以在分割出指定数量的元素后立即终止,无需切割整段字符串:
const logEntry = "2026-11-11 ERROR Database connection failed";

// 使用正则按空格拆分,并限制前 3 项
const parts = logEntry.split(/\s+/, 3);
// 示例输出: ['2026-11-11', 'ERROR', 'Database']
2. 扩展运算符:极简的语法糖与数组就地组装
扩展运算符是语言级别的解构展开语法,只能将整个字符串作为可迭代对象展开,不接受任何配置参数。它的最大优势在于书写极其精简,且能够非常自然地嵌入到更复杂的数组字面量中进行就地拼接或解构赋值:
const prefix = ['Start'];
const str = "ABC";

// 与其他元素就地合并
const combined = [...prefix, ...str, 'End'];
// 示例输出: ['Start', 'A', 'B', 'C', 'End']

// 结合解构提取首字符与剩余字符
const [firstChar, ...restChars] = str;
// firstChar 为 'A',restChars 为 ['B', 'C']
语法注意事项:扩展运算符要求操作对象必须实现了
[Symbol.iterator]。如果传入 null、undefined 或未实现迭代器的普通对象,会直接抛出 TypeError: object is not iterable 异常。
3. Array.from:原生映射参数与零中间数组优化
Array.from(items, mapFn?, thisArg?) 的功能维度最为全面。它不仅能够转换可迭代对象(如 String、Set、Map),还能够将任何拥有 length 属性和整数索引的类数组对象(Array-like Object)转为真正的数组。
更重要的是,Array.from 支持第二个可选参数 mapFn。如果在将字符串转为数组的同时需要对每个字符进行处理(例如清洗、修剪、获取 Unicode 码值),使用 Array.from 的性能明显优于 [...str].map():
const text = "12345";

// 方式 A:先展开再 map(会创建中间临时数组,造成二次遍历与GC压力)
const doubleA = [...text].map(char => Number(char) * 2);

// 方式 B:Array.from 原位映射(单次遍历,直接构建目标数组)
const doubleB = Array.from(text, char => Number(char) * 2);
// 示例输出: [2, 4, 6, 8, 10]
在方式 A 中,JavaScript 引擎必须先在内存堆中分配一个包含所有中间字符的数组,然后再调用 .map() 分配第二个目标数组;而方式 B 在迭代字符串生成最终数组的过程中直接完成了函数计算,节约了中间临时数组的内存开销与垃圾回收损耗。
四、字符串转数组与加工处理的标准操作流程
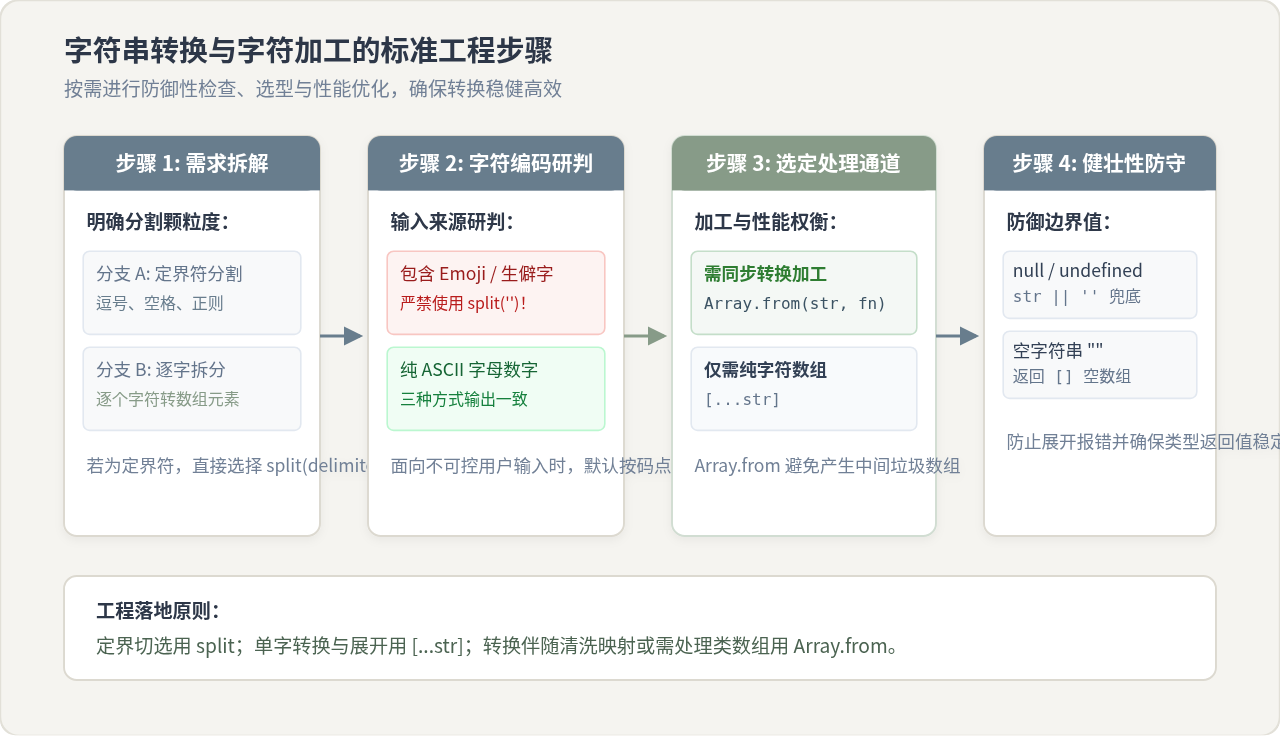
在实际工程代码中,为了兼顾健壮性、字符安全与执行性能,开发者应按照规范的决策顺序选择转换方式。以下是标准的四步操作流程:
第 1 步:明确拆分目标是定界符还是单字符
如果业务需求是按照特定分隔符(如逗号、分号、换行符或正则表达式)切割字符串,无需犹豫,必须使用 str.split(separator)。扩展运算符与 Array.from 不支持定界符参数。
第 2 步:评估字符串来源与编码安全性
当目标是将字符串逐字拆分为单字符数组时,必须评估输入文本的来源。若输入属于用户自主输入的内容(如用户名、评论、昵称、国际化文本),很有可能包含 Emoji、非中欧字符或生僻字,此时一律禁止使用 str.split(''),应立即切换至基于 Unicode 码点的迭代器方式。
第 3 步:根据后续处理需求选择实现通道
如果仅需要快速获取字符数组,或者需要将字符与其他数组元素合并,优先采用语法简明直接的 [...str];如果需要对拆解出的每个字符进行清洗、数值转换、属性映射等二次处理,优先采用 Array.from(str, mapFn),避免构建冗余的中间数组。
第 4 步:针对边界值添加防御性代码
在真实业务函数中,传入的变量可能为 null、undefined 或空字符串。为了避免运行时抛出异常并保证返回值类型一致,应在转换前添加防御性默认值:
// 稳健的单字处理函数示例
function extractChars(input) {
  // 兜底为空字符串,保证始终返回数组类型
  const safeStr = input ?? '';
  return Array.from(safeStr, c => c.trim()).filter(Boolean);
}
五、场景选型决策指南与特性速查总结
综合以上对底层原理、运行表现与语法特性的分析,下表全面总结了 split、扩展运算符与 Array.from 在关键维度上的具体差异:
| 对比维度 | str.split('') |
[...str] |
Array.from(str) |
|---|---|---|---|
| 底层拆分依据 | UTF-16 代码单元(16位) | Unicode 码点迭代器 | Unicode 码点迭代器 |
| 辅助平面字符 (Emoji/生僻字) | ❌ 碎裂为孤立代理对乱码 | ✓ 正确保留完整字符码点 | ✓ 正确保留完整字符码点 |
| 特定分隔符与正则 | ✓ 原生完整支持 | ❌ 仅限全量逐字展开 | ❌ 仅限全量逐字转换 |
| 截断限制 (limit) | ✓ 原生支持第二个参数 | ❌ 不支持截断 | ❌ 不支持截断 |
| 内置映射处理 (mapFn) | ❌ 需后续链式调用 .map() |
❌ 需后续链式调用 .map() |
✓ 原生支持,避免中间临时数组 |
| 支持类数组对象 | ❌ 仅限 String 原型 | ❌ 仅限可迭代对象 | ✓ 兼容 { length: 3 } 等对象 |
| 语法形式与可读性 | 标准方法调用,语义明确 | 最为简洁精巧,易于嵌套组合 | 静态函数调用,表意严谨 |
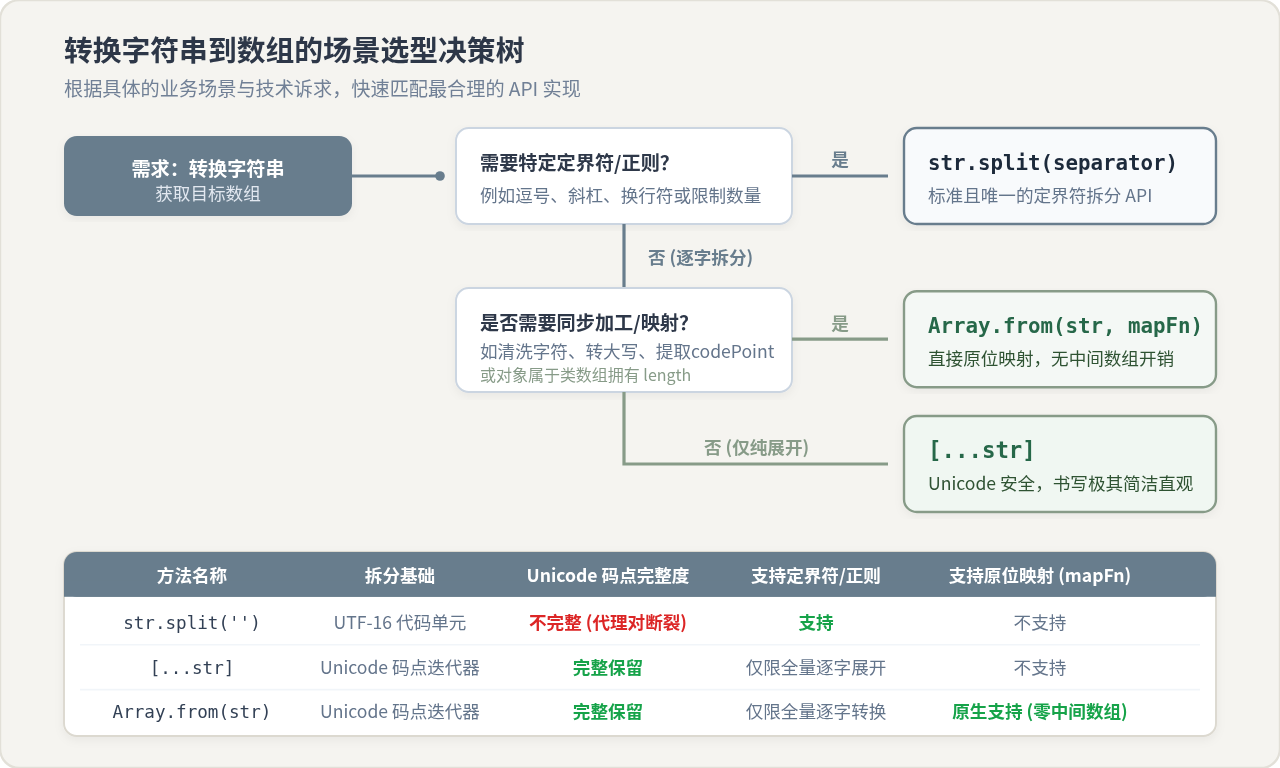
总结而言,在现代 JavaScript 开发中:
- 按特定符号或正则表达式切分文本时,
split是唯一的标准方案; - 单纯进行单字符安全拆分、快速反转字符串或在数组中就地展开拼接时,优先使用
[...str]; - 在转换的同时需要对字符进行加工处理、或者需要兼容类数组对象时,优先使用
Array.from(str, mapFn)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章