

深入解析 JavaScript 中 window.location.href 与 window.location.replace 的本质区别。从浏览器会话历史栈内存模型、执行生命周期,到鉴权拦截死循环与支付防重提交等实战场景,提供清晰严谨的技术选型指南。
JS location.replace与href跳转的区别及适用场景
作者:流萤
时间:2026-11-03
浏览:376
文章目录
JavaScript 核心导航机制
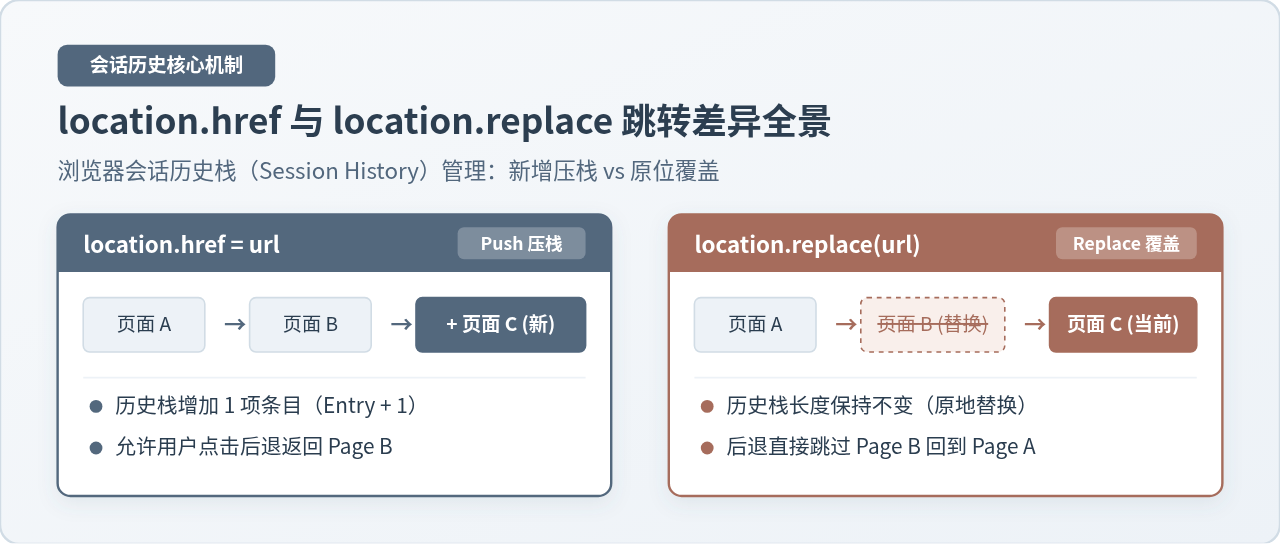
图 0:location.href 与 location.replace 导航机制的核心差异全景
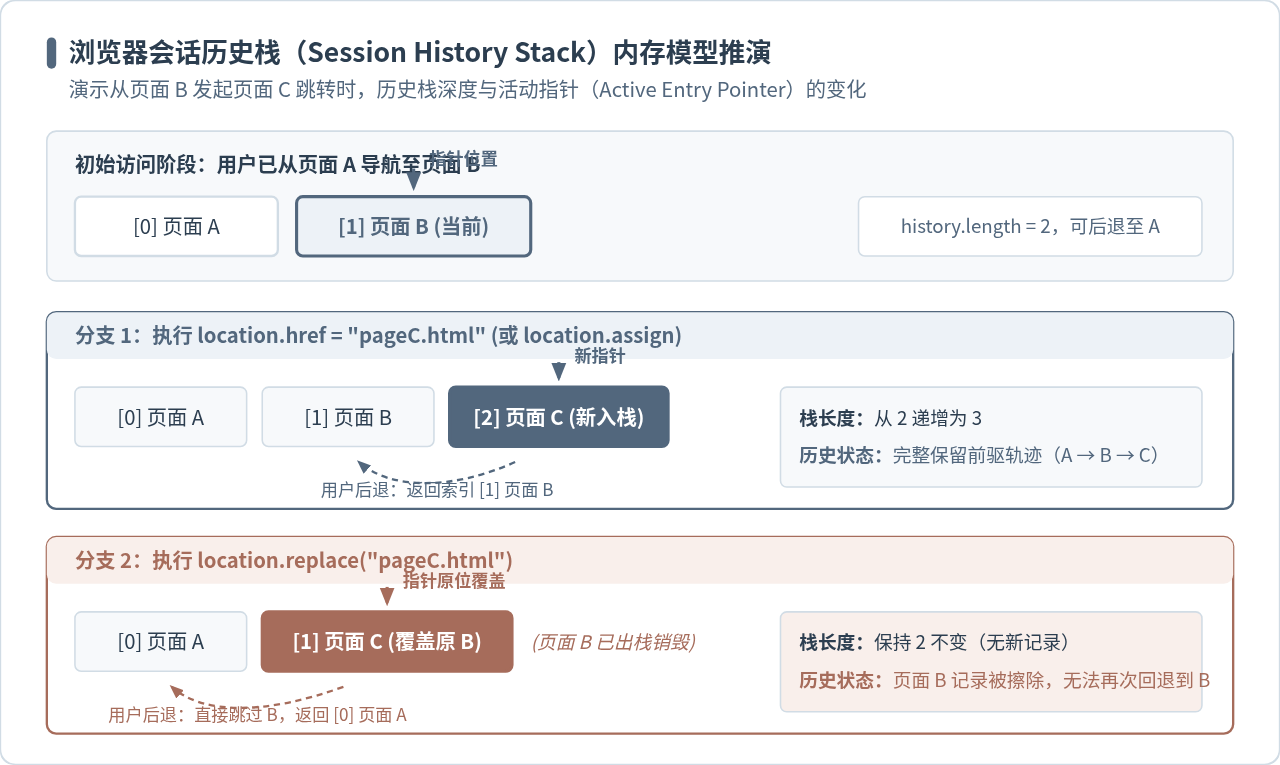
图 1:浏览器会话历史栈(Session History Stack)入栈与替换对比
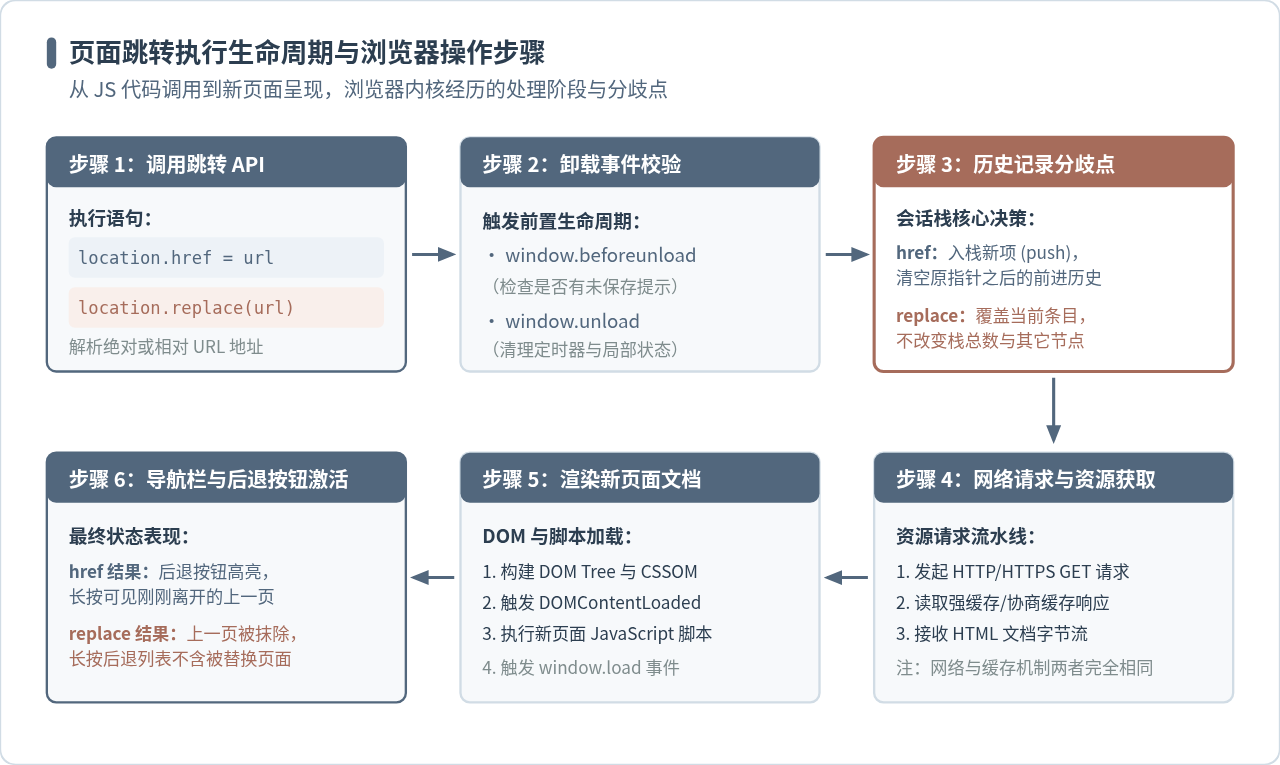
图 3:JavaScript 页面跳转执行生命周期与浏览器操作步骤
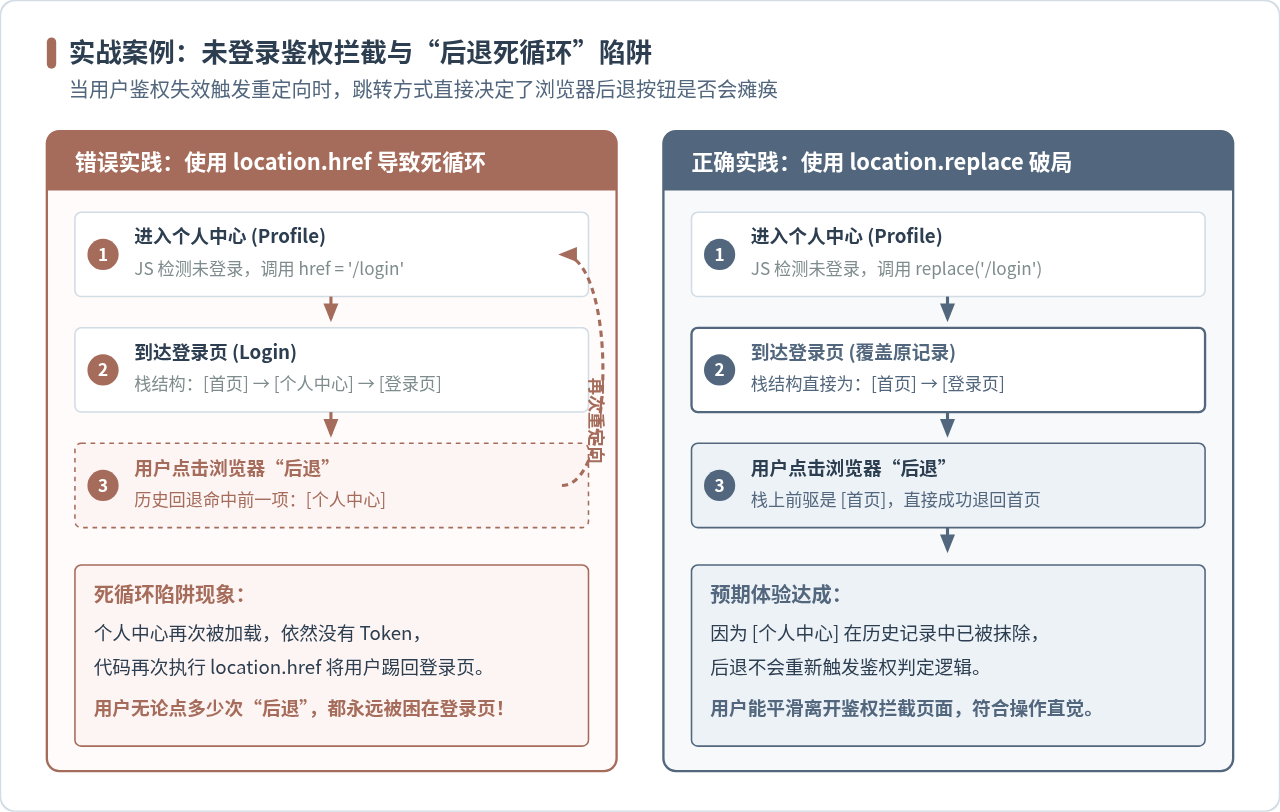
图 2:未登录权限拦截场景下的“后退死循环”与解决方案
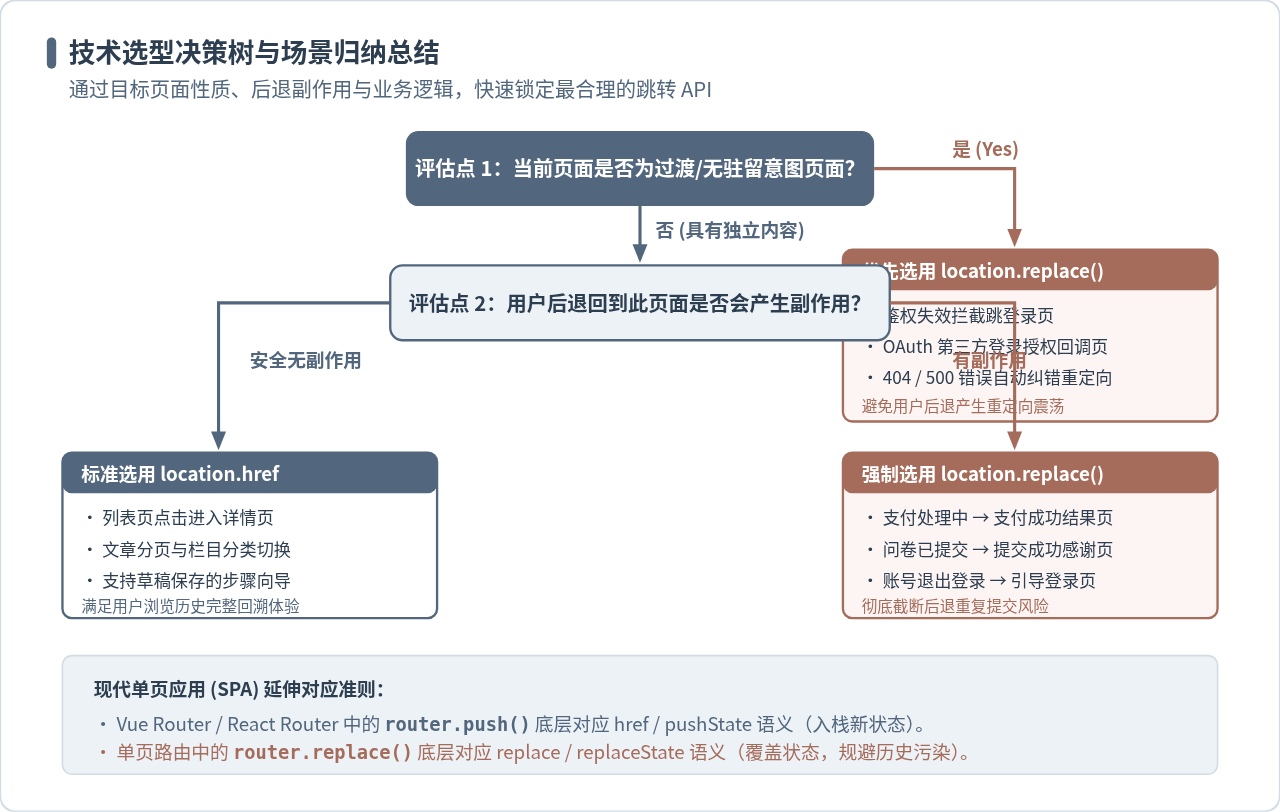
图 4:location.replace 与 href 技术选型决策树
分类:Web开发 / 前端原理
关键词:location.replace / location.href / 会话历史栈
在 JavaScript 开发中,
window.location.href 与 window.location.replace() 都能使浏览器导航至新地址,两者的根本区别在于对浏览器会话历史栈(Session History Stack)的处理方式不同:location.href 会把目标页面作为新记录项压入历史栈,允许用户点击“后退”按钮返回原页面;而 location.replace() 则直接用新页面覆盖当前历史记录,彻底抹除原页面的访问痕迹,使用户点击“后退”时直接跳过当前页。理解这一分歧是规避“鉴权后退死循环”与防止“重复提交表单”的关键。
一、核心机制对比:会话历史栈的“压栈”与“替换”
当我们在浏览器控制台执行页面重定向时,直观上看到的是浏览器地址栏更新并加载了新页面。但在浏览器底层,导航控制器(Navigation Controller)会同步维护当前标签页的会话历史记录(Session History)。
可以通过浏览器全局属性 history.length 观察历史条目总数。window.location.href 属于赋值操作,底层等同于标准导航行为;而 window.location.replace() 则是专门暴露的方法调用,它显式通知浏览器放弃为当前文档保留历史镜像。
如上图所示,假设用户当前的浏览轨迹为从“页面 A”访问到“页面 B”,此时会话栈中存在 2 条记录,活动指针停留在索引 [1](页面 B)。
- 使用
location.href = "pageC.html":浏览器在索引[2]处压入新页面 C,指针前移到[2],history.length变为 3。用户点击浏览器工具栏的“后退”按钮,指针安全退回索引[1],页面重新加载或恢复为页面 B。 - 使用
location.replace("pageC.html"):浏览器不在栈顶开辟新空间,而是直接将索引[1]的“页面 B”改写为“页面 C”。history.length依然维持 2,页面 B 的 URL 及状态被彻底剔除。用户点击“后退”按钮时,浏览器退回到索引[0],即直接回到页面 A。
二、API 语法与执行生命周期
在编码实践中,两个 API 接受的参数形式和调用方式存在差异。理解具体的执行生命周期有助于我们在复杂交互中选择正确的触发时机。
1. 完整代码调用示例
// 方式一:location.href(支持相对路径与绝对路径)
window.location.href = '/dashboard/overview';
// 等价简写(不推荐,易读性较弱):
// location = '/dashboard/overview';

// 方式二:location.replace(必须作为函数调用,传入目标 URL 字符串)
window.location.replace('/login?redirect=' + encodeURIComponent(window.location.pathname));

// 补充:location.assign 的行为与 location.href 完全一致
window.location.assign('/dashboard/overview'); // 同样会产生新历史记录
语法注意:
location.replace() 是一个函数,必须使用括号传参调用;若误写为 location.replace = url,不但无法触发跳转,还会导致脚本运行时静默失败或覆盖内置方法。此外,传入相对路径(如 'detail.html')时,两者都会依据当前文档的 Base URL 自动解析为完整的绝对地址。
2. 浏览器内部处理步骤
- 触发跳转调用:脚本执行
location.href赋值或location.replace()函数调用,引擎解析目标 URL 的合法性。 - 分发卸载前置事件:浏览器检查并触发当前文档的
window.onbeforeunload与window.onunload事件。如果有未保存表单且注册了确认弹窗,用户可在此阶段取消导航。 - 会话历史指针计算(核心分歧):若为
href,在栈顶创建新条目并推进指针;若为replace,原地更新当前条目的 Document Reference 与 URL。 - 网络与资源加载:浏览器网络进程建立 TCP/TLS 连接,发起 HTTP GET 请求,并根据 HTTP 响应头执行缓存判定(两者在此阶段完全遵循相同的网络与缓存规范)。
- 新页面渲染:浏览器清空旧 DOM,解析新 HTML 字节流,构建 DOM 树与 CSSOM,并依次分发
DOMContentLoaded与load事件。 - 刷新导航控制区状态:根据历史栈状态,更新浏览器地址栏、“后退”按钮高亮可用性及历史记录下拉列表。
三、实战对比:规避登录鉴权中的“后退死循环”
在实际项目开发中,如果混淆了两者的使用场景,最典型的灾难性 Bug 就是未登录拦截导致的“后退死循环”(Infinite Redirect Loop)。
很多前端新人习惯于任何跳转都使用 location.href。设想一个常见场景:用户未登录状态下直接在地址栏输入或者点击外链访问 /user/settings(受保护的个人设置页)。该页面在加载时发现用户没有鉴权 Token,立刻执行跳转到 /login 页面。
死循环产生的具体推导:
- 用户从搜索引擎(外部页面)进入
/user/settings,历史栈记录为:[0] 搜索引擎→[1] 个人设置页。 - 个人设置页执行
location.href = '/login',此时历史栈变为:[0] 搜索引擎→[1] 个人设置页→[2] 登录页。 - 用户到达登录页后,如果改变主意不想登录,顺手点击浏览器的“后退”按钮。
- 浏览器将当前指针退回到
[1] 个人设置页。 - 个人设置页重新运行其初始化脚本,再度检测到“无 Token”,毫不犹豫地再次执行
location.href = '/login'。 - 用户立刻被弹回登录页,造成“后退按钮彻底失灵”的假象。如果用户拼命快速双击后退,甚至可能在历史栈中堆叠出十几个交替的记录项。
解决方案:在此类重定向场景下,将跳转代码严格改为
window.location.replace('/login')。由于设置页在历史栈中被登录页就地取代,栈结构保持为 [0] 搜索引擎 → [1] 登录页。用户点击后退时,直接返回到搜索引擎页面,死循环被彻底打破。
四、典型适用场景与选型决策
区分何种场景选用何种 API,关键在于追问一个问题:“如果用户在这个页面点击后退,回到上一页是否合乎逻辑且安全?”
1. 必须优先使用 location.replace 的五大场景
- 权限拦截与未登录重定向:如上述案例,由受保护页面重定向到登录页,或已登录用户误入登录页后被重定向到主页。
- OAuth 第三方登录中转回调页:微信、GitHub、Google 等授权登录后,前端回调地址(如
/oauth/callback?code=xxx)仅用于解析 Authorization Code 并换取 Token。此页面为纯瞬态中转页,必须用replace跳转到业务首页,避免用户后退重新触发已失效的 code 请求。 - 错误状态与自动降级跳出:当页面发生 404 Not Found、500 服务异常或参数缺失时,倒计时后跳转到站点主页,必须使用
replace,防止用户后退反复陷入错误页面。 - 敏感操作后的不可逆状态迁移(防重复提交):例如在电商结账流程中,从“订单支付中/支付确认”跳往“支付成功结果页”,必须使用
replace。否则用户后退回到支付页面,极易导致重复发起支付请求或产生订单状态紊乱。 - 退出登录(Logout)清理:用户在后台点击“退出登录”,前端清理 LocalStorage 中的凭据后,应使用
replace跳转到欢迎页或登录页,杜绝用户通过后退看到已注销界面的缓存数据(BFCache)。
2. 应当使用 location.href 的常规场景
- 内容浏览与层级导航:从文章列表页点击进入详情页、从商品列表进入具体规格页,属于标准的树状或线性阅读流程,用户强烈依赖后退键返回列表。
- 分步骤填报表单(支持回退修改):例如投保流程第一步“填写个人信息”完成后进入第二步“确认保单”,若业务允许用户回退修改第一步,应使用
href。 - 模拟普通超链接(<a> 标签):按钮或卡片容器的点击事件中实现的页面导航,保持与常规 HTML 超链接一致的原生操作习惯。
五、参数与属性维度对比矩阵
为了在工程开发中便于查阅,以下将 location.replace、location.href 以及相似的 location.assign 进行全维度特性归纳:
| 对比维度 | location.href | location.replace() | location.assign() |
|---|---|---|---|
| 调用语法 | 属性赋值:href = url |
方法调用:replace(url) |
方法调用:assign(url) |
| 会话历史栈 | 新增条目(Push Entry) | 覆盖当前条目(Replace Entry) | 新增条目(Push Entry) |
| history.length | 通常增加 1 | 保持不变 | 通常增加 1 |
| 后退键(Back) | 可返回原页面 | 无法返回原页面,跳至前驱 | 可返回原页面 |
| 网络缓存策略 | 标准 HTTP 缓存行为 | 标准 HTTP 缓存行为 | 标准 HTTP 缓存行为 |
| SPA 框架映射 | router.push(path) |
router.replace(path) |
router.push(path) |
六、工程实践中的避坑与拓展建议
在实际项目落地时,开发者还需要留意与单页应用(SPA)、异步请求配合时的几个细节:
1. 单页应用(Vue / React / Angular)中的历史隔离
现代单页应用大多采用 HTML5 History API(history.pushState 与 history.replaceState)由前端路由引擎接管跳转,避免触发全页面刷新。
如果你的项目处于 Vue Router 或 React Router 环境下,请注意:直接调用 window.location.replace() 或 window.location.href 会导致整个浏览器重新发起网络请求并重新初始化整个 JS Bundle,丢失所有内存中的状态(如 Vuex / Pinia / Redux 状态)。
在单页路由中,应当对应使用路由提供的导航方法:
// Vue Router 中的映射
this.$router.push('/target');    // 对应 location.href 压栈
this.$router.replace('/target'); // 对应 location.replace 覆盖

// React Router (v6) 中的映射
const navigate = useNavigate();
navigate('/target');                  // 对应 location.href 压栈
navigate('/target', { replace: true }); // 对应 location.replace 覆盖
只有在跨越不同子域系统、跳出单页应用接入外部页面,或者必须强制刷新文档重置全局上下文时,才使用原生 window.location 对象。
2. 异步回调中的安全跳转
在发起 Ajax 或 Fetch 请求后重定向时,务必注意代码执行流。如下写法常常引发偶发异常:
// 容易导致逻辑穿透的错误写法
fetch('/api/logout').then(res => {
  if (!res.ok) {
    window.location.replace('/login');
    // 注意:JS 不会因为发起跳转而立即停止执行后续同步语句!
    console.log('正在跳转...');
  }
  doSomethingElse(); // 危险:页面尚未完全卸载前,后续代码仍可能执行
});

// 推荐的标准守卫写法
if (shouldRedirect) {
  window.location.replace('/login');
  return; // 明确阻断后续业务逻辑执行
}
调用 location.replace() 只是向浏览器发出了导航指令,在浏览器实际终止当前进程并销毁执行上下文之前,该作用域内的其余同步语句仍会被执行。因此在发出重定向后,务必添加 return 退出当前逻辑块。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章