

深入分析在JavaScript中读取本地文件时常见的报错与无响应原因,涵盖浏览器沙箱安全限制、FileReader异步生命周期错位、取消文件选择引发的异常、大文件内存占用及环境API混淆,提供具体排查步骤与合规代码示例。
JS读取本地文件时报错或无响应的常见原因
作者:青柠
时间:2026-11-05
浏览:196
文章目录
在 JavaScript 开发中,读取本地文件时发生报错或界面毫无响应,绝大多数情况并非简单的语法错误,而是源于浏览器安全沙箱对磁盘路径的直接拦截、FileReader 异步生命周期处理不当、未防范用户取消选择导致的空指针,或是大文件阻塞了主线程渲染。明确这些核心机制并掌握规范排查顺序,可以快速解决文件交互中的绝大部分故障。
一、故障排查与分流顺序
当文件读取代码未按预期工作时,排查的第一步是区分“抛出明确报错”还是“静默无响应”。控制台有红字报错说明代码触发了浏览器的安全拦截或未捕获异常;若控制台无报错但变量为空或页面卡死,则应重点检查异步时序或内存负荷。
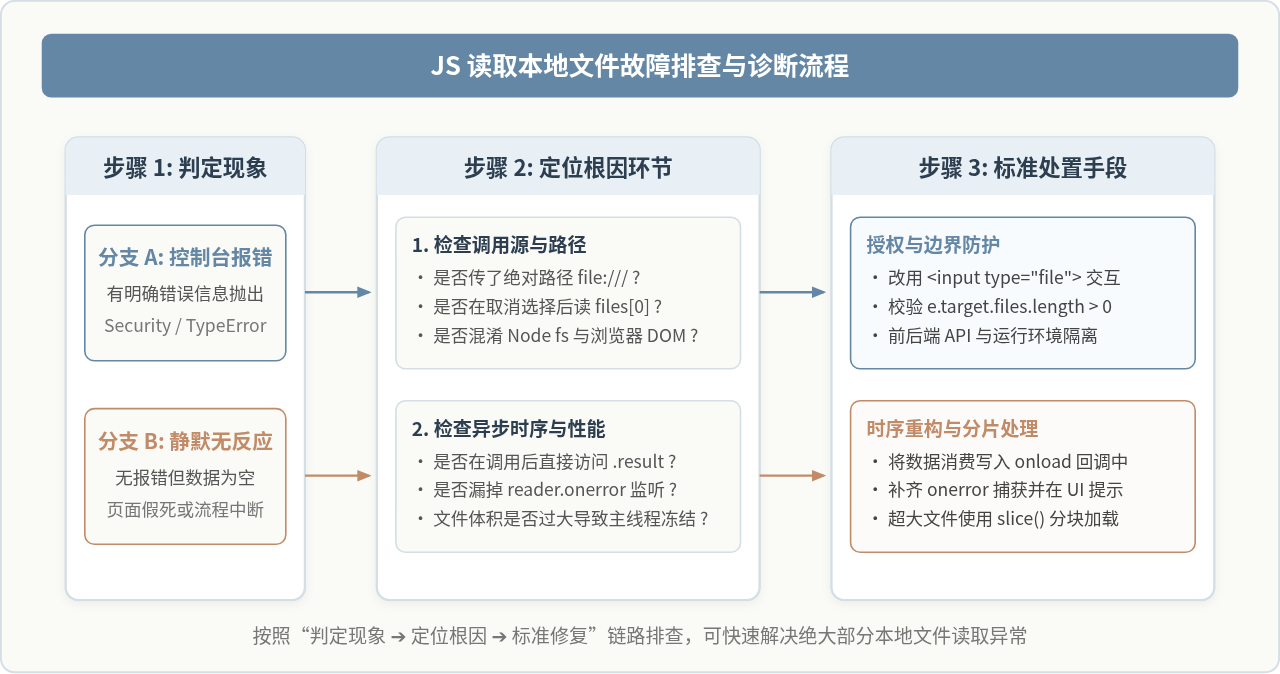
排查顺序按部就班定位故障节点
- 查看开发者工具 Console:确认是否有
Not allowed to load local resource、SecurityError或TypeError。 - 检查文件获取途径:确认代码是接收来自用户选择的
File对象,还是误用了本地磁盘字符串路径。 - 追踪异步回调:确认读取操作是否完整注册了
onload与onerror,避免在同步代码块中立即获取结果。 - 评估文件体积:确认选定文件是否过大导致垃圾回收或阻塞主线程。
二、浏览器安全沙箱限制:直接传本地绝对路径报错
初学者在调试前端页面时,常希望像后端语言一样直接通过本地绝对路径读取文件,例如写出 fetch("C:/data.txt") 或 new XMLHttpRequest() 请求 file:/// 协议路径。在现代浏览器中,这类调用会被安全沙箱直接拦截。
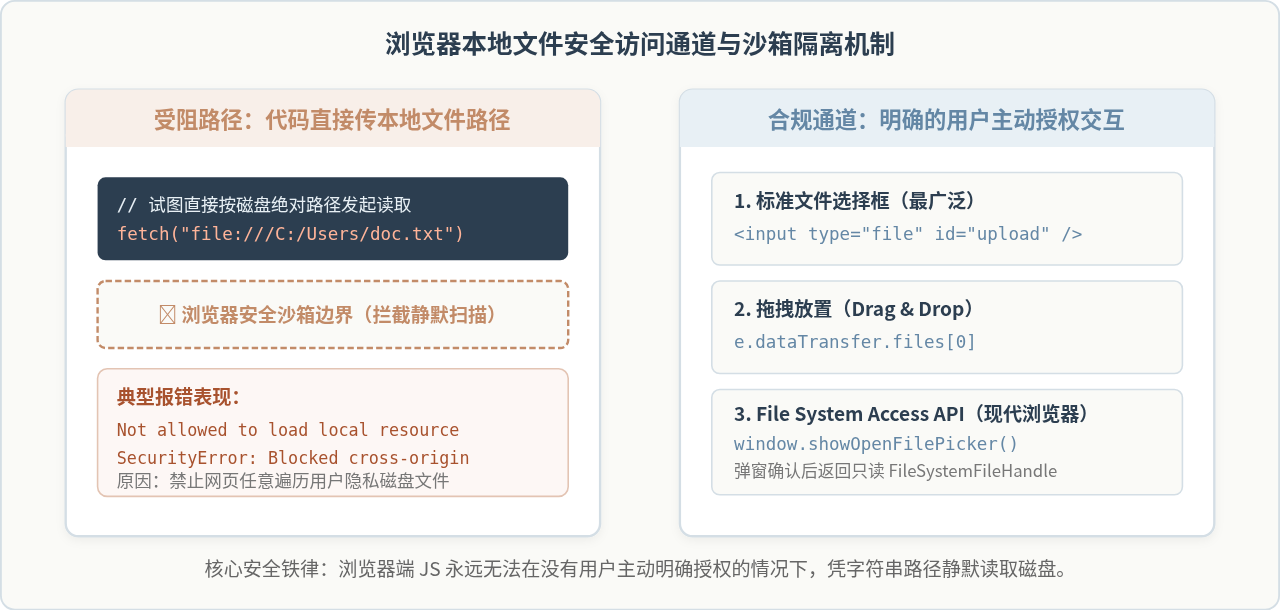
1. 报错表现与底层原因
浏览器控制台通常会输出以下两类典型错误:
- 报错
Not allowed to load local resource: file:///...:浏览器明确禁止网页上下文直接发起访问本地操作系统的 I/O 请求。 - 报错
SecurityError: Failed to execute 'fetch' on 'Window': URL scheme "file" is not supported:同源策略严格限制file://协议的跨源访问。
核心原因:这是浏览器安全模型的核心铁律。如果允许网页 JavaScript 仅凭文件路径就静默读取本地文件,任何恶意网页都能在用户不知情的情况下遍历读取硬盘上的敏感配置文件、SSH 密钥或隐私文档。因此,浏览器环境下的本地文件读取,必须建立在用户主动授权的基础之上。
2. 合规解决路径
必须改用浏览器提供的授权通道。常见方式有两种:
方案 A:标准文件选择输入框(兼容所有浏览器)
<!-- HTML 部分 -->
<input type="file" id="fileInput" />

<script>
  const fileInput = document.getElementById('fileInput');
  fileInput.addEventListener('change', (event) => {
    const file = event.target.files[0];
    if (!file) return; // 防范取消选择
    console.log('用户授权读取文件:', file.name, file.size);
  });
</script>
方案 B:现代 File System Access API(Chrome / Edge 等现代环境)
async function pickAndReadFile() {
  try {
    // 弹出系统级文件选择对话框
    const [fileHandle] = await window.showOpenFilePicker();
    const file = await fileHandle.getFile();
    const text = await file.text();
    console.log('文件内容读取成功:', text);
  } catch (err) {
    if (err.name !== 'AbortError') {
      console.error('读取异常:', err);
    }
  }
}
三、FileReader 异步时序错乱:读取结果为空或静默无响应
使用 FileReader 时最容易出现的现象是:控制台没有抛出任何报错,但取出来的变量始终是 null,或者无论如何操作界面都不刷新。这通常是由于混淆了同步与异步执行时序。
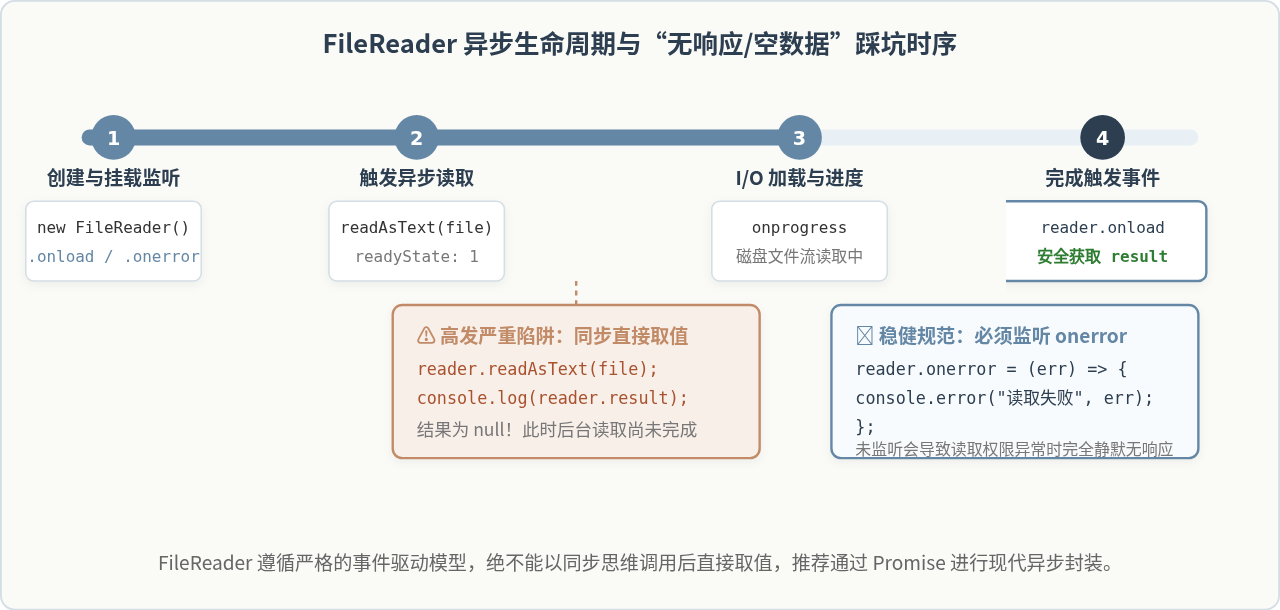
1. 常见陷阱:在启动读取后立即同步访问 result
初学者常误以为 readAsText() 是一个同步阻塞方法,在调用之后立刻去读取 reader.result:
// ❌ 错误示范:同步取值导致恒为 null
const reader = new FileReader();
reader.readAsText(file);
console.log(reader.result); // 输出: null!此时底层 I/O 尚未开始或正在进行中
在调用 readAsText() 的那一瞬间,reader.readyState 仅为 1(LOADING),文件的磁盘 I/O 需要交由浏览器后台线程异步读取,主线程此时继续向下执行。由于读取尚未完成,reader.result 自然为 null。
2. 常见陷阱:遗漏 onerror 监听导致静默失败
如果目标文件正在被其他进程独占写入、系统权限受限或磁盘扇区损坏,FileReader 会触发 onerror 事件。如果开发者只注册了 onload 而没有注册 onerror,错误就会被完全吞没,在用户看来表现为“点击后没有任何反应”。
3. 标准防范:基于 Promise 封装现代读取逻辑
推荐将事件驱动的 FileReader 包装为标准的 Promise,或者直接使用现代 File / Blob 原生支持的 file.text() 或 file.arrayBuffer():
// 方式 1:健壮的 FileReader Promise 封装
function readTextFile(file) {
  return new Promise((resolve, reject) => {
    const reader = new FileReader();
    // 先挂载监听器,再启动读取
    reader.onload = () => resolve(reader.result);
    reader.onerror = () => reject(new Error('文件读取失败: ' + reader.error));
    reader.readAsText(file, 'UTF-8');
  });
}

// 方式 2:现代浏览器原生异步 API(推荐)
async function handleFile(file) {
  try {
    const content = await file.text();
    console.log('读取成功:', content);
  } catch (error) {
    console.error('读取出错:', error);
  }
}
四、未做边界防范:取消选择导致的未捕获 TypeError
在实际使用中,用户点击上传按钮弹出系统文件对话框后,经常会点击“取消”或按 ESC 键退出。此时,<input type="file"> 仍然会触发 change 事件,但其 files 列表长度为 0。
⚠️ 典型报错现象
TypeError: Cannot read properties of undefined (reading 'name') 或后续传给 readAsText(undefined) 时抛出 TypeError: Failed to execute 'readAsText' on 'FileReader': parameter 1 is not of type 'Blob'。
当未做边界校验时,该未捕获异常会导致整个后续交互事件函数被强制终止。对用户而言,再次点击或选择时,界面可能毫无反应。
// 规范防范写法
document.getElementById('upload').addEventListener('change', function(e) {
  const fileList = e.target.files;
  // 必须首选校验是否存在有效文件
  if (!fileList || fileList.length === 0) {
    console.log('用户取消了文件选择');
    return;
  }
  const file = fileList[0];
  // 继续执行读取
});
五、超大文件直接读入:主线程卡死与页面无响应
当用户选择几百兆甚至数吉字节(GB)的日志、视频或大型数据集时,使用 readAsText() 或 readAsArrayBuffer() 一次性读取整份文件,往往会导致浏览器弹出“页面无响应(Page Unresponsive)”甚至整个标签页崩溃。
核心原因:FileReader 会尝试将全部数据解码并加载到 V8 引擎堆内存中。超大字符串创建与频繁的内存垃圾回收会完全耗尽主线程算力,造成浏览器渲染管线冻结。
解决方案:分块(Chunking)切片读取。利用 Blob.prototype.slice() 对文件进行分块,按需逐块读取:
async function readFileInChunks(file, chunkSize = 2 * 1024 * 1024) { // 每次读取 2MB
  let offset = 0;
  const totalSize = file.size;

  while (offset < totalSize) {
    const chunk = file.slice(offset, offset + chunkSize);
    const textChunk = await chunk.text();

    // 处理当前块数据(如解析分行、计算哈希或流式上传)
    console.log(`已读取进度: ${Math.min(100, ((offset + chunk.size) / totalSize * 100).toFixed(1))}%`);

    offset += chunkSize;
    // 让出主线程微任务,避免 UI 假死
    await new Promise(r => setTimeout(r, 0));
  }
  console.log('大文件全部分块处理完毕');
}
六、运行环境与宿主 API 混淆
部分开发者在使用构建工具(如 Vite、Webpack)或 SSR 框架(如 Next.js、Nuxt)时,容易混淆 Node.js 与浏览器端的文件读取 API:
- 在前端代码中书写
const fs = require('fs')或import fs from 'fs',导致运行时报错ReferenceError: fs is not defined或构建打包错误。浏览器端没有 Node.js 的本地文件系统访问模块。 - 在 Node.js 服务端脚本中试图使用
new FileReader()或document.getElementById(),报错FileReader is not defined。
判断准则:服务端(Node.js)使用 fs/promises 按路径读写;客户端(浏览器)严格依赖 DOM File / Blob API,并通过用户交互触发。
七、故障排查与应对方案总结
综上所述,JS 读取本地文件异常的根源可以收敛为四个主要方面:安全隔离机制、异步生命周期、边界空值校验以及内存性能管理。
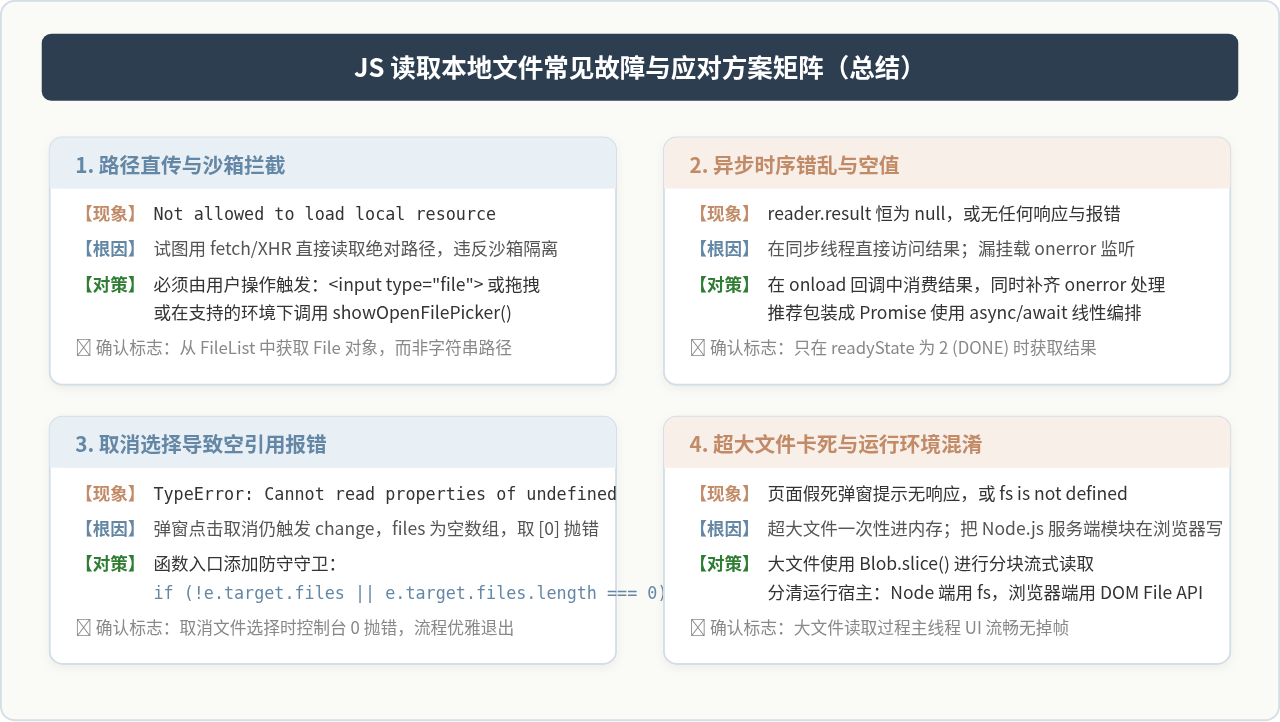
在日常开发中,建议牢记以下防范准则:始终通过 <input type="file">、拖拽或 showOpenFilePicker 获取合规 File 对象;在事件回调第一行校验 files.length > 0;优先使用基于 Promise 的 file.text() 或确保 onerror 事件完整挂载;对超过 50MB 的大文件坚决采用 file.slice() 分片处理。遵循这一套规范,即可彻底避免文件读取过程中的报错与无响应问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章