

深入讲解前端在提交包含空格的数据时,JavaScript如何正确进行转义与编码。解析%20与+号的规范差异、不同提交场景下的处理方案,并提供规范的前端代码实践与排查指南。
前端提交数据时JS怎么正确转义空格避免后端解析错误
作者:岩茶
时间:2026-11-02
浏览:204
文章目录
分类:Web开发 / 接口交互
关键词:URL编码 / 数据提交 / HTTP协议
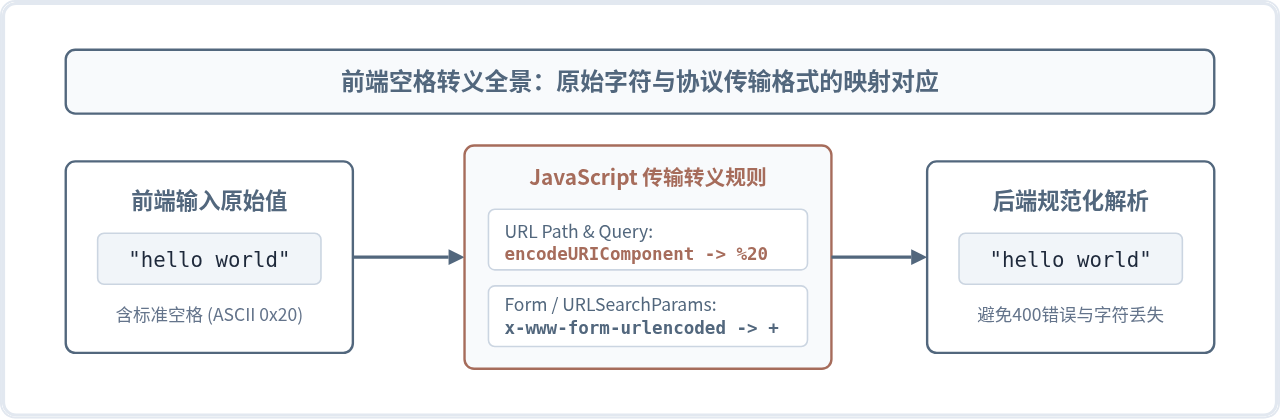
前端向后端提交带有空格的数据时,直接字符串拼接会导致请求抛出 400 Bad Request,或者导致空格被吞掉、甚至误将真实加号解析为空格。核心解决方案在于:针对 URL 查询参数或 RESTful 路径段,必须使用
encodeURIComponent() 将空格转义为标准的 %20;针对表单类参数,优先使用 URLSearchParams 进行规范序列化;而针对 POST 接口的 JSON 载荷,直接依赖 JSON.stringify() 即可,切忌多余转义。
一、为什么空格在数据提交中如此容易报错?
在日常开发中,输入框中的空格似乎只是一个最普通的字符。但在 HTTP 传输层面上,空格(ASCII 码 32,十六进制 0x20)是 URI 语法(RFC 3986)中的非法字符。如果前端发起 GET 请求时,直接用字符串模板将变量拼进 URL:
// 错误示范:直接拼接包含空格的参数
const keyword = "MacBook Pro";
fetch(`/api/search?q=${keyword}`);
// 实际发出的请求目标: /api/search?q=MacBook Pro
当网关或应用服务器(如 Nginx、Tomcat、Node.js 内部的 HTTP Parser)解析请求行时,HTTP 协议本身就是使用空格来分隔“请求方法”、“请求路径”与“协议版本”的(例如 GET /index.html HTTP/1.1)。一旦请求路径中直接出现了未编码的裸空格,服务器的解析器就会因无法准确切分协议字段而立即中断连接,返回 400 Invalid character in request target。
注意:虽然现代浏览器在调用
fetch 或 window.location 时,内部可能会尝试对请求 URL 执行一次宽容度较高的自动纠错,但不同运行环境(如 Node 端请求、小程序、WebView、旧版客户端)以及反向代理的拦截规则差异极大。依赖运行环境“兜底补丁”是产生线上偶发故障的主要根源。
二、核心机制:%20 与 + 号的前后端解析分歧
空格转义引发后端解析错误的第二个高发区,是 %20 与 + 的语义歧义。很多开发者在联调时会发现:为什么明明前端传了 +,后端取出来却变成了空格?或者前端传了空格,后端却解析成了字面量加号?
这源于历史上两套并行的标准规范:
- RFC 3986(通用 URI 语法规范):空格必须被百分号编码为
%20。在该规范中,加号+是一个保留字符(Reserved Character),它的字面含义就是纯粹的加号。在 URL 的 Path(路径)部分,空格必须且只能使用%20,使用+会被直接当做加号字符处理。 - W3C application/x-www-form-urlencoded(表单规范):在传统的 HTML 表单提交中,为了人类可读性与历史兼容性,表单键值对中的空格被特意规定编码为
+,而真正的加号则被编码为%2B。
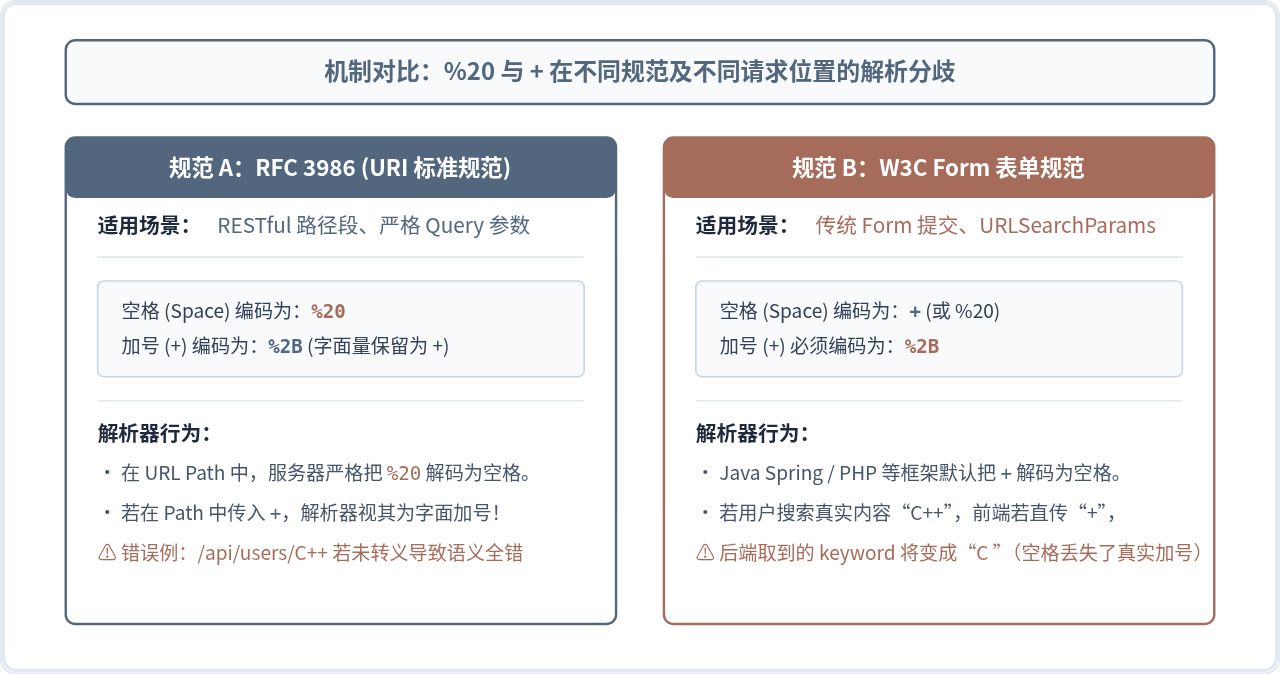
主流后端框架(如 Java Servlet 的 request.getParameter()、PHP 的 $_GET、Python Django/Flask、Node.js 的 querystring)在解析 URL Query 字符串时,默认都会将 + 视为空格还原!因此,如果在前端没有将用户输入的加号编码为 %2B,后端就会把它误认为空格;反过来,如果前端将空格转为了 +,而当前位置是 URL Path,后端又不会将其视为空格。
三、JavaScript 常见编码 API 的能力与适用边界
JavaScript 语言提供了多个内置函数与对象用于处理编码,很多开发者容易混淆 escape、encodeURI、encodeURIComponent 以及现代的 URLSearchParams。
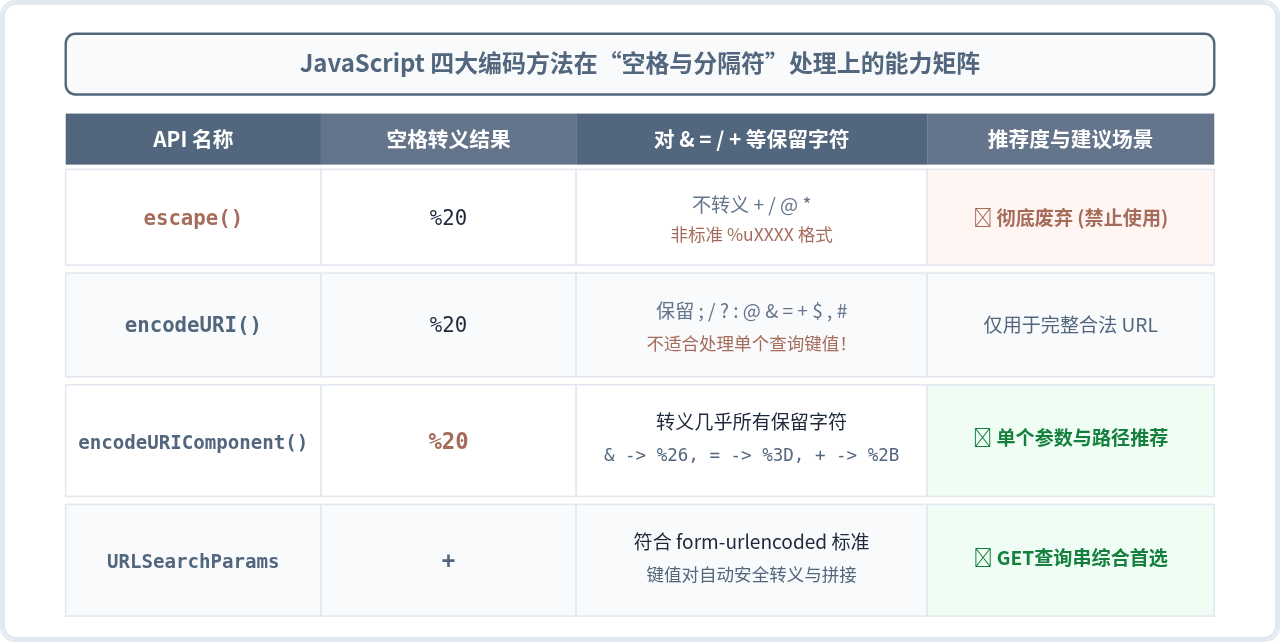
通过对比可以清晰地看出:绝不能使用 encodeURI 来转义查询参数值。如果用户输入的搜索内容是 A & B + C,encodeURI 不会对 &、= 和 + 转义,导致参数结构本身被拆毁,后端解析完全错位。
四、操作步骤:前端安全转义与提交的标准化流程
在实际工程开发中,要彻底杜绝空格引发的解析错误,建议严格按照以下 5 个步骤组织数据:
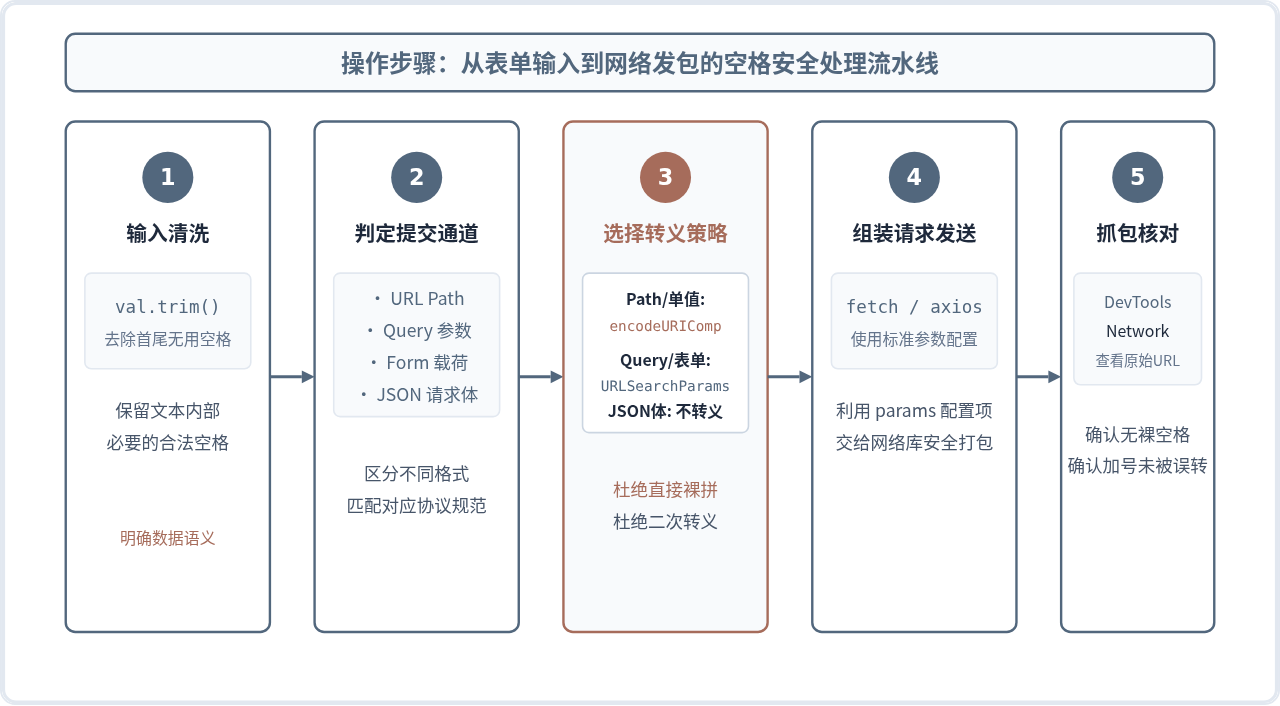
1. 针对 URL 查询参数(Query String):推荐使用 URLSearchParams
对于现代浏览器与 Node.js 10+ 环境,最优雅、稳妥的方式是使用标准的 URLSearchParams API。它会自动为键和值处理所有非法字符,将空格按照规范转为 +,并将真实的加号转为 %2B:
// 推荐方案:使用 URLSearchParams 处理 GET 参数
const params = new URLSearchParams({
  keyword: "深入 理解 JavaScript",
  tag: "C++", // 真实的加号会被转为 %2B,避免被后端误认为空格
  page: 1
});

const url = `/api/articles?${params.toString()}`;
// 生成结果: /api/articles?keyword=%E6%B7%B1%E5%85%A5+%E7%90%86%E8%A7%A3+JavaScript&tag=C%2B%2B&page=1

fetch(url)
  .then(res => res.json())
  .then(data => console.log(data));
特殊边界提示:某些网关(如极个别老旧的微服务网关、或者某些配置了严格正则校验的微服务)可能只认
%20 而不认 +。如果你必须在 Query 参数中使用 %20,可以通过简单的正则将 + 统一规整:
const safeQuery = params.toString().replace(/\+/g, '%20');
2. 针对 RESTful 动态路径段(Path Segment):必须使用 encodeURIComponent
当参数不是作为问号后面的 Query 传递,而是作为 URL 路径的一部分(例如 /api/users/{username}/profile)时,千万不能使用 URLSearchParams,也不能直接拼接变量:
// 错误示范:/api/files/my document.pdf (导致 Nginx 400 报错)
// 错误示范:/api/files/my+document.pdf (后端将文件名识别为含加号,找不到原文件)

// 正确方案:使用 encodeURIComponent 对路径段单独编码
const fileName = "my report 2026.pdf";
const safePath = `/api/files/${encodeURIComponent(fileName)}`;
// 最终请求路径: /api/files/my%20report%202026.pdf

fetch(safePath);
3. 针对 POST 请求体中的数据提交
对于 POST 请求,空格的处理完全取决于 Content-Type:
-
application/json(现代主流): 在 JSON 格式中,字符串内部的空格完全合法,无需转换为%20或+。前端只需要通过JSON.stringify()序列化对象即可。很多新手在此处画蛇添足地手动执行encodeURIComponent,导致后端数据库存入了一堆%20,增加了解码负担。// 正确做法:直接交给 JSON.stringify,空格保持原样 const payload = { address: "742 Evergreen Terrace", remark: "Room 101" }; fetch('/api/user', { method: 'POST', headers: { 'Content-Type': 'application/json' }, body: JSON.stringify(payload) }); -
application/x-www-form-urlencoded: 如果接口要求表单格式,直接将URLSearchParams实例作为 body 传递,浏览器会自动设置正确的请求头并安全编码空格:const formData = new URLSearchParams(); formData.append('title', 'Designing Data-Intensive Applications'); fetch('/api/books', { method: 'POST', body: formData // 浏览器会自动填充 Content-Type 并编码空格为 + });
五、常见问题排查与避坑决策
为了在开发与代码审查中快速定位问题,我们将高频出现的转义失误及应对场景总结为全景决策图:
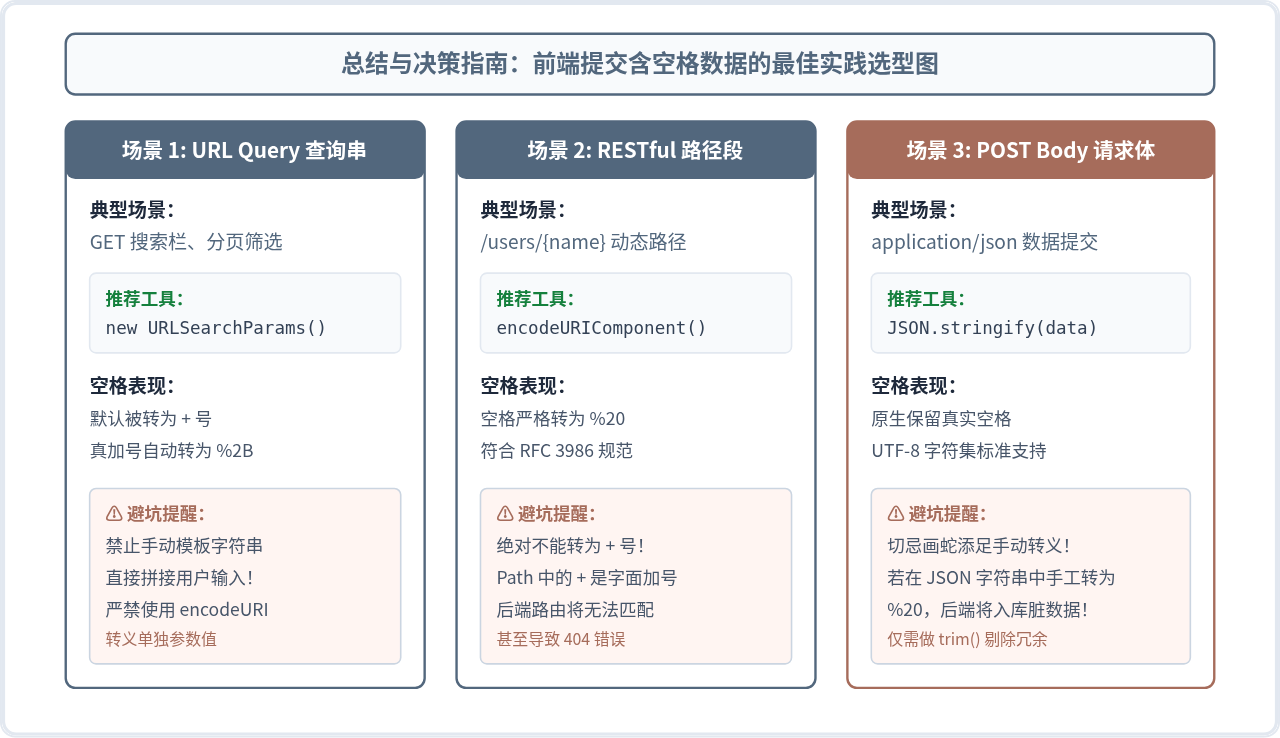
排查后端解析异常的检查清单
-
排查是否发生了“二次转义”(Double Encoding):
如果前端对已经用
encodeURIComponent转义过的参数再次执行了编码,%20中的%会被二次转义为%25,最终发送给后端的是%2520。后端初次解析后得到的是字符串"%20"而不是真正的空格。在 Network 面板中检查“Request URL”,如果看到连续的%25,即可断定存在重复调用。 -
排查 Axios / Fetch 的参数配置项:
在使用
axios.get(url, { params: { q: 'hello world' } })时,Axios 会使用默认的paramsSerializer自动转义。如果项目全局配置了自定义的序列化插件,务必检查是否覆盖了空格编码逻辑。 -
全角空格与特殊空白符排查:
除了标准空格(U+0020),用户从文档复制文本时可能引入“不换行空格”(
/ U+00A0)或全角中文空格(U+3000)。这些字符被转义后的字节序列与普通空格不同(例如 U+00A0 转为%C2%A0)。如果业务只允许普通空格,应在前端提交流水线的第一步使用正则value.replace(/\u00A0/g, ' ')进行统一规整。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章