
详细讲解在 JavaScript 中使用 charAt(0) 与 slice(1) 组合实现字符串首字母大写的经典写法,深入解析 charAt 与方括号访问的安全差异、slice 截取机制以及生产级函数封装与边界处理。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串首字母大写:charAt与slice组合写法
作者:闭包旅人
时间:2026-11-02
浏览:127
文章目录
JavaScript 字符串处理
实用代码技巧
类别:前端基础教程 | 运行环境:浏览器 / Node.js | 推荐指数:★★★★★
一、核心答案与一秒上手的标准写法
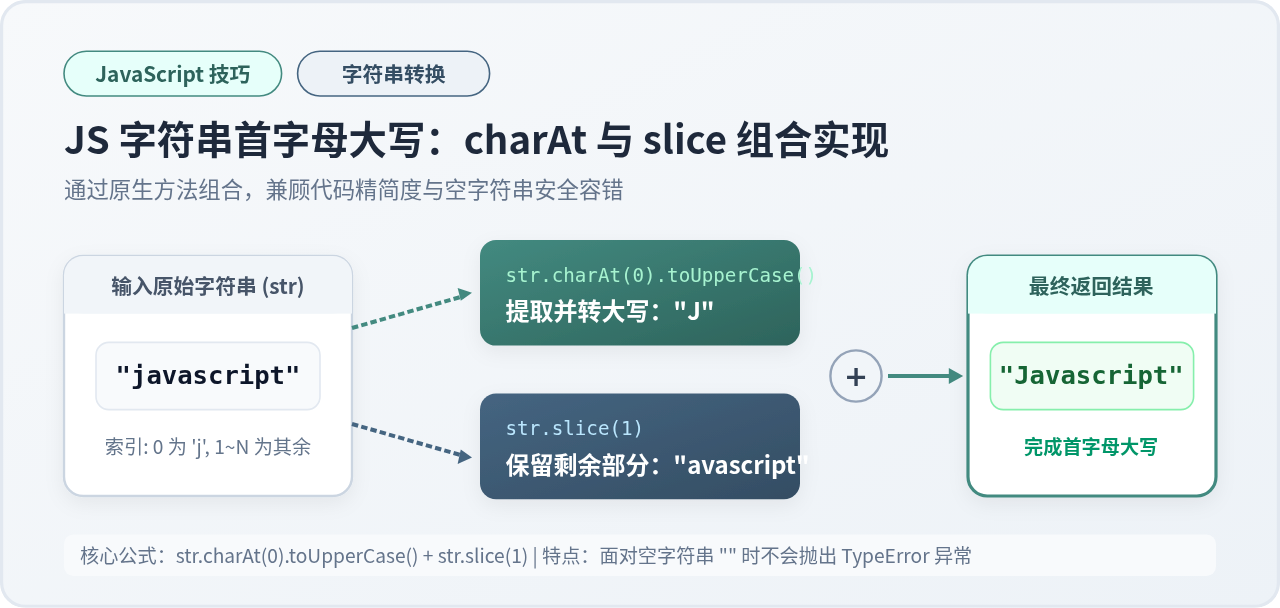
在 JavaScript 中将字符串的第一个字母转换为大写,最经典、稳健且执行效率极高的方式是结合使用 charAt(0) 和 slice(1)。这一写法无需加载第三方工具库,也不依赖复杂的正则表达式,仅使用原生 API 即可平稳完成需求。
核心表达式如下所示:
// 核心表达式
const result = str.charAt(0).toUpperCase() + str.slice(1);
例如,当输入变量为 "javascript" 时,运算过程会将其拆分为大写的 "J" 与截取后的余部 "avascript",再通过加号拼接为 "Javascript"。这套组合不仅代码精简易读,更关键的价值在于它对空字符串具备极佳的天然容错能力,不会轻易因访问非法索引而引发程序崩溃。
二、执行步骤详解:四个阶段的具体推导
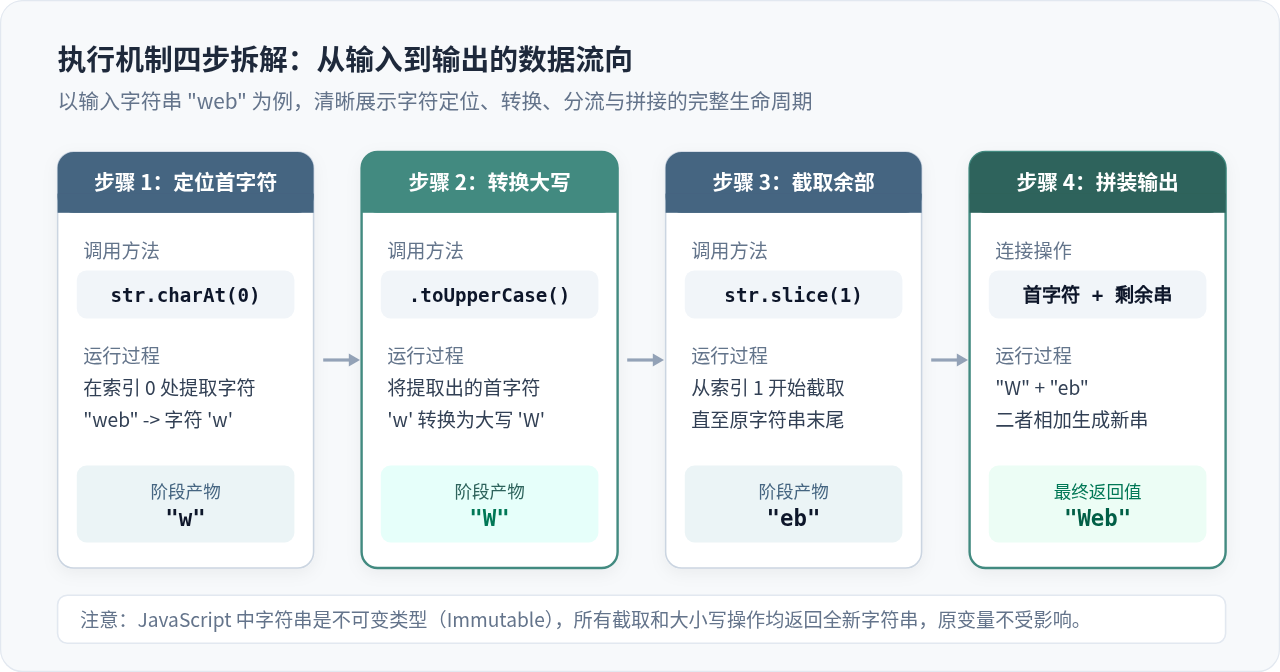
为了让读者彻底掌握这段代码的底层运行过程,我们将 str.charAt(0).toUpperCase() + str.slice(1) 拆解为四个具体步骤:
- 提取索引 0 处的首个字符(
str.charAt(0)):从目标字符串中读取位于位置 0 的字符单元。如果字符串本身为空"",该方法不会报错,而是安全返回一个空字符串""。 - 转换为大写形式(
.toUpperCase()):对提取出的单字符调用原生大写转换方法。如果是英文字母,便转为对应的大写形态;若是非字母符号或空字符串,则保持原样输出。 - 截取剩余字符串(
str.slice(1)):从索引 1 开始一直截取到字符串末尾,完整保留从第二个字符开始的全部内容。如果原字符串长度仅为 1 或 0,slice(1)会平稳返回空字符串""。 - 字符串拼装整合(
+):使用加号运算符将转为大写的首字符与截取得到的剩余子串合并,生成并返回一个全新的字符串对象。
不可变性(Immutability)提醒
在 JavaScript 中,String 是原始值类型,字符串的内部字符是只读的,任何原生方法都无法直接原地修改字符串本身。无论是 charAt、toUpperCase 还是 slice,均是在内存中创建并返回一个新的字符串,原本传入的变量值始终不会受到任何破坏。
三、深度剖析:为什么选择 charAt(0) 而非 str[0]?
许多习惯现代 ES6+ 语法的开发者常会提出疑问:现代 JavaScript 支持像数组那样直接使用方括号读取字符(例如 str[0]),为什么资深工程师和主流规范依然极力推崇使用 charAt(0)?
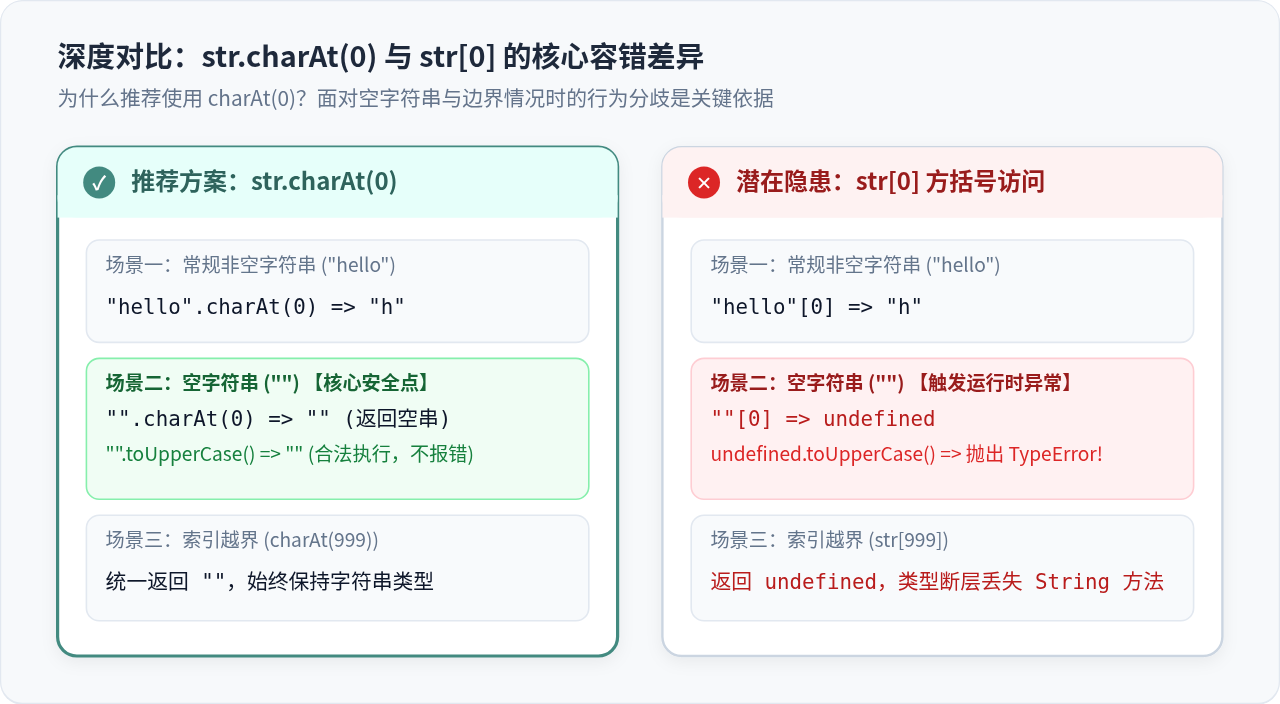
答案的核心在于:面对空字符串 "" 或索引越界时的容错表现截然不同。
1. 运行时崩溃风险对比
观察以下两组代码在遇到空字符串时的执行结果:
// 方案 A:使用 charAt(0) —— 稳健安全
const emptyStr = "";
const safeResult = emptyStr.charAt(0).toUpperCase() + emptyStr.slice(1);
console.log(safeResult); // 顺利输出空字符串 "",没有报错!

// 方案 B:使用 str[0] —— 抛出致命异常
const dangerResult = emptyStr[0].toUpperCase() + emptyStr.slice(1);
// Uncaught TypeError: Cannot read properties of undefined (reading 'toUpperCase')
当 str 为 "" 时:
"".charAt(0)严格遵循 ECMAScript 规范,返回空字符串""。对空字符串继续调用"".toUpperCase()依然返回"",随后"" + "".slice(1)完美计算出""。整个链条严丝合缝,无任何报错中断。""[0]属于属性访问,当索引超出范围时,JavaScript 引擎会返回undefined。对undefined调用任何方法都会直接触发TypeError,导致整个前端页面脚本报错中断或 Node.js 服务进程崩溃。
| 特性 / 场景 | str.charAt(0) | str[0](属性访问) |
|---|---|---|
| 正常非空字符(如 "hello") | 返回 "h" | 返回 "h" |
| 空字符串 "" | 返回 "" (空字符串) | 返回 undefined |
| 索引越界(如 index = 999) | 返回 "" (类型始终为 string) | 返回 undefined (类型断层) |
| 空串直接链式调用 .toUpperCase() | 安全,返回 "" | 抛出 TypeError 崩溃 |
| ECMAScript 规范标准 | 自 ES1 即存在,全兼容 | ES5 引入的标准语法糖 |
四、slice(1) 的工作机制与截取逻辑
在组合的后半部分,我们使用 str.slice(1) 来获取剩余的字符。理解这一步的关键在于搞清 slice 的参数与边界行为:
- 起始索引参数:
slice(start, end)接受起始与结束位置。当仅传入一个参数1时,代表从索引 1 开始提取,直至字符串的最末尾。 - 长度不足时的自动收敛:若字符串长度为 0 或 1,截取起点
1已经超出或等于字符串的长度上限。此时slice(1)并不会产生异常,而是自动返回一个合法的空字符串""。 - 为什么优先选用 slice 而不是 substring 或 substr?
substr已经被 ECMAScript 官方列入遗留废弃(Deprecated)特性列表,不应在现代代码中继续使用。substring虽然功能相似,但其参数处理机制较为复杂(例如如果参数为负数会自动转为 0,若起点大于终点会自动交换参数位置)。slice语义清晰明确,不仅与Array.prototype.slice保持高度一致的 API 直觉,且支持负数索引,是现代 JavaScript 字符串截取的统一首选标准。
五、封装健壮的生产级工具函数
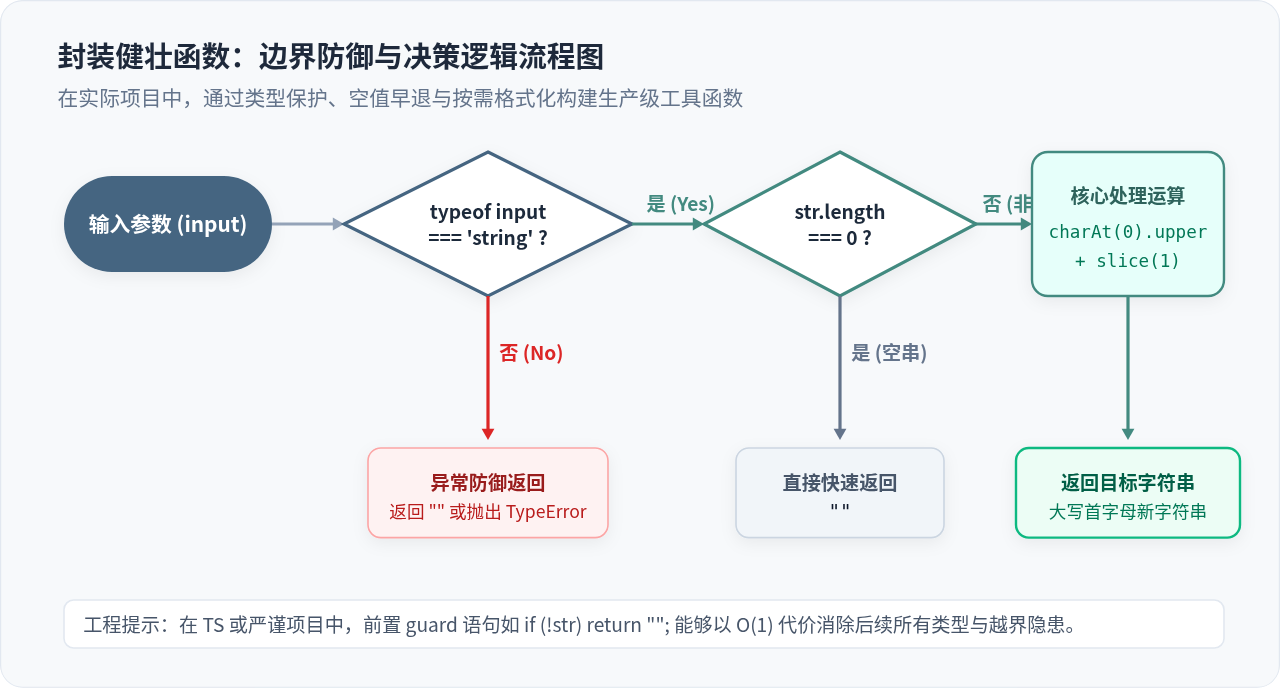
虽然单行表达式非常简洁,但在实际工程业务中,传入的数据来源往往参差不齐(可能混杂 null、undefined 或数值类型)。为了让函数在各种复杂环境中稳定运行,推荐封装一个带有前置类型守卫的工具函数:
/**
 * 将输入字符串的首字母转换为大写
 * @param {unknown} str - 待处理的原始数据
 * @param {boolean} [lowerRest=false] - 是否强制将其余字符转为小写
 * @returns {string} 转换后的字符串
 */
function capitalize(str, lowerRest = false) {
  // 1. 防御性检查:非字符串或空值处理
  if (typeof str !== 'string' || str.length === 0) {
    return '';
  }

  // 2. 提取并转换首字母
  const firstChar = str.charAt(0).toUpperCase();

  // 3. 按需决定剩余字符是保留原样还是强制小写
  const restChars = lowerRest ? str.slice(1).toLowerCase() : str.slice(1);

  return firstChar + restChars;
}
实际测试验证
我们用该函数执行各种常规及极端边界测试,观察实际输出:
// 常规英文单词
console.log(capitalize("hello"));             // 结果: "Hello"

// 单个字母
console.log(capitalize("a"));                 // 结果: "A"

// 空字符串(边界场景)
console.log(capitalize(""));                  // 结果: ""

// 首字符已是大写
console.log(capitalize("Apple"));             // 结果: "Apple"

// 全大写单词,选择保留原样
console.log(capitalize("NASA"));              // 结果: "NASA"

// 全大写单词,启用 lowerRest 强制格式化
console.log(capitalize("NASA", true));        // 结果: "Nasa"

// 容错处理:传入非字符串类型
console.log(capitalize(null));                // 结果: ""
console.log(capitalize(undefined));           // 结果: ""
console.log(capitalize(12345));               // 结果: ""
六、拓展思考:句子首字母大写与 Unicode 代理对
掌握了单个单词的基础写法之后,在实际开发中我们还会遇到两类常见的延伸场景:
1. 整个句子每个单词首字母大写(Title Case)
如果需求是让一个英文句子里的所有单词首字母都大写,可以先用空格 split(" ") 分词,配合数组的 map 遍历调用前文的函数,最后通过 join(" ") 组装:
function titleCaseSentence(sentence) {
  if (!sentence) return '';
  return sentence
    .split(' ')
    .map(word => word.charAt(0).toUpperCase() + word.slice(1))
    .join(' ');
}

console.log(titleCaseSentence("the quick brown fox"));
// 输出: "The Quick Brown Fox"
2. 包含 Emoji 或特殊 Unicode 字符的情况
charAt(0) 和 slice(1) 是基于 16 位 UTF-16 代码单元(Code Unit)工作的。对于处于基本多语言平面(BMP)之外的复杂字符(如某些 Emoji "👋" 或古代罕见汉字),它们由 2 个代理对(Surrogate Pair)代码单元组成:
高级字符集提示
如果你的字符串首字符可能包含 4 字节的 Emoji 或特殊 Unicode 字符,str.charAt(0) 只会截取高位代理单元。处理这类超大字符集时,可以使用 ES6 的扩展运算符 [...str] 或 Array.from(str) 配合 codePointAt 来按码点分割。不过在绝大多数 Web 开发日常场景中,首字母均为标准英文字母,charAt(0) + slice(1) 的性能与简洁度依然是无出其右的黄金选择。
七、全篇总结与速查卡片
通过本文的全面梳理,我们可以总结出 charAt 与 slice 组合写法的几大核心精髓:
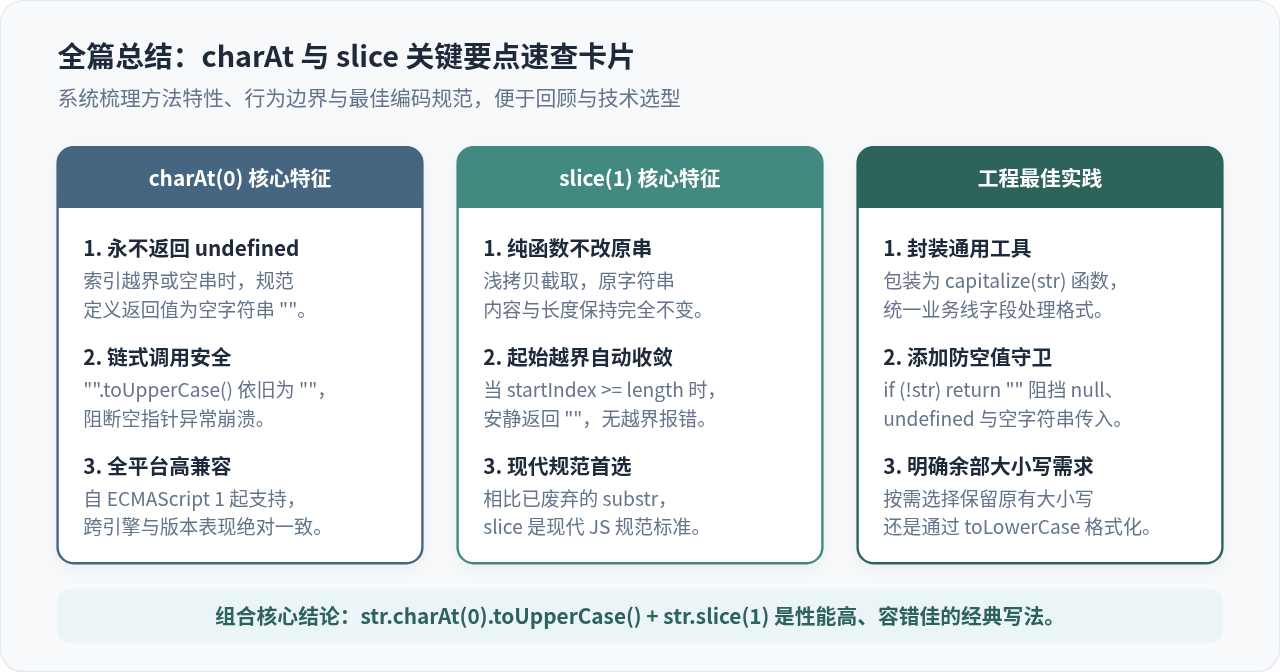
- 牢记标准核心公式:
str.charAt(0).toUpperCase() + str.slice(1)。 - 胜在安全无报错:相较于
str[0]遇空引发的崩溃隐患,charAt(0)在遇到空串时返回"",支持后续安全的链式转换。 - 现代语义规范:
slice(1)支持参数边界自动收敛,是替代已被废弃的substr的现代标准方式。 - 封装原则:在团队公共库或复杂业务场景中,加入
typeof str !== 'string'的防御性检查,能构建出健壮抗风险的生产级函数。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章