
详细讲解在 JavaScript 中如何将任意长度的字符串按固定长度均匀切割成数组。涵盖 for 循环切片、正则表达式 match、函数式 Array.from 等多种实现方法,分析末尾余数、空字符串与 Emoji 多字节字符的处理方案及性能选型。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript怎么将长字符串按固定长度切割成数组
作者:闭包旅人
时间:2026-10-30
浏览:613
文章目录
在 JavaScript 中,将长字符串按固定长度均匀拆分成数组的核心思路分为两类:最稳健且性能最高的方式是使用
for 循环配合 String.prototype.slice() 沿步长依次切片;追求单行简洁的代码则可以使用正则表达式 match(new RegExp(`.[\\s\\S]{1,${size}}`, 'g')) 或 match(new RegExp(`.{1,${size}}`, 'gs'))。本文将具体介绍这两种主流方案的实现代码、末尾余量处理机制、边界防御以及包含 Emoji 特殊字符时的安全切分策略。
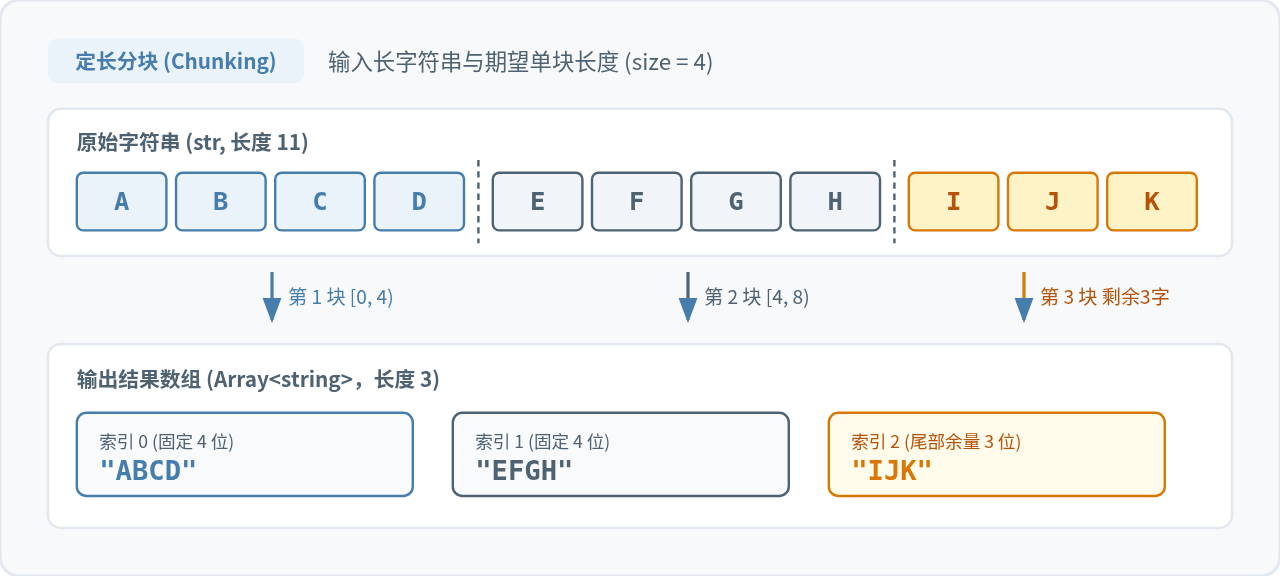
方法一:for 循环配合 slice() 步长截取(推荐方案)
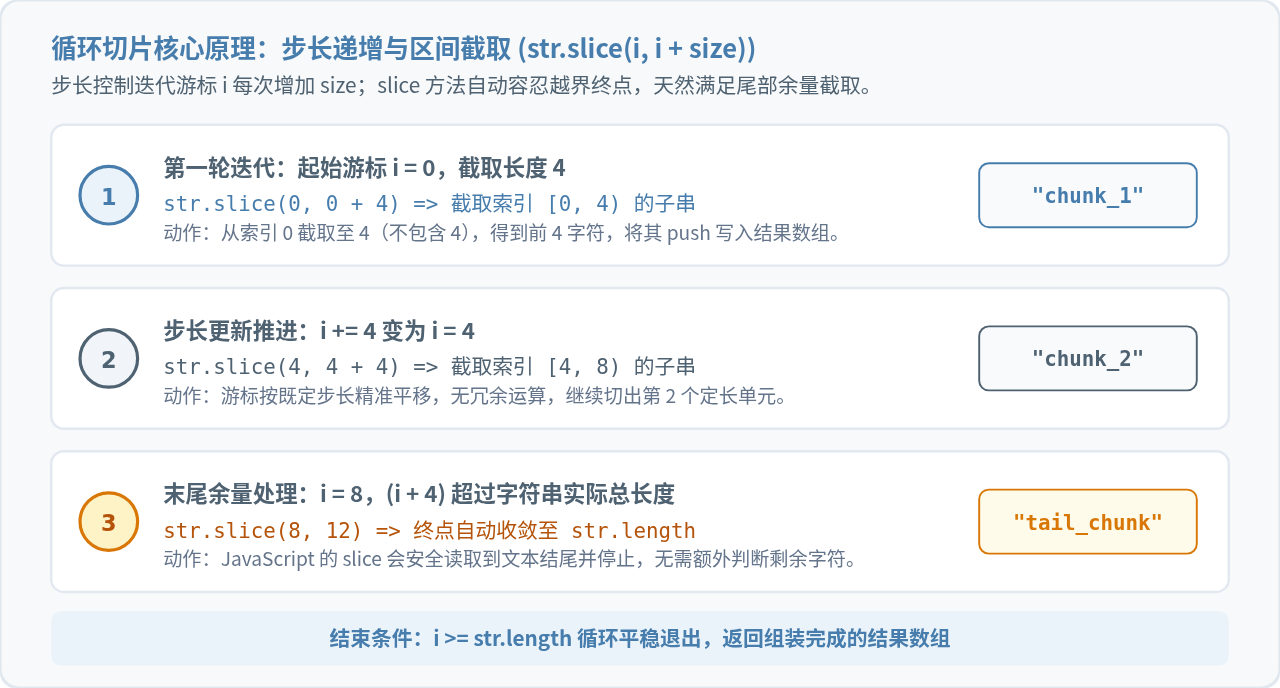
使用传统的 for 循环结合 slice(start, end) 是实际工程中最通用、性能最优的做法。我们以固定长度 size 为步长递增循环变量 i,每次从 i 截取到 i + size,并将结果依次压入结果数组中。
function chunkStringBySlice(str, size) {
  if (!str || size <= 0) return [];
  const chunks = [];
  for (let i = 0; i < str.length; i += size) {
    chunks.push(str.slice(i, i + size));
  }
  return chunks;
}

// 示例调用
const text = "ABCDEFGHIJK";
const result = chunkStringBySlice(text, 4);
console.log(result);
示例输出:
["ABCD", "EFGH", "IJK"]
这段代码有两个关键细节值得注意:
- 末尾余量自动容忍:当字符串总长度无法被
size整除时(如上例总长 11,步长 4,最后一轮i = 8,计算出i + size = 12),slice()遇到超出字符串长度的终点索引会自动收敛到字符串末尾,安全切出仅剩的"IJK",不会报错也不会填充undefined。 - 零额外计算开销:循环内部直接按索引切片,不依赖正则表达式解析引擎,在大文本或高频调用场景下能够提供最佳的执行速度。
方法二:使用正则表达式 match() 单行切割
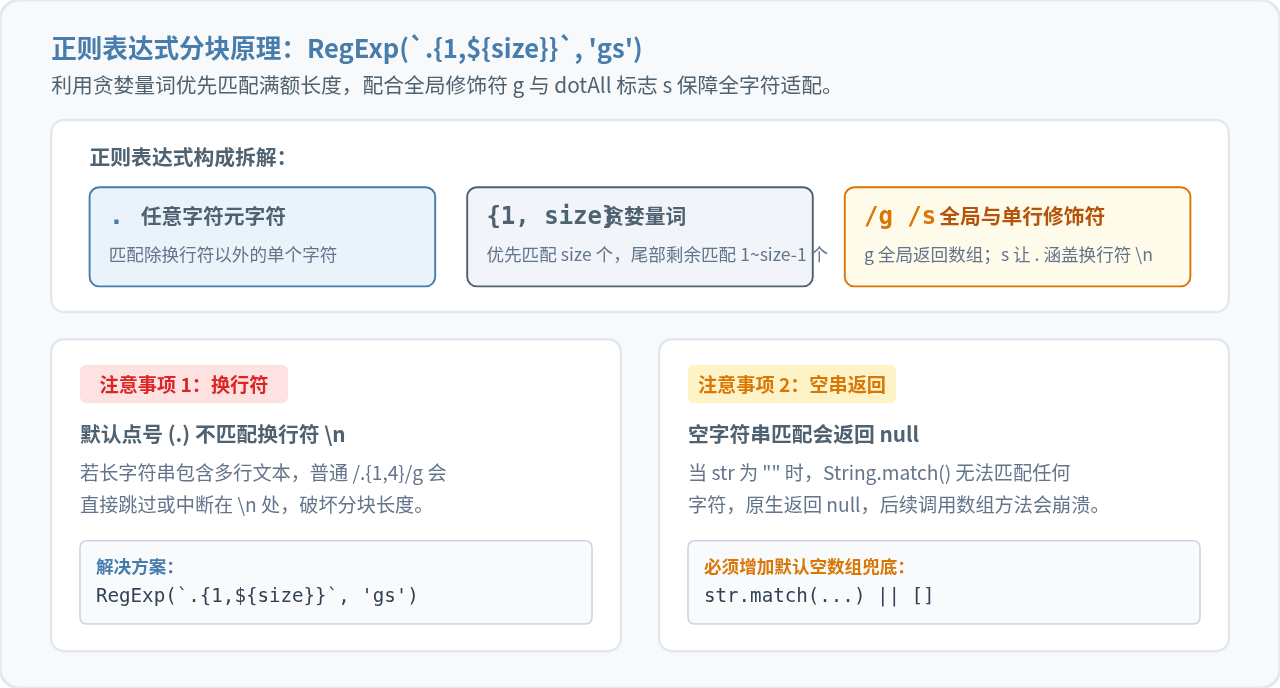
如果你希望用更简练的单行代码完成任务,可以使用 String.prototype.match()。通过动态构造一个包含贪婪量词 {1,size} 和全局标志 g 的正则表达式,正则引擎会依次匹配出符合长度的子串并直接封装为数组返回。
function chunkStringByRegex(str, size) {
  if (!str || size <= 0) return [];
  // 使用 'gs' 修饰符:'g' 代表全局匹配,'s' (dotAll) 允许点号匹配包括换行符在内的所有字符
  const regex = new RegExp(`.{1,${size}}`, 'gs');
  return str.match(regex) || [];
}

// 示例调用
const logData = "line1\nline2\nline3";
const chunks = chunkStringByRegex(logData, 5);
console.log(chunks);
示例输出:
["line1", "\nline", "2\nlin", "e3"]
使用正则表达式时,有两个容易被忽视的隐患必须处理:
- 换行符匹配隐患(dotAll 模式):在默认情况下,正则表达式中的元字符
.并不匹配换行符\n或\r。如果待处理的长文本中包含换行,未加s标志的正则表达式会被换行符打断,导致切片丢失字符。若运行环境较老不支持s标志,可以将表达式改写为new RegExp(`[\\s\\S]{1,${size}}`, 'g')。 - 空字符串返回 null 陷阱:当输入字符串为空
""时,match()无法匹配到任何符合{1, size}的字符,其原生返回值为null而非空数组。因此必须在末尾追加|| [],确保函数调用者始终获得数组类型。
方法三:Array.from() 函数式一行构造
在追求无局部变量突变的函数式编程风格中,还可以借助 Array.from() 初始化指定长度的数组,再在映射函数中计算每个分块的起止索引:
function chunkStringFunctional(str, size) {
  if (!str || size <= 0) return [];
  const chunkCount = Math.ceil(str.length / size);
  return Array.from({ length: chunkCount }, (_, index) =>
    str.slice(index * size, (index + 1) * size)
  );
}

// 示例调用
const orderId = "20261030998877";
console.log(chunkStringFunctional(orderId, 4));
示例输出:
["2026", "1030", "9988", "77"]
这种写法的核心在于 Math.ceil(str.length / size),它通过向上取整精确计算出所需分块的总数量,随后由 Array.from 的映射回调完成切片。它兼具声明式代码的清晰与 slice 的高效。
进阶注意事项:Unicode 与 Emoji 多字节字符的处理
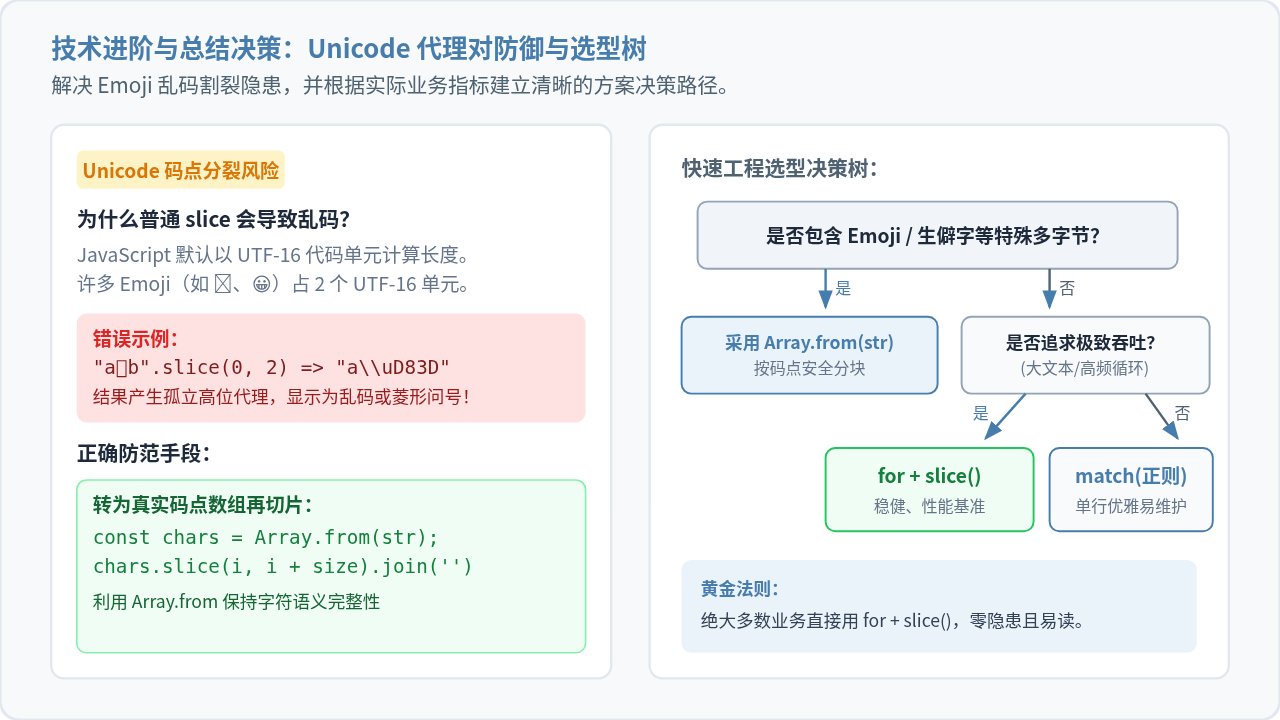
在日常开发中,处理英文字母、数字和常规汉字时,前述方法均能稳定工作。但如果长字符串中包含 Emoji 表情(如 🚀、😀)或特殊数学符号,由于 JavaScript 的字符串长度 length 是基于 UTF-16 代码单元(Code Units)计算的,这些字符在底层由两个代码单元(代理对,Surrogate Pairs)组成,其 length 为 2。
风险警示:如果直接使用基于字符索引的
str.slice(),当切割点恰好落在代理对的两个代码单元之间时,一个原本完整的 Emoji 会被强行劈开,导致前后两个分块中均出现无法识别的乱码字符(形如孤立代理对 \uD83D 或 )。
若业务场景涉及用户输入的昵称、社交聊天记录等包含 Emoji 的长文本,应先使用支持 Unicode 码点(Code Point)的解构方式将字符串转化为真实字符数组,再进行定长组合:
function chunkUnicodeString(str, size) {
  if (!str || size <= 0) return [];
  // Array.from(str) 或 [...str] 会按 Unicode 码点正确拆分 Emoji
  const codePoints = Array.from(str);
  const chunks = [];
  for (let i = 0; i < codePoints.length; i += size) {
    chunks.push(codePoints.slice(i, i + size).join(''));
  }
  return chunks;
}

// 示例调用
const mixedText = "Hi🚀你好世界🎉";
console.log(chunkUnicodeString(mixedText, 3));
示例输出:
["Hi🚀", "你好世", "界🎉"]
常见边界条件与防御清单
在封装为生产级工具函数前,建议核查以下边界条件以确保代码健壮性:
- 步长非正数校验:如果调用方传入
size <= 0或NaN,for循环将陷入死循环,正则量词会抛出语法错误。必须在函数入口添加if (size <= 0 || !Number.isInteger(size)) return [];防御。 - 空值与空串防护:输入为
null、undefined或""时,应直接返回空数组[],避免因后续调用抛出TypeError。 - 步长大于字符串总长度:当
size >= str.length时,各实现方案均会安全返回包含原字符串本身的单元素数组[str]。
总结与选型建议
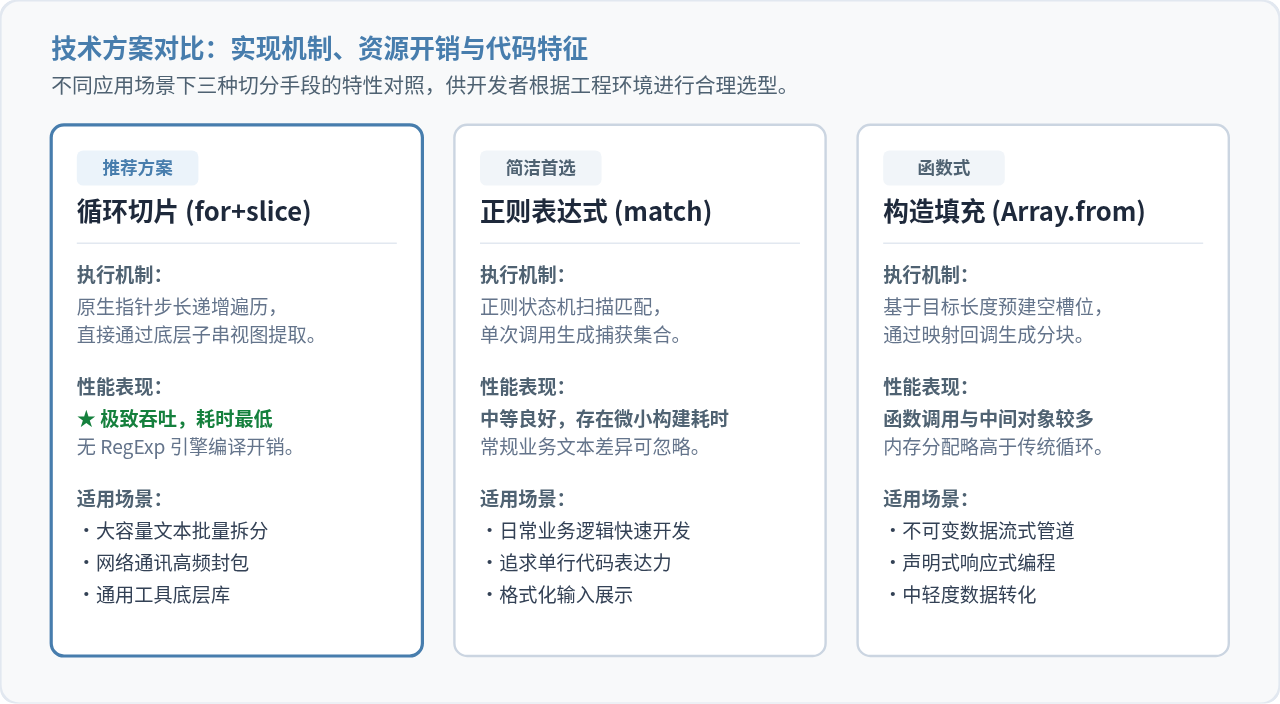
| 实现方案 | 代码行数 | 执行效率 | 特殊依赖 / 边界要求 | 推荐场景 |
|---|---|---|---|---|
| for 循环 + slice() | 约 6 行 | 最高 (无需构建额外对象) | 无特殊要求,原生支持完备 | 追求性能、通用工具库、大文本切片 |
| 正则表达式 match() | 1 行 | 良好 (存在编译与匹配开销) | 必须加 s 标志与 || [] 兜底 |
业务代码轻量开发、简单展示 |
| Array.from() 构造 | 3 行 | 中等 (多次函数调用) | 需计算 Math.ceil |
函数式管道、不可变数据编程 |
| Array.from(str) 码点切片 | 约 7 行 | 随长度增加有额外数组开销 | 内存分配较大 | 包含 Emoji、生僻字的富文本处理 |
在绝大多数日常前端与 Node.js 业务中,优先使用 for 循环 + slice() 作为基准方案。它语法意图明确、执行性能最优,并且天然安全地处理了末尾余量,是解决字符串定长切割最可靠的选择。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章