
全面解析JavaScript中字符串转数字的3种核心方法:Number()、parseInt()与parseFloat()的底层原理、语法参数、边界差异与实战选型指南。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串转数字:Number()、parseInt与parseFloat的区别及用法
作者:清欢
时间:2026-10-30
浏览:221
文章目录
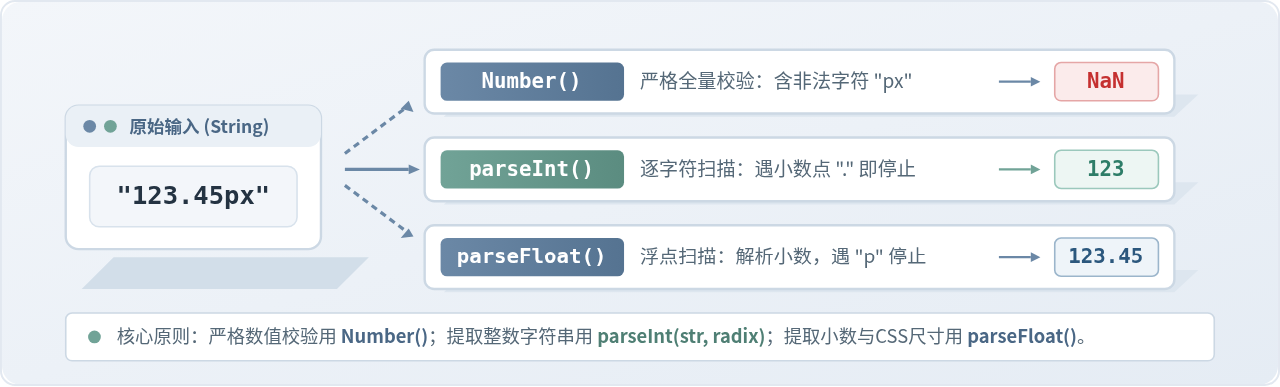
在 JavaScript 开发中,将字符串转为数字主要有三种内置方式:
Number()、parseInt() 与 parseFloat()。三者的核心区别在于:Number() 属于全量强制类型转换,要求字符串整体必须完全符合数值格式,遇到任何非法字符均返回 NaN,但空字符串会被转为 0;parseInt() 与 parseFloat() 则属于模式解析提取,从左至右扫描字符直到遇到首个不合法字符停止截断,其中 parseInt() 只提取整数并支持通过基数(radix)指定 2 到 36 进制,而 parseFloat() 专门提取十进制浮点数及科学计数法。理解这一解析机制的差异,是准确选择转换方法并避免线上边界 Bug 的关键。
一、核心机制:强制类型转换与逐字符模式解析的区别
JavaScript 在处理字符串转数字时,内部并不采用同一种逻辑。我们可以将其清晰地分为两类处理体系:
- 类型转换器(Type Conversion / Casting):以
Number(value)为代表。它的职责是把传入的值视为一个整体,严格按照 ECMAScript 规范的ToNumber抽象操作进行映射。如果字符串中混杂了非数字字符(除首尾允许的空白字符外),转换立即宣告失败并返回NaN。 - 模式解析器(Incremental Parsing):以
parseInt(string, radix)和parseFloat(string)为代表。它们最初的设计目标是从包含格式或单位的文本流中“提取”可用数字。因此它们会先跳过前导空格,随后尽可能多地向后读取符合当前数字规范的字符,遇到不能识别的字符(如字母、单位符号或第二个小数点)时不会报错,而是停下来返回已成功读取的部分。
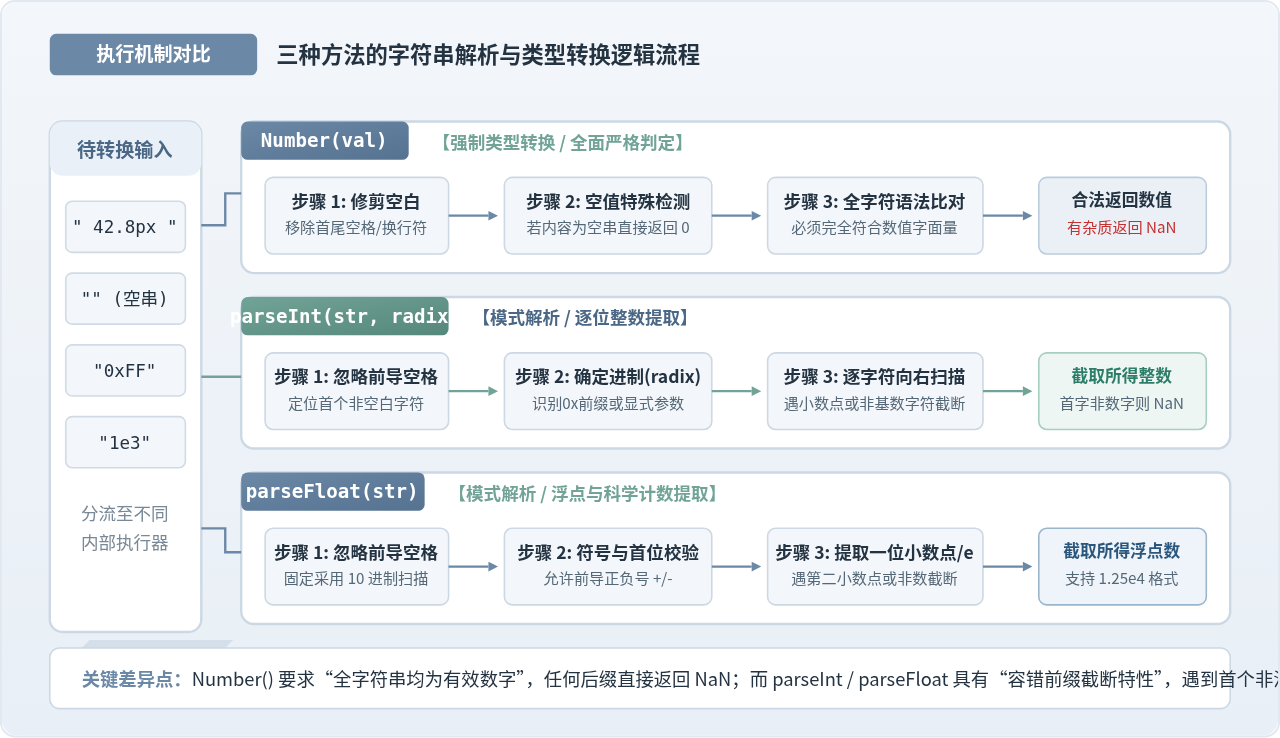
正是这种“全量严格校验”与“前缀容错提取”的定位差异,决定了它们在实际业务中的具体用法与边界表现。
二、Number() 的用法、规则与边界陷阱
Number() 是 JavaScript 的全局构造函数,当作为普通函数调用 Number(value) 时,执行强制类型转换。
1. 基本用法与常规示例
对于结构规范的标准数值字符串,Number() 能无缝保留整数或浮点精度,同时也天然支持十六进制、八进制和科学计数法字面量:
// 1. 标准数字字符串
Number("42");        // 示例输出: 42
Number("3.14159");   // 示例输出: 3.14159

// 2. 前后包含空白字符(会被自动忽略修剪)
Number("   88   ");  // 示例输出: 88

// 3. 科学计数法与常见进制
Number("2.5e3");     // 示例输出: 2500
Number("0x1f");      // 示例输出: 31 (十六进制)
Number("0b1010");    // 示例输出: 10 (二进制)
2. 常见边界与踩坑点
使用 Number() 时,必须特别警惕以下两类容易引发逻辑隐患的情况:
- 带单位文本返回 NaN:例如 CSS 像素值
"24px"或金额格式"¥100",因为包含非数字字符,Number("24px")不会像 CSS 计算那样提取 24,而是直接得到NaN。 - 空字符串与空白转为 0:
Number("")、Number(" ")以及Number(null)均会返回0。在表单校验中,如果用户未填写任何内容(输入为空字符串),直接使用Number(inputValue)会得到数字0,这极易导致系统误判用户输入了合法数值 0。
避坑建议:在处理用户表单或外部 API 输入时,如果使用 Number(),请先显式校验字符串是否为空:const num = str.trim() === "" ? NaN : Number(str);,以避免空字符隐蔽转换为 0。
三、parseInt() 的用法、基数机制与截断行为
parseInt(string, radix) 用于将输入字符串解析为指定进制的整数。它的语法签名包含两个参数:待解析字符串和转换基数。
1. 语法规范与 radix 参数
radix 是一个介于 2 到 36 之间的整数,代表待解析数字的进制基数。虽然规范允许省略该参数,但强烈建议在任何场景下都显式传入 radix。
// 显式指定基数进行转换
parseInt("10", 10);  // 十进制: 10
parseInt("10", 2);   // 二进制: 2
parseInt("10", 8);   // 八进制: 8
parseInt("10", 16);  // 十六进制: 16
parseInt("AF", 16);  // 示例输出: 175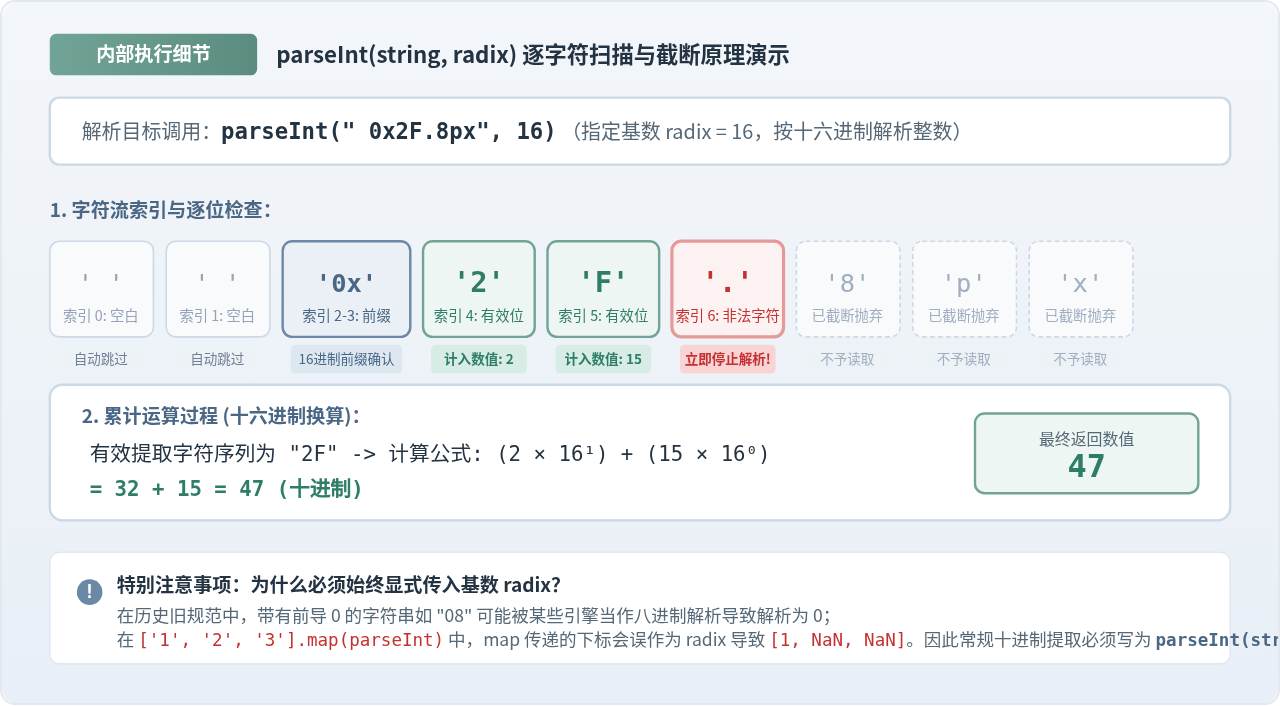
2. 逐字符扫描与截断特性
parseInt() 的解析规则如下:
- 忽略字符串开头的所有空白符;
- 检查正负号(
+或-); - 从首个有效字符开始,按照
radix所允许的字符集向右读取。一旦遇到不在该基数有效字符范围内的字符,立即停止读取,并将此前已识别的字符组合成整数返回; - 如果首个非空字符本身就不是当前基数下的合法数字,则直接返回
NaN; - 特别注意:小数点
"."不属于整数基数字符,因此parseInt()遇到小数点会直接停下,只截取整数部分,不会四舍五入。
// 遇非数字字符或小数点截断
parseInt("48px", 10);    // 示例输出: 48
parseInt("48.95", 10);   // 示例输出: 48 (不是 49,直接截断)
parseInt("width: 48", 10); // 示例输出: NaN (首个字符 'w' 即非法)
parseInt("100e2", 10);   // 示例输出: 100 (遇到字母 e 停止,不支持科学计数法)
经典陷阱:Array.prototype.map 结合 parseInt
在数组处理中,常见错误写法是 ['1', '2', '3'].map(parseInt)。这是因为 map 会向回调函数传入三个参数 (element, index, array),导致 parseInt 分别执行了:
parseInt('1', 0)(基数 0 默认转为 10 进制,得 1);
parseInt('2', 1)(基数 1 不合法,返回 NaN);
parseInt('3', 2)(二进制中字符 '3' 非法,返回 NaN)。
正确写法应封装单参数箭头函数:['1', '2', '3'].map(item => parseInt(item, 10)) 或 ['1', '2', '3'].map(Number)。
四、parseFloat() 的用法与浮点解析
parseFloat(string) 专门用于解析十进制浮点数。与 parseInt() 类似,它同样采用模式扫描机制,但存在以下显著特性:
- 仅支持十进制:
parseFloat()没有radix参数,它始终按十进制解析。如果传入十六进制前缀"0x1A",它在扫描到0后遇到字符x就会判定非法并截断,最终仅返回0。 - 识别且仅识别一个小数点:遇到首个小数点时会作为浮点部分继续扫描,但如果遇到第二个小数点,则视为非法字符并停在第二个小数点前。
- 完整支持科学计数法:遇到
e或E时,能够正确读取后方的指数部分。
// 1. 提取浮点小数与带单位尺寸
parseFloat("3.14159");     // 示例输出: 3.14159
parseFloat("2.5rem");      // 示例输出: 2.5 (适合提取 CSS 相对尺寸)
parseFloat("  .5");        // 示例输出: 0.5 (支持省略整数部分的点开头)

// 2. 多重小数点与非数字截断
parseFloat("12.34.56");    // 示例输出: 12.34 (遇到第二个点停止)
parseFloat("100.5% completed"); // 示例输出: 100.5

// 3. 科学计数法支持
parseFloat("3.14e-2");     // 示例输出: 0.0314
parseFloat("1e5");         // 示例输出: 100000

// 4. 十六进制陷阱
parseFloat("0xFF");        // 示例输出: 0 (无法解析十六进制,停在 'x')
五、三种转换方法的行为对比与边界矩阵
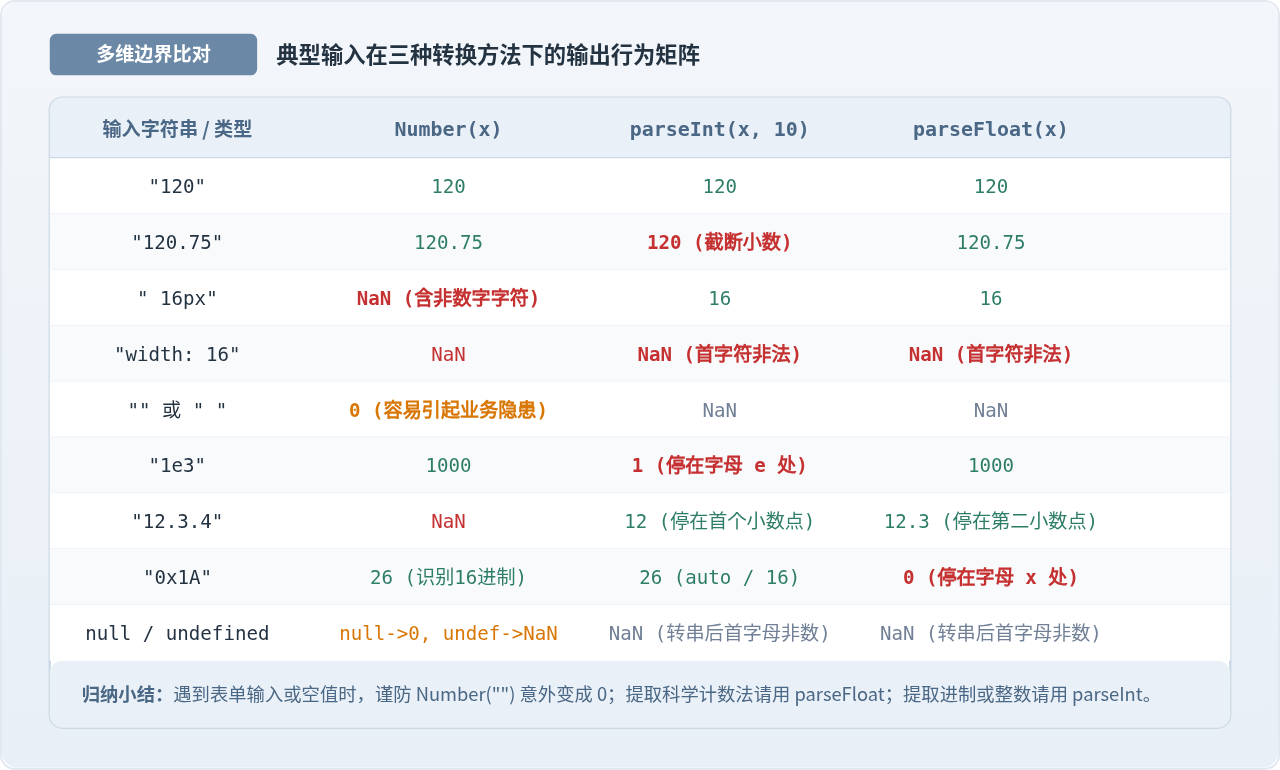
为了直观对比三者在各种常见、边界和特殊输入下的具体行为差异,整理如下对照表:
| 输入值 (input) | Number(input) | parseInt(input, 10) | parseFloat(input) | 解析行为差异解释 |
|---|---|---|---|---|
"100" |
100 | 100 | 100 | 标准纯整数字符串,三者结果一致 |
"100.75" |
100.75 | 100 | 100.75 | parseInt 遇到小数点直接截断抛弃小数 |
" 20px" |
NaN | 20 | 20 | Number 拒绝非数字字符;另两者容错截取数字前缀 |
"v2.0" |
NaN | NaN | NaN | 首个非空字符为字母,所有方法均无法开始解析 |
"" (空字符串) |
0 | NaN | NaN | Number 规范规定空串为 0;解析器无法找到首位数字 |
"1e3" |
1000 | 1 | 1000 | parseInt 不支持科学计数法,在字母 e 处截断 |
"0x10" |
16 | 16 | 0 | parseFloat 仅支持十进制,遇字符 x 截断留 0 |
"12.4.8" |
NaN | 12 | 12.4 | parseFloat 读取至第二个小数点停止 |
true / false |
1 / 0 | NaN | NaN | parseInt/parseFloat 将布尔值转为 "true" 导致 NaN |
null |
0 | NaN | NaN | Number(null) 遵循历史规范转为 0,解析器得 NaN |
undefined |
NaN | NaN | NaN | 全部返回 NaN |
六、实战选型与避坑决策指南
在具体工程实践中,不应当随意混用这三者。根据业务数据的性质和校验严格度,可遵循以下明确的选择路径:
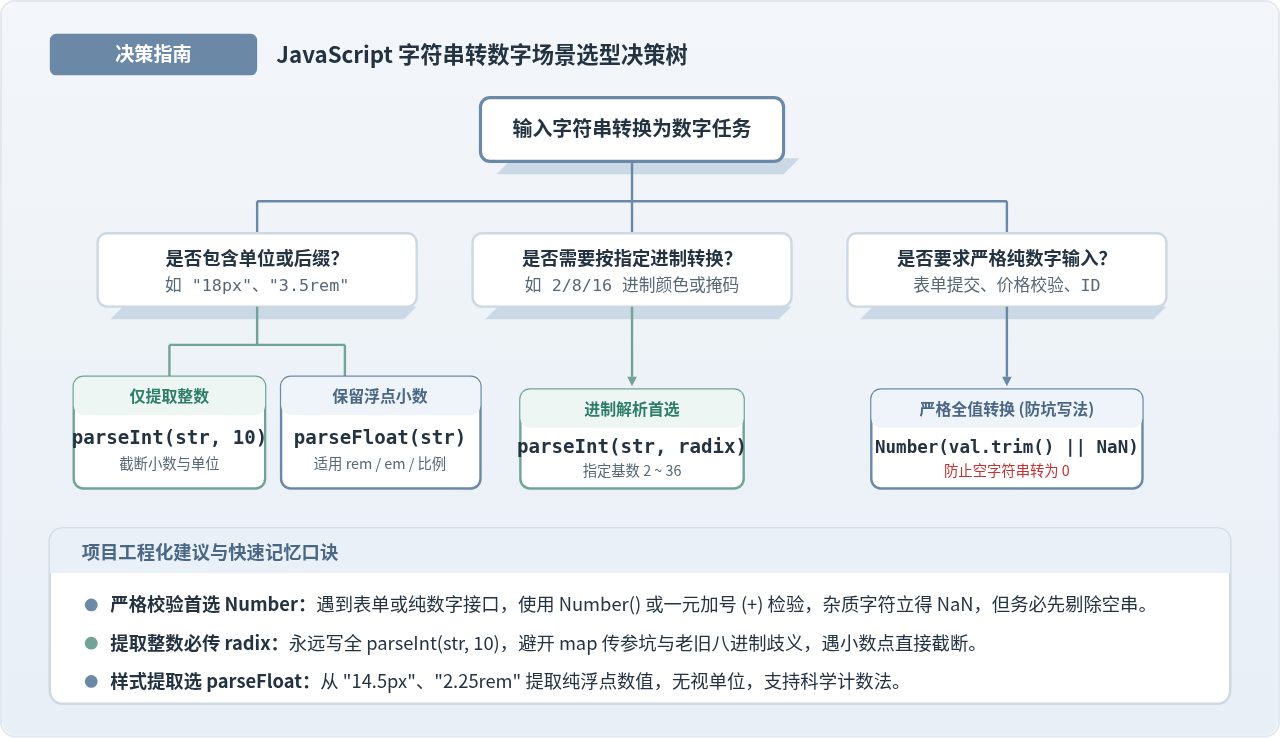
1. 场景一:表单输入校验与纯数值处理(首选 Number)
当接收用户输入的金额、年龄、手机号等字段时,我们的业务预期是“必须全部由数字构成”。如果用户误输入了 "100元",我们期望系统提示格式错误,而不是默默把 100 存入数据库。此时应使用 Number() 或一元正号 +,并显式过滤空串:
function parseStrictNumber(input) {
  if (typeof input !== 'string' || input.trim() === '') {
    return NaN; // 严防空字符串被转成 0
  }
  const result = Number(input);
  return Number.isNaN(result) ? NaN : result;
}
2. 场景二:CSS 样式或物理单位数值提取(首选 parseFloat / parseInt)
在编写动画库、Canvas 图表或操作 DOM 元素样式时,经常需要从 getComputedStyle 中读取 "1920px"、"1.75rem" 等属性值。此时后缀属于既定规范,我们只需要提取前导数值:
// 提取带单位的浮点尺寸
const rawHeight = "48.5px";
const heightValue = parseFloat(rawHeight); // 48.5

// 提取带单位的整数计数
const rawCount = "20items";
const countValue = parseInt(rawCount, 10);  // 20
3. 场景三:进制解析与哈希/色彩转换(首选 parseInt)
在解析十六进制颜色代码(如 #3B82F6 中的分量)或解析二进制位掩码时,必须使用 parseInt 并明确提供 radix:
// 将十六进制颜色分量转为 0-255 十进制
const hexColor = "3B";
const r = parseInt(hexColor, 16); // 59

// 解析权限二进制掩码 "1011"
const permissionMask = parseInt("1011", 2); // 11
4. 常用验证小工具:如何稳妥判断转换结果?
在 JavaScript 中,NaN 具有“不等于自身”的特殊性质(即 NaN === NaN 为 false)。因此,切勿使用等号判断是否解析成功,而应统一使用 ES6 推荐的 Number.isNaN():
const parsed = Number("abc");

// 错误判定写法:
if (parsed === NaN) { /* 永远不会进入该分支 */ }

// 正确判定写法:
if (Number.isNaN(parsed)) {
  console.log("转换失败,不是合法有效数字");
}大整数提示:对于超过 16 位的极大整数(大于 Number.MAX_SAFE_INTEGER,即 9007199254740991),上述三种基于 Number(双精度浮点数 IEEE 754)的方法都会出现精度丢失。处理此类雪花 ID、订单号或高精度哈希时,应使用 BigInt(str),而不是 Number() 或 parseInt()。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章