

全面解析现代JavaScript中URLSearchParams API的使用方法,包含初始化构建、参数读取判断、动态修改更新、自动编码序列化以及常见边界陷阱的应对方案。
JS解析URL查询参数:URLSearchParams API使用指南
作者:竹影
时间:2026-10-30
浏览:259
文章目录
在现代 Web 开发中,解析与操作 URL 查询参数(Query String)的标准途径是内置的 URLSearchParams 接口。过去开发者通常依靠字符串切割(split('&'))或复杂的正则表达式提取键值,这往往难以妥善处理多重编码、同名参数覆盖与特殊符号转义等细节。URLSearchParams 原生支持主流浏览器与 Node.js 运行环境,提供了简洁统一、自动编解码的读写能力。
一、初始化与构造方式
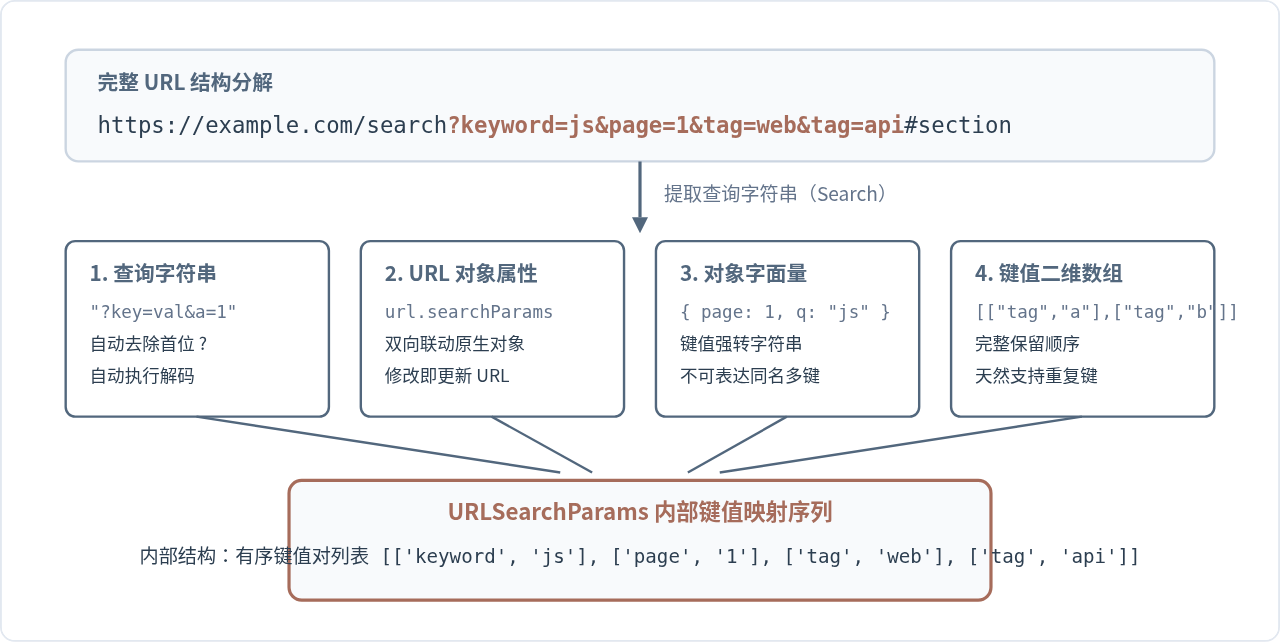
URLSearchParams 允许传入多种不同格式的数据源作为初始参数。无论是提取当前页面地址栏中的参数、解析服务端返回的完整 URL 字符串,还是直接通过键值字典进行构造,其构造函数都能完成自动解析。
// 方式 1:直接传入查询字符串(前置问号 '?' 会被自动忽略)
const params1 = new URLSearchParams("?keyword=javascript&page=1&filter=article");

// 方式 2:结合 URL 对象使用(推荐做法,直接读取 searchParams 属性)
const url = new URL("https://example.com/search?sort=desc&tag=frontend&tag=react");
const params2 = url.searchParams;

// 方式 3:传入纯对象字面量(键与值均会被自动转为字符串)
const params3 = new URLSearchParams({
  keyword: "urlsearchparams",
  page: 2,
  published: true
});

// 方式 4:传入二维数组(适合处理存在重复同名键的场景)
const params4 = new URLSearchParams([
  ["category", "tutorial"],
  ["category", "guide"],
  ["level", "intermediate"]
]);
二、核心读取方法:单值、多值与存在性判断
读取参数时,最常见的误区是混淆单值与多值。在 HTTP 查询参数规范中,同一个参数名可以多次出现(例如复选框筛选 tag=web&tag=api)。URLSearchParams 针对不同读取需求提供了明确的方法分工。
1. 获取单值:get(name)
get() 返回与指定名称关联的第一个值。若该参数在 URL 中并不存在,则返回 null;若该参数存在但未赋予具体内容(例如 ?debug 或 ?debug=),则返回空字符串 ""。
const params = new URLSearchParams("keyword=javascript&tag=web&tag=api&empty=");

params.get("keyword"); // "javascript"
params.get("tag");     // "web"(仅返回第一个匹配项)
params.get("empty");   // ""(键存在但无值)
params.get("page");    // null(键不存在)
2. 获取所有同名值:getAll(name)
当参数可能以同名多次传递时,必须使用 getAll()。该方法总是返回一个由字符串组成的数组。若参数不存在,返回空数组 [],不会返回 null,有效避免了数组判空的非必要防护代码。
params.getAll("tag");   // ["web", "api"]
params.getAll("page");  // []
3. 判断参数是否存在:has(name)
has() 用于判断指定的参数键名是否存在于参数集合中,返回布尔值。在较新的现代浏览器规范中,has() 已经支持第二个可选参数 value,用于判断是否存在特定键值组合(如 params.has("tag", "web"))。
params.has("keyword"); // true
params.has("empty");   // true(只要键名存在即返回 true,不判断是否为空)
params.has("page");    // false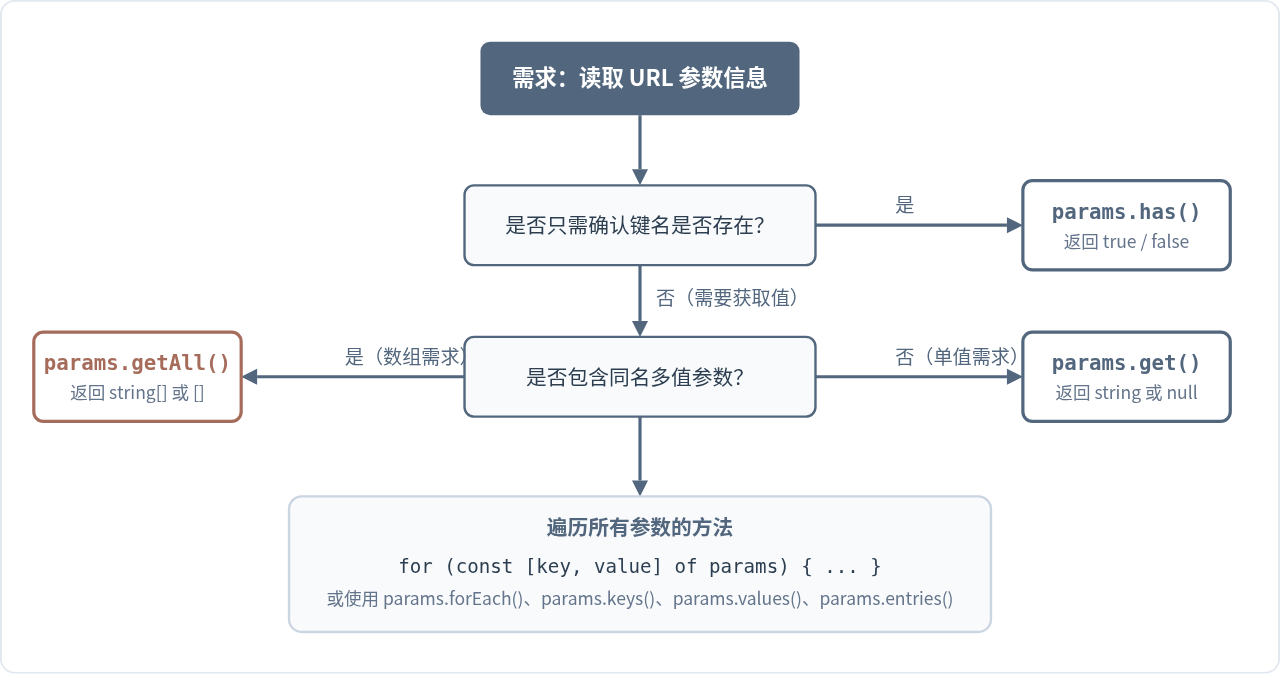
三、修改、添加与序列化:状态更新机制
URLSearchParams 不仅用于静态读取,更是前端进行路由更新与参数构建的得力工具。通过 set、append 与 delete 等变异方法修改参数后,调用 toString() 即可直接得到标准格式的 Query String。
1. 覆盖与追加:set() 对比 append()
set(name, value) 会将指定键设置为目标值。若该键之前存在多个同名项,set() 会将它们全部移除并仅保留这一个最新值。而 append(name, value) 则是在末尾追加一项,原有同名项全部继续保留。
const params = new URLSearchParams("tag=js&tag=css");

// 覆写:清除所有 tag,仅设为 html
params.set("tag", "html");
console.log(params.toString()); // "tag=html"

// 追加:在现有基础上增加新条目
params.append("tag", "vue");
console.log(params.toString()); // "tag=html&tag=vue"
2. 删除与排序:delete() 与 sort()
delete(name) 会彻底删除集合中所有名为 name 的条目。若只需删除特定值的条目,新标准同样支持 delete(name, value) 形式。
sort() 则会按各键名的 Unicode 码位对所有键值对进行原地字典排序。在构建接口签名、网络请求缓存键或统一页面规范链接(Canonical URL)时,这一特性十分关键。
const params = new URLSearchParams("z=last&a=first&m=middle");
params.sort();
console.log(params.toString()); // "a=first&m=middle&z=last"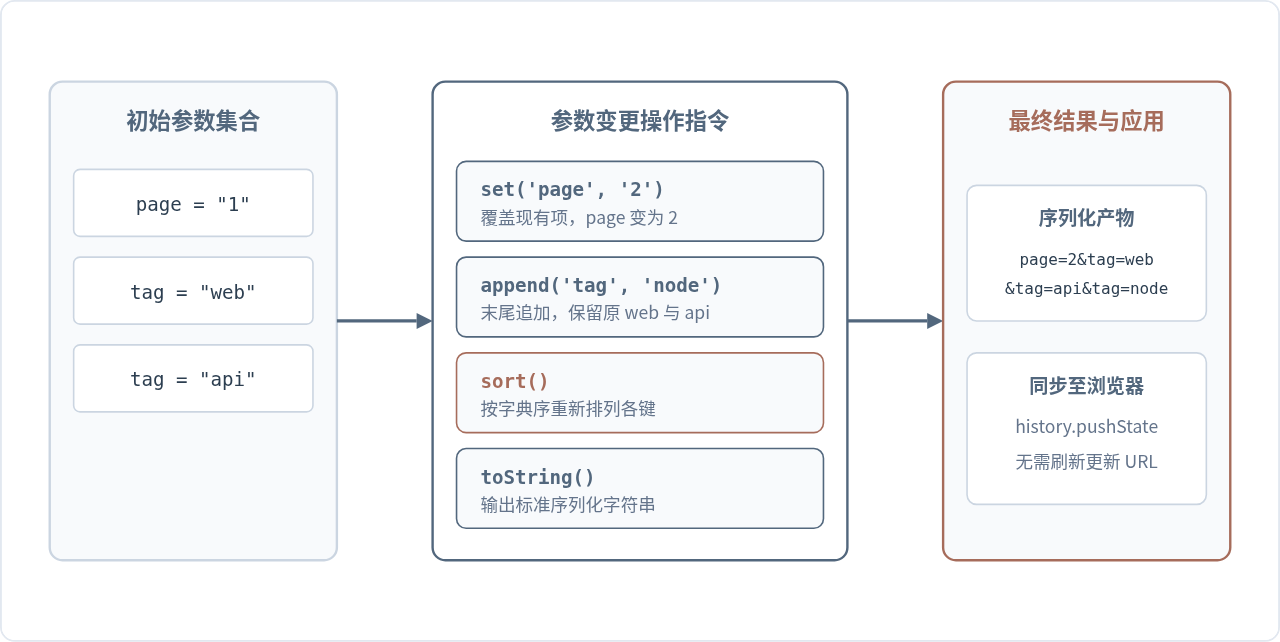
四、细节、编码机制与易错边界排查
虽然 URLSearchParams 大幅降低了解析难度,但在实际项目中仍有几个关键边界需要特别注意:
1. 空格与加号(+)的编码规则
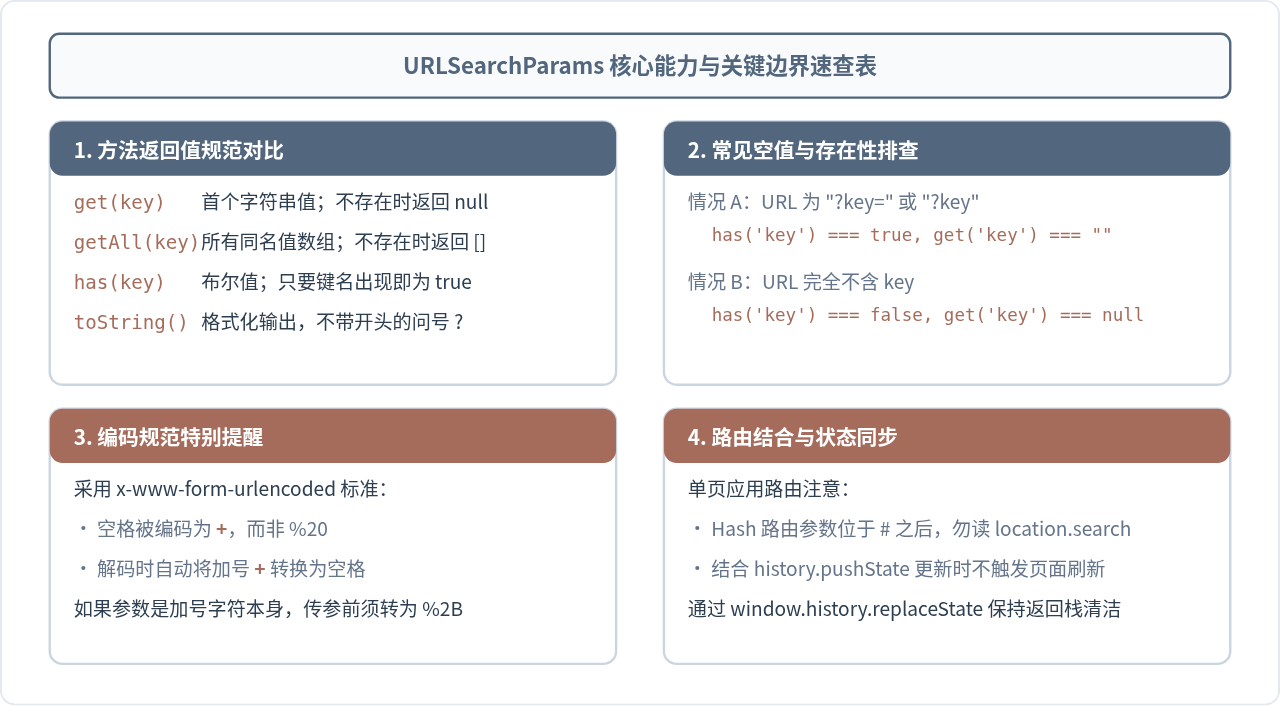
URLSearchParams 遵循的是 application/x-www-form-urlencoded 规范,而不是严格的 RFC 3986 统一资源标识符规范。在该规范下:
- 空格字符在序列化输出时会被转为加号
+,而不是%20。 - 在解析包含
+的输入字符串时,URLSearchParams会自动将其解码为普通空格。如果 URL 中的加号本身代表数学加号或加密哈希(如 Base64),必须先对其转义为%2B再传递。
2. 与单页面应用中 Hash 路由(#)的冲突
浏览器原生的 window.location.search 仅提取问号 ? 到井号 # 之间的内容。若单页面应用使用了 Hash 模式(例如 https://domain.com/#/list?id=123),则此时 location.search 会是空字符串,因为参数跟在 Hash 后面。此时必须从 window.location.hash 中截取问号后面的部分,再交由 URLSearchParams 处理:
// 针对 Hash 路由下的查询参数提取
const hashIndex = window.location.hash.indexOf("?");
const hashQuery = hashIndex !== -1 ? window.location.hash.slice(hashIndex) : "";
const hashParams = new URLSearchParams(hashQuery);
console.log(hashParams.get("id"));
3. 不存在键与空值键的判断差异
务必分清 null 与 "":
- 未在 URL 中出现的键:
params.get("absent") === null,params.has("absent") === false。 - URL 包含了键但未写值(如
?flag=或?flag):params.get("flag") === "",而params.has("flag") === true。
五、实战示例:列表筛选与地址栏同步
下面是一个在前端开发中极为常见的实战场景:用户在页面勾选筛选条件、切换分页时,将状态实时同步至浏览器地址栏;并在用户刷新页面时,准确从 URL 中反向恢复筛选状态。
// 1. 从当前 URL 读取并恢复筛选状态
function restoreFilterState() {
  const params = new URLSearchParams(window.location.search);

  return {
    page: parseInt(params.get("page") || "1", 10),
    keyword: params.get("keyword") || "",
    categories: params.getAll("cat"), // 获取多选分类
    sort: params.get("sort") || "create_time"
  };
}

// 2. 更新筛选状态并无刷新写入地址栏
function updateFilterState(newFilters) {
  const url = new URL(window.location.href);

  // 更新或删除关键字
  if (newFilters.keyword) {
    url.searchParams.set("keyword", newFilters.keyword);
  } else {
    url.searchParams.delete("keyword");
  }

  // 设置当前页码
  url.searchParams.set("page", String(newFilters.page || 1));

  // 重置并重新填充多选分类
  url.searchParams.delete("cat");
  if (Array.isArray(newFilters.categories)) {
    for (const cat of newFilters.categories) {
      url.searchParams.append("cat", cat);
    }
  }

  // 使用 replaceState 更新浏览器地址,不新增历史记录步进
  window.history.replaceState({}, "", url.toString());
}
六、总结
URLSearchParams 统一了现代 JavaScript 对 URL 查询参数的读写方式。在绝大多数业务开发中,牢记以下几条准则即可避免大部分问题:
- 优先配合
URL对象使用:使用url.searchParams是最稳健的模式,它能在操作参数的同时自动同步更新url.href。 - 单值用
get,多值用getAll:不要用get读取数组类参数,否则只会拿到第一个值。 - 判空要精确:
null表示未传,""表示传了但值为空,结合has()做明确意图的判定。 - 牢记
+的特殊意义:注意application/x-www-form-urlencoded下空格转为+的既有规则,遇到敏感特殊字符提前做好转义。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章