
深入对比并实战讲解使用JavaScript提取网页超链接的两种核心方式:document.links与document.querySelectorAll,涵盖属性差异、绝对路径转换及去重导出。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS提取网页所有超链接:document.links与querySelectorAll实战
作者:竹影
时间:2026-10-30
浏览:547
文章目录
在前端脚本或浏览器控制台中提取当前网页的所有超链接,最核心且常用的两个原生接口是 document.links 和 document.querySelectorAll('a')。前者是 DOM 规范早期就存在的专用集合,专用于收集所有具备超链接特性的锚点与热区;后者是现代通用选择器 API,能够以 CSS 规则自由定位任何匹配的标签。本文将通过原理剖析、多场景代码实现与常见陷阱排查,帮助读者系统掌握在实际项目中高效提取、清洗与导出超链接的方法。
一、核心机制对比:document.links 与 querySelectorAll('a')
很多开发者初学时容易认为“页面上的所有超链接等同于所有的 <a> 标签”。这一认知在大部分常规页面中表现正常,但并非严谨标准。在 HTML 规范中,没有设置 href 属性的 <a> 仅仅作为占位锚点或单纯的文本容器,它并不构成能够点击跳转的“超链接”。
document.links 属于 HTMLCollection 实例,它遵循专用规则:只抓取页面中带有 href 属性的 <a> 元素以及带有 href 属性的 <area> 图像热区元素,同时该集合是动态(live)的。而 document.querySelectorAll('a') 返回的是静态(static)的 NodeList,如果不额外附加属性选择器,它会连同没有 href 属性的纯占位 <a> 一并返回,且不会包含 <area> 元素。
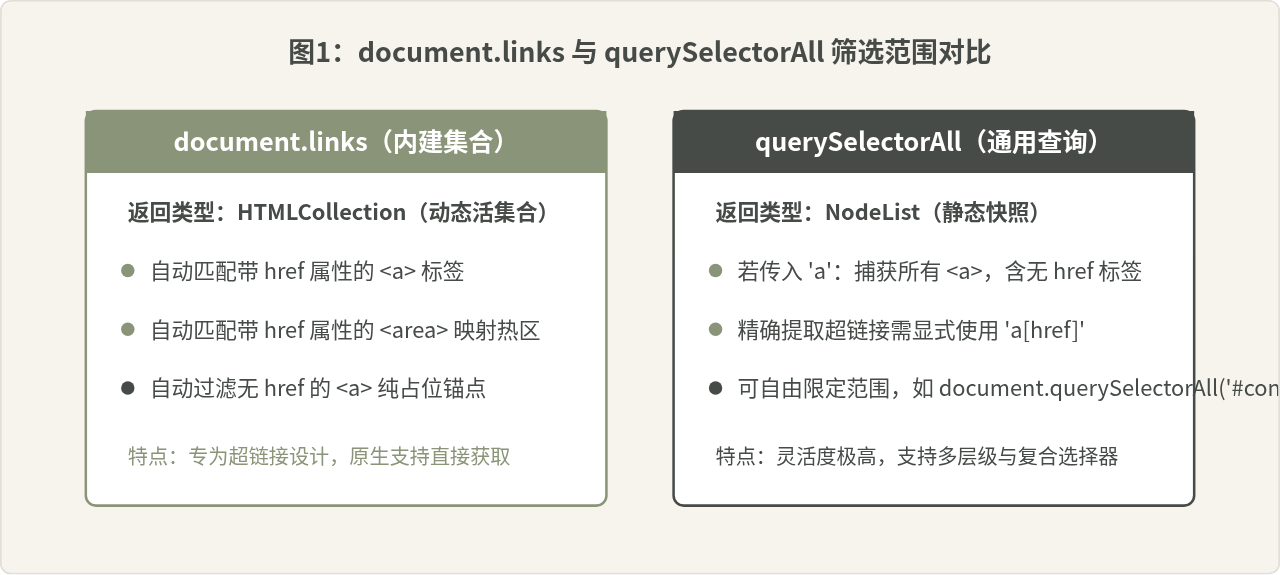
图1:两个接口的集合类型、元素覆盖范围及匹配机制对比
为了直观说明差异,以下是两者核心特性的对照清单:
| 对比维度 | document.links | document.querySelectorAll('a[href]') |
|---|---|---|
| 返回值类型 | HTMLCollection(动态) |
NodeList(静态) |
| 是否支持 <area> 热区 | 是(只要有 href 属性即包含) | 否(需另写 querySelectorAll('a[href], area[href]')) |
| 无 href 的 <a> 标签 | 自动排除 | 由选择器决定(写 a[href] 排除,写 a 包含) |
| 作用域限定 | 仅挂载于 Document,无法局部调用 |
可挂载于任何容器节点(如 element.querySelectorAll) |
| 数组方法适配 | 不支持 forEach,需转换后遍历 |
原生内置 forEach 方法 |
二、超链接提取的完整实战步骤
在实际开发或数据抓取中,完整提取超链接通常包含四个标准环节:准备与节点选取、属性提取、规范化与去重过滤、结果导出。整个流程环环相扣,如下图所示:
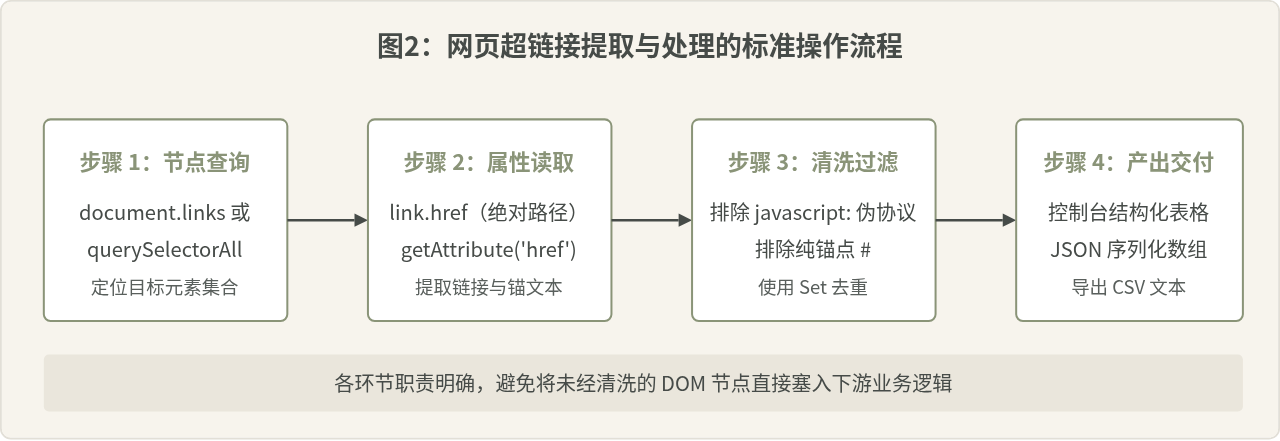
图2:从 DOM 节点抓取到下游交付的端到端四步操作法
1. 使用 document.links 进行轻量提取
由于 document.links 属于类数组对象,最稳妥的做法是通过 Array.from() 将其转换为标准数组,以便使用 map 与 filter:
// 提取页面所有超链接并返回纯地址数组
const allUrls = Array.from(document.links).map(link => link.href);

console.log(`共提取到 ${allUrls.length} 个超链接:`, allUrls);
如果不仅需要 URL,还需要链接对应的提示文字(锚文本)和打开方式,可构造结构化对象:
const linkDetails = Array.from(document.links).map(link => ({
  text: (link.textContent || '').trim(),
  href: link.href,
  target: link.target || '_self'
}));

console.table(linkDetails);
2. 使用 querySelectorAll 进行范围精确提取
很多时候并不需要抓取整页页头(导航栏)、页脚(版权声明)中的链接,而仅仅关注正文容器(如 article 或 .article-body)内部的链接。此时 querySelectorAll 的层级选择器优势凸显:
// 仅提取正文区域内的有效链接
const container = document.querySelector('article') || document.body;
const contentLinks = Array.from(container.querySelectorAll('a[href]')).map(a => ({
  text: a.innerText.trim(),
  href: a.href
}));

console.log('正文链接集合:', contentLinks);
三、关键陷阱解析:element.href 与 getAttribute('href')
在提取链接属性时,一个最容易引发 Bug 的细节就是混淆 element.href 与 element.getAttribute('href')。两者在返回值规范上有本质不同:
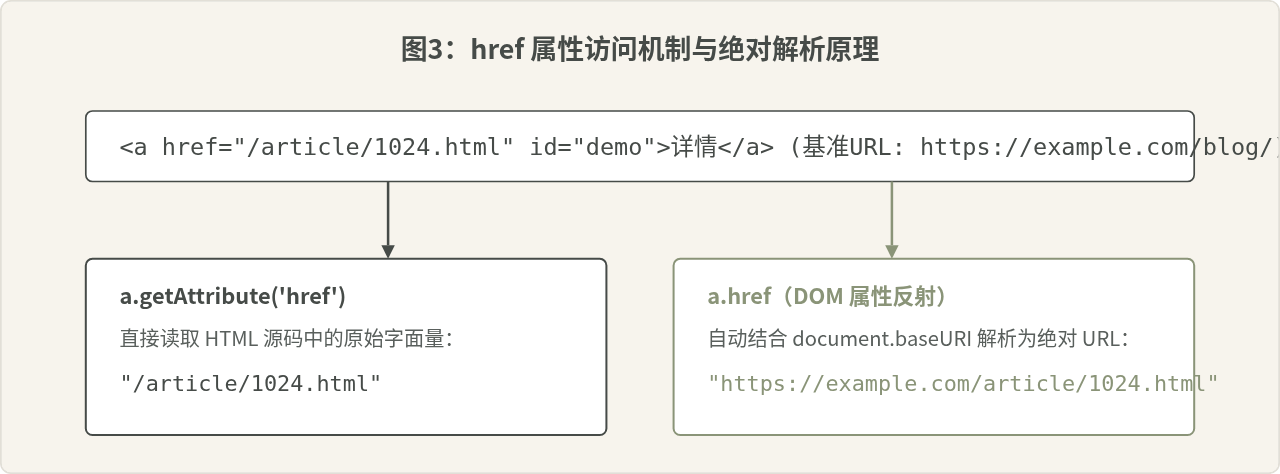
图3:HTML 源码字面属性与 DOM 接口自动解析为完整 URL 的机制差异
a.getAttribute('href'):获取的是编写在 HTML 代码中的原始字符串。如果是相对路径(如./news或/api),拿到的依然是未解析的片段。a.href:属于 DOM 规范定义的HTMLHyperlinkElementUtils接口,浏览器会自动结合页面的baseURI,将其标准化解析为绝对 URL(带有协议、域名与完整路径)。
排查建议:如果提取目的是为了请求资源、校验链路状态或导出给外部程序使用,请始终使用
a.href 获取绝对 URL;如果任务目的是检查源码标签规范性,或者只关心作者原始写了什么,才使用 getAttribute('href')。
四、工程实战:完整健壮的提取与去重脚本
在面对复杂的真实页面时,超链接中往往夹杂着诸如 javascript:void(0)、纯锚点 #、mailto:、tel: 协议,或者大量指向相同地址的重复链接。如果不加处理,提取出的数据通常充斥着噪点。
以下给出一个经过清洗过滤与自动去重的通用实战函数,适合直接嵌入项目工具库或在控制台中运行:
/**
 * 健壮的网页超链接提取器
 * @param {Object} options 配置项
 * @param {Element|Document} [options.root=document] 检索根节点
 * @param {boolean} [options.httpOnly=true] 是否仅保留 http/https 链接
 * @param {boolean} [options.unique=true] 是否按 URL 去重
 * @returns {Array<{url: string, text: string}>}
 */
function extractPageLinks(options = {}) {
  const {
    root = document,
    httpOnly = true,
    unique = true
  } = options;

  // 1. 获取所有带有 href 属性的超链接元素
  const elements = root.querySelectorAll('a[href], area[href]');
  const results = [];
  const seenUrls = new Set();

  for (const el of elements) {
    const fullUrl = el.href;
    const rawHref = el.getAttribute('href').trim();

    // 过滤空链接与无意义的行内脚本/纯锚点
    if (!rawHref || rawHref === '#' || rawHref.startsWith('javascript:')) {
      continue;
    }

    // 可选:仅保留 http 和 https 协议
    if (httpOnly) {
      try {
        const parsed = new URL(fullUrl);
        if (parsed.protocol !== 'http:' && parsed.protocol !== 'https:') {
          continue;
        }
      } catch (e) {
        continue; // 非法 URL 字符串直接忽略
      }
    }

    // 去重处理
    if (unique) {
      if (seenUrls.has(fullUrl)) {
        continue;
      }
      seenUrls.add(fullUrl);
    }

    results.push({
      url: fullUrl,
      text: (el.textContent || el.getAttribute('alt') || '').trim()
    });
  }

  return results;
}

// 执行提取并在控制台输出格式化结果
const cleanLinks = extractPageLinks();
console.table(cleanLinks);
五、选型总结与决策建议
无论是使用原生轻量的 document.links,还是使用自由度极高的 document.querySelectorAll,关键在于理解场景约束。下图总结了在不同需求下的最佳路径选型:
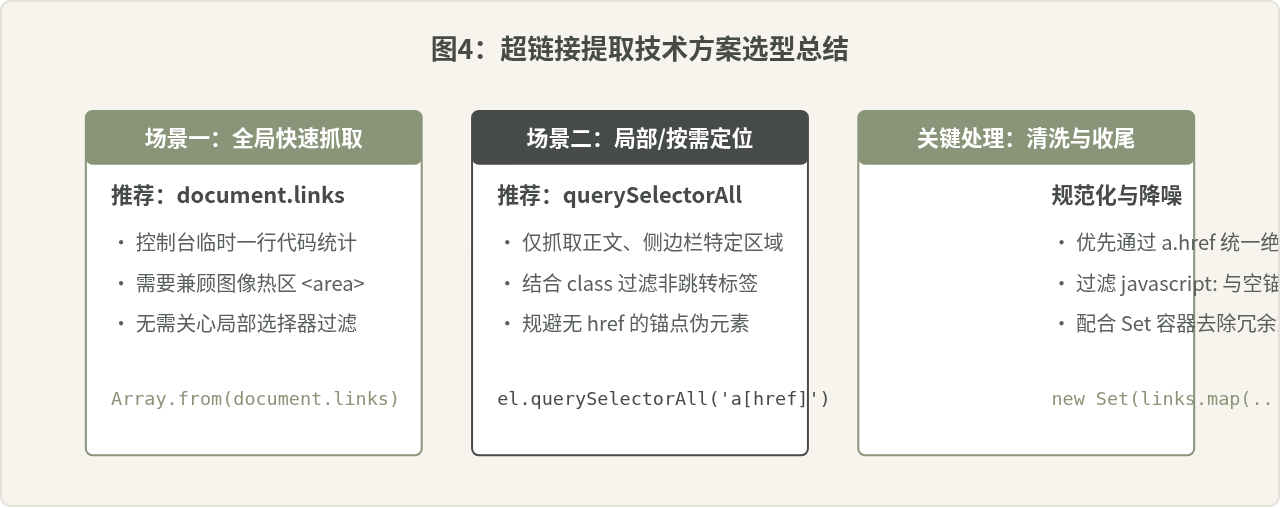
图4:两类接口的选用场景与生产环境标准化清洗建议
综上所述,当你的任务是全局快速排查或需要兼顾历史规范中的图像热区时,document.links 提供了天然过滤无 href 标签的原生便利;而当任务存在层级嵌套限制、需要结合复杂 CSS 选择器排除干扰区域时,container.querySelectorAll('a[href]') 则是灵活性最高的现代选择。结合 a.href 的绝对路径解析与 Set 集合去重,即可构建稳定可靠的超链接提取方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章