
深入盘点Node.js开发中常用的关系型数据库PostgreSQL、MySQL、SQLite与非关系型数据库MongoDB、Redis,从架构特性、适用场景、生态工具到工程落地给出全面解析与对比选型建议。

当前位置:首页 > Node.js 数据库开发 > 正文
Node.js开发常用的数据库有哪些
作者:谷雨
时间:2026-10-30
浏览:194
文章目录
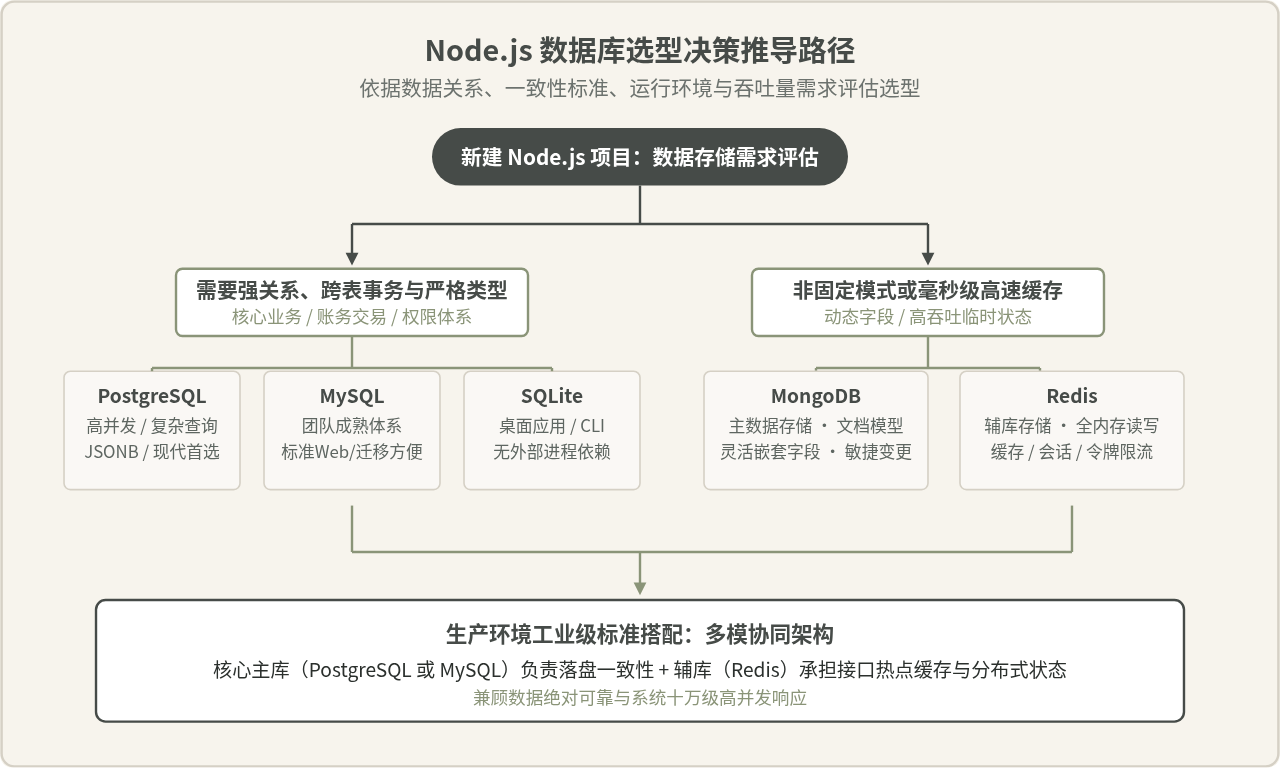
在当前的 Node.js 后端工程实践中,并没有一种适用于所有业务的“唯一万能数据库”。核心主流数据库主要划分为三类:以 PostgreSQL、MySQL 和 SQLite 为代表的关系型数据库(SQL),以 MongoDB 为代表的文档型数据库(NoSQL),以及以 Redis 为代表的高速内存键值数据库。绝大多数实际项目采用“关系型/文档型主库负责核心业务持久化,搭配 Redis 负责缓存与并发状态管理”的多模组合模式。
一、Node.js 与常用数据库的全景架构
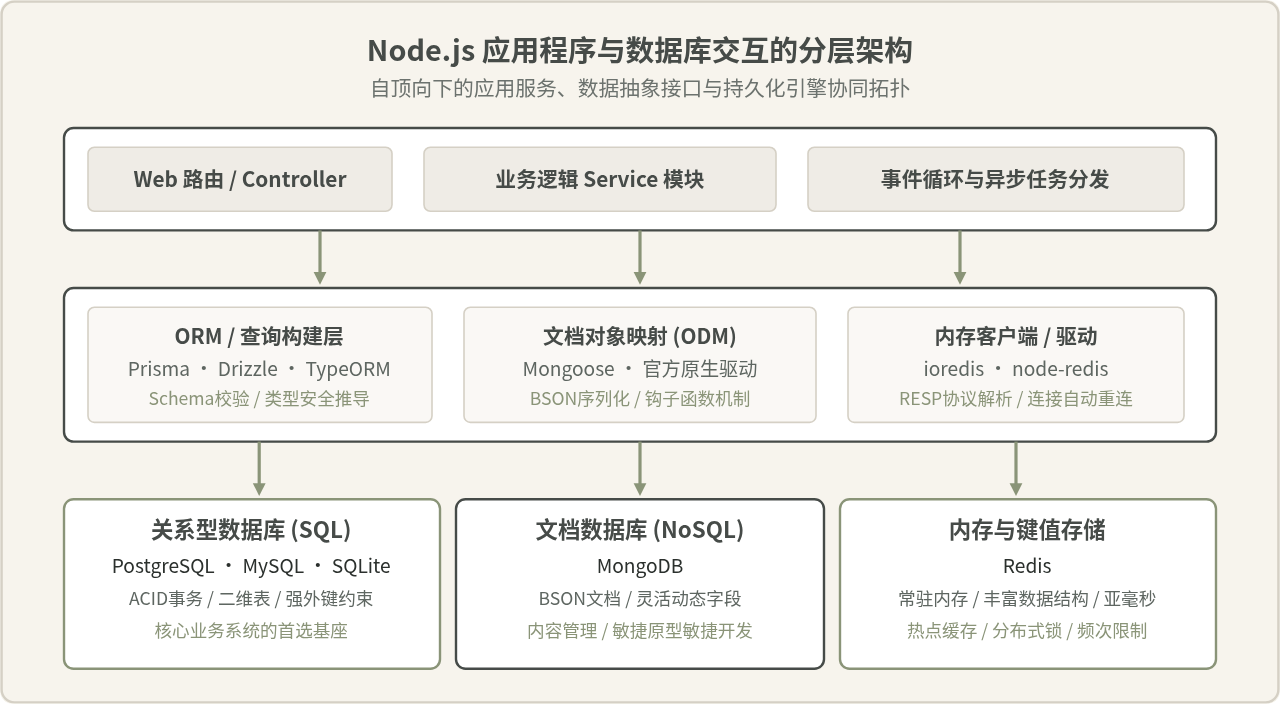
Node.js 采用单线程事件循环驱动非阻塞异步 I/O 的运行机制。这意味着当应用程序与数据库通信时,Node.js 并不直接阻塞等待磁盘写入或复杂计算完成,而是将网络查询交由底层驱动发送,并依赖连接池高效分发异步任务。
根据数据组织形式和在系统架构中所承担的职责,Node.js 开发者接触频率最高的五种数据库可以清晰地划分为三个层级:
- 强关系型持久存储(PostgreSQL / MySQL):依托严格的二维表结构、字段类型约束与 ACID 事务支持,适合电商结算、权限账务、用户关系等要求数据高准确度的核心主业务系统。
- 轻量级嵌入式存储(SQLite):以单文件形式直接嵌入在 Node.js 进程内部,免去网络通信开销和外部数据库服务的安装配置成本,广泛应用于桌面客户端、单机微服务及边缘计算。
- 灵活多模/文档存储(MongoDB):基于 BSON(二进制 JSON)文档存储数据,数据模型与 JavaScript 对象的表达方式天然一致,适合内容发布、高频结构变更与快速原型迭代。
- 极速内存状态中心(Redis):将数据常驻内存并提供丰富的数据结构,作为辅库承担热点数据缓存、分布式会话(Session)、接口限流与消息发布订阅。
二、关系型数据库:结构化业务与数据一致性基石
关系型数据库以严格的 Schema(表结构)、SQL 标准化查询、ACID 事务完整性为标志。在涉及资金、多主体关联、严密状态流转的企业级 Node.js 项目中,关系型数据库始终占据主导地位。
1. PostgreSQL:现代 Node.js 社区的主流首选
PostgreSQL 在当下的 Node.js 和 TypeScript 社区中拥有极高的支持度。它不仅具备极佳的 SQL 规范遵从度和完善的外键、视图、触发器支持,更凭借强大的多模扩展能力赢得广泛认可:
- 原生的 JSONB 高效索引:PostgreSQL 支持将非结构化 JSON 存为二进制 JSONB,并允许通过 GIN 索引对 JSON 内部的任意键名或数组直接建立倒排索引,实现了“关系型模型与文档型性能兼备”。
- 强大的类型系统与拓展能力:支持丰富的地理信息扩展(PostGIS)、向量检索插件(pgvector,用于大模型嵌入存储)以及自定义枚举与数组类型。
- Node.js 驱动与生态:底层使用
pg(node-postgres)提供高效连接池;上层与现代 ORM(如 Prisma、Drizzle ORM)配合默契,能够直接将数据库表映射为精确的 TypeScript 类型。
2. MySQL:装机量大、成熟稳固的行业标准
MySQL(及其分支 MariaDB)是全球互联网基础设施中使用最为广泛的关系型数据库之一。对于很多既有技术团队,从 PHP、Java 或 Python 栈迁移到 Node.js 时,MySQL 往往是阻力最小的选择:
- 运维生态极度成熟:主流云厂商均提供极其完善的 MySQL 高可用实例、只读从库和自动备份方案,社区排障资料极其丰厚。
- 读写优化模型明确:基于 InnoDB 存储引擎的聚簇索引和行级锁机制,在标准电商交易、用户中心、后台系统等以单表高频读写和适度关联查询的场景下表现平稳。
- Node.js 驱动支持:推荐使用
mysql2驱动包,它完全兼容老旧的mysql包接口,同时内置了 Prepared Statement 预编译语句机制以防御 SQL 注入,并支持 Promise 语法。
3. SQLite:零配置、进程内嵌入的轻量级代表
SQLite 与 PostgreSQL 和 MySQL 有着本质的架构区别:它是一个无独立服务端进程的嵌入式数据库。整个数据库表现为磁盘上的单个普通文件,数据库引擎作为动态链接库直接运行在 Node.js 主进程或子进程内。
- 适用场景:Electron 构建的跨平台桌面应用、本地命令行 CLI 辅助工具、自动化测试环境,以及低写入并发的中小型微服务。
- Node.js 驱动选型:推荐使用
better-sqlite3,它利用 Node-API(C++ 扩展)同步执行读写操作,避免了异步 IPC 的封包开销,在本地单文件读取测试中速度远超一般的网络数据库驱动。 - 局限与约束:SQLite 在并发写入时使用库级锁(WAL 模式下有很大改善,但依然不适合高并发多点并发写入),不适合分布式多节点部署的后端集群。
三、非关系型与专用数据库:动态灵活性与超高吞吐
当数据结构的字段经常变动,或者单点查询的吞吐量要求达到数万乃至数十万 QPS 时,传统关系型数据库的表锁机制与硬盘 I/O 往往面临压力,此时便需要引入针对特定形态优化的 NoSQL 或内存数据库。
1. MongoDB:基于文档的模型与灵活迭代
在 Node.js 普及早期,由 MongoDB、Express、Angular 和 Node 组成的“MEAN 技术栈”风靡一时。MongoDB 将数据保存为形如 JSON 的 BSON 文档,表被称为“集合(Collection)”,行被称为“文档(Document)”。
- 面向对象的直观存取:JavaScript 中的复合对象、嵌套数组和子键,可以直接无须拆解地保存为一个 MongoDB 文档,省去了复杂的连表(JOIN)操作设计。
- Schema-less(无固定模式):同一集合内的不同文档可以拥有完全不同的字段,当业务需求频繁迭代,需要随时增加非标准化属性时,无需执行耗时阻塞的
ALTER TABLE变更。 - Node.js 工具链:官方提供
mongodb驱动,社区几乎全量采用mongoose作为 ODM(对象文档映射库)。Mongoose 允许开发者在应用层通过代码定义数据格式规范与内置校验规则。
2. Redis:微秒级响应的内存数据结构中心
严格来说,Redis 通常不作为独立承载所有数据的“单一主数据库”,而是作为整个后端架构的关键支撑组件。Redis 将数据完整保存在内存中,仅异步落盘持久化,平均响应延迟在亚毫秒级别。
- 多样化的原生数据结构:不仅支持普通键值字符串(String),还原生支持哈希表(Hash)、双向列表(List)、集合(Set)、有序集合(Sorted Set)以及 HyperLogLog 和位图。
- Node.js 核心搭配场景:
- 热点数据缓存:将从 PostgreSQL 或 MySQL 中查询出的复杂计算结果放入 Redis,设置 TTL(过期时间),降低关系型数据库的 CPU 负荷。
- 分布式 Session 共享:当 Node.js 服务通过 PM2 集群模式或多容器横向扩容时,内存会话无法跨进程访问,统一存储在 Redis 中即可实现无状态平滑调度。
- 高频计数器与限流防刷:利用
INCR原子操作和滑动窗口算法,轻松实现 API 接口的频率限制(Rate Limiting)。
- Node.js 驱动生态:主流首选为
ioredis,具备优秀的集群支持、哨兵监控感知、管道传输(Pipelining)及连接断开重试策略。
四、工程化落地:Node.js 项目中的数据库接入规范与代码实践
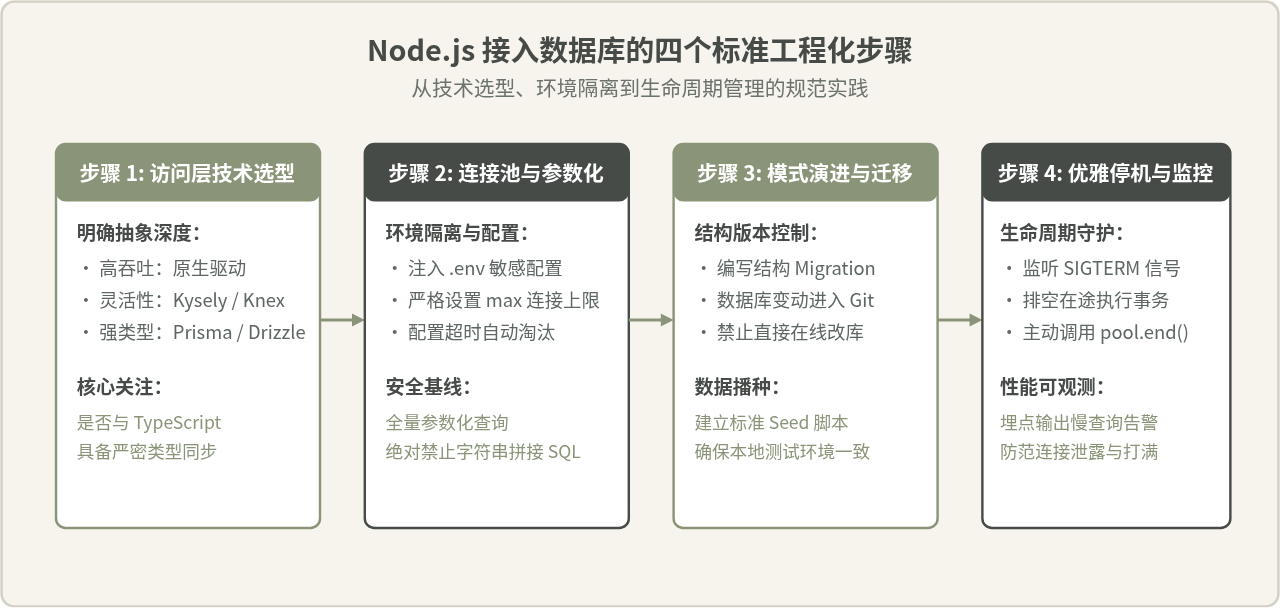
选定具体数据库后,在 Node.js 中如何组织数据库访问代码同样至关重要。一个未经规范管理的数据库调用层,极易因“连接泄漏”、“缺乏超时机制”或“明文拼接 SQL”导致应用在生产环境中雪崩。
1. 数据访问抽象层:原生驱动与 ORM / Query Builder 的权衡
在 Node.js 中,操作数据库的方式通常有三个梯队:
- 原生驱动(Native Drivers):如
pg、mysql2。直接书写原生 SQL。优势是性能无损、透明可控,但需要手工处理参数转义与类型映射,代码较为冗长。 - 轻量级查询构建器(Query Builder):如
Kysely、Knex.js。提供链式调用的 TypeScript API 来生成 SQL,拥有完善的代码自动补全和编译期语法校验,兼备灵活性与可维护性。 - 全功能对象关系映射(ORM):如
Prisma、Drizzle ORM、TypeORM。通过 Schema 文件自动生成数据库表结构与前端强类型模型,大幅减少重复 CRUD 代码的编写工作。
2. 典型接入代码示例:连接池与优雅停机(Graceful Shutdown)
以下以最通用的 PostgreSQL 原生驱动 pg 为例,展示在生产环境中应当遵循的连接池配置、参数化防注入查询以及服务关停时释放资源的标准范式:
// db.js - 数据库连接池模块化封装
const { Pool } = require('pg');

// 生产环境务必从环境变量读取配置,杜绝硬编码
const pool = new Pool({
  host: process.env.DB_HOST || '127.0.0.1',
  port: parseInt(process.env.DB_PORT || '5432', 10),
  database: process.env.DB_NAME || 'app_production',
  user: process.env.DB_USER || 'node_user',
  password: process.env.DB_PASSWORD,
  max: 20,                  // 连接池最大连接数,视 Node 进程数与数据库负载而定
  idleTimeoutMillis: 30000, // 闲置连接释放超时(30秒)
  connectionTimeoutMillis: 2000, // 获取连接的最大等待时间(2秒)
});

// 监听连接池错误,防止未捕获异常导致 Node 进程崩溃
pool.on('error', (err) => {
  console.error('数据库连接池发生意外错误:', err.message);
});

/**
 * 封装通用参数化查询方法
 * 严格使用占位符 ($1, $2) 防止 SQL 注入
 */
async function query(text, params) {
  const start = Date.now();
  const res = await pool.query(text, params);
  const duration = Date.now() - start;
  // 可记录大于 200ms 的慢查询日志
  if (duration > 200) {
    console.warn(`[慢查询检测] 耗时 ${duration}ms, SQL: ${text}`);
  }
  return res;
}

/**
 * 优雅关停处理函数
 * 在收到部署重启或终止信号时,等待正在执行的事务结束后主动排空连接池
 */
async function closePool() {
  console.log('正在排空并断开数据库连接池...');
  await pool.end();
  console.log('数据库连接池已安全关闭。');
}

process.on('SIGTERM', async () => {
  await closePool();
  process.exit(0);
});

process.on('SIGINT', async () => {
  await closePool();
  process.exit(0);
});

module.exports = {
  query,
  closePool,
};
五、容易混淆的常见说法与深度辨析
在涉及 Node.js 与数据库搭配的技术讨论中,经常存在一些流行但片面的观点。理解这些说法为什么产生、在什么条件下成立,以及何时需要纠偏,有助于做出更理性的技术决策。
说法辨析 1:“学 Node.js 就必须学 MongoDB,它们是天然标配?”
看似合理的原因:在早期全栈培训和入门教程中,MongoDB 的 JSON 存取特性与 JavaScript 的语法高度贴合,前端开发者无需学习复杂的 SQL 语言和外键范式就能迅速把数据写进数据库,教学门槛极低。
实际边界与修正:在真实的商业级生产应用中,核心业务几乎都要处理多租户、资金流、订单状态机与多实体级联约束。MongoDB 虽然在 4.0 后加入了多文档事务,但其强项依然是水平分片与文档内聚。如果强行把高度关联的关系模型塞进 MongoDB,会导致代码充斥着大量脆弱的多次查询模拟 JOIN,维护成本反噬。对于标准企业应用,PostgreSQL 或 MySQL 才是更为扎实的基础设施选型。
说法辨析 2:“现代 SQL 数据库都已支持 JSONB 字段,文档数据库(NoSQL)已经彻底过时了?”
看似合理的原因:PostgreSQL 的 JSONB 配合 GIN 索引确实可以在单个字段内实现极其快速的任意键值检索与路径提取,使得“结构化字段用普通列,动态扩展字段用 JSONB”成为可能,极大挤压了纯文档数据库的传统生存空间。
实际边界与修正:这种说法忽略了集群伸缩架构与写入成本的差异。MongoDB 天然内置了原生基于分片键(Shard Key)的数据自动平衡分片机制,能够非常平滑地横向扩展至几十台机器支撑海量写吞吐;而 PostgreSQL 等关系型数据库的横向分片(Sharding)配置与维护难度明显更高。因此,当面对超海量非结构化事件、日志流与高并发写吞吐需求时,专用文档或时序数据库依然具备不可替代的架构优势。
说法辨析 3:“ORM 会带来严重的性能损耗,生产项目绝对不能使用 ORM?”
看似合理的原因:早期的重型 ORM(如旧版 TypeORM 或某些高层封装)在处理复杂连表查询时,容易生成臃肿的嵌套子查询,或者在开发者不加节制使用懒加载(Lazy Loading)时引发灾难性的“N+1 查询问题”,拖慢系统吞吐。
实际边界与修正:ORM 的核心价值在于研发效率、编译期类型检查、模型统一以及自动化迁移工具链。对于绝大多数互联网系统,瓶颈往往出现在缺失索引、非合理长事务或未经设计的深分页上,而非 ORM 几毫秒的解析开销。现代轻量 ORM(如 Prisma、Drizzle)提供了极其透明的 SQL 导出预览,并随时允许混用 $queryRaw 编写手写原生 SQL。合理的策略是:“90% 的标准业务 CRUD 依托 ORM 享受类型安全与生产力,10% 的高频核心分析或报表接口采用手写 SQL 或查询构建器针对性优化”。
六、Node.js 常用数据库综合对比与选型指南
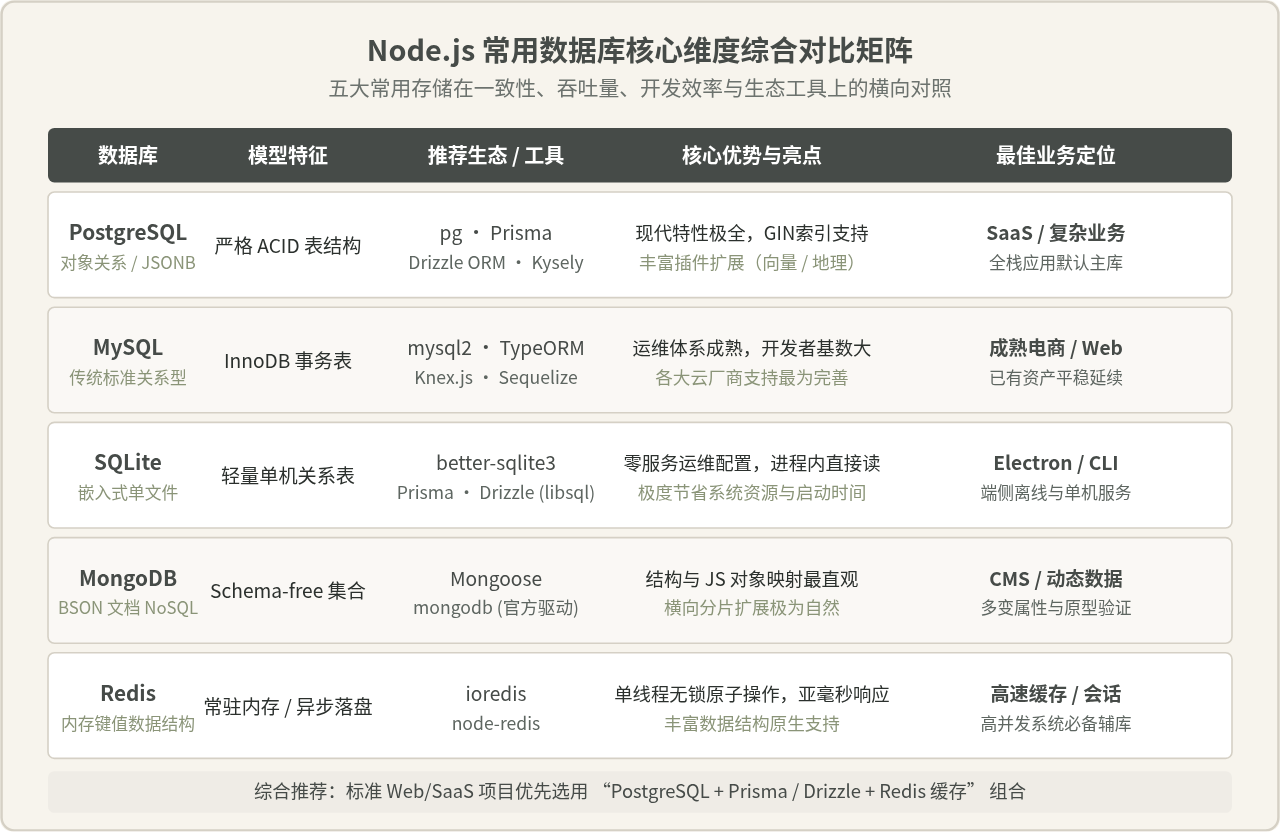
为了在面临技术选型时能够迅速定位最适合自身业务的技术栈,下表对这五种常用数据库的核心特性、驱动工具、优势与最佳适用场景进行了系统总结:
| 数据库 | 数据模型 | Node.js 推荐驱动 / 工具 | 核心优势 | 最适合的业务场景 |
|---|---|---|---|---|
| PostgreSQL | 对象关系型(支持表与JSONB多模) | pg、Prisma、Drizzle ORM |
严格ACID事务、丰富类型、高阶扩展(PostGIS/pgvector) | 企业级 SaaS、金融账务、具备强类型要求的现代全栈系统 |
| MySQL | 传统关系型(表结构驱动) | mysql2、Kysely、TypeORM |
装机量巨大、运维生态极成熟、团队技能通用性强 | 传统 Web 门户、成熟电商平台、从已有技术栈平移的项目 |
| SQLite | 嵌入式进程内关系型 | better-sqlite3 |
零服务依赖、单文件存储、进程内同步读取速度极高 | Electron 桌面应用、CLI 本地工具、小型单机脚本与单元测试 |
| MongoDB | 面向文档的 NoSQL(BSON格式) | mongodb、Mongoose |
与 JS 对象高度一致、模式灵活多变、天然易于水平扩展 | 内容管理系统(CMS)、敏捷迭代初创产品、复杂多态目录 |
| Redis | 全内存键值与数据结构服务器 | ioredis、redis |
亚毫秒级低延迟响应、原生丰富数据结构、原子操作 | 热点数据缓存、用户会话中心、分布式锁、API 限流与消息队列 |
七、总结
Node.js 的数据库技术选型,本质上是在数据一致性要求、业务模型变化频率、并发读写吞吐以及工程开发效率之间做出权衡:
- 当启动一个注重长期稳定迭代的现代 Web 或 SaaS 后端项目时,PostgreSQL 是当前 Node.js 社区综合满意度最高的主库选型,能够很好地配合 TypeScript 保证全程类型安全。
- 如果团队已有成熟的 MySQL 运维积累或现成服务,MySQL 依然是非常稳妥务实的选择。
- 在面对动态多变、层级深沉的内容数据或原型验证时,MongoDB 能最大化发挥文档模型的灵活性。
- 对于桌面端或独立脚本,SQLite 提供了无需搭建网络服务的极简嵌入体验。
- 而在绝大多数高可用架构中,Redis 则是承担热点缓冲、跨进程会话和并发控制不可或缺的基础件。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章