
详细讲解在Node.js后端环境中解析本地Excel文件(.xlsx/.xls)的核心原理、常用库选型、实战代码与避坑指南,涵盖SheetJS读取、日期与空单元格处理以及大文件流式解析。

当前位置:首页 > Node.js 基础 > 正文
Node.js后端怎么解析本地Excel文件
作者:栖木
时间:2026-10-30
浏览:143
文章目录
在Node.js服务端开发中,解析本地存储的Excel表格(.xlsx 或 .xls)是一项基础且频繁的数据接入需求。其核心解决路径非常明确:通过Node.js底层文件系统接口或专用解析库定位本地文件,将二进制结构解压并解析为工作簿(Workbook)内存模型,再选取指定的工作表(Worksheet),最终提取行列单元格并转换为开发者熟悉的JSON数组或二维矩阵。
一、Excel文件结构与解析技术链路
现代Excel文件(.xlsx)本质上是一个遵循OpenXML规范的ZIP压缩包,其内部由定义工作表关系的XML文件、样式表和集中存储文字的共享字符串表(Shared Strings)组合而成。在Node.js中直接读取原始文件,需要经历解压缩、XML语义流解析以及单元格类型转换这三个底层环节。
为了免除繁重的底层XML操作,社区主要采用两类经过实践验证的解析方案:一是以轻量高效著称的 xlsx(即SheetJS),适合绝大部分中小型文件的快速整体载入与转JSON;二是功能更完备且支持事件流的 exceljs,适用于对单元格富文本、样式有特定要求,或者数据量达数十万行需流式处理防止内存溢出的场景。
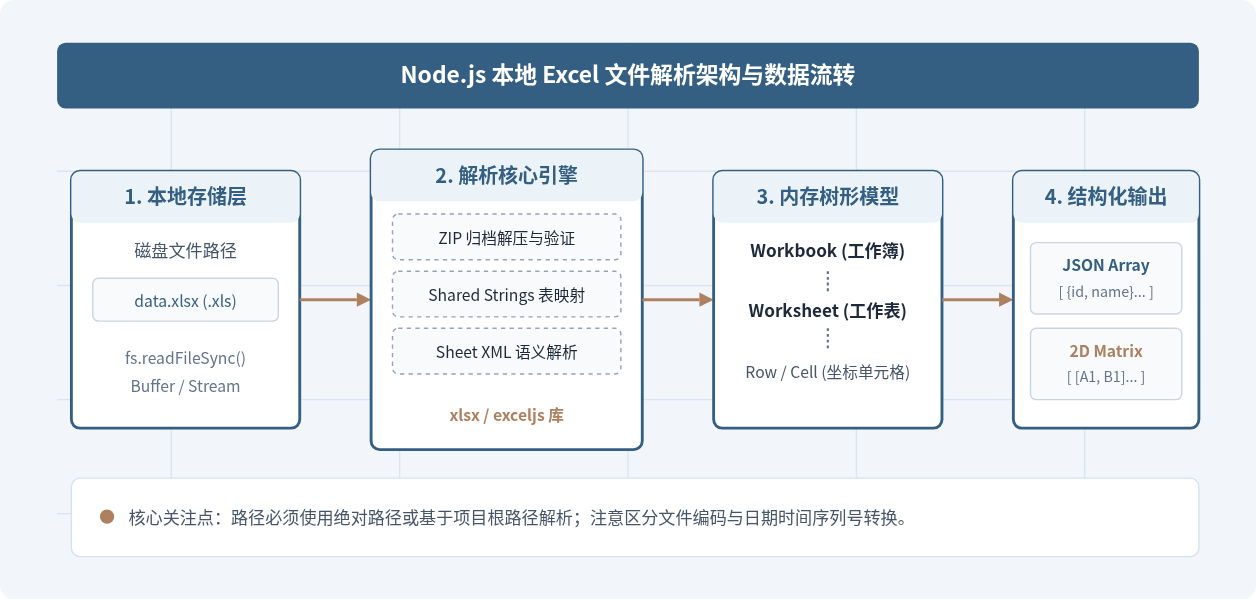
图1:Node.js 本地 Excel 文件从二进制字节流到业务 JSON 对象的四阶转换架构
二、使用 SheetJS (xlsx) 快速解析本地文件
对于大部分常规业务场景(文件通常在几十KB到十数兆字节以内),xlsx 是最精简高效的解析工具。它原生支持直接传入文件物理路径,在同步阻塞或异步操作下一次性构建工作簿。
1. 环境与依赖安装
在你的Node.js工程目录下执行安装命令:
npm install xlsx2. 完整实操代码
在项目中创建脚本文件 parse-local-excel.js,编写如下标准读取逻辑:
const path = require('path');
const fs = require('fs');
const xlsx = require('xlsx');

// 1. 定位本地待解析的 Excel 文件绝对路径
const targetFilePath = path.resolve(__dirname, 'data/users.xlsx');

// 2. 检查本地文件是否存在
if (!fs.existsSync(targetFilePath)) {
  console.error(`错误:目标文件未找到,请确认路径: ${targetFilePath}`);
  process.exit(1);
}

// 3. 读取本地 Excel 文件并构建工作簿对象
// 传入 cellDates: true 可自动将 Excel 内部序列号日期转为 JavaScript Date 对象
const workbook = xlsx.readFile(targetFilePath, {
  cellDates: true,
  dateNF: 'yyyy-mm-dd'
});

// 4. 获取所有工作表名称,并选取目标工作表(默认选取第一张工作表)
const sheetNames = workbook.SheetNames;
console.log('检测到的工作表列表:', sheetNames);

const primarySheetName = sheetNames[0];
const worksheet = workbook.Sheets[primarySheetName];

// 5. 将工作表数据抽取为结构化 JSON 数组(首行为对象属性名)
const jsonData = xlsx.utils.sheet_to_json(worksheet, {
  defval: '', // 遇到空单元格时不跳过,填充为空字符串保证字段完整性
  raw: false   // 格式化输出为最终展现的文本字符串
});

console.log('成功解析的记录数量:', jsonData.length);
console.log('第一条数据预览:', jsonData[0]);
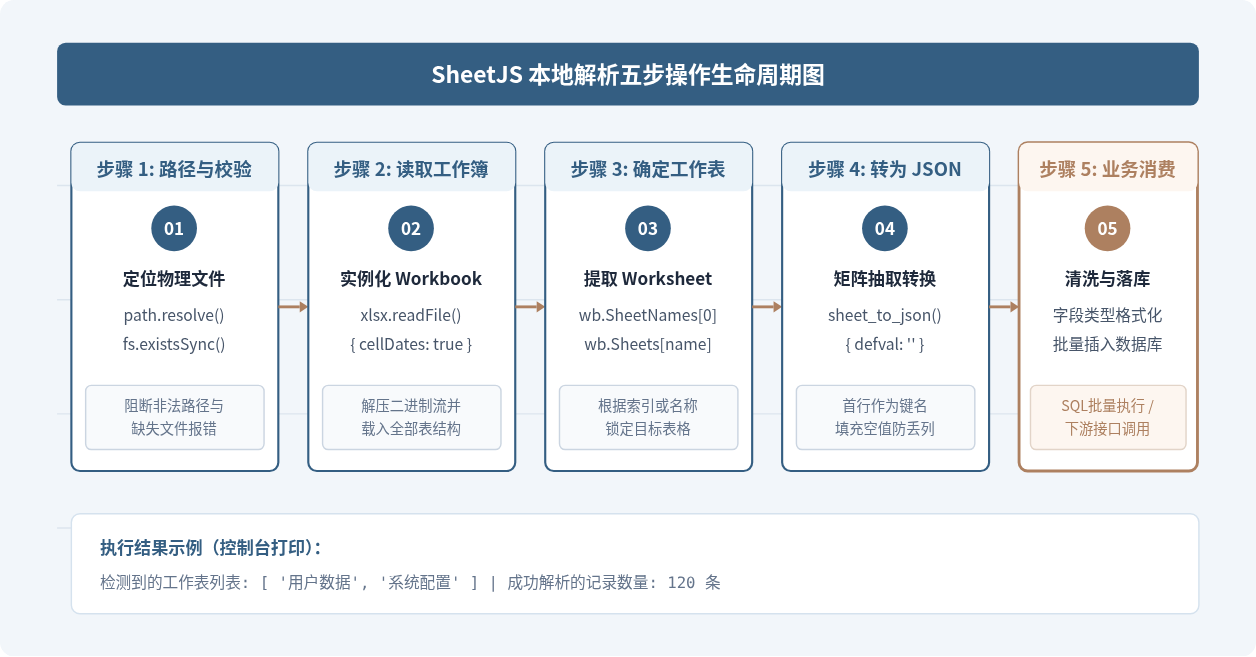
图2:SheetJS 从本地加载到最终交付业务代码的五步执行流程序列图
三、解析本地Excel的关键避坑要点
虽然基础读取只需几行代码,但在生产业务中,Excel数据的灵活性往往会导致各种静默Bug。以下是四个最常见问题的产生机制与对应处理方案。
1. 日期格式解析成浮点数与时区偏移
Excel底层并不存在独立的Date存储类型,而是将日期记录为自1900年1月0日起算的天数序列号(例如 45200.5 代表某个特定时刻)。如果在调用 xlsx.readFile() 时没有显式传入 { cellDates: true },解析结果将直接返回该数字,而非标准时间字符串。
避坑指南:在读取时务必添加 cellDates: true 配置。此外由于不同国家和系统本地时区的影响,生成Date对象后建议使用 date.toISOString() 或自定义工具函数统一转为 YYYY-MM-DD 格式,防止因本地时区差导致“日期少了一天”。
2. 空单元格导致属性键缺失与行对齐错乱
sheet_to_json 默认会将空单元格(null或空白字符)直接忽略。如果某一行第三列为空,该行转换出的对象将直接缺失该属性键。这在进行数据库批量插入时,极易造成字段错位或 undefined 报错。通过显式设置 { defval: '' } 或 { defval: null },可以强制为所有未填充项填入默认值,确保每一行输出的属性键集合完全一致。
3. 大数字精度丢失与科学计数法
在解析身份证号、银行卡号、手机号或大整数ID时,若Excel单元格为“常规”或“数值”格式,超过15位有效数字将触发JavaScript的双精度浮点数溢出,低位自动被抹平为0。针对这类长数字字段,在制作模板时应要求业务人员设为“文本”格式;解析端可通过 raw: false 优先获取格式化展示文本,避免经过数值类型二次转换。
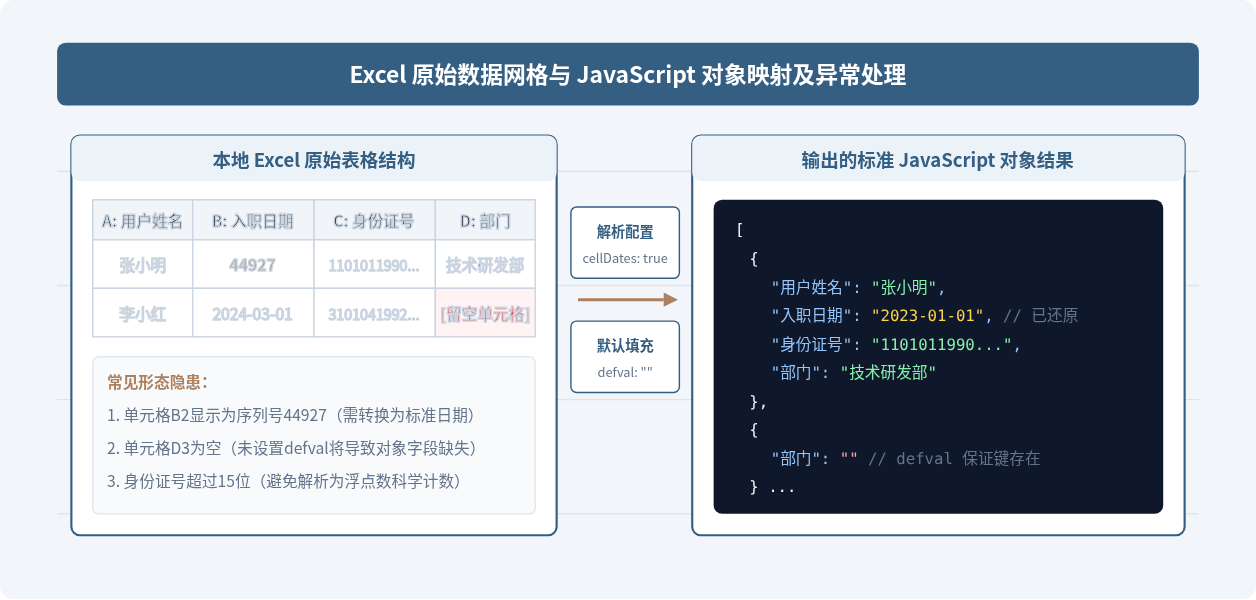
图3:Excel 物理单元格状态到 JavaScript 规整数据模型的映射对照
四、超大文件的进阶处理:ExcelJS 流式读取
当本地Excel文件增长到几十兆字节(行数超过10万至100万行)时,一次性将整个工作簿加载进内存会导致Node.js堆内存迅速暴涨,极易触发 JavaScript heap out of memory 进程崩溃。针对大文件场景,必须采用事件驱动的流式读取(Stream Reader)。
1. 安装 ExcelJS
npm install exceljs2. 流式逐行处理代码
使用 exceljs 提供的流式工作簿读取器,每次仅将当前行载入内存,处理完毕后即可垃圾回收,将内存占用稳定在极低水平:
const path = require('path');
const ExcelJS = require('exceljs');

async function parseLargeExcelStream(filePath) {
  // 1. 初始化流式工作簿读取器
  const workbookReader = new ExcelJS.stream.xlsx.WorkbookReader(filePath, {
    entries: 'emit',
    sharedStrings: 'cache', // 缓存共享字符串表,大幅提升后续解析速度
    worksheets: 'emit'
  });

  let totalProcessedRows = 0;
  let headers = [];

  // 2. 异步迭代读取工作簿内部实体
  for await (const worksheetReader of workbookReader) {
    console.log(`正在读取工作表: ${worksheetReader.name}`);

    // 逐行异步遍历工作表
    for await (const row of worksheetReader) {
      // 第一行提取为表头 Key 集合
      if (row.number === 1) {
        headers = row.values.slice(1); // row.values 索引从1开始
        continue;
      }

      // 获取当前行各单元格值并构造业务对象
      const rowValues = row.values.slice(1);
      const rowData = {};
      headers.forEach((key, index) => {
        rowData[key] = rowValues[index] !== undefined ? rowValues[index] : null;
      });

      totalProcessedRows++;

      // 此处可执行批量入库(例如每累积 1000 条批量写一次 MySQL)
      if (totalProcessedRows % 10000 === 0) {
        console.log(`已流式处理 ${totalProcessedRows} 行数据...`);
      }
    }
  }

  console.log(`大文件解析完毕,累计处理行数: ${totalProcessedRows}`);
}

const largeFilePath = path.resolve(__dirname, 'data/large-dataset.xlsx');
parseLargeExcelStream(largeFilePath).catch(console.error);
五、技术选型决策与排错清单
在进行Node.js后端架构设计时,应根据业务文件特征与操作目的选择恰当的库与解析策略,具体差异与决策路径如下图与表格所示:
| 对比维度 | SheetJS (xlsx) | ExcelJS (标准模式) | ExcelJS (流式模式) |
|---|---|---|---|
| 核心优势 | 调用极简、解析速度快、API直接 | 支持单元格复杂样式、公式与批注 | 内存占用恒定低、抗突发OOM风险 |
| 适用文件大小 | 适合 < 20MB 的中小型表格 | 适合 < 15MB 需保留样式的表格 | 适合 20MB ~ 500MB+ 的大体量数据 |
| 内存机制 | 全量装入堆内存(DOM树) | 全量装入堆内存(对象图复杂) | 事件流式处理,行级回收 |
| 典型场景 | 管理后台常规配置导入、用户列表导入 | 模板导出回填、带格式的报表二次编辑 | 海量交易流水对账、日志数据离线批量入库 |
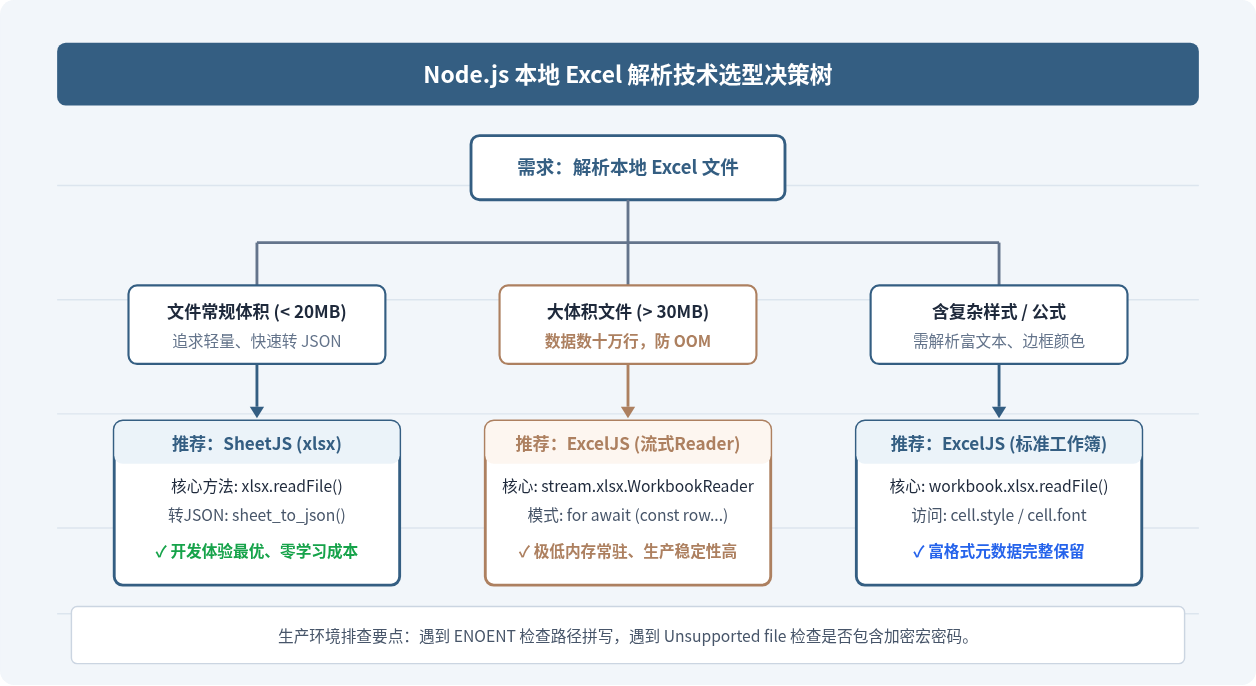
图4:Node.js 后端解析本地 Excel 文件的全场景选型与架构决策树
常见运行时排查清单
- 报错
Error: ENOENT: no such file or directory:通常是由于使用相对路径(如./data.xlsx)时,当前执行上下文的process.cwd()并非脚本所在目录。解决方案是统一使用path.resolve(__dirname, '相对路径')构建绝对定位。 - 报错
Unsupported file key...或文件损坏提示:表明目标文件可能是被损坏的假Excel(例如某些系统直接将HTML或CSV修改后缀名为.xlsx导出),此时需确认文件真实MIME类型,或通过十六进制文件头判断其签名是否为标准ZIP(50 4B 03 04)。 - 多Sheet场景遗漏数据:不要直接写死
workbook.SheetNames[0],业务如果要求合并多Sheet数据,可通过workbook.SheetNames.forEach(name => { ... })遍历收集。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章