
深入分析JavaScript在浏览器和Node.js环境中读取Excel与CSV文件出现中文乱码的根源,提供针对编码不匹配与二进制误读的完整排查步骤、代码方案与防乱码规范。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript读取Excel出现中文乱码怎么解决
作者:函数茶馆
时间:2026-10-30
浏览:93
文章目录
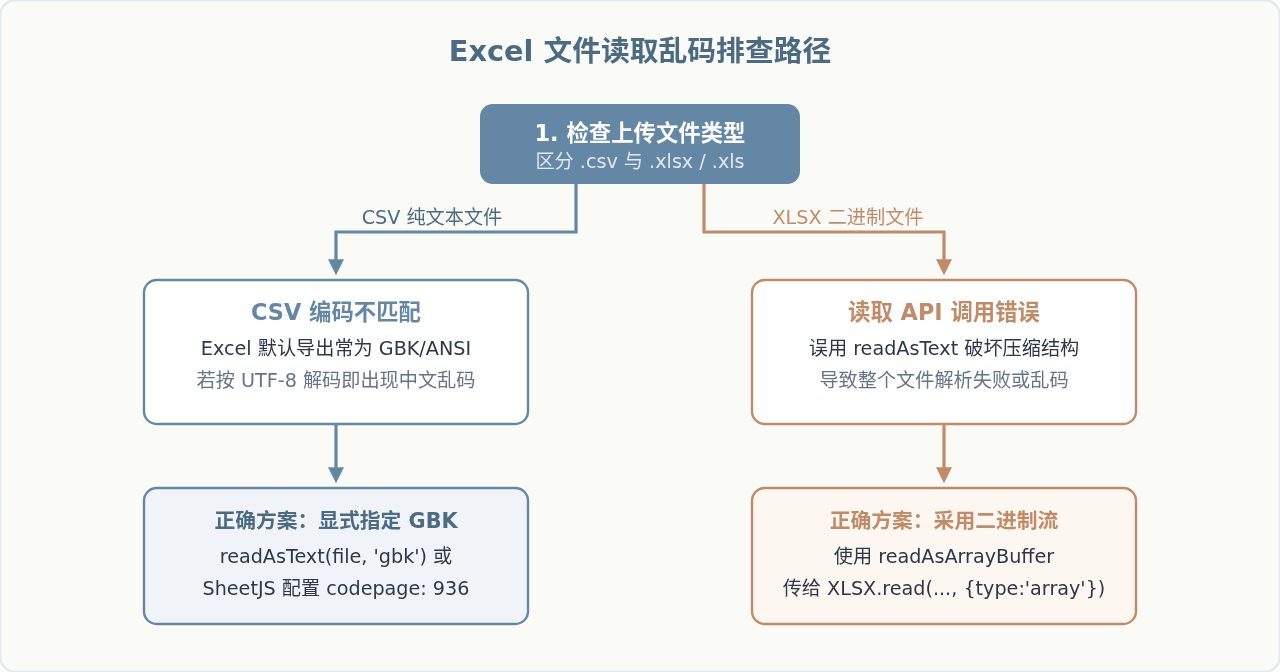
JavaScript 读取 Excel 文件出现中文乱码,核心原因只有两个:一是文件本身属于以 ANSI/GBK 编码存储的文本型表格(如 CSV),而在前端被默认当作 UTF-8 进行字符解码;二是对标准 .xlsx 这种 Zip 压缩格式的二进制文件使用了错误的纯文本读取方法(如 readAsText)。只要查明文件真实存储形式,并在读取时正确指定编码或切换为二进制读取模式(readAsArrayBuffer),乱码问题就能彻底解决。
一、排查起点:确认文件真实格式与读取模式
日常工作中通常把两类完全不同的文件统称为“Excel”:一类是由 Excel 生成的逗号分隔纯文本文件(.csv);另一类是标准的 Office Open XML 压缩二进制文件(.xlsx 或 .xls)。两者的解析通路完全不同,错误的读取方式必然直接导致乱码。
二、原因剖析:为什么中文会变成乱码
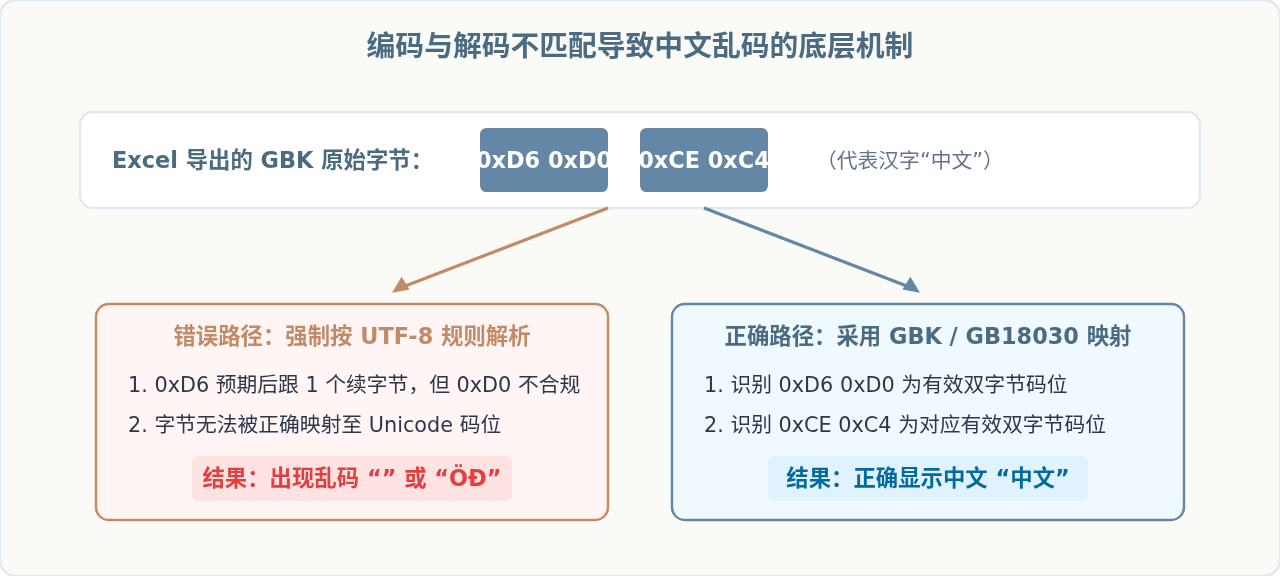
计算机在底层存储文件时全为原始二进制字节(Byte)。字符如何在屏幕上显示,取决于解码表将哪几个字节映射为哪一个汉字:
- GBK / GB2312 编码:在中文 Windows 系统下,微软 Excel 导出 CSV 文件时默认采用系统本地字符集(Windows-936 / GBK)。在 GBK 中,一个常见汉字占用 2 个字节(例如汉字“中”存储为十六进制
D6 D0)。 - UTF-8 编码:现代网页与 JavaScript 运行环境的默认字符集。在 UTF-8 中,绝大部分常用汉字占用 3 个字节(例如“中”存储为
E4 B8 AD)。 - 错位解码产生乱码:当浏览器或 Node.js 环境使用默认的 UTF-8 解码器去解析由 2 字节构成的 GBK 字符时,字节序不满足 UTF-8 变长前缀规则,解码器无法匹配有效字符,就会生成乱码符号(如“”或“ÖД等典型字符拼合)。
三、场景一实操:原生 FileReader 读取 CSV 乱码的解决
如果是纯前端利用 HTML5 原生 FileReader API 读取 CSV 格式的表格文件,解决乱码主要有两种方式:
方法 1:利用 readAsText 的指定编码参数
FileReader.prototype.readAsText(blob, encoding) 允许传入第二个参数来指定字符集,默认为 "UTF-8"。直接传入 "GBK" 或 "GB18030" 即可按中文编码解码:
// 针对在 Windows Excel 导出的 CSV 文件
const reader = new FileReader();

reader.onload = function(e) {
  const textContent = e.target.result;
  console.log("解析成功的文本:\n", textContent);
};

// 关键点:显式传入 'gbk' 或 'gb18030'
reader.readAsText(file, 'gbk');
方法 2:使用 readAsArrayBuffer 配合 TextDecoder
在较新的浏览器标准中,推荐先将文件读取为原始字节数组(ArrayBuffer),再使用原生 TextDecoder API 进行解码。这种方式可以灵活处理动态编码探测与降级尝试:
function readCSVFile(file) {
  const reader = new FileReader();

  reader.onload = function(e) {
    const buffer = e.target.result;

    // 先尝试以 UTF-8 解码,开启 fatal: true 模式遇到异常字节会报错
    try {
      const utf8Decoder = new TextDecoder('utf-8', { fatal: true });
      const content = utf8Decoder.decode(buffer);
      console.log("以 UTF-8 成功解析:", content);
    } catch (err) {
      // UTF-8 解码失败,平滑降级为 GBK 解码
      const gbkDecoder = new TextDecoder('gbk');
      const content = gbkDecoder.decode(buffer);
      console.log("自动降级为 GBK 成功解析:", content);
    }
  };

  reader.readAsArrayBuffer(file);
}
四、场景二实操:使用 SheetJS (xlsx.js) 时的乱码排查与配置
在主流前端项目中,解析 Excel 大多依赖开源库 SheetJS (xlsx)。在引入 SheetJS 后,乱码通常由以下两个环节引起:
避坑关键:绝不能对 .xlsx 文件执行 reader.readAsText()!.xlsx 内部是一个 Zip 压缩包,强行用文本读取会破坏二进制文件结构,使库无法解压并抛出解析异常或出现全是问号与乱码的情况。
1. 正确读取 .xlsx 二进制文件
读取 .xlsx 必须走二进制缓冲通道:
import * as XLSX from 'xlsx';

function handleExcelUpload(file) {
  const reader = new FileReader();

  reader.onload = function(e) {
    const data = new Uint8Array(e.target.result);
    // 关键配置:type 指定为 'array'
    const workbook = XLSX.read(data, { type: 'array' });

    // 获取首个工作表并转换为 JSON
    const firstSheetName = workbook.SheetNames[0];
    const worksheet = workbook.Sheets[firstSheetName];
    const jsonData = XLSX.utils.sheet_to_json(worksheet);

    console.log("解析结果:", jsonData);
  };

  reader.readAsArrayBuffer(file);
}
2. SheetJS 读取 GBK 编码 CSV 的 codepage 配置
如果用 SheetJS 直接解析 CSV,而该 CSV 文件是 GBK 编码的,SheetJS 默认可能会按常规字符表解析。需要显式传入代码页编号 codepage: 936:
// 读取 CSV 文件并指定代码页为 936 (GBK)
const workbook = XLSX.read(data, {
  type: 'array',
  codepage: 936 // 936 代表简体中文 GBK/GB2312
});
五、服务端与工程实践:Node.js 环境处理
在 Node.js 服务端处理上传的表格时,逻辑完全一致。如果是读取本地磁盘或上传流中的 GBK CSV 文件,不能直接以 utf-8 字符串形式读入:
const fs = require('fs');
const iconv = require('iconv-lite');

// 1. 读取为原始 Buffer,不要指定 'utf-8' 编码
const buffer = fs.readFileSync('excel_data.csv');

// 2. 使用 iconv-lite 按照 gbk 编码转为 JavaScript 的 UTF-8 字符串
const str = iconv.decode(buffer, 'gbk');

console.log("解析出的文本内容:\n", str);
六、源头防范:如何彻底避免乱码再次发生
排查与修复属于被动应对,在团队协作和系统设计中,可以通过以下规范从源头杜绝中文乱码:
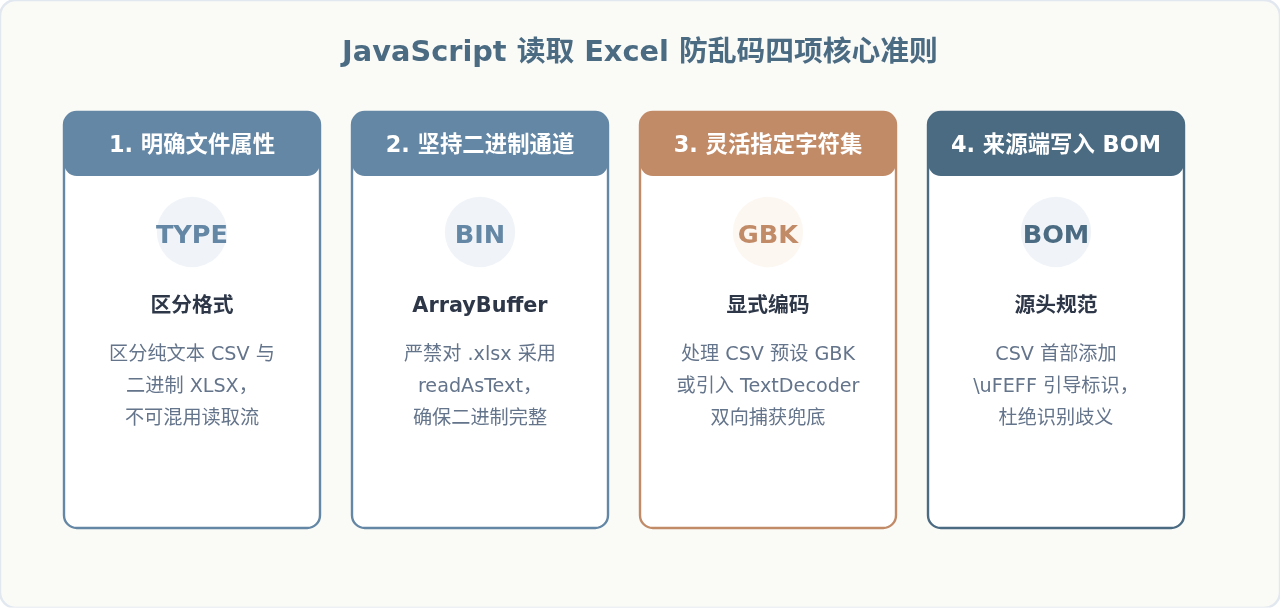
- 导出 CSV 时附加 UTF-8 BOM:如果业务系统需要生成 CSV 供用户在 Excel 中打开,务必在文件字节最开头写入 3 个字节的 BOM(
0xEF, 0xBB, 0xBF)。当 Excel 检测到 BOM 时,就会强制采用 UTF-8 解码,而不会退回到本地 ANSI/GBK。 - 优先推荐使用标准
.xlsx格式:相比纯文本 CSV,.xlsx格式严格标准化了内部 XML 的编码格式(默认均为 UTF-8),只要前端统一使用readAsArrayBuffer,几乎不会受客户端操作系统的区域语言差异影响。 - 前端增加编码容错机制:在解析 CSV 文件时,通过前面提到的
TextDecoder异常捕获策略,先试探 UTF-8,发生异常时自动降级到 GBK。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章