
深入解析 JavaScript 中 Array.prototype.sort() 的默认字符串排序行为、UTF-16 编码机制,以及如何正确编写自定义比较函数处理数值、对象及本地化字符排序。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组sort()默认字符串排序行为及自定义比较函数
作者:拾光
时间:2026-11-22
浏览:282
文章目录
ECMASCRIPT 标准规范
JavaScript 中 Array.prototype.sort() 在未提供任何参数时,并不会按数值大小排序,而是统一将元素转换成字符串,并按照 UTF-16 码元(Code Unit)的字典序进行排列。要获得符合业务预期的排序结果,必须向其传入自定义比较函数。本文将详细剖析默认字典序转换的底层机制、自定义比较函数的决策模型,以及在纯数值、复杂对象和多语言场景下的正确实现。
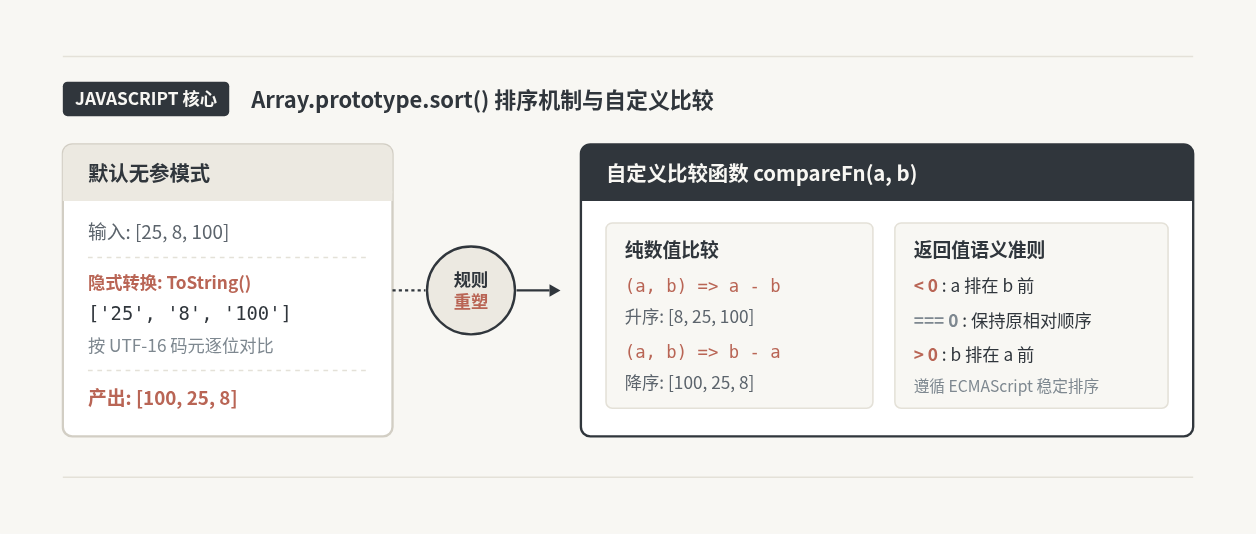
导读概览:Array.prototype.sort() 从默认字典序到自定义比较函数的转变架构
一、默认排序行为:为什么 [25, 8, 100] 会被排成 [100, 25, 8]
在初学 JavaScript 时,最令人费解的现象之一莫过于直接对数值数组调用 .sort()。例如执行以下代码:
const scores = [25, 8, 100];
scores.sort();
console.log(scores);
// 示例输出: [100, 25, 8]
从数学常识来看,8 < 25 < 100,但排序结果却是 100 排在首位,8 反而排在最后。产生该现象的根本原因在于 ECMAScript 规范的定义:
- 隐式字符串转换:当没有传入比较函数(compareFn)时,数组内的每个元素都会通过抽象操作
ToString()转化为字符串。 - UTF-16 码元升序:引擎将转换后的字符串从第一个字符开始,逐位比对其在 Unicode / UTF-16 编码中的十进制数值(即
charCodeAt(index)返回值)。
在 [25, 8, 100] 这个数组中,元素被依次转为 "25"、"8" 和 "100"。引擎在比对它们的首个字符时:
"100"的首字符是'1',对应 UTF-16 码元十进制值为 49(十六进制0x0031);"25"的首字符是'2',对应 UTF-16 码元十进制值为 50(十六进制0x0032);"8"的首字符是'8',对应 UTF-16 码元十进制值为 56(十六进制0x0038)。
因为 49 < 50 < 56,引擎在比较首字符阶段就已经决出了胜负,完全不关心字符串代表的实际数学量级。这就是 "100" 排在 "25" 前面、"25" 排在 "8" 前面的完整原因。
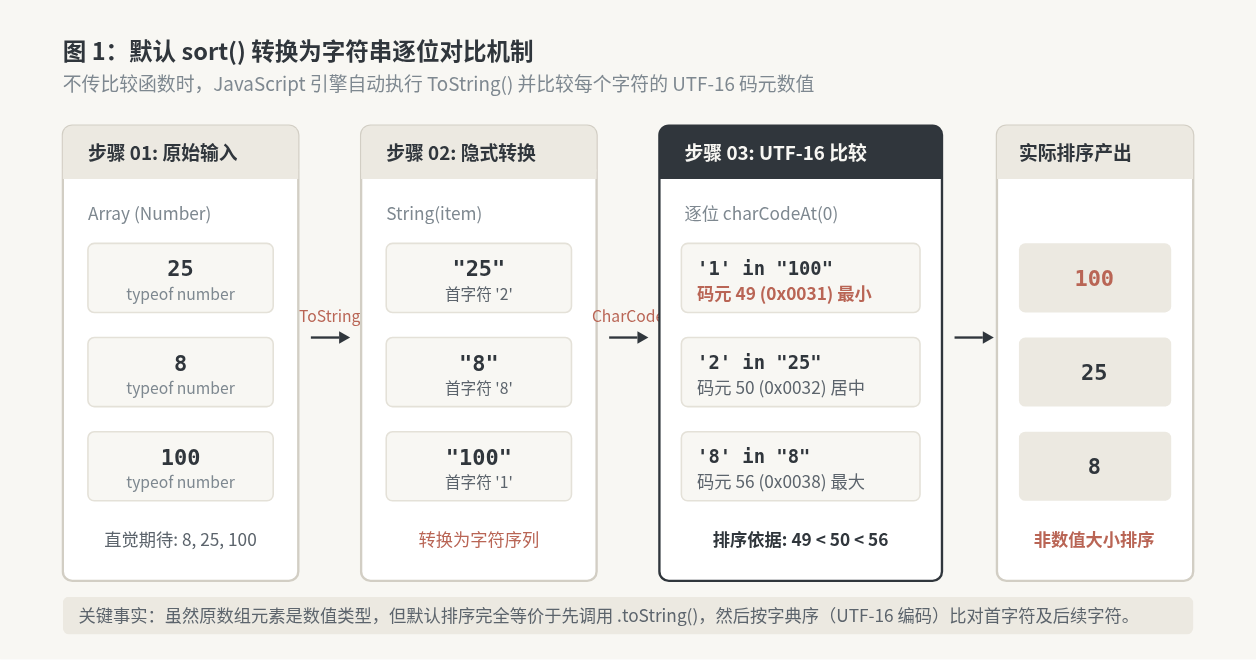
图 1:默认 sort() 转换为字符串逐位对比机制
二、自定义比较函数(compareFn)的工作机制与决策模型
要改变默认的字符串比对行为,开发者需要给 sort() 传递一个比较函数:array.sort(compareFn)。该函数接收两个待比较的元素 a 与 b,并返回一个表示其相对顺序的数值。
ECMAScript 规范对 compareFn(a, b) 的返回值做了严格的三态定义:
| 返回值条件 | 语义判定 | 排序决策 |
|---|---|---|
compareFn(a, b) < 0(负数) |
元素 a 小于 b |
a 将排在 b 之前(不发生后移) |
compareFn(a, b) === 0 |
元素 a 与 b 等价 |
保持 a 和 b 的相对位置不变(ES2019+ 稳定排序) |
compareFn(a, b) > 0(正数) |
元素 a 大于 b |
b 将排在 a 之前(元素调换位置) |
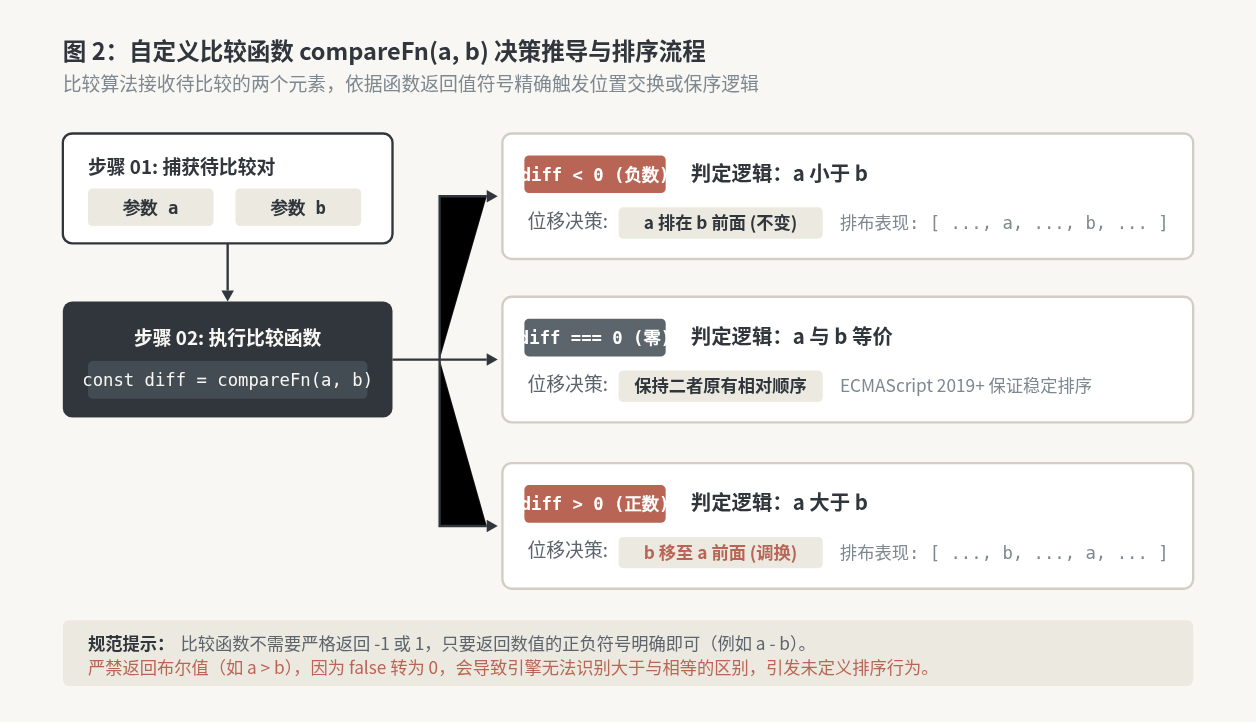
图 2:自定义比较函数 compareFn(a, b) 决策推导与排序流程
算法稳定性保证(Stable Sort)
在 ECMAScript 2019(ES10)之前,语言规范并未强制要求 sort() 必须是稳定的,不同浏览器(如早期的 V8 针对短数组使用插入排序,长数组使用快速排序)在面对返回值等于 0 的元素时可能打乱原有的相对顺序。自 ES2019 起,规范强制要求 Array.prototype.sort 必须采用稳定排序算法(主流引擎均采用 Timsort)。这意味着如果两个元素的比较结果为 0,它们在排完序后的相对位置必然与排序前完全一致。
提示:比较函数不需要只返回
-1、0 或 1。任何正负浮点数或整数都被合法接受,引擎只通过符号判断方向。但严禁返回布尔值(如 a > b),因为 false 会被强制转换为 0,从而导致引擎误以为两个不等元素是等价的。
三、数值排序实践与常见陷阱排查
1. 基础数值排序标准写法
对于纯数字数组,最常用也是最直观的写法是利用算术差值:
const numbers = [25, 8, 100, 3];

// 升序排序 (Ascending): 小到大
numbers.sort((a, b) => a - b);
console.log(numbers);
// 示例输出: [3, 8, 25, 100]

// 降序排序 (Descending): 大到小
numbers.sort((a, b) => b - a);
console.log(numbers);
// 示例输出: [100, 25, 8, 3]
2. 减法运算的陷阱与防御性写法
虽然 a - b 在大多数日常开发场景下足够简洁有效,但在极端数值或异常数据参与时,直接相减存在两个潜在隐患:
- 无穷大计算产生 NaN:当数组中包含
Infinity与-Infinity时,Infinity - Infinity的计算结果为NaN。一旦比较函数返回NaN,排序算法的传递性被打破,会导致数组输出顺序错乱。 - 大数精度截断:当数值超过 JavaScript 的安全整数边界(
Number.MIN_SAFE_INTEGER与Number.MAX_SAFE_INTEGER)时,浮点差值运算可能丢失精度。
在需要极高稳健性的通用工具库中,更稳妥的做法是使用全比较(三元判断):
function safeNumberAsc(a, b) {
  if (a < b) return -1;
  if (a > b) return 1;
  return 0;
}
关于 undefined 和空位(Empty Slots):
在 JavaScript 中,数组中的
undefined 元素以及稀疏数组的空位不会被传入 compareFn。规范规定它们永远会被统一移动到数组的末尾。
四、进阶应用:字符串本地化排序与多属性对象排序
1. 字符串的真实自然排序:localeCompare
默认的字符串排序仅基于 ASCII/Unicode 码点大小,在遇到带重音字母(如德语、法语)、自然文件命名(如 file2.txt 与 file10.txt)或中文拼音排序时,默认字典序将无法满足业务需要。
此时应当搭配 String.prototype.localeCompare():
const names = ["张三", "李四", "王五", "阿强"];

// 按照中文拼音首字母正序排列
names.sort((a, b) => a.localeCompare(b, 'zh-CN'));
console.log(names);
// 示例输出: ["阿强", "李四", "王五", "张三"]

// 自然数字混排 (让 "file2" 排在 "file10" 之前)
const files = ["file10.txt", "file2.txt", "file1.txt"];
files.sort((a, b) => a.localeCompare(b, undefined, { numeric: true }));
console.log(files);
// 示例输出: ["file1.txt", "file2.txt", "file10.txt"]
2. 复杂对象数组的多字段优先级排序
在管理端或电商列表中,经常需要复合排序规则:例如“先按用户权限等级升序,若权限相同则按积分降序,积分相同再按姓名拼音正序”。
利用 JavaScript 逻辑或运算(||)的短路求值特性,可以写出极其优雅且高效的管道式比较函数:
const members = [
  { name: "李四", roleLevel: 1, score: 88 },
  { name: "张三", roleLevel: 1, score: 95 },
  { name: "王五", roleLevel: 2, score: 90 }
];

members.sort((a, b) => {
  // 1. 权限升序
  const levelDiff = a.roleLevel - b.roleLevel;
  // 2. 积分降序
  const scoreDiff = b.score - a.score;
  // 3. 姓名拼音升序
  const nameDiff = a.name.localeCompare(b.name, 'zh-CN');

  // 依次短路:当前者非 0 时直接返回结果,为 0 则进入下一级评判
  return levelDiff || scoreDiff || nameDiff;
});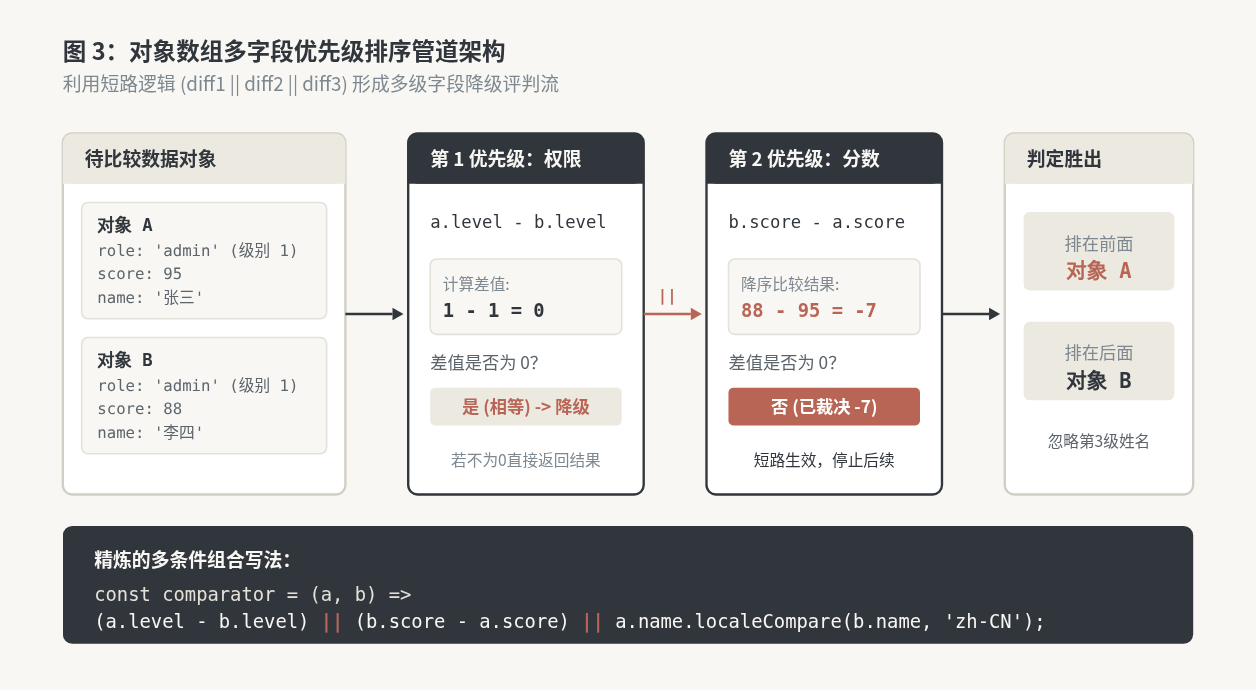
图 3:对象数组多字段优先级排序管道架构
五、原地修改副作用与现代解决方案
Array.prototype.sort() 是一个具有破坏性(Destructive)的就地修改方法(In-place Algorithm)。它不仅返回排序后的数组,同时会直接改变原数组本身:
const original = [3, 1, 2];
const sorted = original.sort((a, b) => a - b);

console.log(original === sorted); // true (返回同一个引用)
console.log(original);           // [1, 2, 3] (原数组已被修改!)
在 React、Vue 等推崇单向数据流和不可变状态(Immutability)的框架中,直接对组件状态进行 .sort() 会引发严重的状态污染或导致组件不重新渲染。针对原地修改的副作用,开发者有两种标准解法:
- 浅拷贝后排序(经典做法):
const safeSorted = [...original].sort((a, b) => a - b); - ES2023 新标准方法 toSorted():ECMAScript 2023 引入了非破坏性排序方法
Array.prototype.toSorted(),它在底层自动克隆原数组并返回全新有序实例,完全不影响原数组。// 现代浏览器与 Node.js 20+ 原生支持 const safeList = original.toSorted((a, b) => a - b);
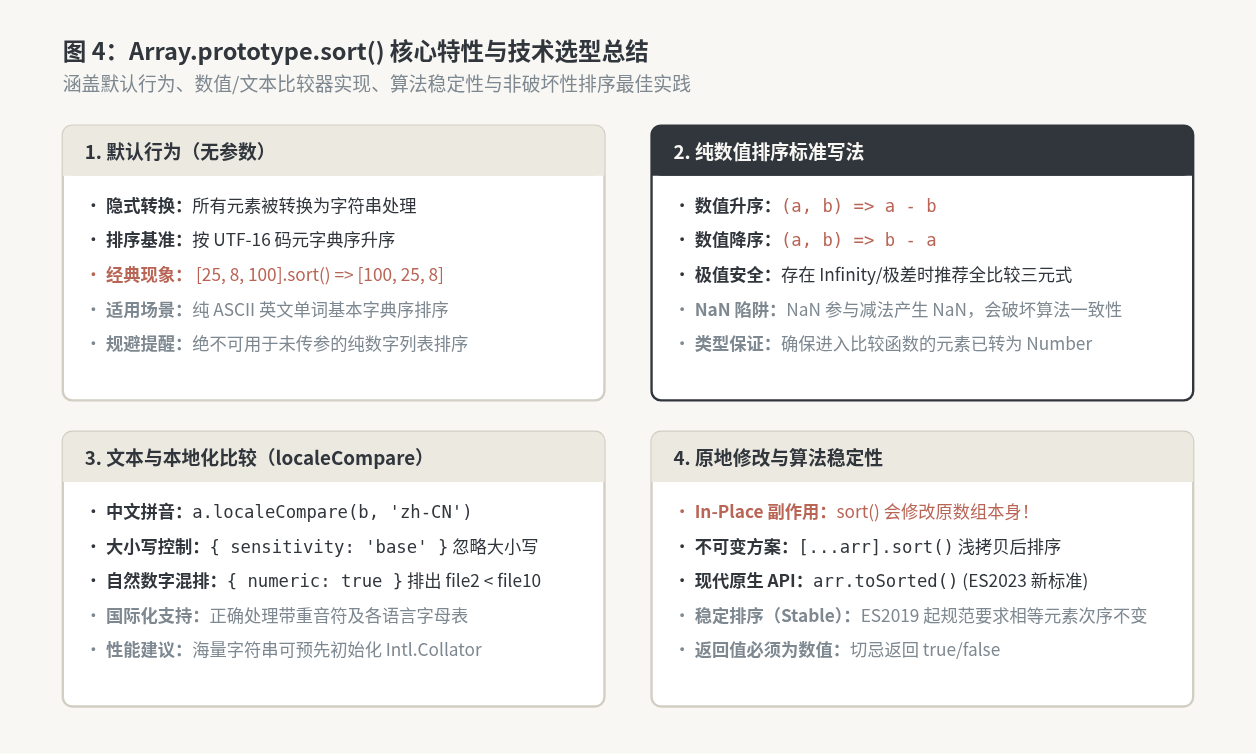
图 4:Array.prototype.sort() 核心特性与技术选型总结
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章