
深入讲解JavaScript中动态计算HTML表格rowspan属性实现相邻行合并的算法与实践,涵盖数据预计算模型、级联依赖处理、DOM与组件库对接及性能优化。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS动态计算rowspan实现表格行合并算法
作者:拾光
时间:2026-11-22
浏览:665
文章目录
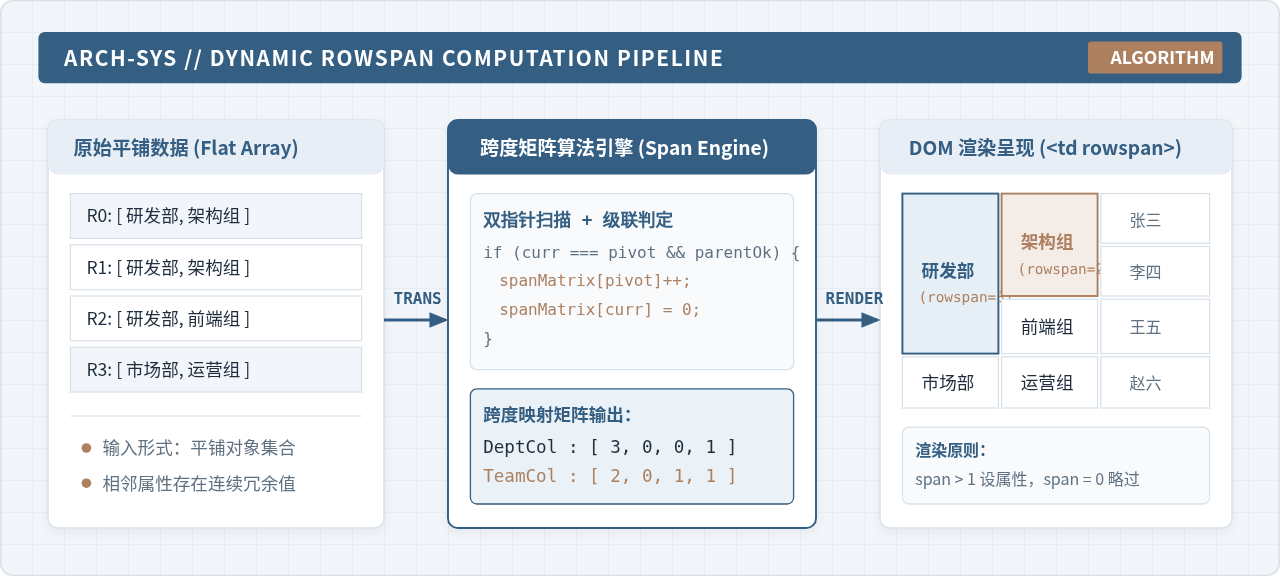
在前端报表和管理系统开发中,平铺的二维数据集往往包含大量连续重复的分类信息(例如部门、城市、业务大类)。使用 HTML
<td rowspan="N"> 进行单元格合并,能够将同类数据在纵向聚合呈现。实现动态 rowspan 的工程核心不是在页面渲染完成后直接遍历 DOM 节点进行增删,而是通过建立「跨度映射矩阵(Span Matrix)」在渲染前完成平铺数组的单遍扫描与推导。本文将系统拆解单列滑动窗口统计、多列级联依赖控制算法,并给出原生 DOM 与主流 UI 框架的工程化接入标准。
一、HTML rowspan 渲染机制与数据模型映射
在 HTML 表格的排版规则中,rowspan 属性控制当前单元格沿垂直方向向下跨越的物理行数。当第一行的 <td> 声明了 rowspan="k"(k > 1)时,渲染引擎会自动扩展其高度,占用接下来的 k - 1 行在对应列的槽位。
这一机制带来了一项不可违背的刚性排版法则:在被跨越的后续 k - 1 行中,对应列的 <td> 元素必须被物理移除或在模板中主动跳过。如果后续行依然输出了 <td>,表格排版引擎便会将该行的其他单元格依次向右推移,造成严重的列错位(Cell Displacement)。
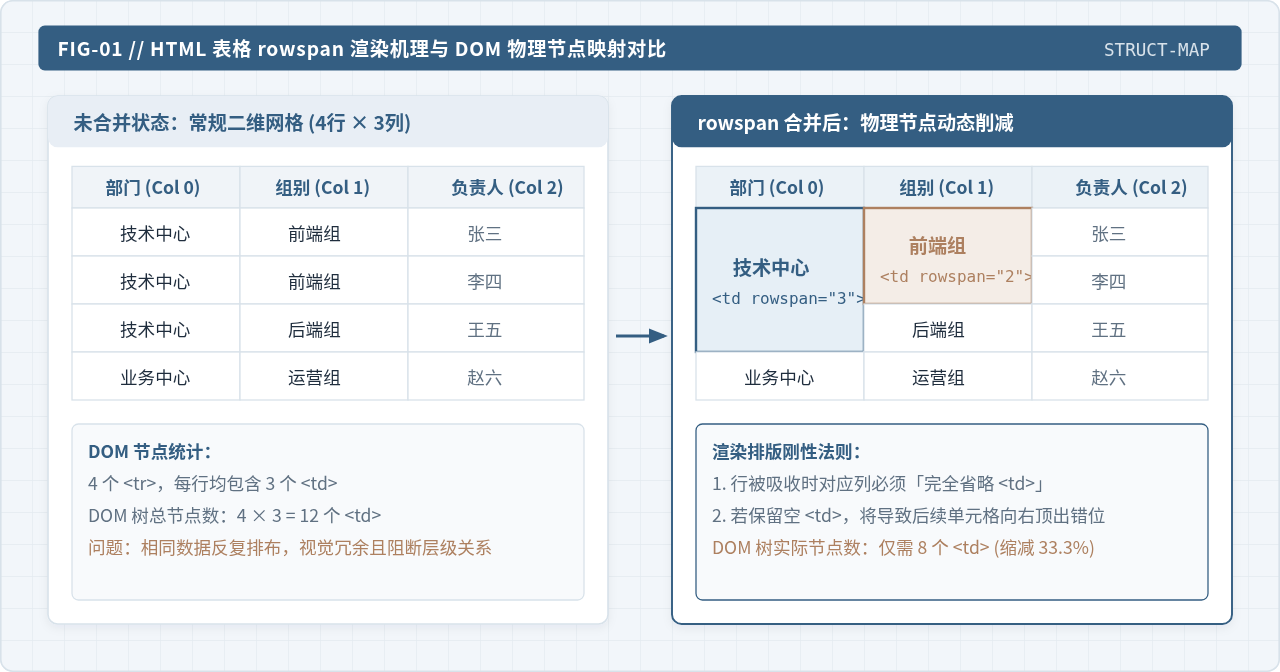
为了在不破坏前端单向数据流的前提下支持高性能渲染,算法的核心思路是将原始数组转化为并行的「跨度数组(Span Array)」。对于长度为 M 的数据集合,每列生成一个长度同样为 M 的整型数组:
- 首行合并点(Pivot Row):记录实际跨越的行数
k(例如rowspan = 3); - 被吸收行(Absorbed Rows):记录跨度值为
0,渲染器读取到0时直接跳过该单元格的创建; - 独立未合并行(Single Row):跨度值为
1,正常输出单个<td>。
二、单列连续重复值合并算法实现
单列合并算法的目标是检测指定字段中连续出现的相同数值,并准确标记每个连续区间的起点与跨度。该算法采用双指针(滑动基准指针与前向扫描指针)结合后向回写技术,时间复杂度为严格的 O(N)。
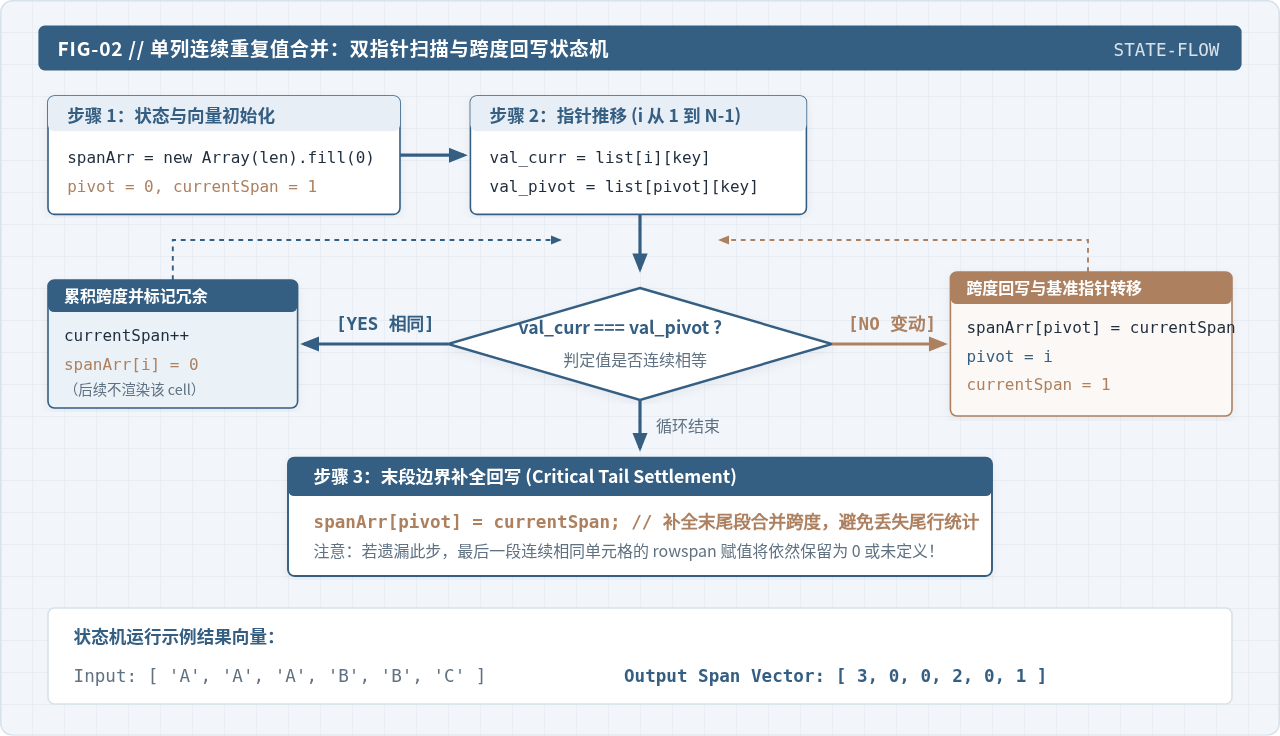
具体计算流程分为四个步骤:
- 初始化状态:创建与列表等长的向量
spanArr并填充为 0。定义基准索引pivotIndex = 0,当前累积跨度currentSpan = 1。 - 遍历对比:指针
i从 1 开始逐行迭代至末尾。将第i行的字段值与第pivotIndex行的基准值对比。 - 分支处理:
- 数值相同:说明处于同一合并组中,跨度累加
currentSpan++,当前行赋值spanArr[i] = 0。 - 数值变化:连续区间中断。先将上一段的累积跨度回写至基准行
spanArr[pivotIndex] = currentSpan;随后转移基准点pivotIndex = i,并将当前跨度重置为currentSpan = 1。
- 数值相同:说明处于同一合并组中,跨度累加
- 尾部边界回写(Critical Tail Settlement):循环退出后,最后一段区间的累积跨度尚未赋值,必须显式执行
spanArr[pivotIndex] = currentSpan,否则末尾组将丢失合并信息。
/**
 * 计算单列的连续相同值合并跨度数组
 * @param {Array<Object>} list - 平铺数据列表
 * @param {string} columnKey - 待合并的字段键名
 * @returns {Array<number>} 跨度数组(元素大于 0 代表渲染的 rowspan,等于 0 代表跳过)
 */
function computeSingleColumnSpan(list, columnKey) {
  const len = list.length;
  if (len === 0) return [];

  // 初始化全 0 跨度数组
  const spanArr = new Array(len).fill(0);
  let pivotIndex = 0;
  let currentSpan = 1;

  for (let i = 1; i < len; i++) {
    const currentValue = list[i][columnKey];
    const pivotValue = list[pivotIndex][columnKey];

    if (currentValue === pivotValue) {
      // 连续重复:跨度递增,当前行标记为 0(不渲染)
      currentSpan++;
      spanArr[i] = 0;
    } else {
      // 遇到不同值:结算上一区间的跨度
      spanArr[pivotIndex] = currentSpan;
      // 重置基准指针与初始跨度
      pivotIndex = i;
      currentSpan = 1;
    }
  }

  // 必须处理循环结束后的尾部剩余跨度
  spanArr[pivotIndex] = currentSpan;

  return spanArr;
}

// 示例运行检验
const mockData = [
  { id: 1, department: "研发部", name: "张三" },
  { id: 2, department: "研发部", name: "李四" },
  { id: 3, department: "研发部", name: "王五" },
  { id: 4, department: "市场部", name: "赵六" },
  { id: 5, department: "市场部", name: "孙七" },
  { id: 6, department: "财务部", name: "周八" }
];

const deptSpans = computeSingleColumnSpan(mockData, "department");
console.log("部门列跨度计算结果:", deptSpans);
// 期望输出: [ 3, 0, 0, 2, 0, 1 ]
三、多列级联依赖与层级合并控制
在真实业务报表中,表格通常包含具备树状层级关系的复合维度,例如「省份 -> 城市 -> 区域」或「一级部门 -> 二级团队」。如果直接对每一列独立运行单列合并算法,会产生严重的穿透合并缺陷(False Merging)。
典型场景:假设第 1-2 行是“浙江省 / 朝阳区”,第 3-4 行是“北京市 / 朝阳区”。若仅按字段名“朝阳区”比对,算法会将“朝阳区”识别为 4 行连续相同而合并为一个跨越 4 行的大单元格。然而两者的上级省份完全不同,这会导致北京市的下属机构被错误合并进浙江省的视觉范畴中。
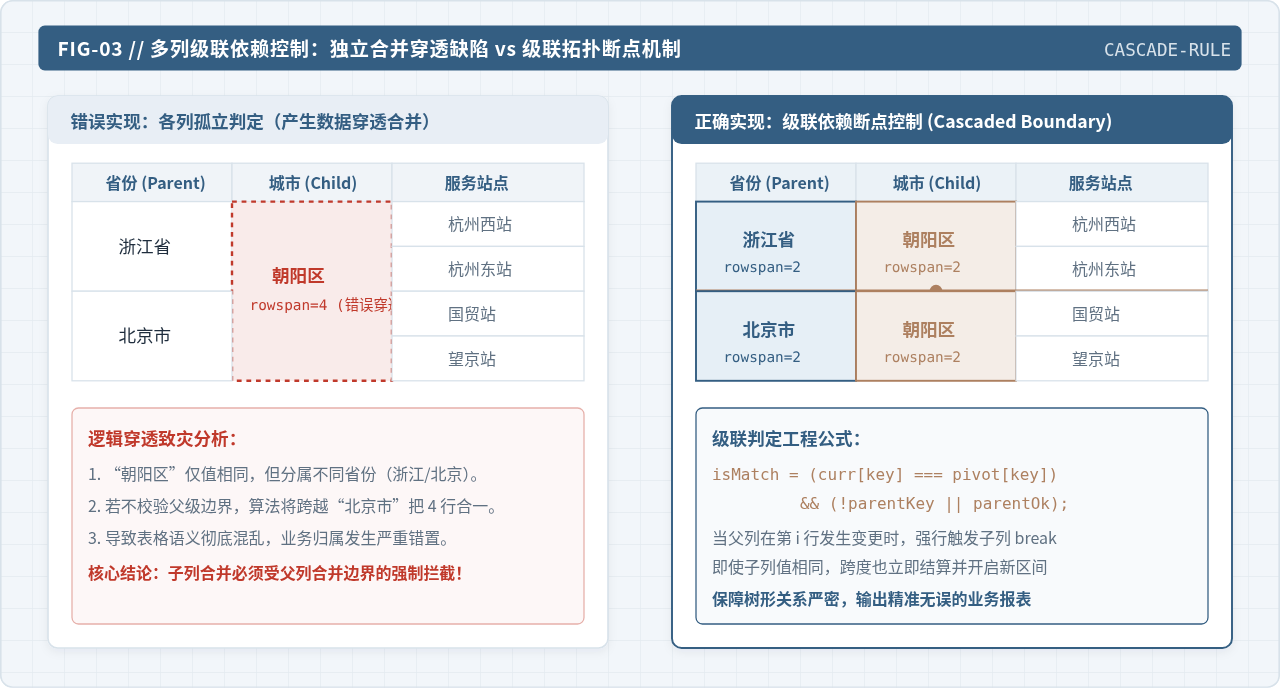
解决该问题的工程规范是引入前置依赖断点判定(Cascading Dependency Constraint)。某列的当前行与基准行能够合并的充要条件是:
级联判定准则
当前列字段值相同 AND 该列所依赖的所有父级列在对应行也必须处于相同的合并区间(即父级未在此处发生截断)。
以下是支持依赖链配置的通用多列跨度计算引擎实现:
/**
 * 多列级联行合并计算引擎
 * @param {Array<Object>} data - 数据集
 * @param {Array<{ key: string, parentKey?: string }>} columnConfigs - 列配置列表(定义字段与依赖父字段)
 * @returns {Record<string, Array<number>>} 每列对应的跨度向量字典
 */
function computeCascadedSpans(data, columnConfigs) {
  const result = {};
  const rowCount = data.length;

  if (rowCount === 0) {
    columnConfigs.forEach(col => (result[col.key] = []));
    return result;
  }

  // 按依赖拓扑自顶向下依次计算
  columnConfigs.forEach(({ key, parentKey }) => {
    const spanArr = new Array(rowCount).fill(0);
    let pivotIndex = 0;
    let currentSpan = 1;

    for (let i = 1; i < rowCount; i++) {
      const isSelfMatch = data[i][key] === data[pivotIndex][key];

      // 级联断点校验:若存在父级列,检查当前行与基准行在父级维度上是否在同一合并块中
      let isParentMatch = true;
      if (parentKey && result[parentKey]) {
        // 在父级列中,如果第 i 行的 span > 0,说明父级在当前行开启了全新合并块,父级已截断
        // 只有当父级在此处仍属于上一块的吸收行(即父级 span 值为 0)或者当前行与 pivot 的父级值相同时才算延续
        isParentMatch = (data[i][parentKey] === data[pivotIndex][parentKey]) && (result[parentKey][i] === 0);
      }

      if (isSelfMatch && isParentMatch) {
        currentSpan++;
        spanArr[i] = 0;
      } else {
        spanArr[pivotIndex] = currentSpan;
        pivotIndex = i;
        currentSpan = 1;
      }
    }

    // 补齐末尾区间
    spanArr[pivotIndex] = currentSpan;
    result[key] = spanArr;
  });

  return result;
}
四、渲染适配实践:原生 DOM 与现代组件库
完成跨度矩阵的计算后,视图层只需要以 O(1) 的时间复杂度直接读取对应的数值,即可决定单元格的输出状态。
1. 原生 HTML/JS 渲染实现
在原生 JavaScript 中,动态构建 <tbody> 时根据跨度值决定是否插入 <td>:
function renderNativeTable(containerId, list, columnsConfig) {
  const spansMap = computeCascadedSpans(list, columnsConfig);
  const container = document.getElementById(containerId);

  let html = '<table class="demo-table"><thead><tr>';
  columnsConfig.forEach(col => {
    html += `<th>${col.title}</th>`;
  });
  html += '</tr></thead><tbody>';

  list.forEach((row, rowIndex) => {
    html += '<tr>';
    columnsConfig.forEach(col => {
      const span = spansMap[col.key] ? spansMap[col.key][rowIndex] : 1;

      // span === 0 说明被前置行合并覆盖,直接省略输出
      if (span === 0) return;

      // span > 1 声明 rowspan 属性,span === 1 为普通单元格
      const rowspanAttr = span > 1 ? ` rowspan="${span}"` : '';
      html += `<td${rowspanAttr}>${row[col.key] ?? ''}</td>`;
    });
    html += '</tr>';
  });

  html += '</tbody></table>';
  container.innerHTML = html;
}
2. 静态表格运行效果验证
将上述算法应用于包含省份、城市、业务站点的多行数据集,计算并渲染出的最终 HTML 表格结构如下:
| 省份 / 直辖市 (Parent) | 行政区域 (Child) | 服务站点编码 | 日均运力 (TEU) |
|---|---|---|---|
| 浙江省 (rowspan=2) | 朝阳区 (rowspan=2) | ST-HZ-001 | 1,420 |
| ST-HZ-002 | 980 | ||
| 北京市 (rowspan=3) | 朝阳区 (rowspan=2) | ST-BJ-101 | 2,150 |
| ST-BJ-102 | 1,870 | ||
| 海淀区 | ST-BJ-201 | 1,630 |
3. 现代 UI 框架(Element Plus / Ant Design)适配
主流组件库均内置了行合并回调接口(例如 Element Plus 的 span-method 和 Ant Design 的 customCell)。严禁在这些回调函数中执行循环查找或重复调用统计函数,否则在表格重绘时会触发 O(Rows × Cols × N) 的高频计算,引发页面卡顿。
标准做法是在获取到响应数据后,一次性计算出 Span 矩阵缓存在组件实例中,回调函数仅作索引查表:
// Element Plus Table: :span-method 接入标准
function handleTableSpanMethod({ row, column, rowIndex, columnIndex }) {
  const targetColKey = column.property;
  // 直接查表,时间复杂度 O(1)
  if (cachedSpanMatrix[targetColKey]) {
    const rowSpan = cachedSpanMatrix[targetColKey][rowIndex];
    return {
      rowspan: rowSpan,
      colspan: rowSpan > 0 ? 1 : 0
    };
  }
  return { rowspan: 1, colspan: 1 };
}

// Ant Design Table: columns.customCell 接入标准
const columns = [
  {
    title: '省份',
    dataIndex: 'province',
    customCell: (record, rowIndex) => ({
      rowSpan: cachedSpanMatrix['province'][rowIndex]
    })
  }
];
五、全流程架构与工程优化总结
为了保证行合并算法在生产环境中的鲁棒性与高执行性能,端到端的数据处理流水线应当遵循清晰的分层架构:
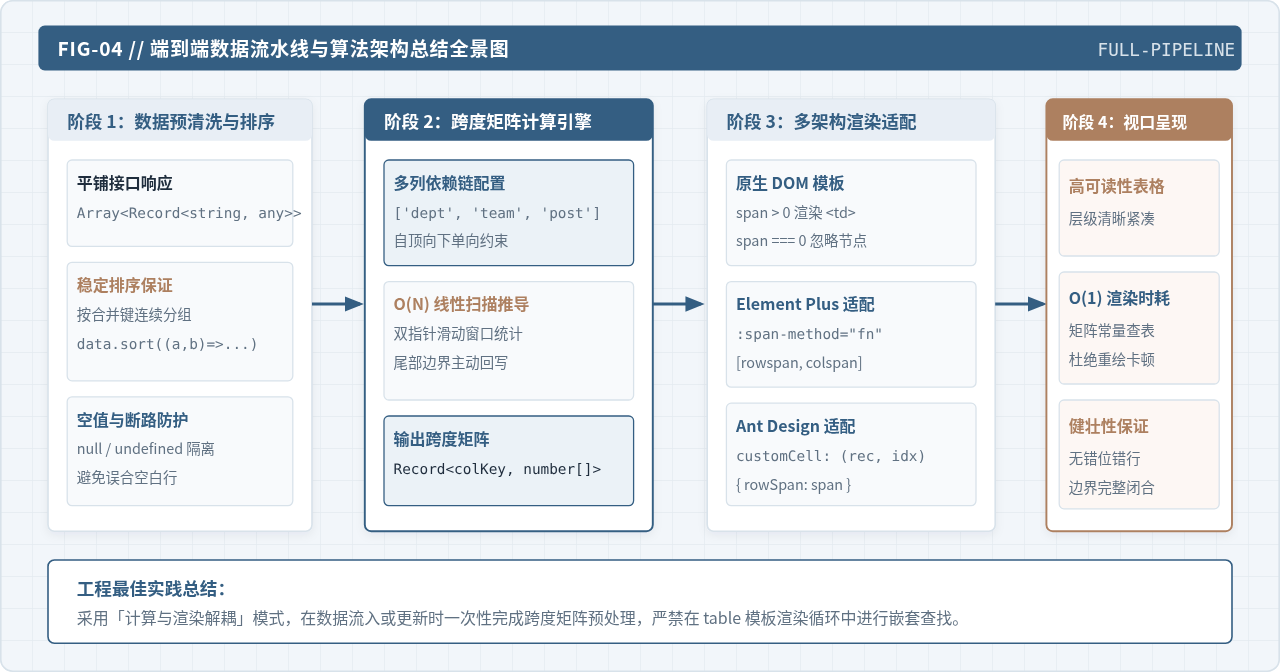
核心工程注意事项
- 稳定预排序前提(Data Ordering):行合并算法的基础假设是「相同的数据在数组中是连续相邻的」。如果原始数据未排序(如交替出现的浙江、北京、浙江),连续值算法将无法将其合并在同一个单元格中。必须确保在送入算法前,数据已经按照依赖键完成了多级稳定排序。
- 空值与非法值防护(Nullish Guard):当数据中包含连续的
null、undefined或空字符串""时,如果不做拦截,算法会将连续的空白行合并为一个巨大的空白单元格。应在比较条件中加入显式判断,对空值默认赋予span = 1,禁止合并无意义空行。 - 分页与虚拟滚动边界(Pagination & Virtual Scroll):HTML 的
rowspan无法穿越分页组件的 DOM 边界。当跨度区间被分页切割时,仅能在当前页内进行局部合并;对于百万级长列表采用虚拟滚动的场景,由于视口外 DOM 节点被销毁,垂直跨行会导致排版错乱,此时应优先考虑树形表格(Tree Table)或折叠面板作为替代方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章