
深入解析Node.js的真实线程架构与libuv线程池工作机制,涵盖主线程事件循环、内核异步多路复用与线程池任务分流、UV_THREADPOOL_SIZE调优与并发排队实测。

当前位置:首页 > Node.js 性能优化 > 正文
Node.js中的线程模型与libuv线程池机制
作者:巡夜人
时间:2026-11-22
浏览:556
文章目录
常说的“Node.js 是单线程的”,严格来说指的是 JavaScript 业务代码的编译执行和事件循环(Event Loop)运行在单一主线程上。然而在底层,Node.js 依托跨平台异步 I/O 引擎 libuv 维护着一套多线程与操作系统内核协同体系:对于网络套接字通信,Node.js 直接依托操作系统底层的事件多路复用(epoll、kqueue、IOCP),完全不占用工作线程;而对于文件读写、密码加解密、压缩及系统级域名解析等无法原生非阻塞化的系统调用,libuv 会将任务分派给其内部的 默认大小为 4 的 C++ 工作线程池(Thread Pool) 排队并发执行。
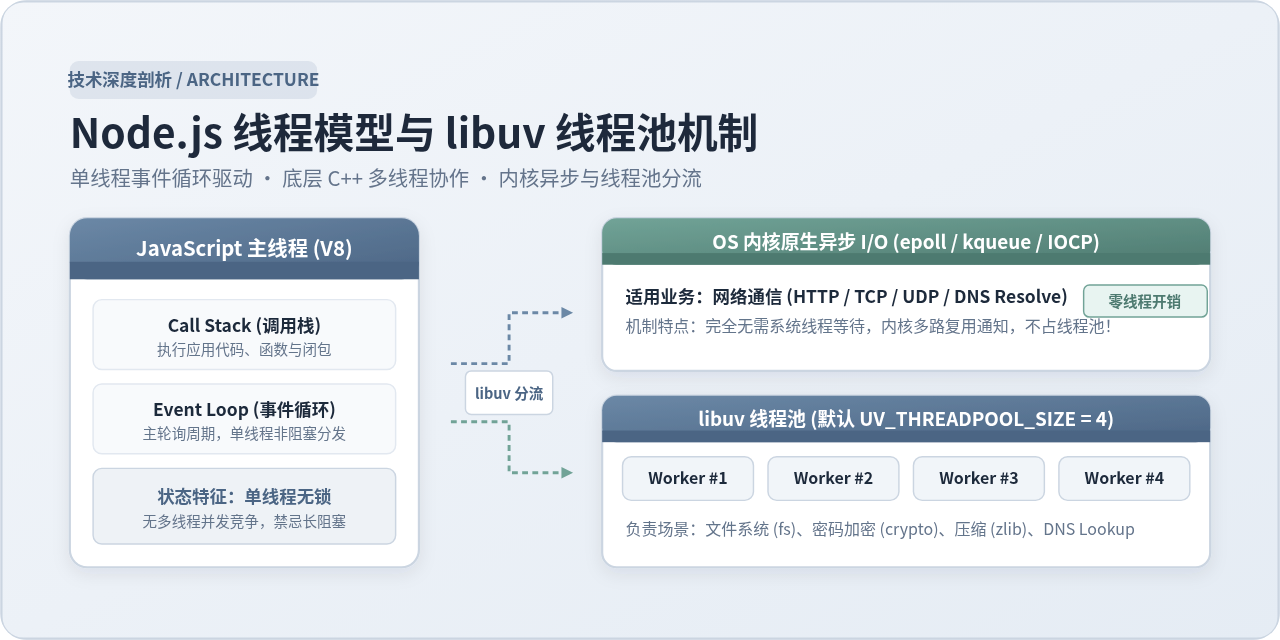
一、核心概念澄清:Node.js 究竟是不是单线程?
在初接触 Node.js 时,“单线程高并发”常常给人一种自相矛盾的错觉。如果只有一个线程,当面对大文件读取或密集计算时,整个服务为何不会直接挂起?要搞清楚这个问题,首先要划清 “JavaScript 执行环境” 与 “Node.js 宿主运行时底层” 的职责边界。
从 V8 引擎和应用开发者的角度看,Node.js 确实是单线程的:
- 单一调用栈(Call Stack):所有的函数调用、作用域创建、变量赋值以及同步代码都在同一个主线程上依次出栈和入栈。这也意味着在任何给定的微秒瞬间,同一进程内只有一段 JavaScript 代码处于运行状态,无需担心传统多线程编程中的数据竞争(Race Condition)和加锁互斥问题。
- 单一事件循环(Event Loop):主线程负责轮询已就绪的 I/O 事件、处理微任务队列(
Promise、process.nextTick)并触发相应的回调函数。
然而,如果把视角下移到 Node.js 的底层 C/C++ 层面,Node.js 进程在操作系统中绝非仅有一个系统线程。启动一个最基础的 node app.js 进程并用系统命令观察,你会发现它通常持有着 6 到 11 个以上的系统原生线程。这些后台线程包括 V8 引擎的垃圾回收辅助线程(GC Threads)、代码即时编译优化线程(Compiler Threads)、libuv 默认预分配的 4 个工作者线程(Worker Threads),以及操作系统用于事件通知的辅助线程。
二、Node.js 分层架构与两种异步执行机制
Node.js 高性能的核心在于其两层分工架构。顶层为 JavaScript 开发者提供简单一致的异步 API(如 fs.readFile()、http.get()),而底层则根据系统资源的物理特性,由 libuv 将异步任务路由到两种截然不同的执行通道中:
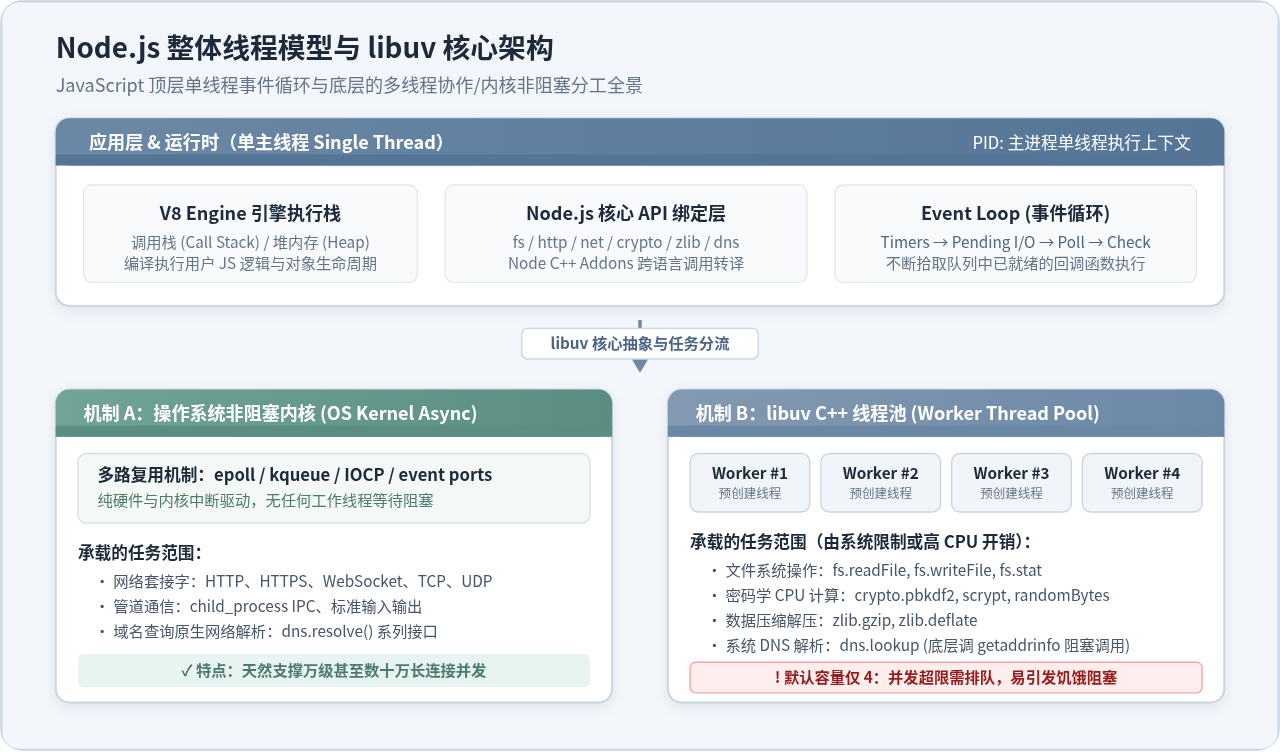
1. 机制 A:操作系统内核非阻塞 I/O(零线程池开销)
现代操作系统内核对网络套接字(Network Sockets)提供了高度成熟的事件就绪通知机制,例如 Linux 的 epoll、macOS/BSD 的 kqueue、Windows 的 IOCP 以及 Solaris 的 event ports。
当我们在 Node.js 中发起 HTTP 请求或监听 TCP 端口时,libuv 仅将对应的 Socket 文件描述符注册到内核的多路复用监听表中,随后主线程继续执行后续业务代码。当数据真正到达网卡并通过内核协议栈就绪后,内核会产生硬件中断并在轮询阶段通知 libuv,libuv 将关联的回调塞入 Poll 阶段队列供主线程拾取。
关键结论:网络 I/O 并不需要工作线程阻塞等待数据传输。一个 Node.js 实例能够维持数万甚至数十万的长连接并发,正是因为网络 I/O 完全绕过了 libuv 线程池,没有产生任何系统线程切换或栈内存消耗。
2. 机制 B:libuv 预分配线程池(包装阻塞式系统调用)
与网络通信不同,操作系统的磁盘文件系统(File System)并不存在统一、高效且跨平台的非阻塞异步规范。虽然 Linux 早期有 AIO,但在不同内核版本和驱动下对常规文件的支持充满限制(如必须满足 O_DIRECT 对齐要求,且依然可能在元数据操作时发生隐式阻塞)。
为了在各大主流操作系统上提供完全一致的 fs.readFile 异步体验,libuv 选择了最可靠的工程方案:在用户态维护一个预先初始化的 C++ 工作线程池(Thread Pool)。当 JavaScript 调用文件异步接口时,底层会将读写操作封装为一个 Work Request 任务,塞入任务队列中;空闲的 Worker 线程认领该任务,以同步阻塞的方式调用底层 C 语言标准库函数(如 open、read、write);任务执行完成后,Worker 线程将结果通知主线程事件循环触发回调。
三、哪些 API 依赖 libuv 线程池?哪些不依赖?
很多开发者容易产生误解,认为只要是异步 API(带 callback 或返回 Promise),都是在 libuv 线程池中跑的。事实并非如此。准确区分哪些 API 走线程池,是进行性能容量评估和排查卡顿的基础。
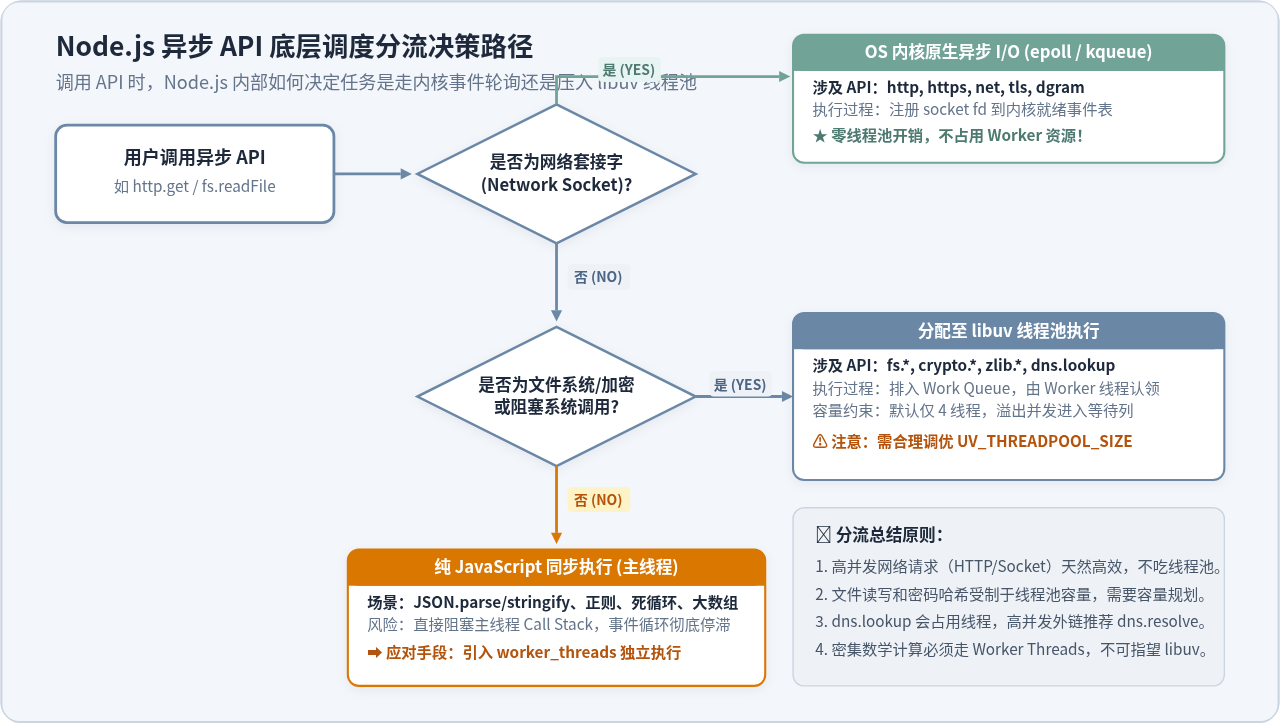
| API 类别与常见方法 | 底层执行机制 | 是否占用 libuv 线程池 | 并发特性与性能瓶颈点 |
|---|---|---|---|
网络通信http, https, net, tls, dgram |
OS 内核多路复用 (epoll / kqueue / IOCP) |
否(零占用) | 极高并发能力;瓶颈在网卡带宽、内存与单核主线程 CPU 解析能力。 |
文件系统fs.readFile, fs.writeFile, fs.stat |
libuv 线程池同步系统调用 | 是 | 受限于 UV_THREADPOOL_SIZE;过高并发会触发任务队列排队。 |
密码哈希计算crypto.pbkdf2, crypto.scrypt, crypto.randomBytes |
libuv 线程池 C++ 密集计算 | 是 | 纯 CPU 密集运算;并发数超过线程池容量时,耗时呈倍数跳增。 |
数据压缩/解压zlib.gzip, zlib.deflate, zlib.brotliCompress |
libuv 线程池 C++ 计算 | 是 | 对大文件或大报文压缩时,可能瞬间占满线程池 Worker。 |
系统域名解析dns.lookup (底层调 getaddrinfo) |
libuv 线程池阻塞调用 | 是 | 系统 libc 的 getaddrinfo(3) 是同步阻塞的,易引发线程池饥饿。 |
原生网络 DNS 查询dns.resolve, dns.resolve4 |
OS 内核套接字 + c-ares 库 | 否(零占用) | 直接通过网络发送 UDP/TCP 报文查询 DNS,不依赖线程池。 |
| 纯 JS 高耗时计算 大数组遍历、JSON 深度解析、复杂正则 |
V8 引擎主线程 Call Stack | 否(阻塞主线程) | 极度危险!直接使整个进程事件循环冻结,需迁移至 Worker Threads。 |
四、动手实测:观察 libuv 线程池的排队与耗时跳变
为了亲眼观察 libuv 线程池的存在及其排队行为,我们可以编写一段简短的脚本,并发调用 5 个高强度的异步密码哈希函数 crypto.pbkdf2。
1. 测试代码设计
创建测试文件 test-threadpool.js,代码如下:
const crypto = require('crypto');

const start = Date.now();
const TASK_COUNT = 5;

for (let i = 1; i <= TASK_COUNT; i++) {
  crypto.pbkdf2('secret-password', 'salt-string', 100000, 512, 'sha512', () => {
    const duration = Date.now() - start;
    console.log(`任务 #${i} 完成,耗时: ${duration} ms`);
  });
}
2. 默认环境执行结果(UV_THREADPOOL_SIZE 默认为 4)
在终端直接执行该脚本:
$ node test-threadpool.js示例输出如下:
任务 #1 完成,耗时: 1021 ms
任务 #2 完成,耗时: 1035 ms
任务 #3 完成,耗时: 1048 ms
任务 #4 完成,耗时: 1052 ms
任务 #5 完成,耗时: 2085 ms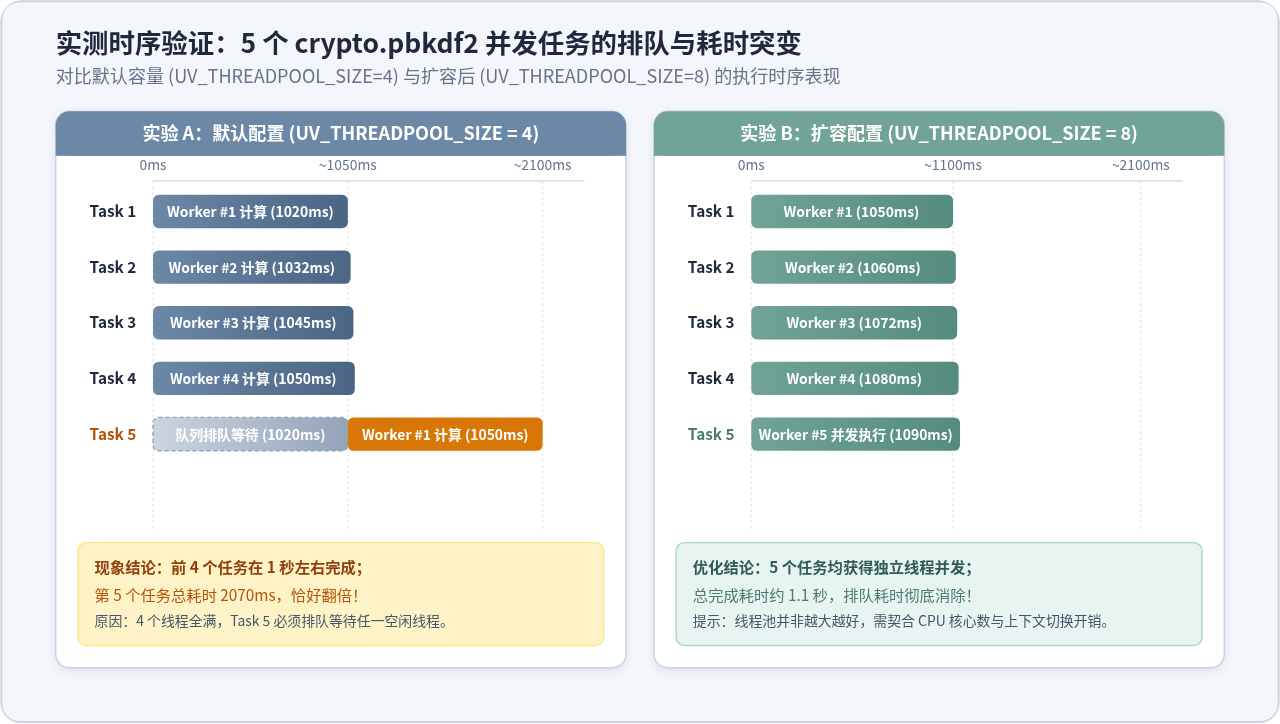
3. 现象原理解析
查看输出可以清晰观察到一个阶梯式突变:前 4 个任务在 ~1050ms 几乎同时执行完毕,而第 5 个任务却耗费了 ~2085ms,耗时正好翻倍。
原因在于:
- 循环启动后,主线程将 5 个任务依次派发给 libuv。
- libuv 线程池默认只预先创建了 4 个工作线程(Worker 1 ~ Worker 4)。
- 前 4 个任务立即各自占据了一个工作线程开始全速计算;而任务 #5 无法获得空闲线程,只能停留在等待队列中处于阻塞挂起状态。
- 约 1020ms 后,Worker 1 最先计算完毕并释放自身,它立即从队列中拾取任务 #5 继续执行。
- 任务 #5 自身的计算需要 1050ms,加上前期排队等待的 1020ms,最终回调触发时间达到了 2085ms。
五、线程池配置与调优:UV_THREADPOOL_SIZE
如果你的服务涉及较多的本地文件 I/O、图片压缩或加解密计算,默认的 4 个线程可能很容易成为吞吐量的硬伤。Node.js 允许通过环境变量 UV_THREADPOOL_SIZE 对线程池容量进行调整。
1. 正确的设置方式
UV_THREADPOOL_SIZE 的有效取值范围为 1 至 1024。必须在 Node.js 启动之前 在操作系统环境中设定:
# Linux / macOS 临时执行
$ UV_THREADPOOL_SIZE=8 node test-threadpool.js

# Linux / macOS 终端全局导出
$ export UV_THREADPOOL_SIZE=8
$ node test-threadpool.js

# Windows PowerShell
$env:UV_THREADPOOL_SIZE="8"
node test-threadpool.js
当使用 UV_THREADPOOL_SIZE=8 node test-threadpool.js 重新运行刚才的测试脚本时,终端输出变为:
任务 #1 完成,耗时: 1050 ms
任务 #2 完成,耗时: 1062 ms
任务 #3 完成,耗时: 1075 ms
任务 #4 完成,耗时: 1083 ms
任务 #5 完成,耗时: 1091 ms
5 个任务全部在 1.1 秒左右完成,排队延迟被彻底消除。
2. 常见误区:为什么在代码中设置 process.env 无效?
高频翻车点:很多开发者试图在代码文件首行写入:
这在绝大多数情况下是完全无效的。
process.env.UV_THREADPOOL_SIZE = 8;这在绝大多数情况下是完全无效的。
根本原因:libuv 线程池的初始化是惰性且只发生一次的。只要在执行 process.env.UV_THREADPOOL_SIZE = ... 之前,Node.js 内部或任何 require(...) 引入的第三方库触发了任何需要 libuv 初始化的操作,libuv 就会读取启动时的系统环境变量并创建内部线程池,此后该大小被固化(read-once),任何 JavaScript 运行时的修改都会被 libuv 彻底忽略。因此,务必在进程启动命令行或容器启动脚本中完成配置。
3. 容量并非越大越好:调优评估指标
把 UV_THREADPOOL_SIZE 设置成 128 或 1024 并不能让程序无限变快,反而可能招致以下副作用:
- CPU 核心上下文切换(Context Switching):系统物理 CPU 核心是有限的。若 64 个工作线程同时在 8 核机器上抢占 CPU 执行
crypto.pbkdf2,操作系统内核会在线程间进行密集的时间片轮转切换,导致 CPU 缓存失效(Cache Miss),实际总吞吐量反而大幅下降。 - 内存额外开销:在 64 位操作系统中,每个原生系统线程都会预留线程调用栈(通常为 1MB ~ 8MB)。无节制扩容会导致 Node.js 基础内存基线显著攀升。
- 磁盘寻道争用:在机械硬盘(HDD)环境下,过多并发的磁盘读写会导致磁头频繁寻道,随机读写性能急剧恶化。
推荐经验值:对于混合型 Web 服务,通常将
UV_THREADPOOL_SIZE 设定为 服务器物理 CPU 核心数的 1 到 2 倍(如 8 核机器设置为 8 到 16)。如果是纯 API 网关或长连接反向代理,保持默认值 4 即可。
六、线程池耗尽问题(Thread Pool Starvation)与工程防范
在实际生产环境中,由于所有走线程池的模块共享同一个全局线程池,极易发生“线程池饥饿(Thread Pool Starvation)”现象。
1. 典型隐患:dns.lookup 拖垮所有文件与加密操作
在 Node.js 中发起外网 HTTP 请求(如调用外部支付或第三方接口)时,默认的 http.request 会调用 dns.lookup 进行域名解析。而 dns.lookup 底层直接调用了操作系统 C 库的同步阻塞函数 getaddrinfo(3),该调用被投递到 libuv 线程池中执行。
如果你的服务在短时间内向大量不同外网域名发起并发请求,且遭遇了 DNS 查询延迟(如慢解析耗时 2~3 秒),这 4 个默认的工作线程就会被 DNS 查询全部占满。此时:
- 本机的
fs.readFile()静态资源读取被挂起排队; - 用户登录注册时的
crypto.pbkdf2密码校验无法得到计算资源; zlib响应压缩被延迟。
整个系统看似 CPU 利用率极低,但接口响应时间全面暴增。
2. 防范与解决策略
- 使用 dns.resolve 代替 dns.lookup:
dns.resolve*系列方法基于c-aresC 语言异步 DNS 库构建,直接在主线程事件循环中通过网络套接字异步查询,不占用任何 libuv 线程池资源。 - 引入 DNS 缓存代理:在 Node.js 端使用诸如
agentkeepalive或本地 DNS 缓存模块,避免每次 HTTP 请求重复查询解析。 - 密集纯 CPU 任务坚决分离:若存在自定义的高复杂度算法(如图像渲染、大量数据计算),不可依赖 libuv,应直接使用 Node.js 原生的
worker_threads模块,将其投递到拥有独立 V8 引擎实例的专用工作线程中运行,绝不干扰主线程事件循环与底层 libuv 线程池。
七、系统总结与核心决策清单
掌握 Node.js 的线程模型与 libuv 线程池机制,是进行高负载服务架构设计与性能瓶颈诊断的关键。最后,我们将核心机制、调优原则与技术选型整理为一张全景矩阵:
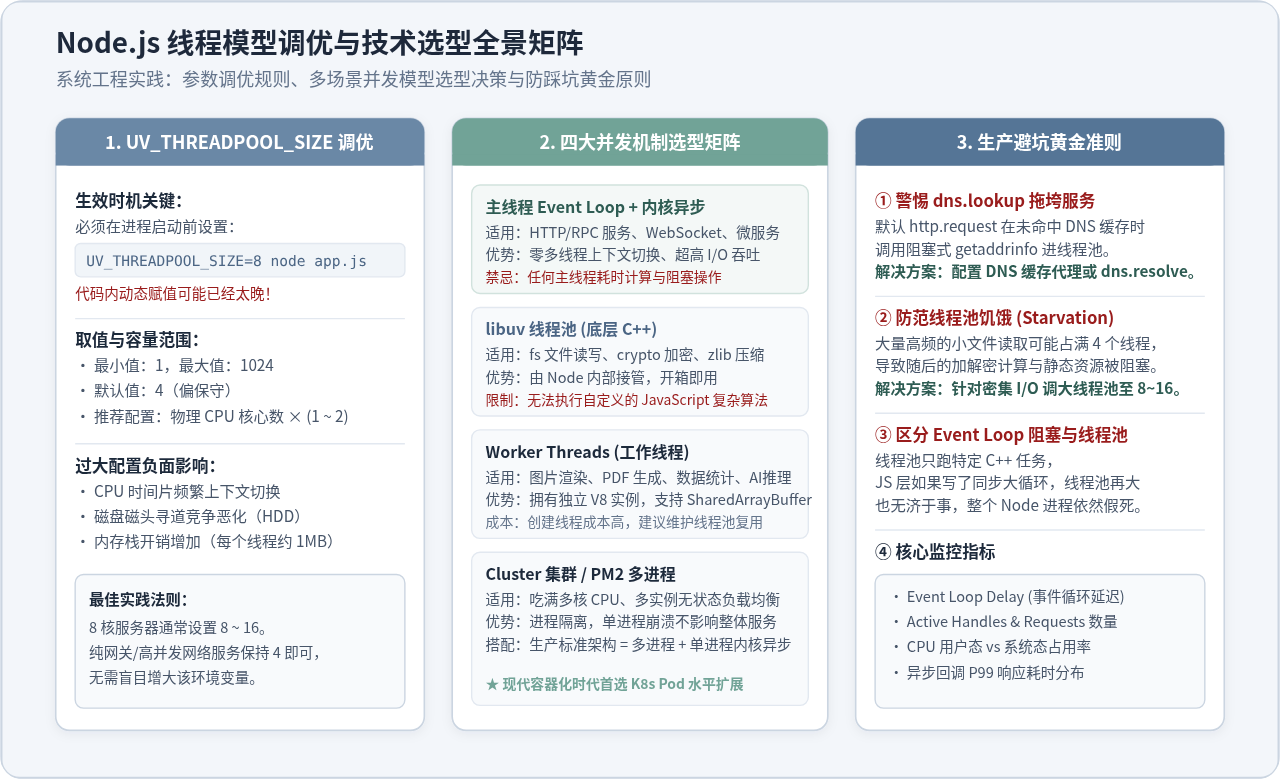
核心认知清单:
- 单线程只是表象:用户代码单线程执行,保证了逻辑的确定性和无锁编程的简便性;底层多线程与内核异步是吞吐量的真正基石。
- 网络 I/O 不进线程池:万级长连接不会把 libuv 线程池压垮,因为它们由操作系统的 epoll/kqueue 内核事件机制原生驱动。
- 四类任务受制于线程池:文件操作(
fs)、密码哈希(crypto)、压缩(zlib)和系统 DNS(dns.lookup)共享同一个容量受限的线程池,高并发下需注意排队现象。 - UV_THREADPOOL_SIZE 须在启动前声明:代码内部动态设置
process.env大多已错过初始化时机。 - 多维度并发组合拳:网络 I/O 走单线程内核异步,系统 I/O 走 libuv 线程池,业务计算走 Worker Threads,多核扩展走多进程 Cluster 或容器化水平扩容。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章